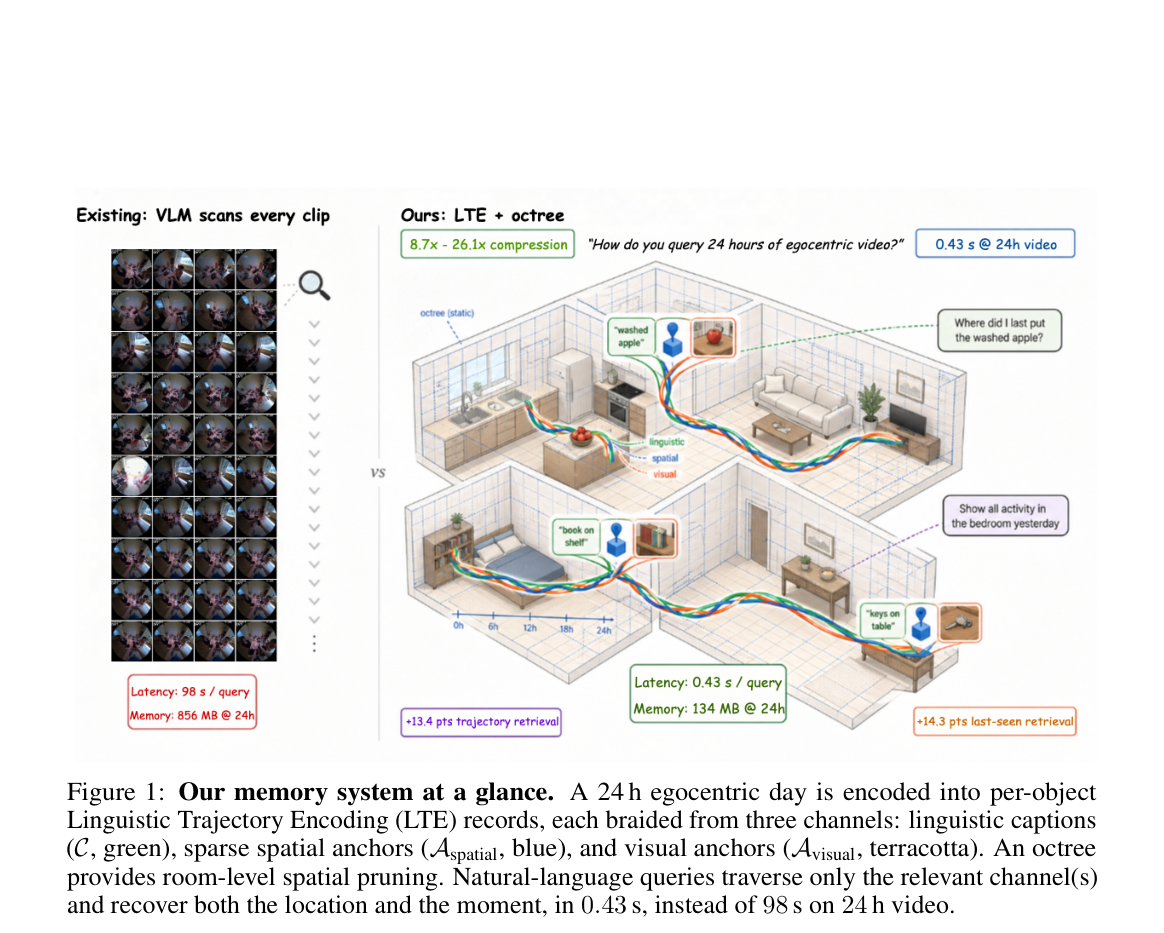
快速导读:本文提出 Linguistic Trajectory Encoding (LTE) 和 Spatial Memory Benchmark (SMB),通过结合语言描述、稀疏空间锚点和视觉锚点的混合表示,实现了对动态物体长时程运动历史的高效压缩与查询,在 Ego4D 和 EgoLife 数据集上显著优于现有基线。
具身智能体在真实世界中需要维持对动态物体状态变化的长期可查询性,但现有记忆系统在处理小时至天级的长时程观察时面临显著挑战。几何 SLAM 系统虽然能精确重建空间结构,却缺乏自然语言语义接口,难以支持高层语义查询;视频语言模型(VLM)虽然具备强大的语义理解能力,但缺乏 3D 空间索引,导致在长视频上的检索效率极低,且无法有效区分不同时刻的物体状态。
本文提出 Linguistic Trajectory Encoding (LTE) 和 Spatial Memory Benchmark (SMB),旨在解决这一核心矛盾。LTE 是一种 per-object 混合轨迹表示,通过结合自然语言运动描述、稀疏 3D 空间锚点和视觉身份锚点,实现了对动态物体运动历史的高效压缩与多通道查询。SMB 则基于 EgoLife 多日记录构建,引入了针对长时程空间记忆的新评测任务,填补了现有基准在动态物体状态查询上的空白。
英文题目:Linguistic Trajectory Encoding for Efficient Long-Horizon Spatial Memory in Embodied Agents
论文出处:arXiv 每日论文精选 · arXiv:2609.04802
原始论文:PDF / 论文页面
这篇论文解决什么问题?
当前具身智能体的记忆系统主要存在三类范式,但均无法同时满足长时程、动态物体和自然语言查询的需求。第一类是基于几何 SLAM 的系统,它们通过视觉里程计和特征匹配构建精确的 3D 地图,但记忆内容主要是静态几何结构,缺乏对动态物体运动轨迹的显式记录,且无法直接通过自然语言进行语义检索。
第二类是基于视频语言模型(VLM)的系统,如 EgoVLPv2 和 Qwen3-VL,它们通过预训练获得强大的视频-语言对齐能力,能够理解视频内容并回答自然语言问题。然而,VLM 通常以 clip-level embeddings 的形式存储记忆,丢弃了细粒度的运动信息,且缺乏 3D 空间索引,导致在长视频上的检索需要遍历大量帧,效率低下,且难以精确回答涉及空间位置和运动状态的问题。
第三类是任务导向的记忆系统,如 3D-Mem 和 VideoAgent,它们围绕即时任务上下文组织记忆,例如记录关键帧快照或事件摘要。这类系统虽然提高了任务相关性,但缺乏针对非任务相关物体的持久化轨迹记录,无法支持跨任务的长时程状态查询。例如,当用户询问“那个杯子昨天被放到了哪里”时,任务导向系统可能因为该物体与当前任务无关而未能记录其运动历史。
因此,核心研究缺口在于:缺乏一种能够以自然语言查询动态物体状态转换的 per-object timeline 表示,该表示需要同时具备语义可解释性、空间可索引性和时间可追溯性,且能在长时程观察中保持高效压缩和快速检索。
核心创新
- Linguistic Trajectory Encoding (LTE): 一种 per-object 混合轨迹表示,将动态运动记录为语言描述阶段,锚定稀疏 3D 位置和视觉裁剪,实现 8.7× 至 26.1× 的轨迹压缩,并在 24 小时视频上保持亚秒级查询延迟。
- Spatial Memory Benchmark (SMB): 基于 EgoLife 多日记录构建的 600 个查询基准,引入 Semantic Trajectory Retrieval (STR) 和 Long-Horizon Object Retrieval (LOR) 两个新任务,填补现有基准在长时程空间记忆评估上的空白。
- Long-horizon retrieval gains: 集成系统在 SMB 的两个新任务上超越最强 VLM 基线(STR +13.4, LOR +14.3),在 Ego4D NLQ 和 VQ2D 上取得最强的 zero-shot 结果,并接近任务特定的监督模型。
方法概览
提出 Linguistic Trajectory Encoding (LTE),一种 per-object 混合轨迹表示,包含三个通道:(1) 描述运动阶段的自然语言 captions (C);(2) 通过 Douglas-Peucker 简化保留的稀疏 3D 空间锚点 (Aspatial);(3) 用于身份验证的视觉锚点 (Avisual)。系统架构包括感知层(SAM3, ViPE, Qwen3-VL)、记忆层(LTE 记录 + Octree 空间索引)和查询路由层,支持 NLQ, VQ2D, STR, LOR 四种任务。
- Linguistic Trajectory Encoding (LTE) 是一种 per-object 混合轨迹表示,包含三个互补通道:自然语言 captions (C)、稀疏 3D 空间锚点 (Aspatial) 和视觉锚点 (Avisual)。自然语言 captions 由 VLM(如 Qwen3-VL)在运动阶段边界生成,描述物体的运动状态和语义变化;稀疏 3D 空间锚点通过 Douglas-Peucker 简化算法从密集轨迹中提取,保留关键空间位置;视觉锚点为物体在关键帧上的裁剪图像,用于身份验证和视觉匹配。
- 感知层负责将 egocentric 视频转换为结构化的 per-frame 观察。系统使用 SAM3 进行物体分割和跟踪,ViPE 进行视觉定位,Qwen3-VL 进行场景标签和运动描述生成。感知层输出包括物体 ID、3D 位置、视觉裁剪和自然语言描述,为记忆层提供结构化输入。
- 记忆层负责存储和索引 LTE 记录。每个动态物体对应一条 LTE 记录,包含其运动历史的所有通道信息。记忆层使用 Octree 作为静态空间索引,将空间划分为房间级区域,支持快速空间剪枝。Octree 节点存储该区域内物体的 LTE 记录指针,使得空间查询可以高效地定位到相关物体。
- 查询路由层支持四种任务:NLQ (Natural Language Query)、VQ2D (Visual Query to 2D)、STR (Semantic Trajectory Retrieval) 和 LOR (Long-Horizon Object Retrieval)。NLQ 和 VQ2D 来自 Ego4D 基准,STR 和 LOR 是本文在 SMB 中引入的新任务。查询路由层根据查询类型和语义内容,决定遍历哪些 LTE 通道,并调用相应的检索策略。
- NLQ 任务要求根据自然语言查询定位视频中的相关片段。系统首先通过 Octree 进行空间剪枝,缩小候选区域,然后在候选区域内遍历 LTE 记录的自然语言 captions,通过语义匹配找到最相关的运动阶段,最后返回对应的时间片段和空间位置。
- VQ2D 任务要求根据视觉查询定位视频中的相关片段。系统首先利用 LTE 记录中的视觉锚点进行身份匹配,找到与查询图像最相似的物体,然后在匹配到的物体轨迹上进行时间过滤,返回相关的时间片段和空间位置。视觉锚点使得 VQ2D 任务可以绕过耗时的帧级扫描,直接进行物体级匹配。
- STR 任务要求根据自然语言查询检索动态物体的运动轨迹。系统遍历 LTE 记录的自然语言 captions,通过语义匹配找到描述物体运动状态的阶段,返回对应的轨迹片段。STR 任务强调对运动状态的语义理解,要求系统能够区分不同的运动阶段,如“拿起”、“放下”、“移动”等。
- LOR 任务要求根据自然语言查询检索长时程内的物体状态。系统利用 Octree 进行空间剪枝,结合 LTE 记录的时间戳和空间锚点,找到在指定时间窗口内处于指定空间的物体状态。LOR 任务强调长时程和空间约束,要求系统能够高效处理跨天级的查询。
逐图理解论文
LTE 混合表示
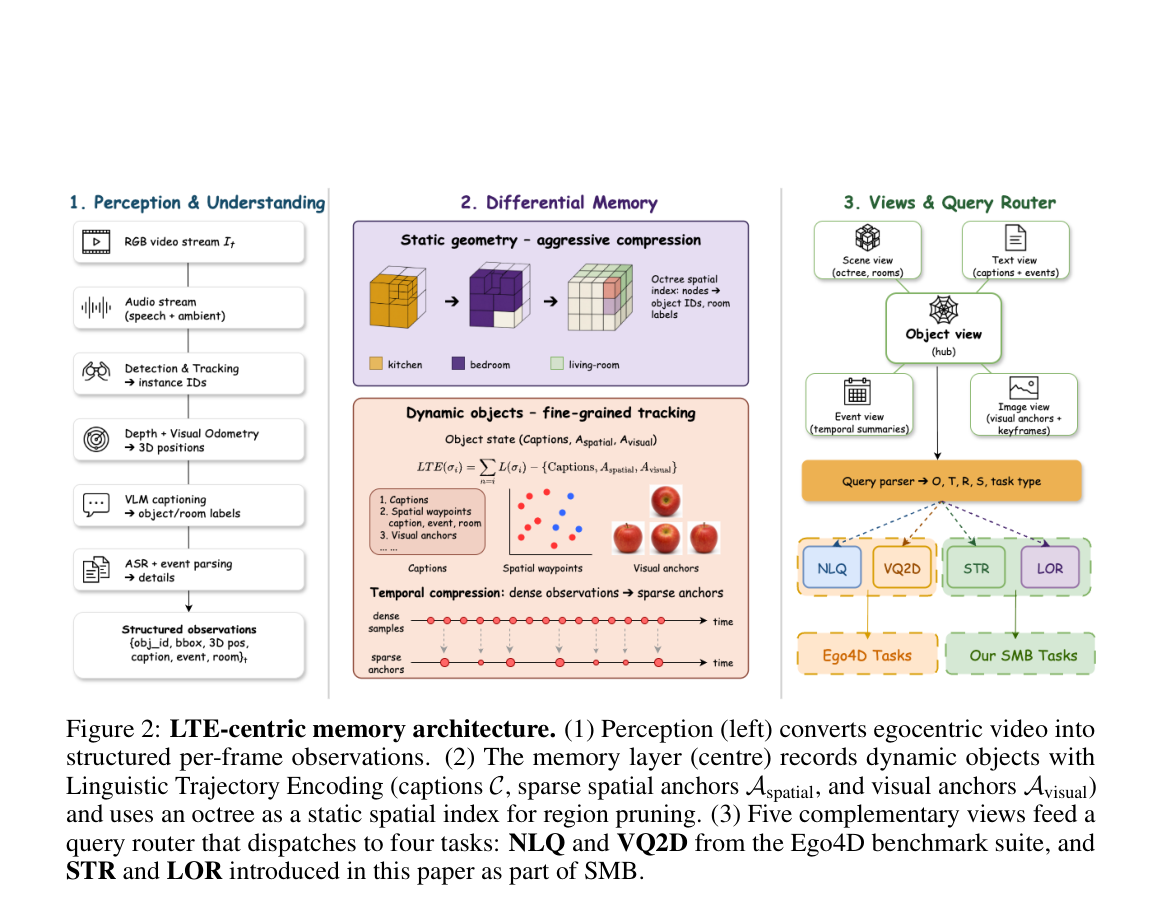
该图详细展示了 LTE 中心记忆架构,包括感知层、记忆层和查询路由层。感知层将 egocentric 视频转换为结构化 per-frame 观察,记忆层记录动态物体的 LTE 记录并使用 Octree 作为静态空间索引,查询路由层支持 NLQ、VQ2D、STR 和 LOR 四种任务。该图展示了系统各组件的交互和数据流,是理解系统实现细节的关键。
SMB 基准与验证
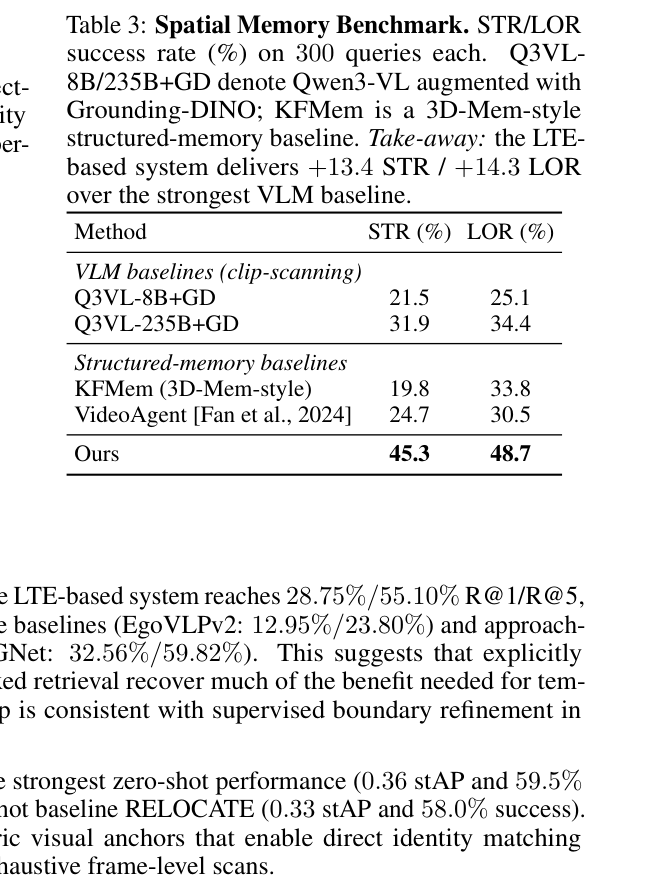
该表展示了 SMB 的结果,LTE 系统在 STR 和 LOR 任务上分别达到 45.3% 和 48.7% 成功率,比最强 VLM 基线 (Q3VL-235B+GD) 高 13.4 和 14.3 个百分点。该表验证了 LTE 在长时程空间记忆任务上的有效性,表明轨迹编码对于语义状态查询至关重要。
效率与消融
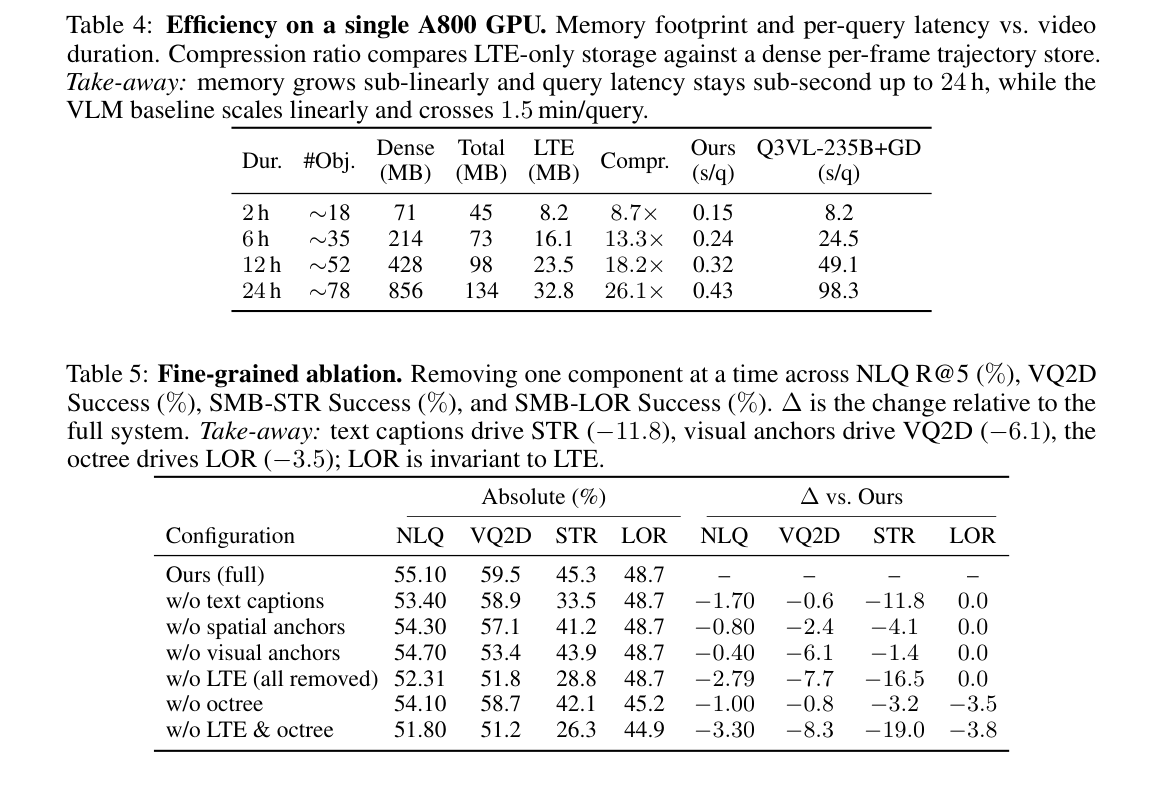
该表展示了效率评估结果,LTE 系统在单张 A800 GPU 上,24 小时视频的查询延迟为 0.43 秒,内存占用随视频时长亚线性增长,压缩比达到 8.7× 至 26.1×。该表验证了 LTE 的高效性,表明混合表示和 Octree 索引可以显著降低查询延迟和内存占用。
实验如何设计?
- 实验在 Ego4D 和 EgoLife 数据集上进行。Ego4D 包含大规模 egocentric 视频,用于评估 NLQ 和 VQ2D 任务;EgoLife 包含多日家庭环境记录,用于构建 SMB 基准和评估 STR 和 LOR 任务。SMB 包含 600 个查询,其中 STR 和 LOR 各 300 个,查询涉及不同时间窗口和空间约束。
- 基线方法包括 VLM 基线(如 Qwen3-VL 结合 Grounding-DINO)、结构化记忆基线(如 3D-Mem 和 VideoAgent)以及任务特定监督模型(如 OSGNet)。VLM 基线直接对视频进行编码和检索,结构化记忆基线使用关键帧快照或事件摘要,任务特定监督模型针对特定任务进行端到端训练。
- 评估指标包括 NLQ 的 R@1 和 R@5(IoU=0.3)、VQ2D 的 stAP 和 Success、STR 和 LOR 的 Success Rate。NLQ 和 VQ2D 使用 Ego4D 标准评估协议,STR 和 LOR 使用 SMB 自定义评估协议,要求返回的轨迹片段与 ground truth 在时间和空间上均满足阈值。
- 效率评估在单张 A800 GPU 上进行,测量内存占用和查询延迟随视频时长的变化。压缩比定义为 LTE-only 存储与 dense per-frame trajectory store 的比值,用于衡量 LTE 表示的压缩效率。
- 消融实验通过移除 LTE 的单个通道(自然语言 captions、视觉锚点、空间锚点)或 Octree 索引,评估各组件对不同任务的贡献。消融实验在 NLQ、VQ2D、STR 和 LOR 任务上进行,以验证各通道和索引的独立作用。
关键结果与论文证据
- 在 Ego4D NLQ 任务上,LTE 系统在 IoU=0.3 下达到 28.75% R@1 和 55.10% R@5,显著优于 EgoVLPv2 (12.95%/23.80%),接近任务特定监督模型 OSGNet (32.56%/59.82%)。这表明结构化物体轨迹和事件索引可以恢复大部分时间定位所需的收益,剩余差距与监督边界细化一致(Table 1, p.7)。
- 在 Ego4D VQ2D 任务上,LTE 系统取得最强的 zero-shot 性能,stAP 0.36,Success 59.5%,略高于 RELOCATE (0.33 stAP, 58.0% Success)。物体中心的视觉锚点使得直接身份匹配成为可能,避免了耗时的帧级扫描(Table 2, p.7)。
- 在 SMB STR 任务上,LTE 系统达到 45.3% 成功率,比最强 VLM 基线 (Q3VL-235B+GD: 31.9%) 高 13.4 个百分点,比结构化记忆基线 (KFMem: 19.8%) 高 25.5 个百分点。这表明轨迹编码对于语义状态查询至关重要,事件级摘要和关键帧快照无法有效表示运动历史(Table 3, p.7)。
- 在 SMB LOR 任务上,LTE 系统达到 48.7% 成功率,比最强 VLM 基线 (Q3VL-235B+GD: 34.4%) 高 14.3 个百分点。Octree 空间索引和稀疏空间锚点使得长时程空间约束查询成为可能,而 VLM 基线缺乏空间索引,难以高效处理空间约束(Table 3, p.7)。
- 在效率方面,LTE 系统在单张 A800 GPU 上,24 小时视频的查询延迟为 0.43 秒,而 VLM 基线为 98.3 秒。内存占用随视频时长亚线性增长,压缩比达到 8.7× 至 26.1×,显著优于 dense per-frame trajectory store(Table 4, p.9)。
- 消融实验表明,移除自然语言 captions 导致 STR 下降 11.8%,移除视觉锚点导致 VQ2D 下降 6.1%,移除 Octree 导致 LOR 下降 3.5%。各通道和索引对不同任务有明确的分工和互补作用,自然语言 captions 驱动语义状态查询,视觉锚点驱动视觉匹配,Octree 驱动空间检索(Table 5, p.9)。
- 在更严格的 IoU=0.5 阈值下,LTE 系统在 STR 和 LOR 任务上的优势依然保持(+12.4 STR, +13.5 LOR),表明结果不是宽松 IoU 标准的产物(Table 10, p.16)。
- 定性分析表明,大多数失败案例源于上游组件(如跟踪 ID 切换和点云漂移),而非 LTE 表示本身。跟踪 ID 切换单独占 STR 错误的 34%,表明系统性能受上游感知和跟踪可靠性限制(Figure 3, p.8; Appendix E)。
阅读时需要注意
- 对象被追踪为原子实体,未建模部件级动态(如门的角度、抽屉的延伸),限制了系统在复杂物体交互场景中的应用。
- 长时程压力测试仅在 EgoLife 家庭环境中进行,缺乏办公室、仓库和户外环境的验证,系统在不同环境下的泛化能力未知。
- 系统性能受上游组件可靠性限制,如跟踪 ID 切换和点云漂移,这些上游错误会直接传播到 LTE 表示和查询结果中。
- LTE captions 在运动阶段边界生成,可能遗漏连续操作中的细粒度状态变化,如缓慢移动或微小调整。
- 单目深度估计和视觉里程计在长时间运行中会积累漂移,影响空间定位精度,进而影响 Octree 索引和空间查询的准确性。
- 系统假设单一持久环境,未处理多环境场景下的跨环境物体重识别和地图对齐,限制了系统在多房间或多建筑场景中的应用。
关联工作
- 3D-Mem 是一种结构化记忆基线,使用关键帧快照表示记忆。LTE 通过维护 per-object 语言轨迹,在动态物体状态查询上显著优于 3D-Mem,因为关键帧快照无法表示运动历史(p.3)。
- VideoAgent 是一种事件级记忆基线,使用事件摘要表示记忆。LTE 通过提供轨迹级抽象,在语义状态查询上优于 VideoAgent,因为事件级摘要缺乏细粒度的运动状态信息(p.3)。
- EgoVLPv2 是一种视频-语言预训练基线,使用 clip-level embeddings 表示记忆。LTE 通过结构化物体轨迹和事件索引,在 Ego4D NLQ 上显著优于 EgoVLPv2,表明细粒度运动信息对于时间定位至关重要(p.7)。
- Qwen3-VL 是一种 VLM,用于场景标签和运动描述生成,也作为基线(结合 Grounding-DINO)在 SMB 上被 LTE 超越。这表明即使强大的 VLM,缺乏空间索引和轨迹表示,也难以高效处理长时程空间记忆查询(p.4)。