Mind the Temporal Gap:检视驾驶视频中的时序理解缺口
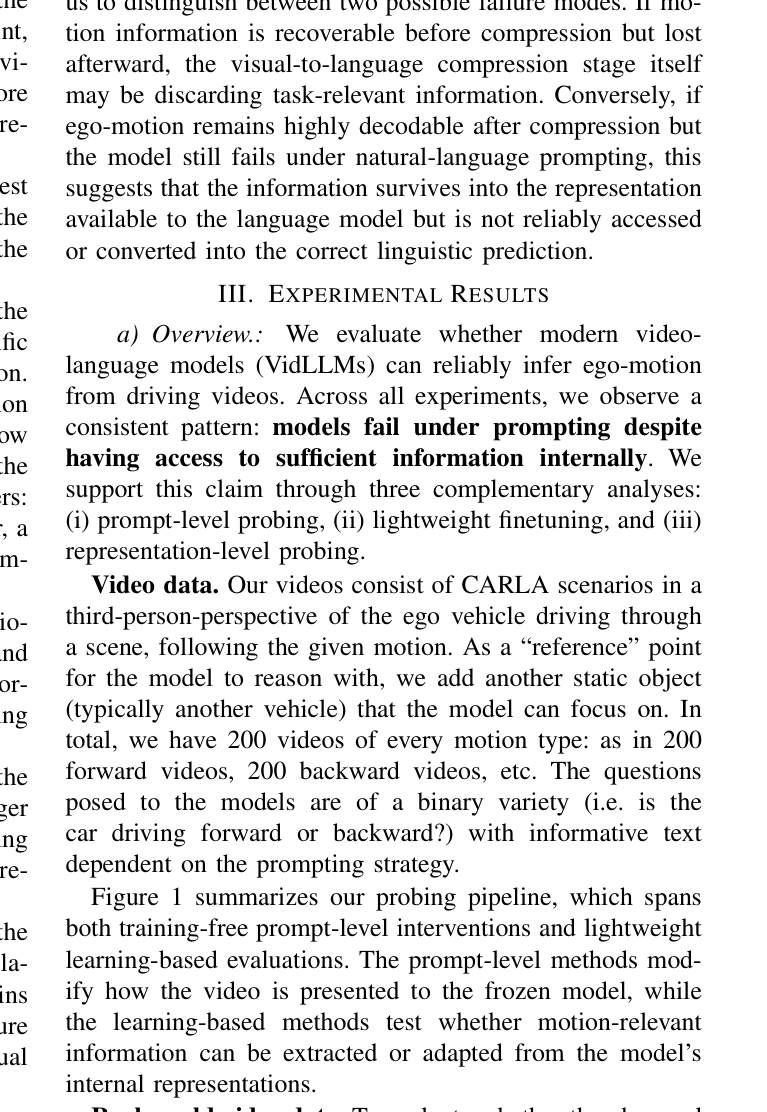
在受控自车运动任务上,现成视频语言模型提示表现不稳且常有类别崩塌,而轻量 LoRA 与特征探针能恢复强运动判别,说明线索常在内部却未可靠进入语言通路。
在受控自车运动任务上,现成视频语言模型提示表现不稳且常有类别崩塌,而轻量 LoRA 与特征探针能恢复强运动判别,说明线索常在内部却未可靠进入语言通路。
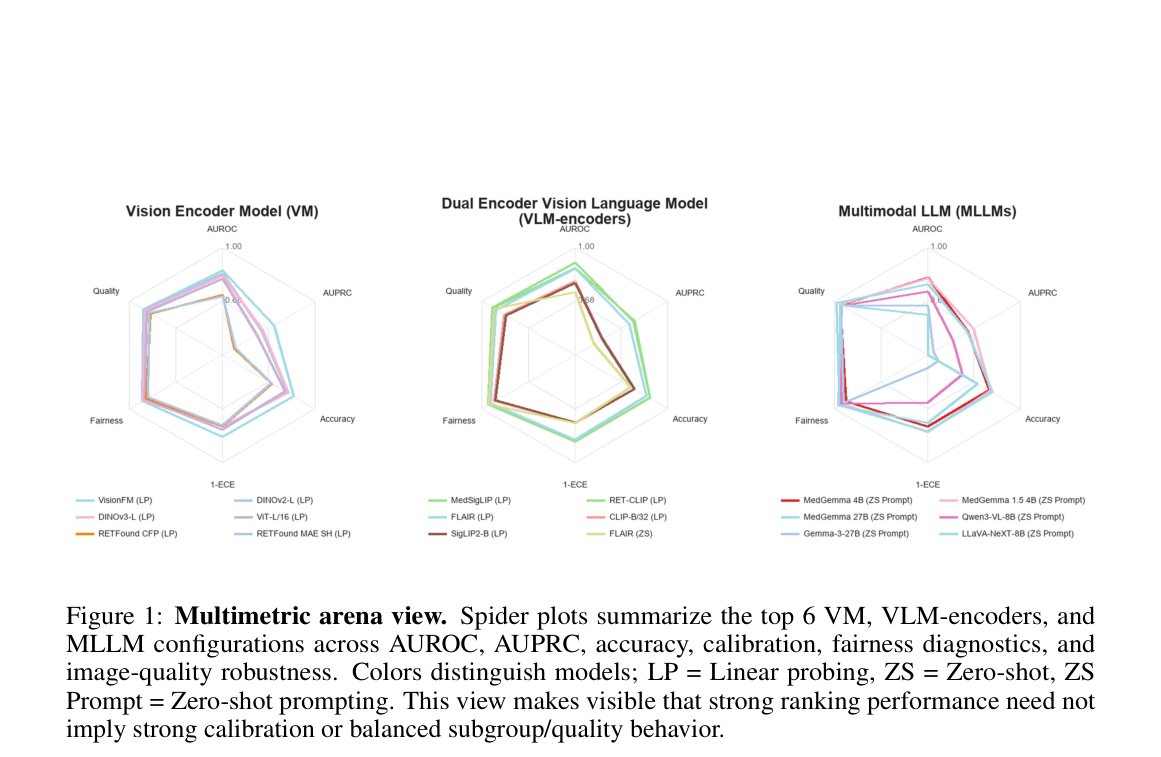
FOCUS 在十个眼底数据集上统一评测 VM、VLM 与 MLLM 的跨库泛化,并同时报告性能、校准、公平与图像质量鲁棒性;明确非临床产品。
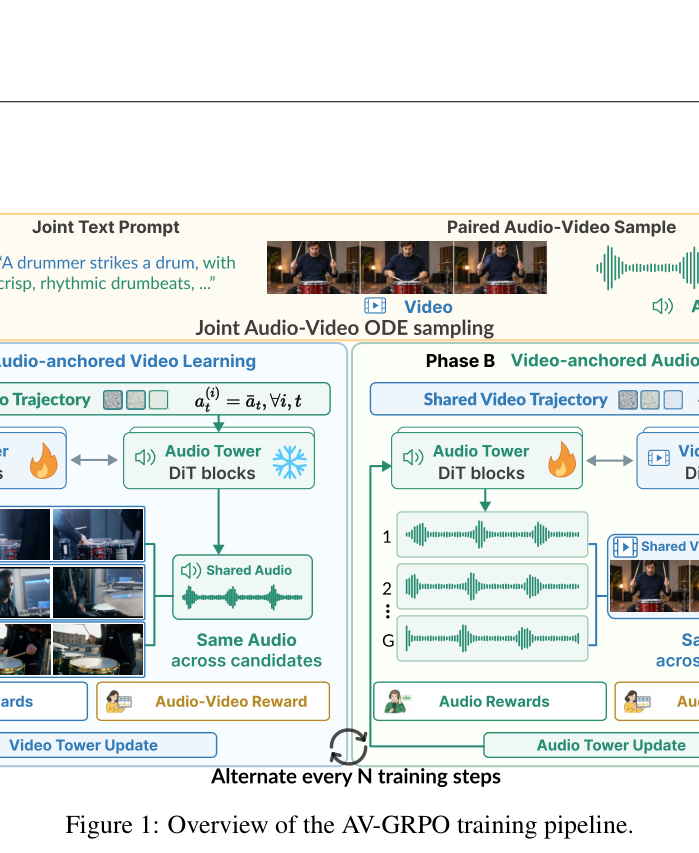
上科院、港理工等提出 AV-GRPO:用模态锚定 rollout、轨迹锁定冻结塔与模态自适应目标,把纠缠的多模态奖励拆成条件单模态子问题,并配 5DAV 数据集;在 LTX-2.3 上 LoRA/全参后训练均优于基线与 GDPO。
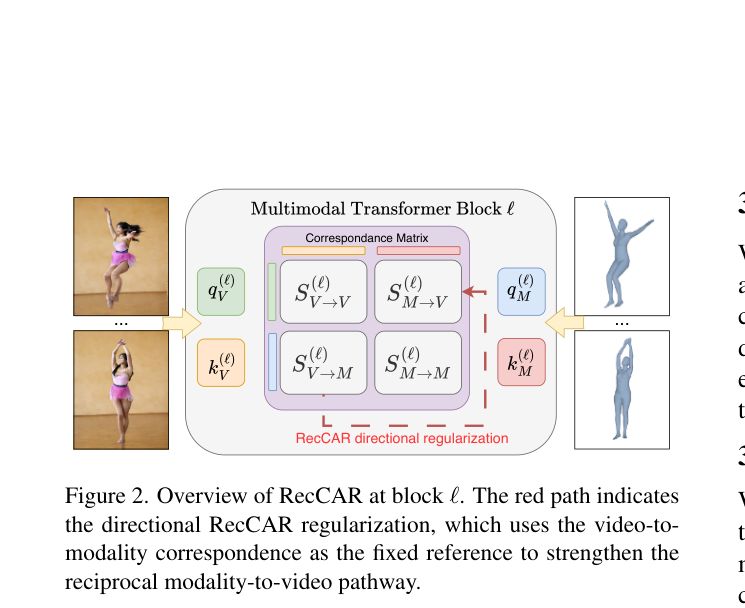
本文发现联合多模态扩散里视频到伴生模态的对应远强于反向路径,并提出 RecCAR,用停梯度 KL 把较弱的模态到视频对应拉向已建立的视频到模态对应,从而提升视频-动作与视频-音频一致性。
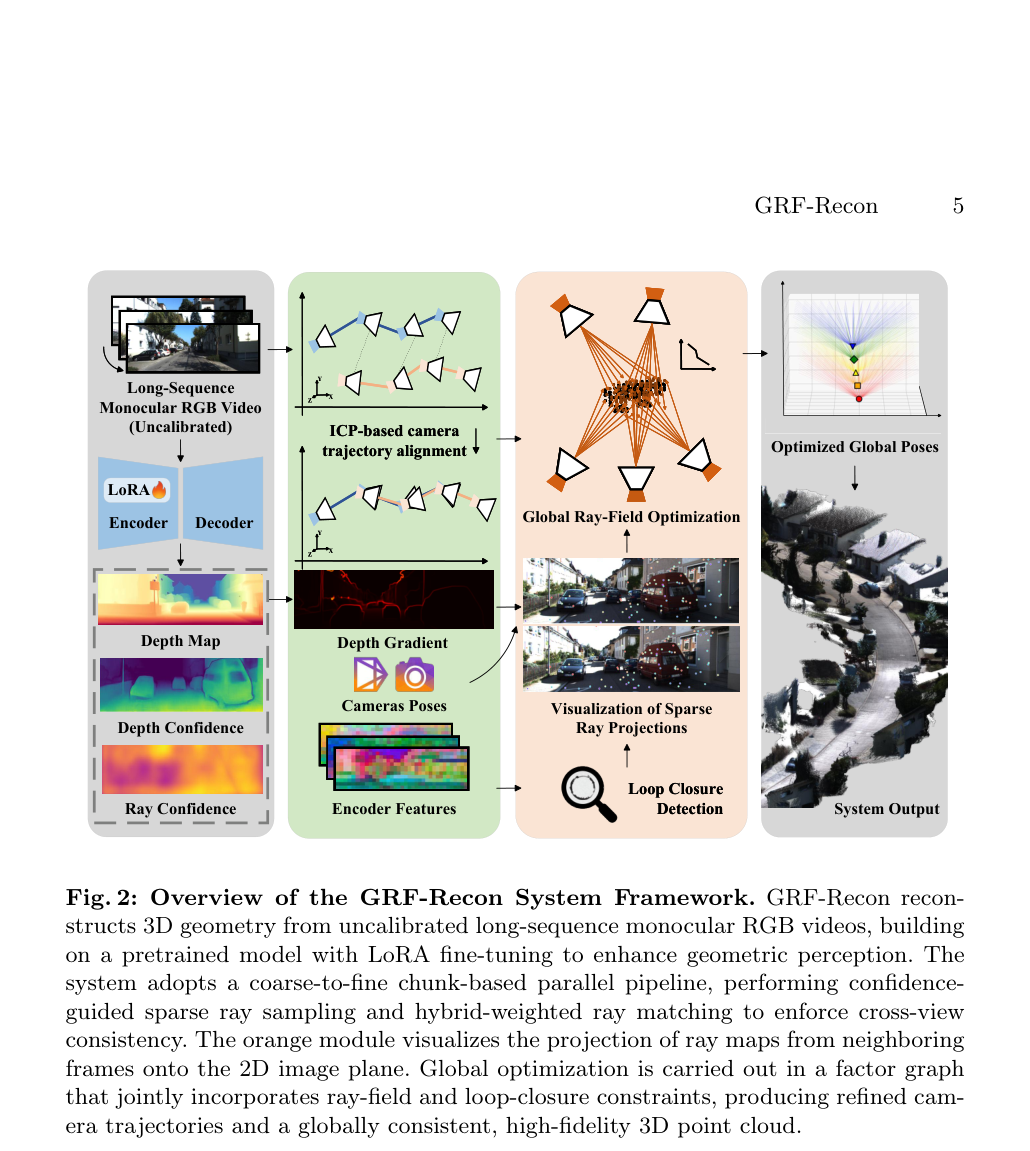
本文提出 GRF-Recon,通过重归一化 LoRA 注入单目几何先验、混合权重稀疏射线场优化与轨迹拼接,把前馈三维重建扩展到千米级未标定单目序列并抑制长期漂移。
本文提出 SOFTPROMPT,通过在跨模态边界注入少量连续软提示 token 并采用空格初始化,在冻结 VLM 骨干网络的前提下,以极少的可训练参数实现了与 LoRA 相当的少样本检测性能,且无灾难性遗忘。
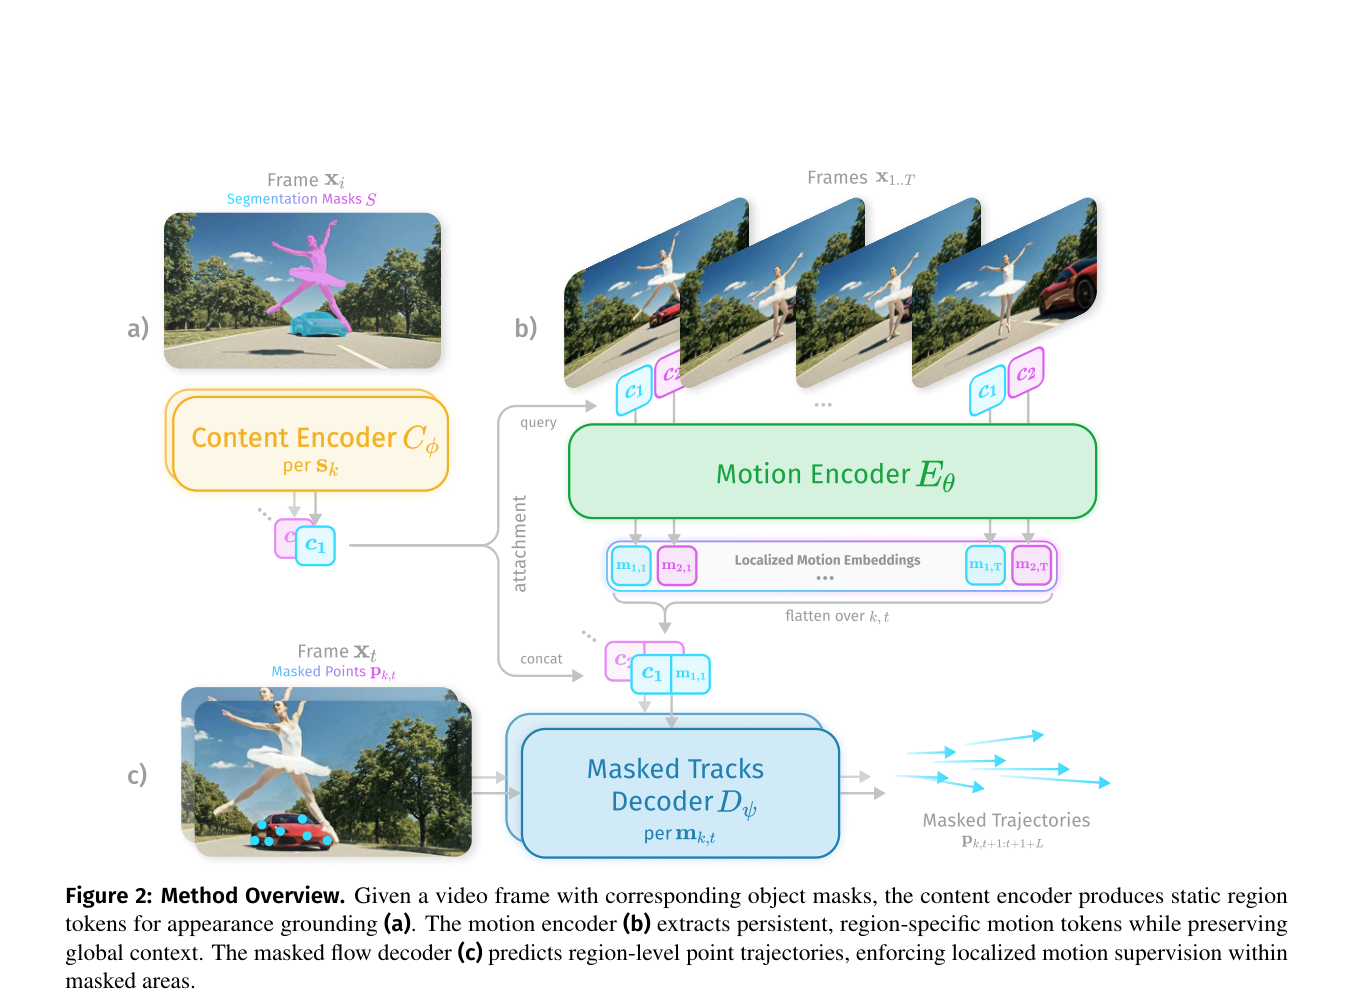
本文提出了一种可提示的局部化运动表示方法,通过在全局视频上下文中提取特定区域的运动嵌入,实现了高精度的对象级运动迁移与组合场景生成,并在局部动作分类任务中优于基于裁剪或掩码的全局方法。