快速导读:本文提出了一种基于共享 MLP 解码紧凑潜码的神经外观模型,在保持重建质量的同时,将 3DGS 中每个高斯的外观存储从 192 字节减少至 28 字节,并显著提升了优化与渲染效率。
3D Gaussian Splatting (3DGS) 凭借显式高斯基元与可微光栅化,在实时渲染与重建质量间取得了显著平衡。然而,其默认采用的三阶球谐函数 (SH) 为每个高斯引入了 45 个视角相关参数,不仅导致巨大的存储开销,其带限特性还限制了高频角度细节的表达,且 SH 系数的更新占据了优化过程的相当一部分时间。
本文提出了一种紧凑的神经外观模型,将每个高斯的外观表示从 192 字节压缩至 28 字节。该模型为每个高斯存储一个 8 维潜码,通过一个共享权重的两层 MLP 结合视角方向编码,解码出视角相关残差。作者进一步构建了一个统一的评估框架,将 SH、Spherical Voronoi (SV)、NASG、NASGabor 以及提出的神经模型集成到 Faster-GS 管线中,在多个标准数据集和跨平台 GPU 上进行了受控对比,深入剖析了不同外观参数化对优化过程、几何恢复及渲染效率的影响。
英文题目:Compact Neural Appearance Models for Efficient Gaussian Splatting
论文出处:arXiv 每日论文精选 · arXiv:2609.05255
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在 3DGS 中,视角相关外观的建模直接决定了渲染的真实感与优化效率。传统的 SH 方案虽然实现简单,但其固定基函数的表达力受限,难以精确捕捉复杂的镜面反射或高频光照变化。为了弥补这一缺陷,优化器往往被迫通过调整高斯的几何形状(如拉长高斯)来“伪造”视角相关效果,这不仅增加了基元数量,还容易引入几何伪影,降低了场景的编辑友好性。
尽管已有研究提出了基于 Beta 核、Soft Voronoi 或各向异性球面高斯 (NASG/NASGabor) 的替代方案,但这些工作大多缺乏在统一优化协议、一致端到端实现以及跨桌面/移动 GPU 性能下的受控对比评估。不同实现细节和超参数设置使得直接比较各方案的优劣变得困难,社区亟需一个标准化的基准来厘清不同外观模型在表达力、存储开销和计算效率之间的真实权衡。
此外,外观模型的表达力与优化过程之间存在微妙的耦合关系。表达力过强的模型可能会吸收非静态场景内容(如采集过程中的物体移动或光照变化),导致几何恢复失真;而表达力不足的模型则可能过度依赖几何调整,引发“popping”等伪影。理解并量化这种耦合关系,对于指导实际场景中的模型选择和超参数调整至关重要。
核心创新
- 提出了基于每基元潜码和共享 MLP 的紧凑神经外观模型,无需预定义基函数。
- 实现了所有外观模型在可微 CUDA 光栅化器中的前向和反向传播融合,支持 JIT 编译。
- 提供了跨桌面和移动 GPU 的 WebGL 查看器,实现了统一的性能对比基准。
- 深入分析了外观参数化对优化过程的影响,揭示了表达力强的模型如何吸收非静态场景内容或几何伪影。
方法概览
作者构建了一个统一的评估框架,将 SH、Spherical Voronoi (SV)、NASG、NASGabor 以及提出的神经模型集成到 Faster-GS 管线中。神经模型为每个高斯存储 8 维潜码,通过一个共享的小型 MLP(2 层,16 神经元)结合视角方向编码解码视角相关残差。利用 tiny-cuda-nn 实现 CUDA 内核融合,并开发了 WebGL 查看器以评估移动端性能。
- 紧凑神经外观模型:为每个高斯分配一个 8 维潜码,通过一个共享权重的两层 MLP(每层 16 个神经元)结合视角方向的频率编码,解码出视角相关颜色残差。这种设计避免了预定义基函数,利用 MLP 的通用逼近能力实现灵活的外观表达。
- CUDA 内核融合:利用 tiny-cuda-nn 库,将 MLP 的前向和反向传播直接融合到可微 CUDA 光栅化器中。这种端到端的融合消除了中间张量的内存读写开销,显著提升了优化和渲染的计算效率,并支持 JIT 编译以适应不同硬件。
- 统一评估框架:将 SH、SV、NASG、NASGabor 和神经模型统一集成到 Faster-GS 优化管线中。所有模型共享相同的几何表示、致密化策略 (MCMC densification) 和光度补偿 (PPISP) 模块,确保对比实验的公平性和可复现性。
- 跨平台性能基准:开发了基于 WebGL 的查看器,支持在桌面 GPU (RTX 5090/4090/3090) 和移动设备 (MacBook M1 Pro, iPad M2 Pro, iPhone A18 Pro) 上进行 720p 渲染帧时间测试。该基准填补了现有工作在移动端性能评估上的空白,为实际部署提供了参考。
- 超参数敏感性分析:系统研究了不同颜色激活函数 (ReLU, Softplus, Sigmoid) 和不透明度学习率对几何恢复的影响。发现参数化选择对优化过程有显著影响,表达力强的模型需要更精细的学习率调度以避免吸收非静态内容。
- 漫反射与镜面反射分解评估:通过可视化基础颜色和视角相关残差,定性评估各模型分解漫反射和镜面反射的能力。分析表明,高表达力模型能更准确地将反射分离到残差中,从而获得更合理的漫反射基础颜色。
逐图理解论文
SH 的几何伪影
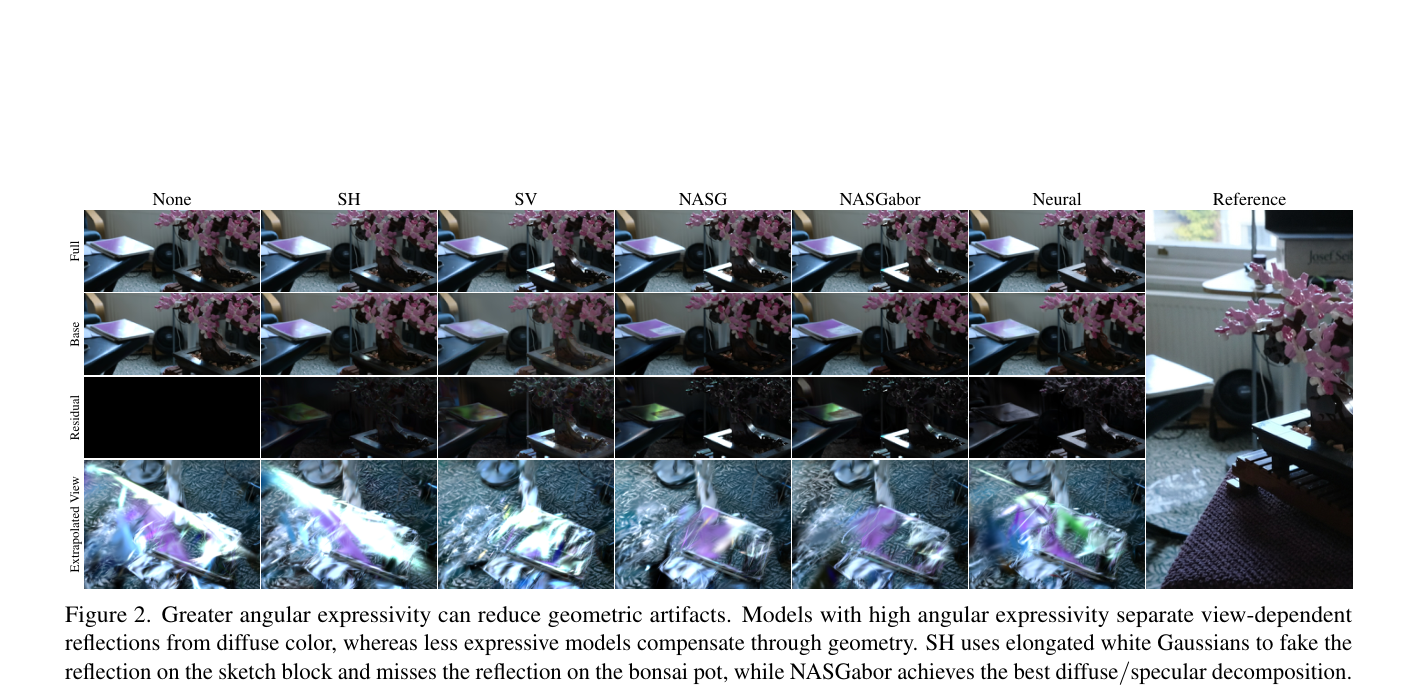
该图展示了不同模型在分解漫反射和镜面反射时的基础颜色和残差。重点观察 SH 中通过拉长高斯伪造反射的几何伪影,以及 NASGabor 和神经模型如何将反射更准确地分离到残差中,从而获得更合理的漫反射基础颜色。
紧凑神经模型
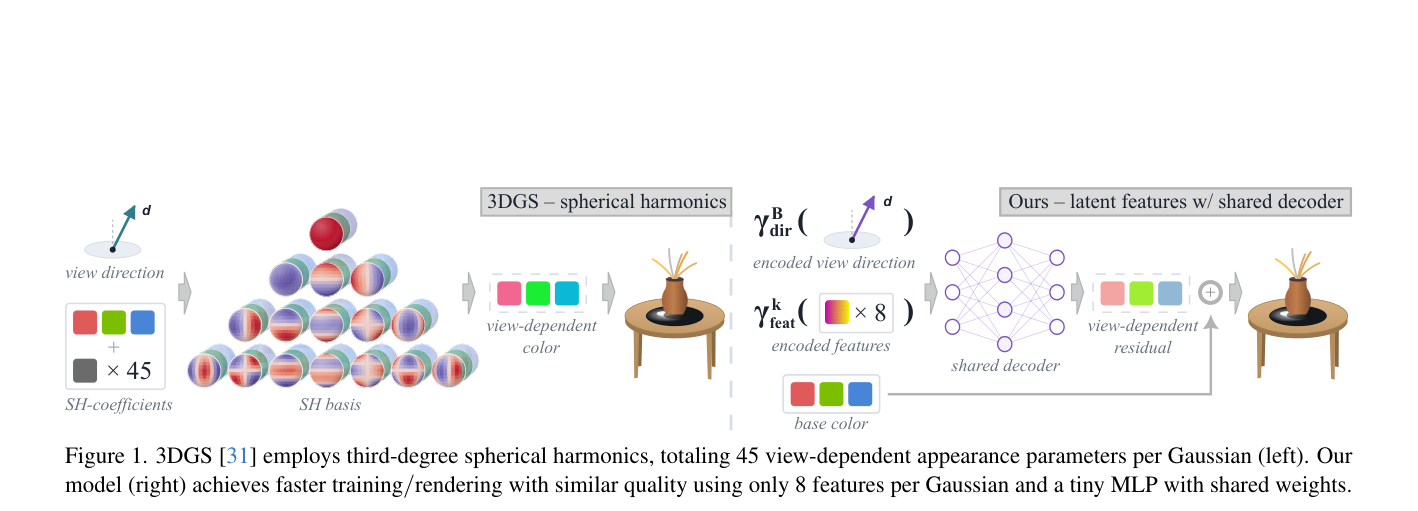
该图直观对比了 SH (45 参数) 和神经模型 (8 潜码 + MLP) 的外观表示。重点观察右侧 MLP 结构及其共享权重特性,理解其如何通过少量潜码和通用逼近能力替代固定基函数,实现存储压缩和表达灵活性。
表达力与伪影吸收
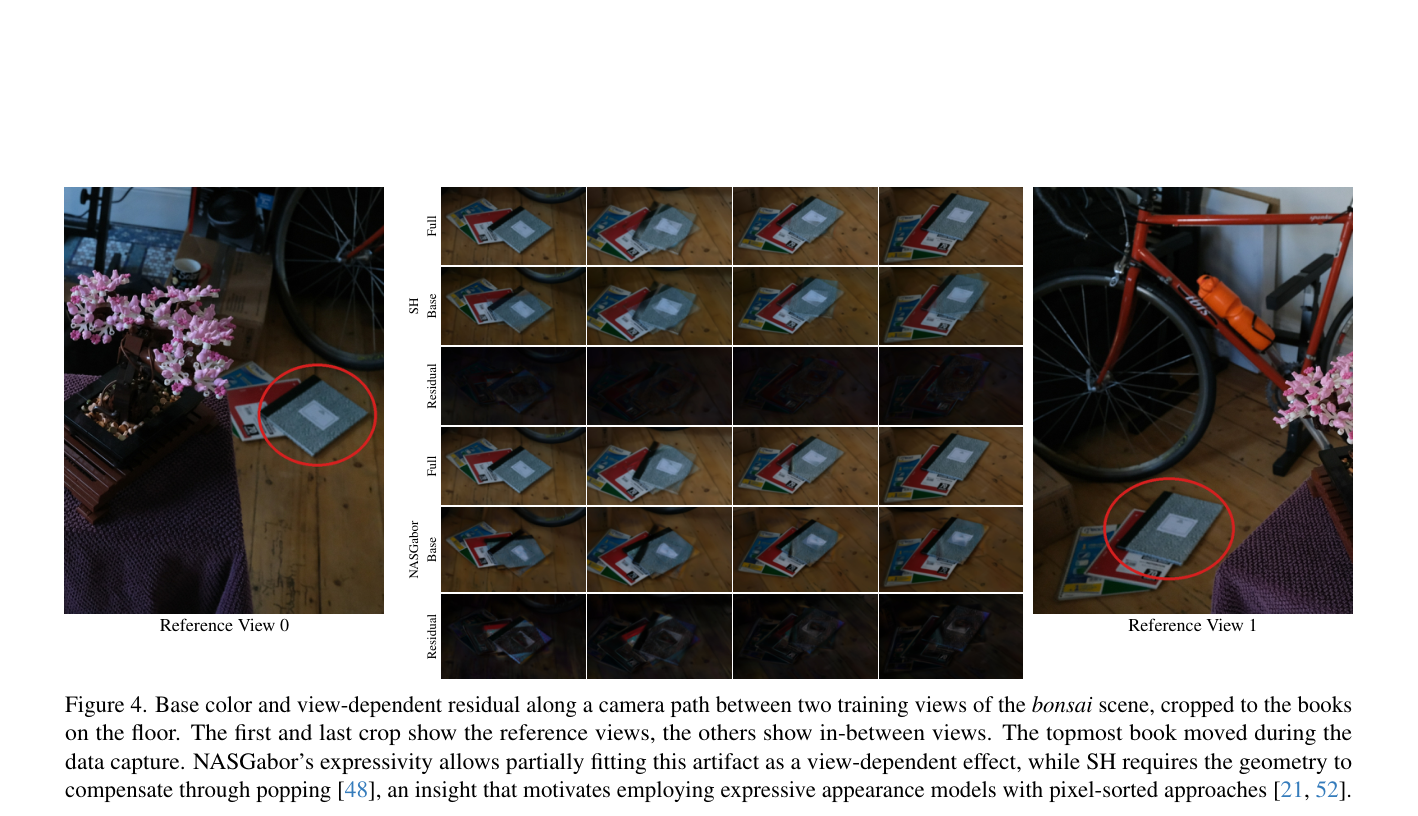
该图展示了在包含物体移动伪影的场景中,不同模型的基础颜色和视角相关残差。重点观察 NASGabor 如何将移动伪影拟合为视角相关效果,而 SH 如何通过几何“popping”补偿,理解表达力模型在吸收非静态内容方面的行为及其对几何恢复的影响。
结论与局限
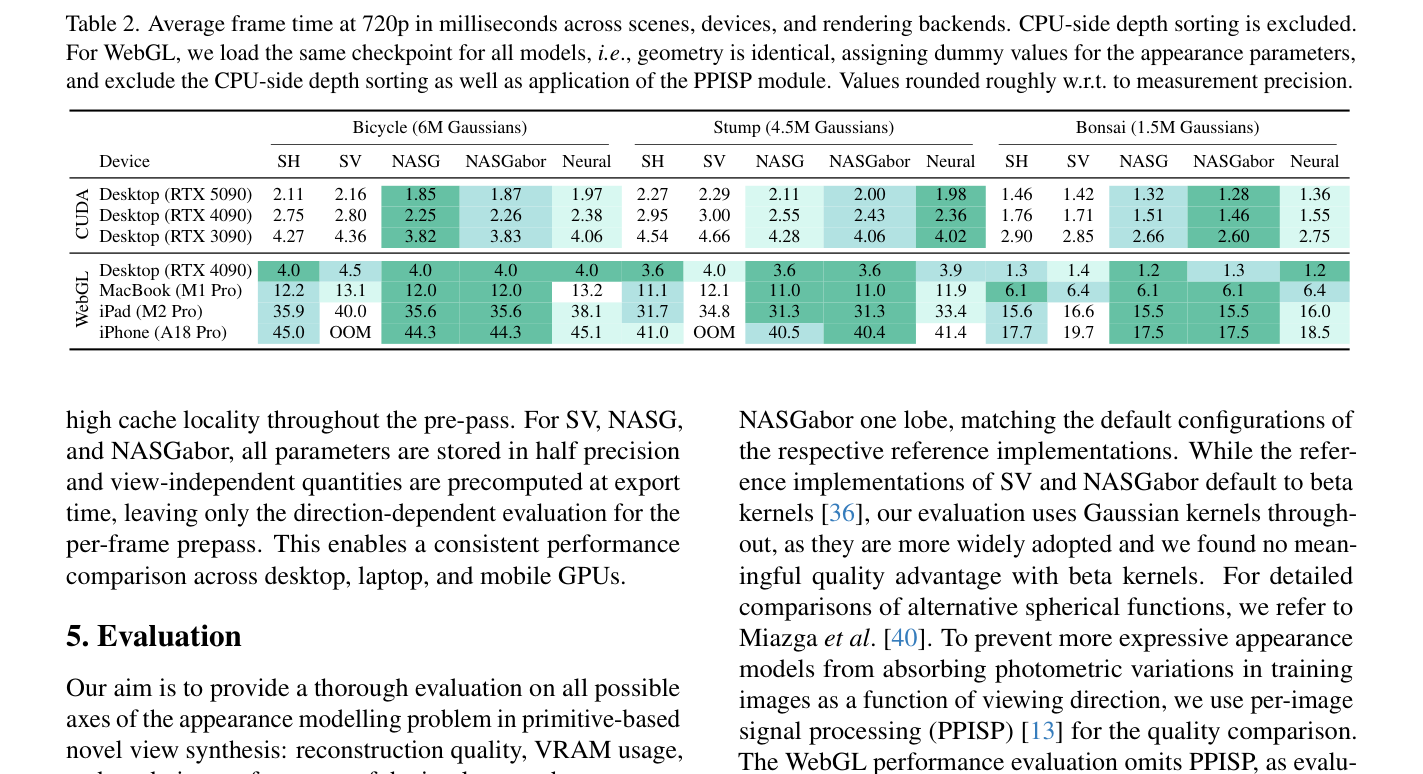
该表展示了跨桌面和移动 GPU 的 720p 渲染帧时间。重点观察 WebGL 列中神经模型与参数化模型的帧时间差异,理解硬件加速缺失对神经模型效率的影响,以及不同 GPU 架构下的性能表现。
实验如何设计?
- 数据集:在 Mip-NeRF 360, Tanks & Temples, Deep Blending 和 NeRF Synthetic 四个标准数据集上进行评估,涵盖真实复杂场景和合成漫反射场景。
- 优化协议:采用 Faster-GS 框架,使用 MCMC densification 策略,并在真实场景上应用 PPISP 处理光度变化。所有实验重复五次以报告平均值和标准差,提高结果的可复现性。
- 硬件环境:桌面端测试在 RTX 5090, RTX 4090, RTX 3090 上进行;移动端测试在 MacBook M1 Pro, iPad M2 Pro, iPhone A18 Pro 上进行,渲染分辨率统一为 720p。
- 评估指标:重建质量采用 PSNR, SSIM, LPIPS;效率指标包括训练时间、VRAM 占用和渲染 FPS (或帧时间)。
- 消融实验:针对神经模型,测试了不同 MLP 结构 (层数、神经元数) 和频率编码维度 (F=8) 的影响;针对所有模型,分析了不同颜色激活函数和不透明度学习率 (固定值 vs. lr=auto) 的效果。
关键结果与论文证据
- 存储与效率优势:神经模型将每个高斯的外观存储从 SH 的 192 字节减少至 28 字节,并在 Mip-NeRF 360 上将优化时间从 6m12s 缩短至 4m17s,同时 PSNR 从 28.36 提升至 28.55 (Page 1, 5)。
- 几何伪影减少:高表达力模型 (如 NASGabor 和神经模型) 能更有效地分离视角相关反射,减少 SH 中常见的通过拉长高斯伪造反射的几何伪影 (Page 6, Fig. 2)。
- 表达力与伪影吸收:在包含非静态内容 (如物体移动) 的场景中,表达力强的模型 (如 NASGabor) 倾向于将伪影拟合为视角相关效果,而 SH 则通过几何“popping”补偿 (Page 8, Fig. 4)。
- 移动端性能权衡:在 WebGL 环境下,由于缺乏 Tensor Cores 等硬件加速,神经模型的渲染帧时间 (18.5ms) 略慢于参数化模型 (SH 17.7ms, NASGabor 17.5ms),表明其效率优势在移动端不明显 (Page 5, Table 2)。
- 超参数敏感性:不透明度学习率的选择对几何恢复有显著影响,lr=auto 策略在不同场景下表现更稳定;颜色激活函数 (如 Softplus) 对残差分解质量有轻微影响 (Page 6, 7, Table 4, Fig. 3)。
- 分解能力差异:NASGabor 在漫反射/镜面反射分解上表现最佳,神经模型通常介于 SH 和 NASGabor 之间,但在某些高光场景 (如 Dr Johnson) 中可能将高光错误地归入基础颜色 (Page 15, 16, Fig. 6)。
阅读时需要注意
- 所有模型均无法准确建模强镜面反射,需要显式二次光线追踪或更复杂的光照模型。
- 神经模型的共享解码器使得场景组合和编辑变得复杂,因为响应无法解析旋转,限制了其作为可编辑表示的灵活性。
- WebGL 环境缺乏 CUDA 中的硬件加速 (如 Tensor Cores),导致神经模型在移动端性能优势不明显,甚至略慢于参数化模型。
- 共享解码器在场景规模极大时可能成为容量瓶颈,限制其对超大规模场景的适应性。
关联工作
- 3D Gaussian Splatting (3DGS):本文的基线方法,使用 SH 建模视角相关外观,存在存储和表达力限制 (Page 1)。
- Faster-GS:本文使用的优化框架,提供了高效的 MCMC densification 和光栅化实现 (Page 1)。
- NASG / NASGabor:基于各向异性球面高斯的竞争方案,在表达力和分解能力上表现优异,但存储开销较大 (Page 3)。
- tiny-cuda-nn:用于实现 MLP 前向/反向传播 CUDA 内核融合的库,是实现高效神经外观模型的关键技术 (Page 3)。
- PPISP:用于处理真实场景光度变化的方法,确保不同模型在公平的光度条件下对比 (Page 5)。