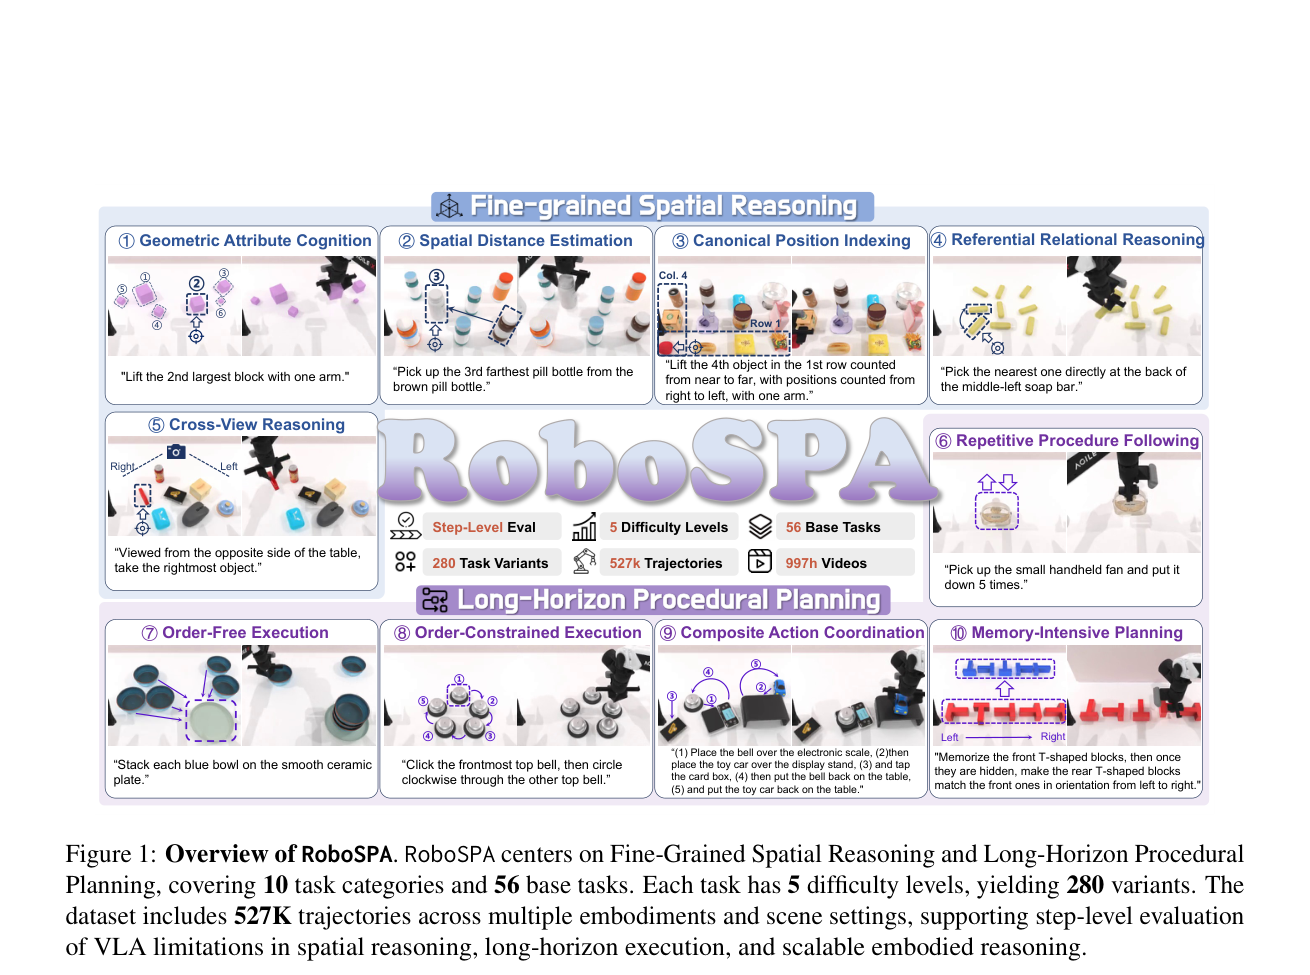
快速导读:本文提出了RoboSPA,一个专注于细粒度空间推理和长视距程序规划的大规模机器人操作数据集与基准,用于诊断VLA模型在复杂空间关系和长程执行中的局限性。
RoboSPA是一个专注于细粒度空间推理和长视距程序规划的大规模机器人操作数据集与基准,旨在诊断VLA模型在复杂空间关系和长程执行中的局限性。它基于SAPIEN模拟器和RoboTwin 2.0框架构建,包含10个任务类别、56个基础任务,每个任务实例化为5个难度级别,共280个变体,包含527K条轨迹,覆盖5种机器人本体和干净/域随机化场景。
本文的核心贡献是首次将细粒度空间推理和长视距程序规划作为VLA数据集的核心评估维度,并引入ONT A指标,基于Cohen's kappa思想消除物体数量带来的随机猜测基线影响。通过在RoboSPA上评估四个代表性VLA模型,本文揭示了模型在复杂任务中的系统性退化模式,为下一代具身智能提供了可操作的诊断框架。
英文题目:RoboSPA: Can VLA Models Go Beyond Simple Scenes and Short-Horizon Tasks?
论文出处:arXiv 每日论文精选 · arXiv:2609.05324
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA模型整合视觉感知、语言理解和动作生成,在结构化、短视距任务中表现良好,但在真实场景中缺乏细粒度空间推理和长视距程序规划能力。细粒度空间推理要求模型通过细微空间线索区分目标,如几何属性、空间距离、规范位置索引、指代关系推理和跨视角推理;长视距程序规划要求模型执行多步动作、保持时序约束和记忆状态,如重复程序、无序/有序执行、复合动作协调和记忆密集规划。
现有数据集如LIBERO和RoboTwin 2.0主要关注短视距任务或简单场景,缺乏对这两方面的系统性、分级难度评估。LIBERO主要关注知识迁移,缺乏细粒度空间推理评估;RoboTwin 2.0提供强域随机化的双臂操作数据生成和评估,但缺乏细粒度空间推理和步骤级诊断。这使得我们无法量化模型性能随任务复杂度增加而退化的具体模式,也难以区分空间感知错误与规划执行错误。
此外,现有评估指标如Success Rate无法区分模型是真正理解了空间关系,还是通过随机猜测或物体数量优势获得成功。例如,当物体数量从3个增加到10个时,随机猜测的基线成功率从33%下降到10%,这使得不同难度级别之间的比较不公平。因此,需要一种新的评估指标和基准,能够更公平地比较模型的空间推理能力,并支持步骤级诊断。
核心创新
- 首次将细粒度空间推理作为VLA数据集的核心评估维度,涵盖几何属性、空间距离、规范位置索引、指代关系推理和跨视角推理。
- 引入长视距程序规划评估,涵盖重复程序、无序/有序执行、复合动作协调和记忆密集规划,支持步骤级诊断。
- 设计多级层次化难度评估体系,每个任务实例化为5个难度级别,便于分析性能随复杂度增加的退化趋势。
- 提出ONT A指标,基于Cohen's kappa思想,消除物体数量带来的随机猜测基线影响,更公平地比较空间推理能力。
- 大规模多本体、多场景数据集,包含527K条轨迹和997小时视频,支持更广泛的泛化性评估。
方法概览
RoboSPA基于SAPIEN模拟器和RoboTwin 2.0框架构建,包含两个核心维度:细粒度空间推理(5类任务)和长视距程序规划(5类任务),共10个类别、56个基础任务。每个任务实例化为5个难度级别(通过增加物体数量或动作序列长度),生成280个变体。数据集包含527K条轨迹,覆盖5种机器人本体(Aloha-AgileX, ARX-X5, Piper, Franka, UR5)和干净/域随机化场景。评估指标包括Success Rate (SR)、Object-Normalized Target Accuracy (ONT A)和Progress Score (PS)。
- RoboSPA包含两个核心维度:细粒度空间推理(5类任务:GAC, SDE, CPI, RRR, CVR)和长视距程序规划(5类任务:RPF, OFE, OCE, CAC, MIP),共10个类别、56个基础任务。每个任务实例化为5个难度级别,通过增加物体数量或动作序列长度实现,生成280个变体。
- 数据集包含527K条轨迹,覆盖5种机器人本体(Aloha-AgileX, ARX-X5, Piper, Franka, UR5)和干净/域随机化场景。域随机化场景包含多样化的布局、干扰物、光照、纹理和桌面,以增强模型的泛化能力。
- 评估指标包括Success Rate (SR)、Object-Normalized Target Accuracy (ONT A)和Progress Score (PS)。ONT A基于Cohen's kappa思想,消除物体数量带来的随机猜测基线影响,更公平地比较空间推理能力。Progress Score反映部分完成情况,支持步骤级诊断。
- 实验使用Aloha-AgileX本体的干净场景数据进行训练和评估,每个基础任务单独训练模型,并在每个难度级别独立评估,每个任务变体进行100次rollout试验。评估四个代表性VLA模型:RDT, GO-1, π0.5, X-VLA。
逐图理解论文
失败直觉
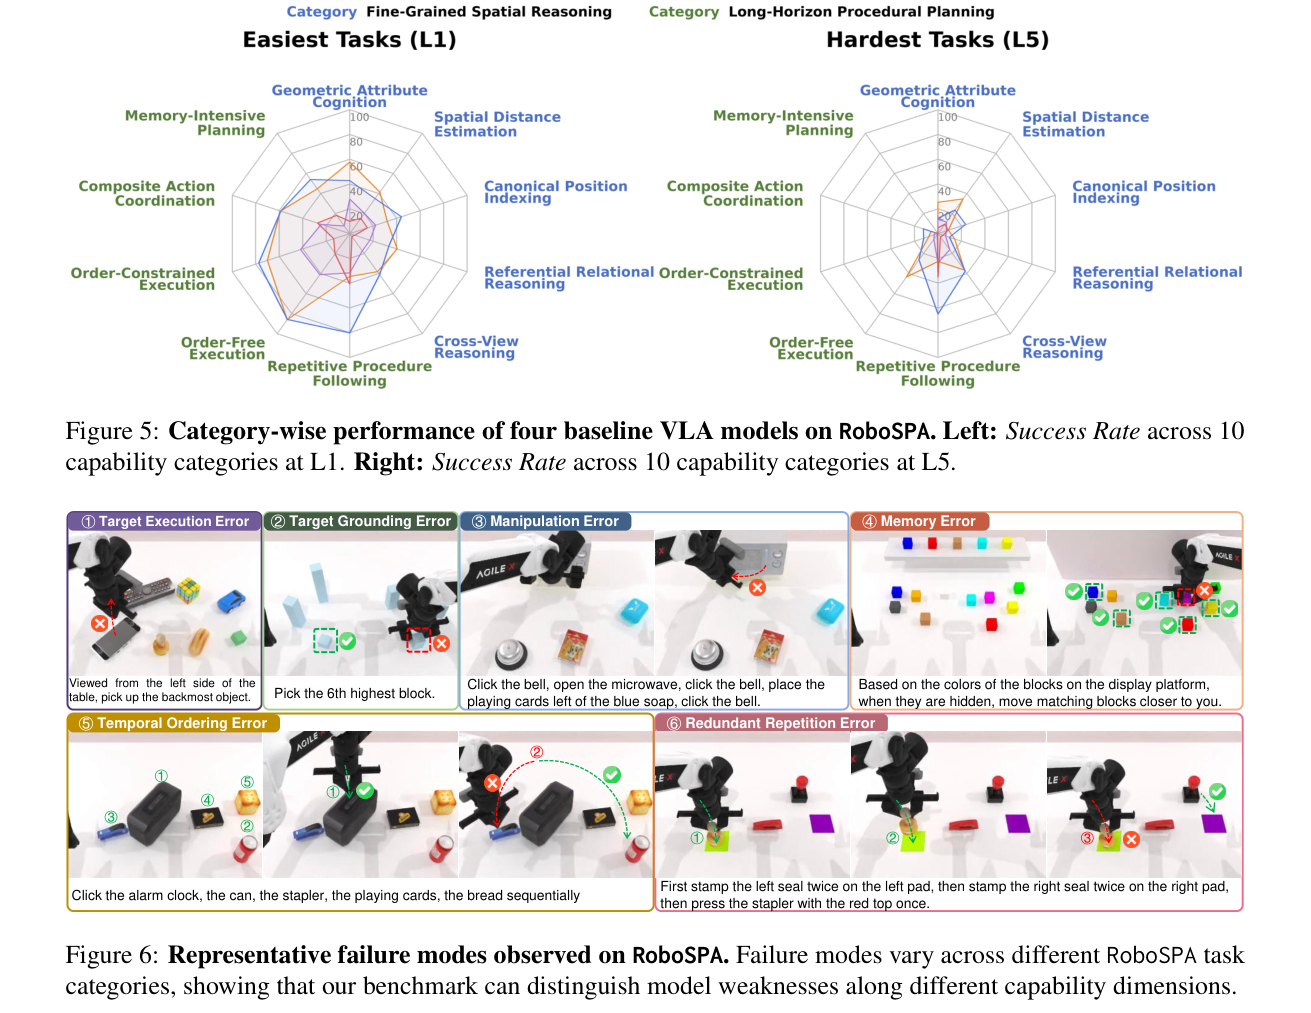
该图展示了在RoboSPA上观察到的代表性失败模式。观察该图可以了解模型在不同任务类别上的具体失败原因,以及基准如何区分模型在不同能力维度上的弱点。
研究缺口
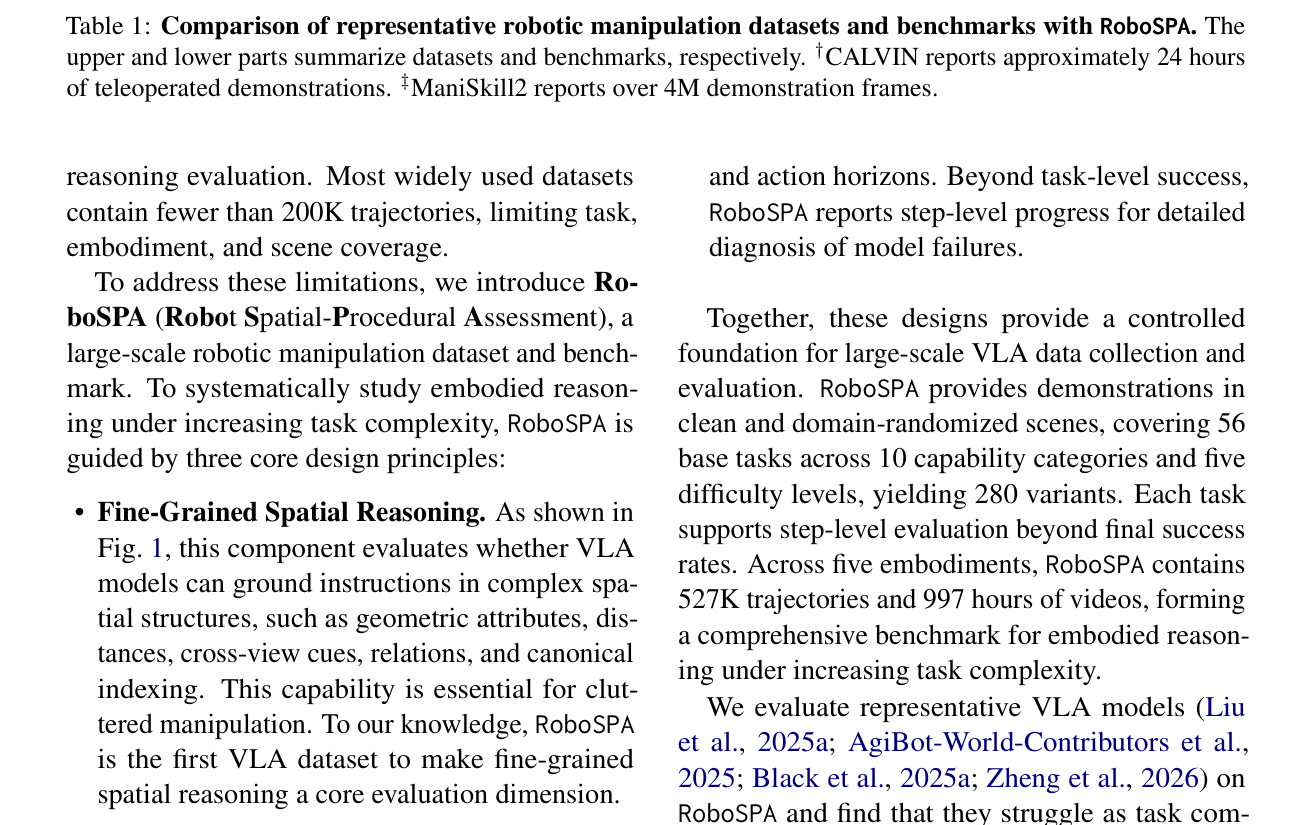
现有基准如LIBERO和RoboTwin 2.0主要关注短视距任务或简单场景,缺乏对细粒度空间推理和长视距程序规划的系统性、分级难度评估。这使得我们无法量化模型性能随任务复杂度增加而退化的具体模式,也难以区分空间感知错误与规划执行错误。
核心贡献
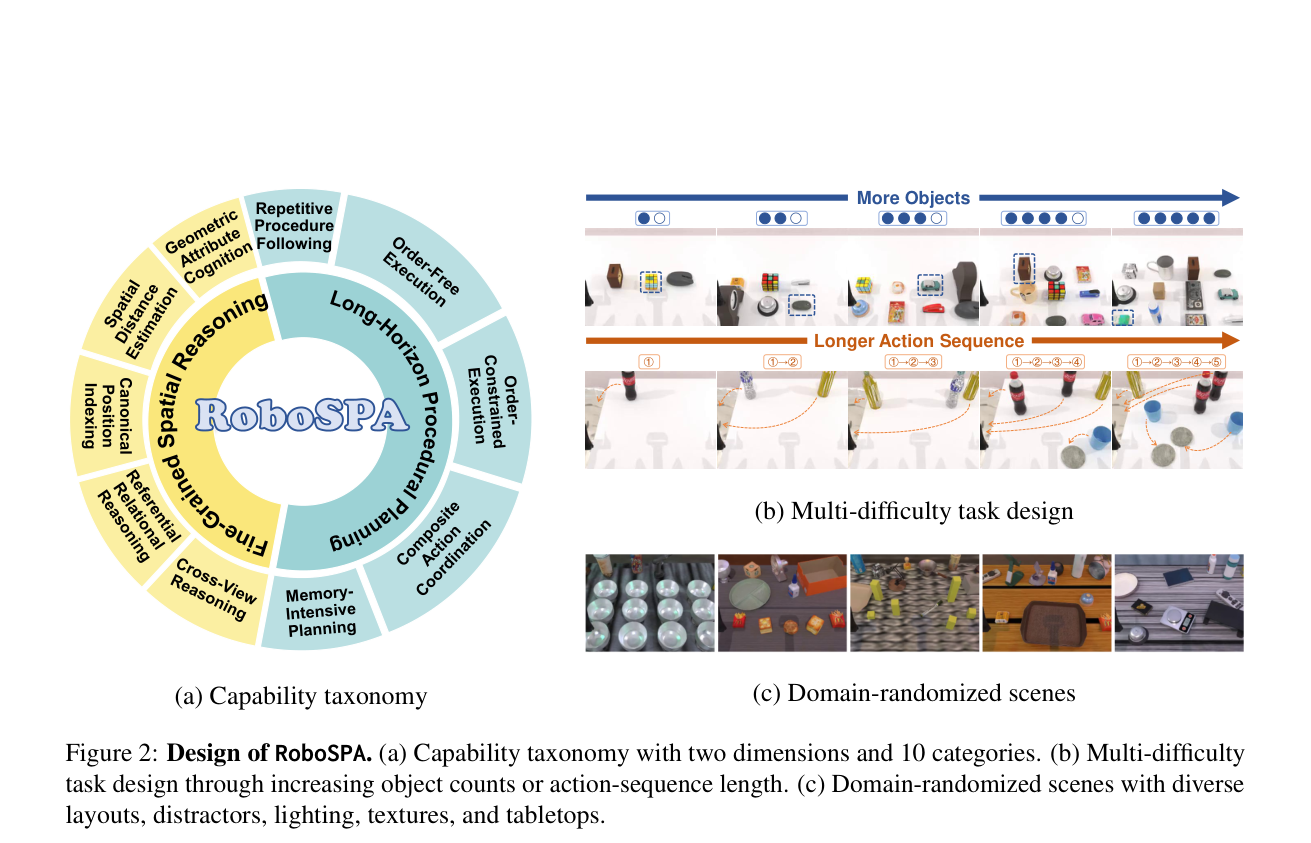
该图展示了RoboSPA的设计,包括能力分类、多难度任务设计和域随机化场景。观察该图可以了解任务如何实例化为不同难度级别,以及域随机化如何增强模型的泛化能力。
关键发现
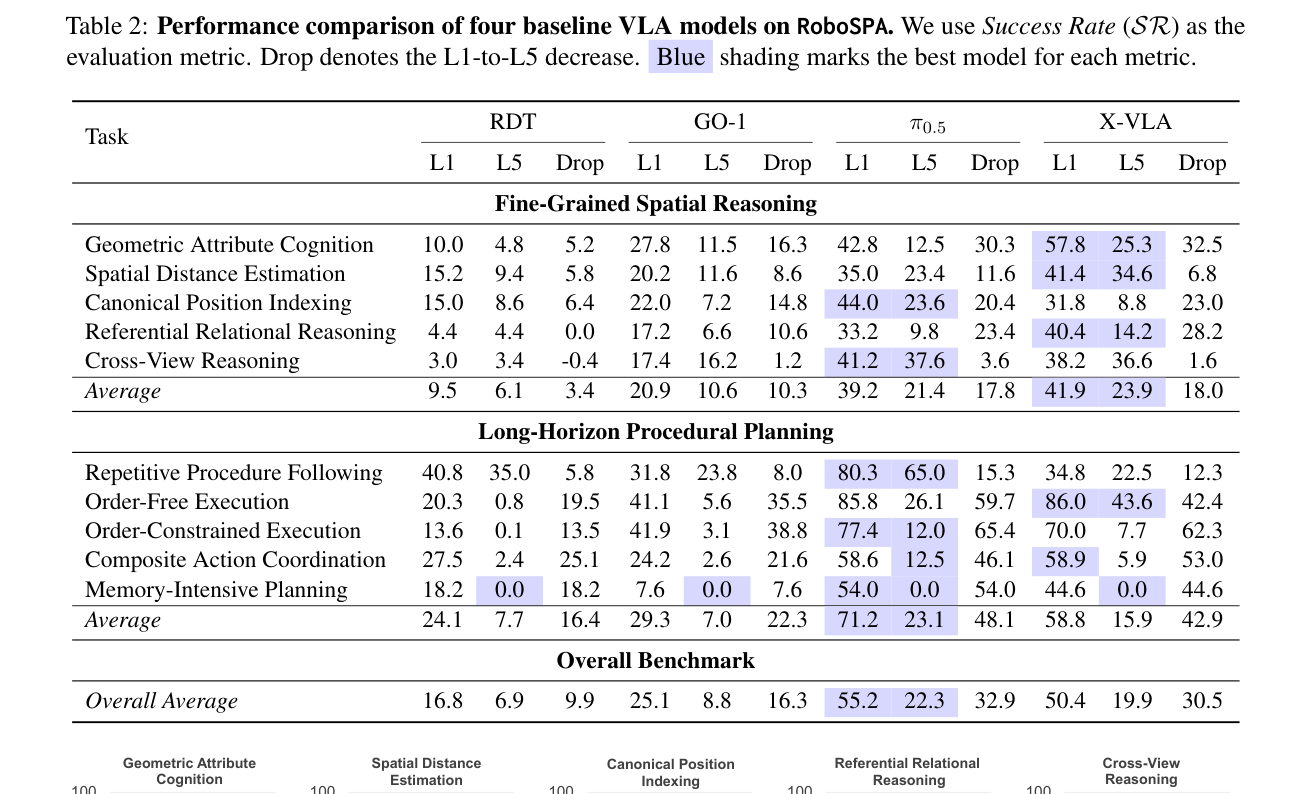
该表展示了四个VLA模型在RoboSPA上的Success Rate比较。观察该表可以了解模型在不同难度级别和任务类别上的性能退化趋势,以及Drop指标如何量化L1到L5的性能下降。
结论与局限
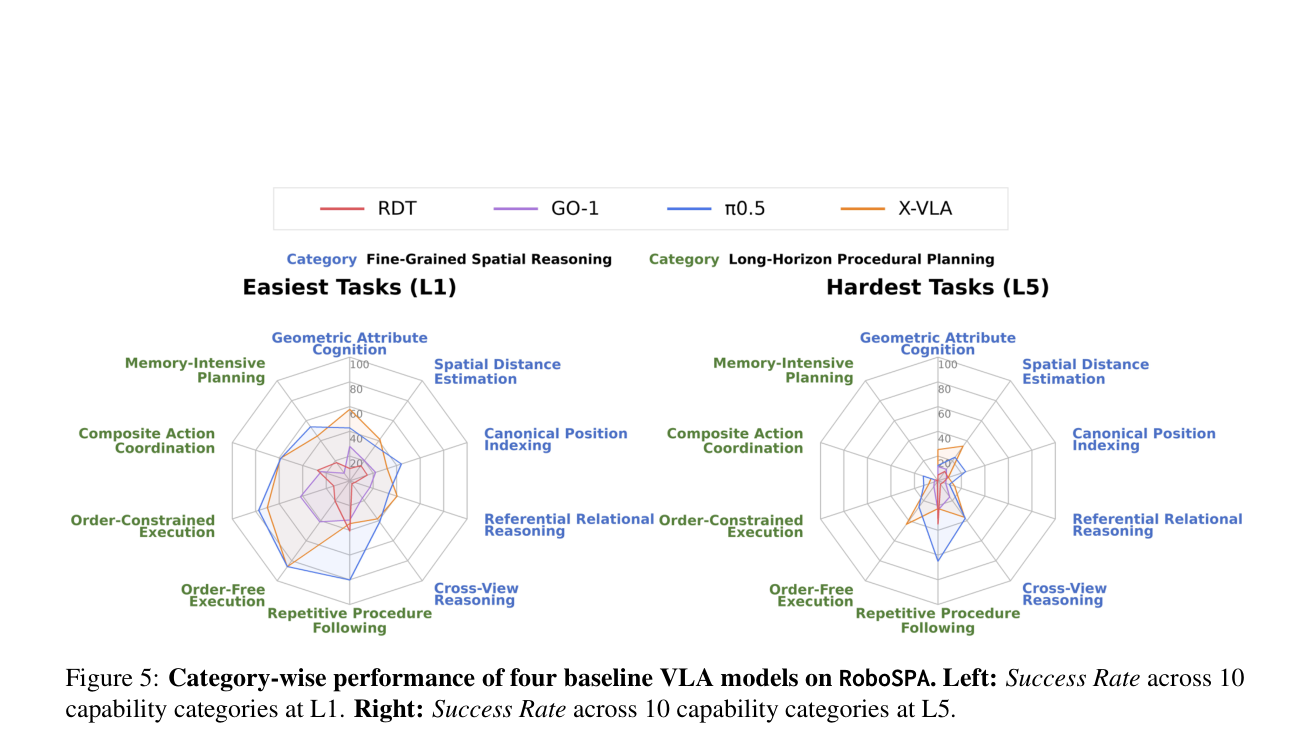
该图展示了四个VLA模型在10个能力类别上L1和L5难度的Success Rate。观察该图可以了解模型在不同能力维度上的性能差异,以及难度增加对性能的影响。
实验如何设计?
- 训练数据:Aloha-AgileX本体的干净场景数据,每个基础任务单独训练模型。
- 评估数据:每个难度级别独立评估,每个任务变体进行100次rollout试验。
- 评估模型:RDT, GO-1, π0.5, X-VLA四个代表性VLA模型。
- 评估指标:Success Rate (SR)、Object-Normalized Target Accuracy (ONT A)和Progress Score (PS)。
- 计算资源:NVIDIA RTX PRO 6000 GPUs,每个基础任务的训练计算预算见表6。
关键结果与论文证据
- 在L5难度下,π0.5的整体平均Success Rate为22.3%,X-VLA为19.9%,GO-1为8.8%,RDT为6.9%(第6页)。
- 在L5难度下,所有模型在Memory-Intensive Planning (MIP)任务上的Success Rate均为0%(第6页)。
- RDT和GO-1在大多数细粒度空间推理任务和难度级别上获得负的ONT A分数,表明其空间推理能力接近或低于随机选择(第7页)。
- π0.5在长视距程序规划任务上的平均Progress Score在L5难度下为45.4%,高于其Success Rate (23.1%),表明模型能部分完成程序但因累积错误失败(第7页)。
- 模型性能从L1到L5显著退化,表明VLA模型在复杂任务设置中推理能力有限(第6页)。
- 失败模式包括目标执行错误、目标接地错误、操作错误、记忆错误、时序排序错误和冗余重复错误,不同任务类别的失败模式不同(第8页)。
阅读时需要注意
- 所有任务均在模拟环境中构建,sim-to-real差距可能限制向物理机器人的直接迁移。
- 基准主要关注桌面操作,可能无法完全捕捉真实世界环境的多样性和开放性。
- 虽然包含多种机器人本体和域随机化场景,但可变形物体操作、人机交互和开放式任务指令等更广泛设置仍未充分探索。
- ONT A指标在物体数量较少时可能不稳定,需结合Success Rate综合评估。
- Progress Score反映部分完成情况,不能替代最终任务成功率的评估。
关联工作
- LIBERO:现有基准,主要关注短视距任务和知识迁移,缺乏细粒度空间推理和长视距程序规划评估(第2页)。
- RoboTwin 2.0:现有基准,提供强域随机化的双臂操作数据生成和评估,但缺乏细粒度空间推理和步骤级诊断(第2页)。
- π0.5:代表性VLA模型,在RoboSPA上表现最佳,但在高难度任务上仍显著退化(第6页)。
- X-VLA:代表性VLA模型,在细粒度空间推理维度表现最佳,但长视距规划能力有限(第6页)。
- RDT和GO-1:代表性VLA模型,在RoboSPA上表现较差,尤其在细粒度空间推理和长视距程序规划任务上(第6页)。