快速导读:DriveZero 通过解耦预训练(DriveRL 强化学习动作模型 + DriveVFM 视觉基础模型感知骨干)并蒸馏为纯相机端到端策略,在 nuPlan、NAVSIM 和 HUGSIM 基准上实现了超越人类驾驶员及现有 SOTA 的性能,且无需人类轨迹监督。
DriveZero 提出了一种超越人类演示的端到端自动驾驶框架,核心思想是将强化学习教师策略与视觉基础模型解耦,再通过蒸馏生成纯相机学生策略。该框架无需人类轨迹监督,即可在多个主流基准上实现超越人类驾驶员的性能。
系统由三部分构成:DriveRL 负责在混合智能体环境中训练特权教师策略,DriveVFM 通过聚合蒸馏多个冻结视觉基础模型构建驾驶专用视觉骨干,DriveZero 则利用 Winner-Takes-All 蒸馏机制将教师行为转移至纯相机策略,并结合目标增强生成多样化监督信号。
英文题目:DriveZero: End-to-End Driving Beyond Human Demonstrations
论文出处:arXiv 每日论文精选 · arXiv:2609.06055
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有端到端自动驾驶系统主要依赖模仿人类驾驶日志,导致学习行为受限于日志的质量和覆盖范围。日志通常缺乏对安全关键偏差、恢复动作及策略诱导状态的覆盖,使得模型在分布外场景容易出错。
强化学习能通过闭环交互优化行为,但直接视觉强化学习样本效率低且仿真成本高。特权强化学习教师策略结合视觉策略蒸馏是解决这一瓶颈的有效途径,但现有方法通常直接复用现成的视觉编码器,未针对驾驶任务优化感知表示。
此外,现有蒸馏方法往往依赖单一未来轨迹,无法生成多样化的监督信号,限制了学生策略对复杂场景的适应能力。
核心创新
- 提出 DriveRL 混合智能体闭环 RL 框架,支持日志回放、规则模型和自学习策略共存,实现无人类演示的行为学习。
- 提出 DriveVFM,通过聚合蒸馏多个冻结视觉基础模型构建统一驾驶骨干,无需检测、分割等任务特定标注。
- 引入目标增强(Goal Augmentation)机制,利用目标条件教师策略生成多样化且目标一致的轨迹,突破日志单一未来限制。
- 设计价值引导的推理时动作搜索(TTS),利用 PPO 训练的价值函数在推理阶段重新排序候选动作,提升鲁棒性。
方法概览
系统分为三部分:1. DriveRL:在由 nuPlan 日志构建的混合智能体交互世界中,通过 PPO 从零训练特权教师策略,输出 Beta 分布动作,并利用价值函数进行推理时动作搜索;2. DriveVFM:通过聚合蒸馏 DINOv3、SigLIP2、SAM 和 Depth Anything V2 等冻结视觉基础模型,构建无需任务标注的驾驶视觉骨干;3. DriveZero:纯相机学生策略,利用 DriveVFM 编码图像,通过 Winner-Takes-All 蒸馏 DriveRL 生成的轨迹,并结合目标增强生成多样化监督信号。
- DriveRL 在由 nuPlan 日志构建的混合智能体交互世界中,通过 PPO 从零训练特权教师策略,输出 Beta 分布动作,并利用价值函数进行推理时动作搜索。
- DriveVFM 通过聚合蒸馏 DINOv3、SigLIP2、SAM 和 Depth Anything V2 等冻结视觉基础模型,构建无需任务标注的驾驶视觉骨干,采用 PHI-S 标准化平衡不同基础模型的特征尺度。
- DriveZero 学生策略利用 DriveVFM 编码图像,通过 Winner-Takes-All 蒸馏 DriveRL 生成的轨迹,仅最接近教师轨迹的提案参与损失计算,提升训练效率。
- 目标增强机制通过改变导航意图生成多样化且目标一致的轨迹,突破日志单一未来限制,为学生策略提供更丰富的监督信号。
- 价值引导的推理时动作搜索利用 PPO 训练的价值函数在推理阶段重新排序候选动作,提升鲁棒性,但仅在候选动作价值显著高于模态动作时才替换,采用保守策略。
逐图理解论文
核心贡献
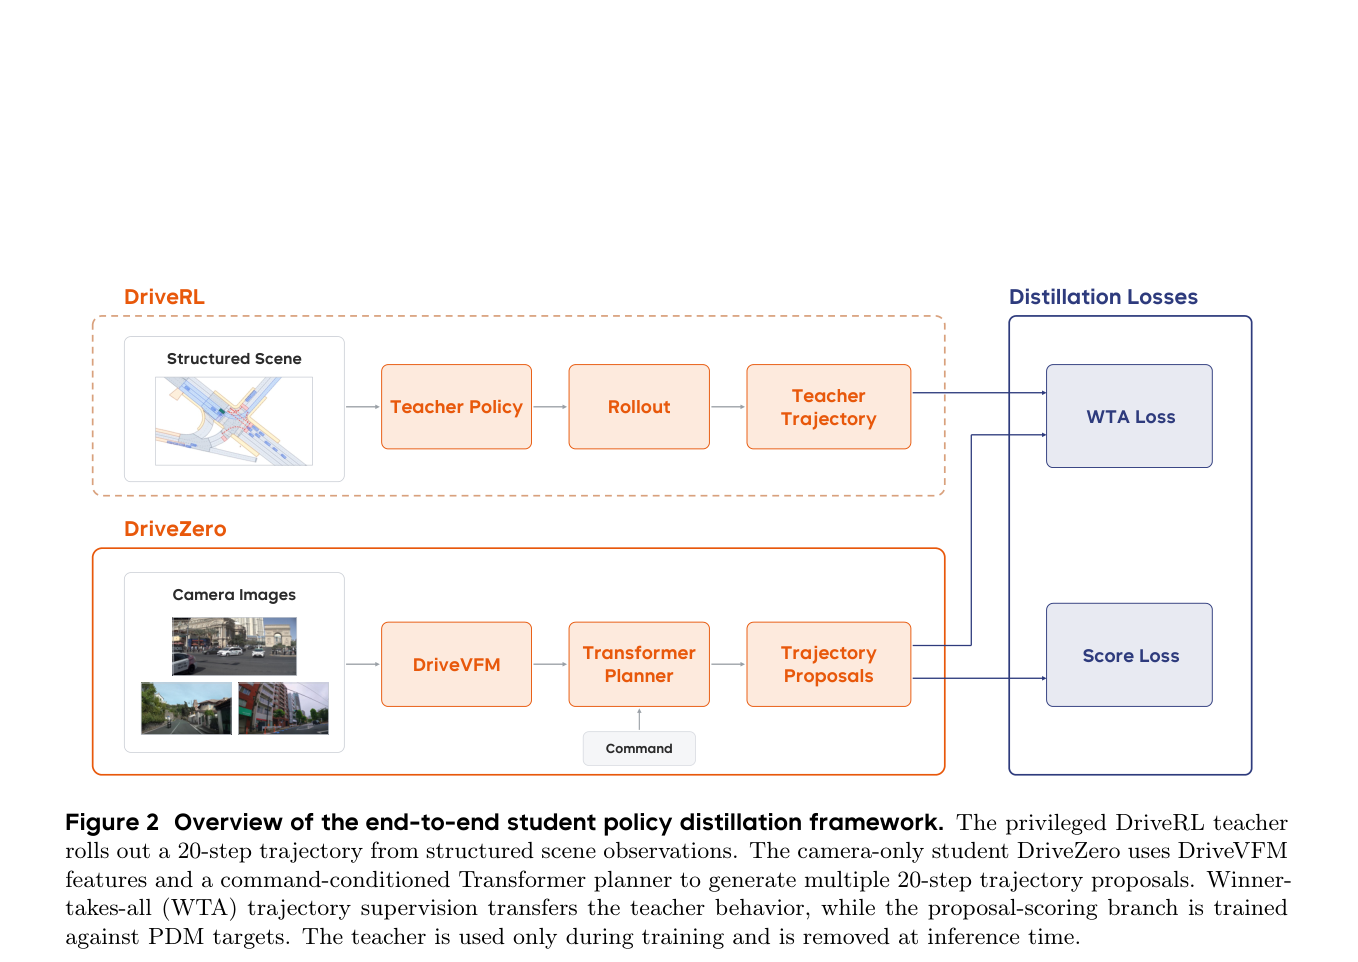
该图展示了端到端学生策略蒸馏框架的整体架构。需重点观察特权 DriveRL 教师如何从结构化场景观测中生成 20 步轨迹,以及纯相机学生 DriveZero 如何利用 DriveVFM 特征和命令条件 Transformer 生成多个轨迹提案。Winner-Takes-All 监督机制和提案评分分支的训练目标也需仔细检查,以理解教师行为如何转移至学生策略。
关键验证
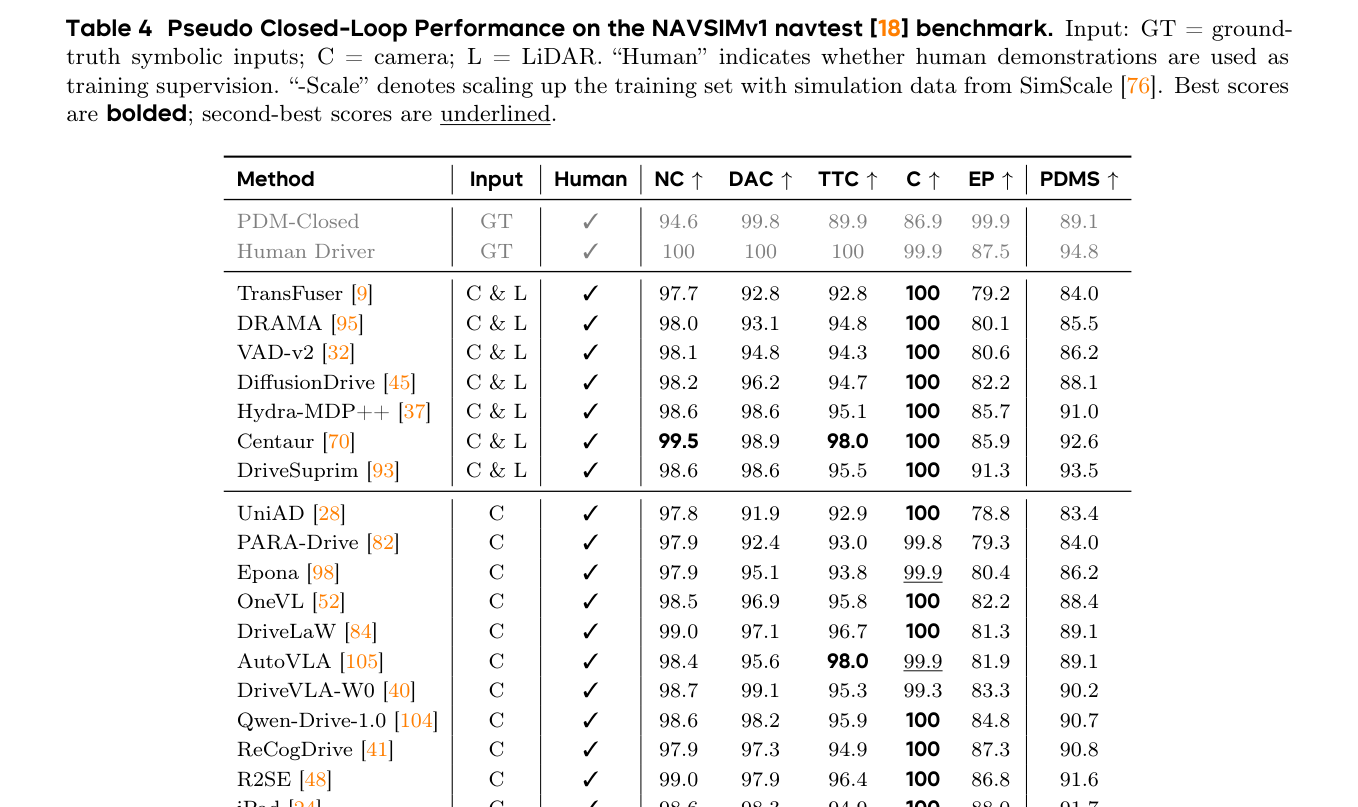
该表展示了 NAVSIMv1 navtest 基准上的伪闭环性能。需对比 DriveZero 与人类驾驶员、DrivoR 和 GigaPixel 的 PDMS 分数,特别关注 DriveZero-Scale 是否超越人类驾驶员。同时检查各组件(NC, DAC, TTC, C, EP)的分数,以理解综合评分的来源。
结论与局限
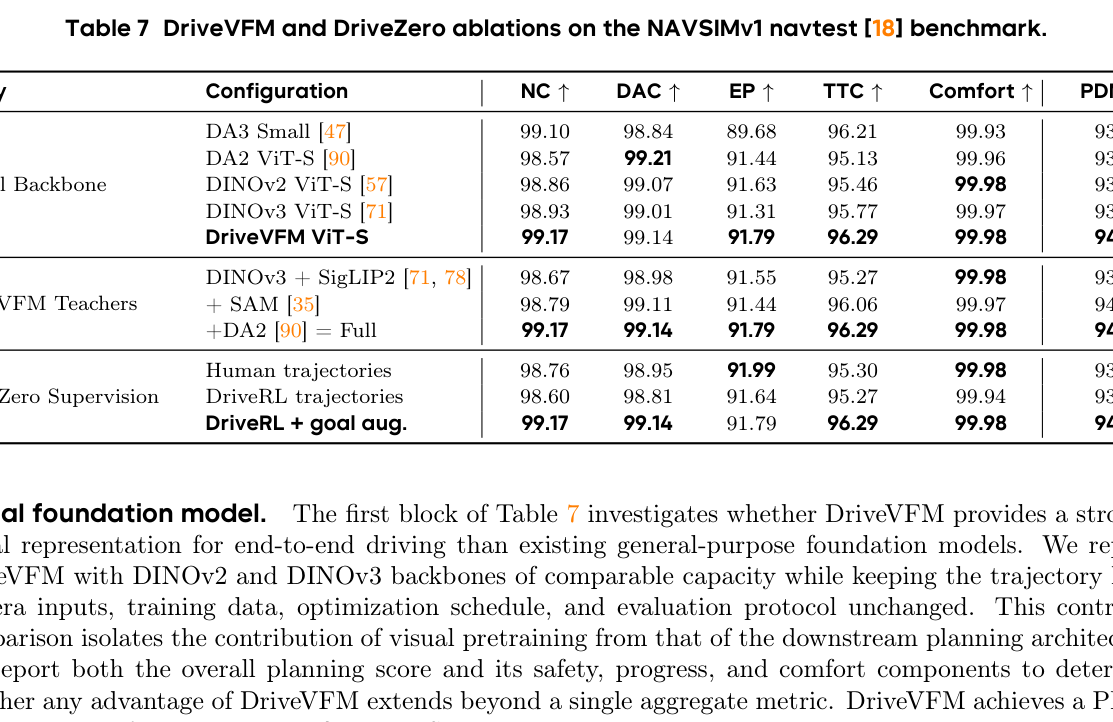
该表展示了 DriveVFM 和 DriveZero 的消融实验结果。需分析视觉骨干(DriveVFM vs DINOv3)、教师模型贡献(SAM, Depth Anything V2)及监督信号(人类 vs RL vs RL+目标增强)对 PDMS 的影响,以理解各组件的贡献。
实验如何设计?
- nuPlan 闭环基准:评估 DriveRL 在 Val14、Test14-hard、Test14-random 的非反应和反应模式下的表现,对比 Log-Replay、CaRL 和 GigaFlow 等方法。
- NAVSIMv1 navtest 伪闭环基准:评估 DriveZero 的 PDMS 及其组件,对比 DrivoR、GigaPixel 等现有 SOTA 方法,并分析 SimScale 数据增强的影响。
- NAVSIMv2 navhard 伪闭环基准:评估 DriveZero 的 EPDMS 及其两阶段评分,对比 PDM-Closed 等使用 GT 符号输入的方法。
- HUGSIM 真闭环基准:评估 DriveZero 的零样本泛化能力,包括路线完成度和 HD-Score,对比 GigaPixel 等方法。
- 消融实验:在 NAVSIMv1 navtest 上分析视觉骨干、教师模型贡献及监督信号的影响,使用 ViT-S 骨干和 navtrain 分割,无 SimScale 数据。
关键结果与论文证据
- DriveRL 在 nuPlan 六个设置上的平均分为 93.01,应用 TTS 后提升至 93.57,超过 Log-Replay 专家,并在所有设置上超越 CaRL 和 GigaFlow(第 9 页)。
- DriveZero 在 NAVSIMv1 navtest 上达到 94.8 PDMS,与人类驾驶员持平;DriveZero-Scale 达到 95.3 PDMS,超越人类驾驶员(第 11 页)。
- DriveZero-Scale 在 NAVSIMv2 navhard 上达到 57.1 EPDMS,超越 DrivoR-Scale(54.6)和 PDM-Closed(56.6)(第 12 页)。
- DriveZero-Scale 在 HUGSIM 上实现零样本平均 HD-Score 46.6,超越 GigaPixel(38.5)8.1 分(第 13 页)。
- 消融实验显示,DriveVFM 骨干比 DINOv3 ViT-S 高 0.53 PDMS;添加 SAM 和 Depth Anything V2 教师分别带来 +0.41 和 +0.31 PDMS 提升(第 13 页)。
- DriveRL + 目标增强监督比纯人类轨迹监督高 0.49 PDMS,比纯 DriveRL 蒸馏高 0.80 PDMS(第 13 页)。
阅读时需要注意
- DriveRL 训练需要大量 GPU 资源(96 GPUs, 2048 worlds/rank)和较长时间(约 21 小时)。
- DriveZero 学生策略在训练时是开环的,未进入交互式环境,可能限制其对动态交互的感知。
- TTS 推理时搜索增加了计算开销,且保守策略可能限制潜在收益。
- HUGSIM 评估为零样本,未针对该基准微调,可能未完全发挥模型潜力。
关联工作
- CaRL 和 GigaFlow 是同样使用闭环 RL 但无人类数据的对比方法,DriveRL 在所有设置上超越它们(第 10 页)。
- DrivoR 使用 register tokens 压缩相机特征,DriveZero 架构借鉴其设计但使用 DriveVFM 骨干(第 11 页)。
- GigaPixel 基于 RL 教师蒸馏,DriveZero-Scale 在 NAVSIMv2 和 HUGSIM 上显著超越 GigaPixel(第 12 页)。
- RADIO 是 DriveVFM 的方法基础,遵循其聚合蒸馏和 PHI-S 标准化思路,但针对驾驶任务定制(第 17 页)。
- PDM-Closed 使用 GT 符号输入,DriveZero-Scale 在 NAVSIMv2 上超越其 EPDMS(第 12 页)。