快速导读:本文提出利用Cross-Layer Transcoders (CLTs)从Vision Transformers (ViTs)中提取全局和实例级概念电路,以揭示模型内部的世界知识、自动发现并移除虚假相关,以及比较不同监督范式下的模型结构差异。
本文提出利用Cross-Layer Transcoders (CLTs)从Vision Transformers (ViTs)中提取全局和实例级概念电路,以揭示模型内部的世界知识、自动发现并移除虚假相关,以及比较不同监督范式下的模型结构差异。
现有可解释机器学习(IML)方法主要关注模型关注何处(如Saliency maps),而非模型如何理解视觉世界;Sparse Autoencoders (SAEs) 虽能分解特征,但主要捕捉输入依赖行为,且获取全局视图需要昂贵的数据集级归因计算。
英文题目:“World Knowledge” in the Weights: Reading Concept Circuits of Vision Transformers
论文出处:arXiv 每日论文精选 · arXiv:2609.09055
原始论文:PDF / 论文页面
这篇论文解决什么问题?
ViTs在视觉领域取得了显著成功,但其内部机制仍是黑盒,导致难以审计其依赖虚假相关(spurious correlations)等失败模式。理解ViTs编码的概念及其跨层交互对于安全关键领域的应用至关重要。
现有IML方法如Saliency maps只能指出模型关注的像素区域,无法解释为何某些特征被赋予高权重,更无法定位虚假相关在模型内部的具体位置。
SAEs虽能分解特征,但主要捕捉输入依赖行为,获取全局视图需要昂贵的数据集级归因计算,难以揭示模型通用的“世界知识”。
因此,需要一种既能揭示模型通用“世界知识”、又能高效定位实例级概念交互的轻量级工具,以支持虚假相关发现与移除。
核心创新
- 首次将CLTs适配到ViTs,验证了其在视觉数据上的有效性。
- 提出从ViTs中读取全局概念电路的方法,无需昂贵的数据集级归因即可揭示模型通用的“世界知识”。
- 展示了概念电路在自动发现虚假相关、移除虚假相关(提升Waterbird数据集准确率11.0%)以及比较不同基础模型内部结构方面的应用。
方法概览
将CLTs适配到ViTs,通过训练CLTs近似Transformer的MLP计算。利用CLTs的输入不变权重直接读取全局概念电路(Global Concept Circuits),利用稀疏激活提取实例概念电路(Instance Concept Circuits)。通过归因补丁(attribution patching)和跨token聚合简化电路结构。
- 将CLTs适配到ViTs,通过训练CLTs近似Transformer的MLP计算,利用CLTs的输入不变权重直接读取全局概念电路(Global Concept Circuits)。
- 利用CLTs的稀疏激活提取实例概念电路(Instance Concept Circuits),并通过归因补丁(attribution patching)和跨token聚合简化电路结构,避免ViTs大量token(如196个)导致的电路过于复杂。
- 通过共激活统计重新加权全局权重,以区分虚假相关概念(高全局权重但低共激活)、非判别性概念(高共激活但低全局权重)和因果概念(高全局权重和高共激活)。
- 在实例概念电路干预中,通过干预中间层表示而非仅最后一层,实现更有效的虚假相关移除和模型Steering。
- 比较CLIP、DINO和ImageNet-supervised ViT的全局概念电路结构差异,揭示不同监督范式对模型内部结构的塑造作用。
逐图理解论文
失败直觉
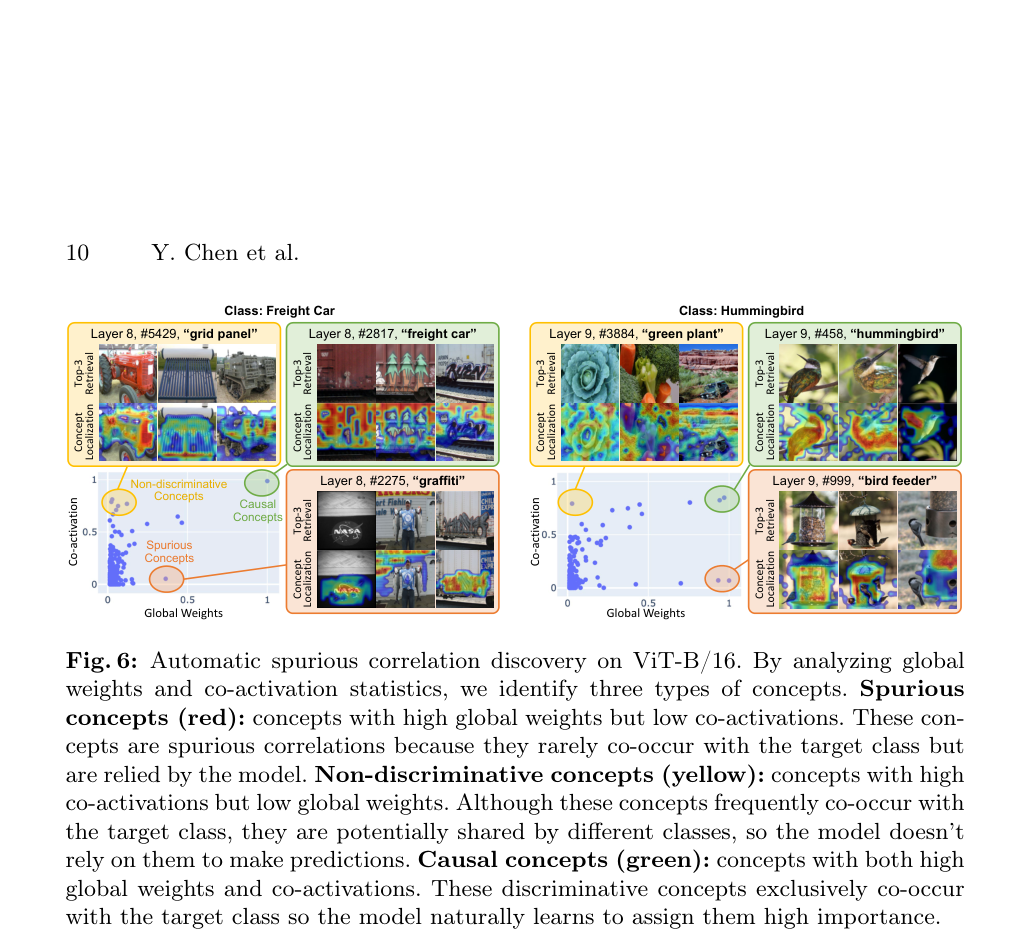
该图展示了ViT-B/16上的自动虚假相关发现。通过分析全局权重和共激活统计,识别三种类型概念:虚假概念(红色,高全局权重但低共激活)、非判别性概念(黄色,高共激活但低全局权重)和因果概念(绿色,高全局权重和高共激活)。该图直观展示了如何区分虚假相关和因果概念。
研究缺口
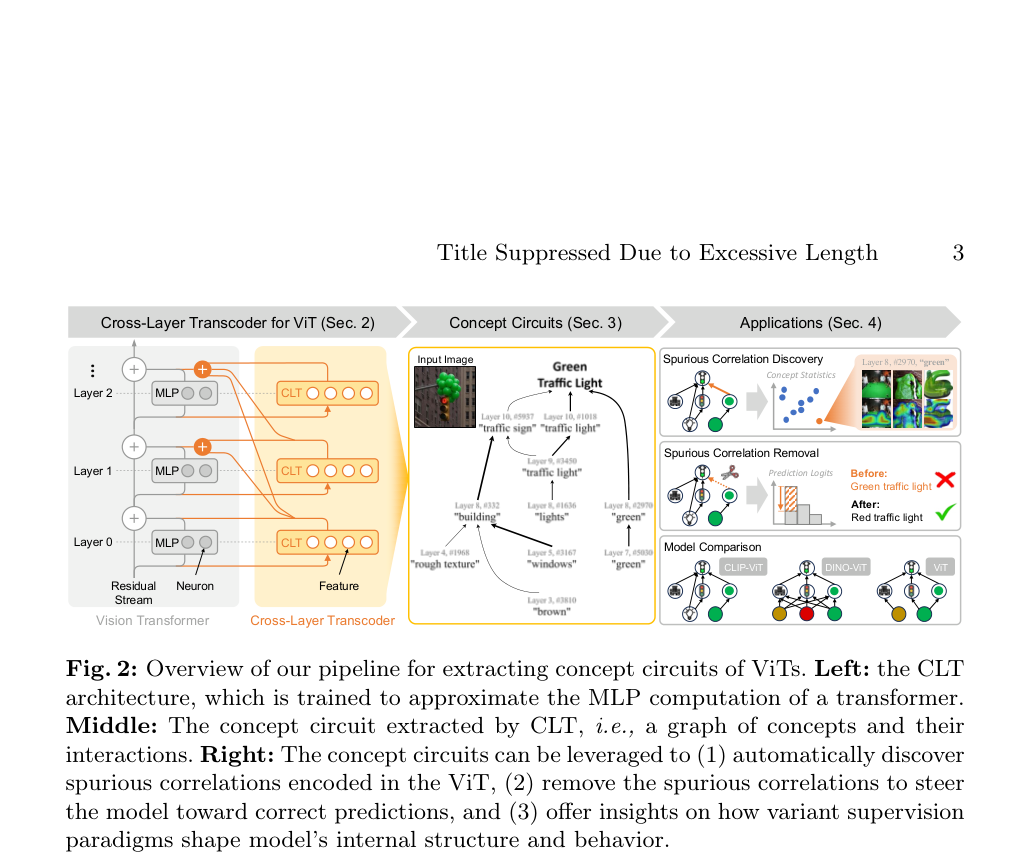
该图展示了从ViTs中提取概念电路的流水线。左侧为CLT架构,训练以近似Transformer的MLP计算;中间为CLT提取的概念电路,即概念及其交互的图;右侧为概念电路的三种应用:自动发现虚假相关、移除虚假相关以Steering模型、提供不同监督范式如何塑造模型内部结构的见解。该图是理解本文方法的核心。
最强结论
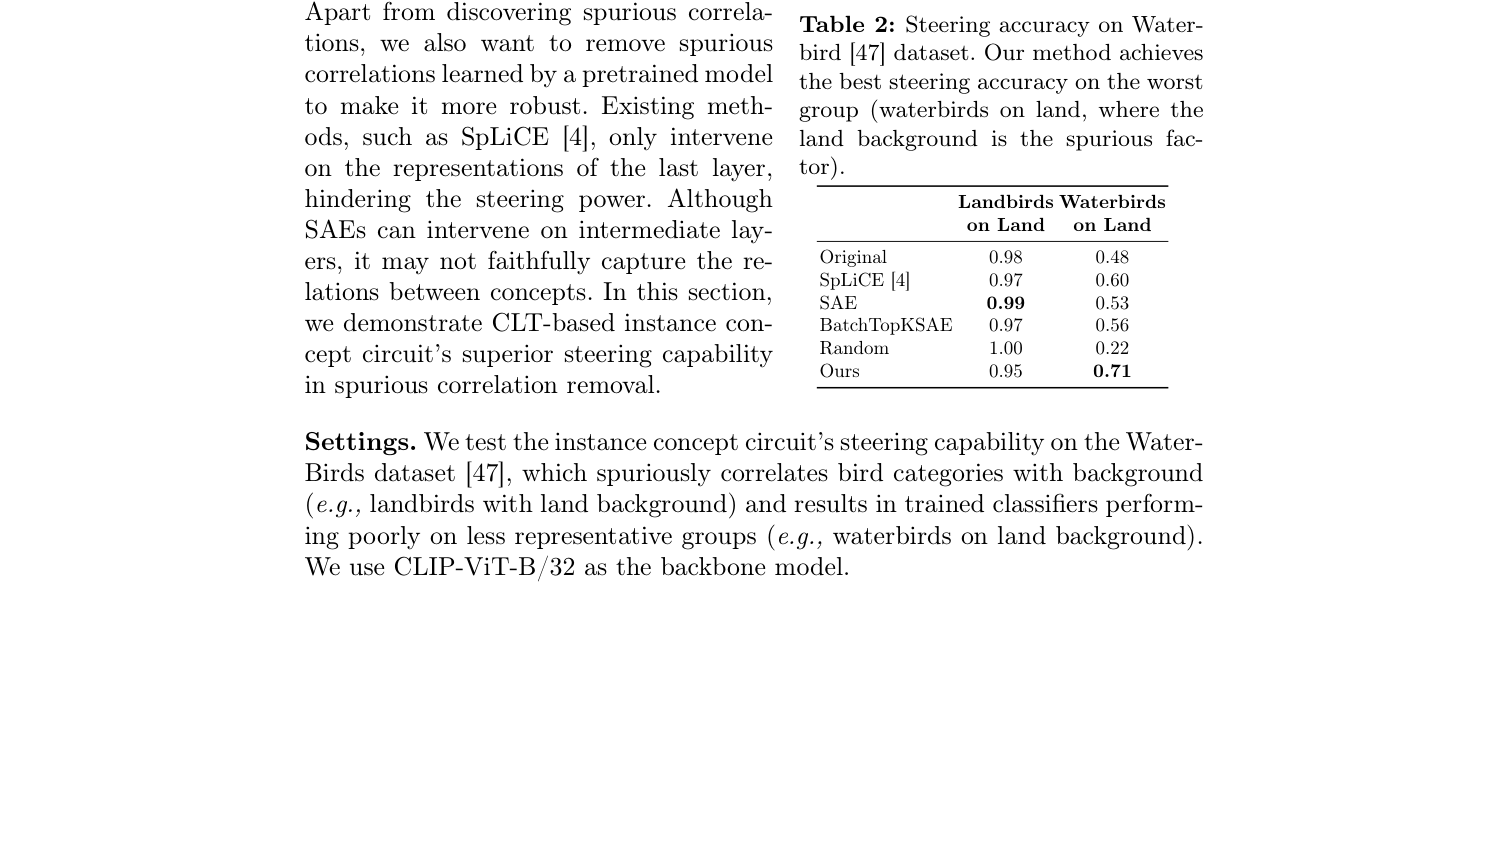
该表展示了Waterbird数据集上的Steering accuracy。本文方法在最困难组(陆地上的水鸟,其中陆地背景是虚假因素)上达到最佳Steering accuracy。该表提供了概念电路在虚假相关移除中有效性的定量证据。
意义与局限
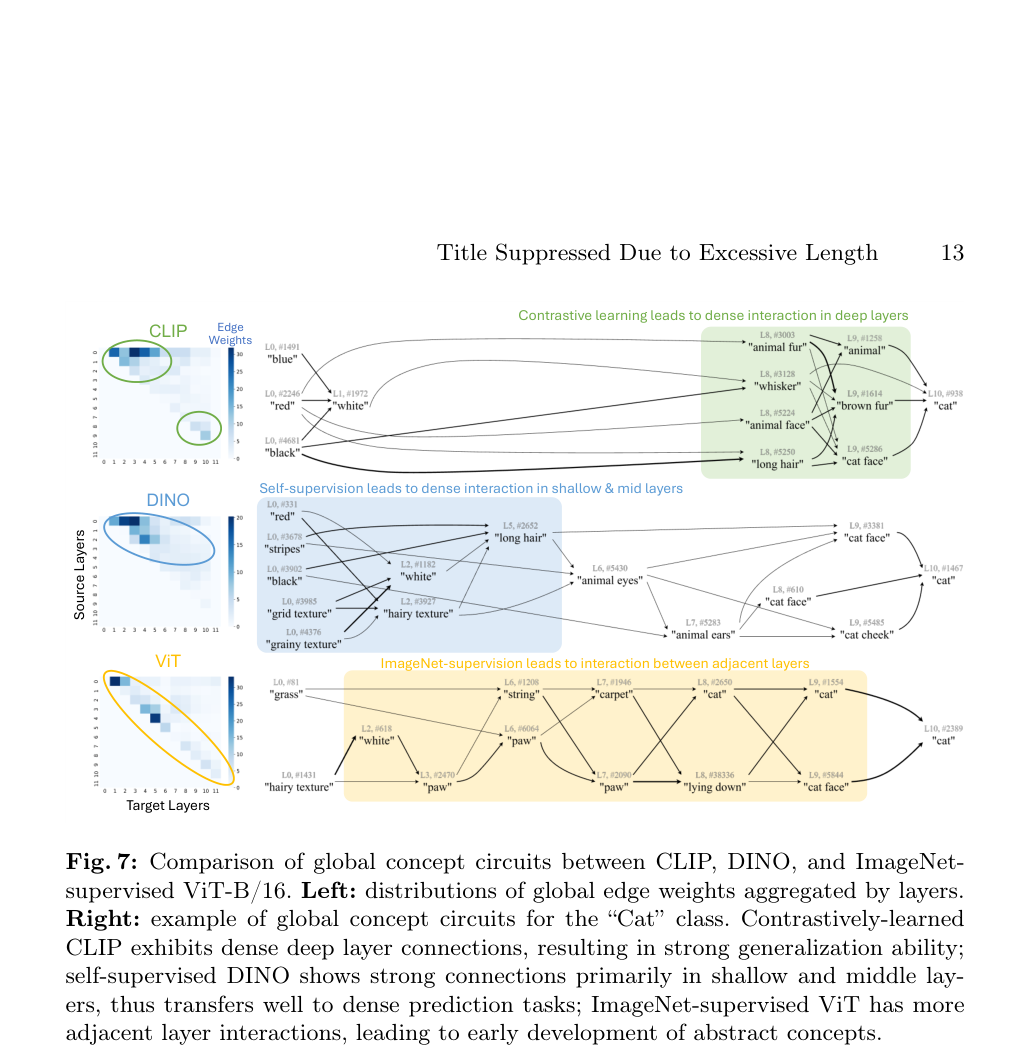
该图比较了CLIP、DINO和ImageNet-supervised ViT-B/16的全局概念电路。左侧为按层聚合的全局边权重分布;右侧为“Cat”类的全局概念电路示例。对比学习的CLIP表现出密集深层连接,导致强泛化能力;自监督的DINO在浅层和中间层表现出强连接,因此对密集预测任务迁移良好;ImageNet-supervised ViT有更多相邻层交互,导致抽象概念早期发展。该图揭示了不同监督范式对模型内部结构的塑造作用。
实验如何设计?
- 在ImageNet验证集上通过消融实验验证全局概念电路的有效性,评估50个随机选择类别的平均准确率下降。
- 在CLIP、DINO和supervised ViT上比较CLT-based和SAE-based实例概念电路的Faithfulness和Completeness,评估50个随机采样类别。
- 在Waterbird数据集上评估移除虚假相关后的Steering accuracy,重点关注“陆地上的水鸟”这一最困难子集。
- 比较CLIP、DINO和ImageNet-supervised ViT的全局概念电路结构差异,分析不同监督范式对模型内部结构的影响。
关键结果与论文证据
- 在ImageNet验证集上,消融全局概念电路中top-10重要概念导致CLIP平均准确率从0.60降至0.22,验证了全局概念电路对模型预测的关键作用(第7页)。
- 在CLIP上,CLT-based实例概念电路在Faithfulness上比SAE-based方法高24.4%,在Completeness上高22.1%,验证了CLT对模型内部机制的忠实反映(第10页)。
- 在Waterbird数据集上,本文方法在“陆地上的水鸟”最困难子集上达到0.71的Steering accuracy,优于SpLiCE(0.60)和SAE(0.53),验证了概念电路在虚假相关移除中的有效性(第11页)。
- CLIP表现出密集深层连接,导致强泛化能力;DINO在浅层和中间层表现出强连接,因此对密集预测任务迁移良好;ImageNet-supervised ViT有更多相邻层交互,导致抽象概念早期发展(第13页)。
阅读时需要注意
- CLTs主要捕捉MLP路径,仅间接反映注意力结构,可能遗漏注意力机制对概念交互的贡献。
- 概念解释需要人工检查,自动化解释生成仍具挑战性。
- 全局图未完全捕捉因果关系,共激活统计重新加权可能引入偏差。
关联工作
- Sparse Autoencoders (SAEs):对比方法,SAE主要捕捉输入依赖行为,获取全局视图成本高;本文使用CLT获取输入不变的全局视图(第3页)。
- SpLiCE:对比方法,SpLiCE仅干预最后一层表示,本文通过实例概念电路干预中间层,效果更优(第11页)。
- Mechanistic Interpretability:本文遵循自底向上的机制可解释性视角,但专注于使用CLT提取ViT中的概念级电路(第14页)。