快速导读:FIRE3D 提出了一种统一的前馈框架,能够从单张RGB图像或随意拍摄的RGB视频中,在60秒内重建出包含完整几何、纹理和6-DoF位姿的仿真就绪3D场景资产,无需测试时优化或额外标注。
FIRE3D 提出了一种统一的前馈框架,能够从单张RGB图像或随意拍摄的RGB视频中,在60秒内重建出包含完整几何、纹理和6-DoF位姿的仿真就绪3D场景资产,无需测试时优化或额外标注。
该框架通过实例感知3D场景感知网络、层级压缩VAE(HC-VAE)和基于点云条件的级联流匹配生成模型,实现了单GPU上并行生成16个以上对象,并在多个数据集上验证了速度和质量优势。
英文题目:FIRE3D: Feed-forward Interactive 3D Scene Reconstruction Within A Minute
论文出处:arXiv 每日论文精选 · arXiv:2609.08848
原始论文:PDF / 论文页面
这篇论文解决什么问题?
3D场景重建在AR/VR、机器人和游戏领域至关重要,但现有方法存在显著瓶颈。传统NeRF/3DGS方法生成不可编辑的场或点云,基于优化的方法速度慢,前馈方法通常缺乏对象级完整性或纹理。
具体而言,现有方法要么依赖昂贵的测试时优化(如HoloScene),要么需要预分割输入、外部感知网络或逐对象顺序推理,无法快速、端到端地从未分割的RGB-D观测中重建出可交互、仿真就绪的完整纹理化3D场景。
FIRE3D 旨在填补这一空白,实现快速、前馈、对象级的纹理化场景重建,为 AR/VR、机器人和游戏领域提供高效、可交互的3D资产生成方案。
核心创新
- 提出HC-VAE层级压缩机制,将对象潜空间压缩至极小尺寸(8^3×64),支持单GPU上并行生成16个以上对象,实现5倍以上加速。
- 设计统一的前馈框架,无需外部感知网络或用户提示,直接从带位姿的RGB-D观测中联合完成实例感知和纹理化重建。
- 构建大规模训练语料库(80k场景、140k视频片段、500k对象),结合Flux.2生成逼真图像增强数据多样性,提升模型泛化能力。
方法概览
FIRE3D包含三个核心组件:(1) 实例感知3D场景感知网络,从带位姿的RGB-D观测中预测对象有效性、位姿和3D实例掩码;(2) 层级压缩VAE(HC-VAE),在SC-VAE基础上进一步压缩对象潜空间至8^3×64,实现32倍压缩;(3) 基于点云条件的级联流匹配生成模型,并行生成结构、形状和材质潜变量,最终解码为纹理网格并组装场景。
- 实例感知3D场景感知网络:从带位姿的RGB-D观测中预测对象有效性、位姿和3D实例掩码,无需外部感知网络或用户提示。
- 层级压缩VAE(HC-VAE):在SC-VAE基础上进一步压缩对象潜空间至8^3×64,实现32倍压缩,支持单GPU上并行生成16个以上对象。
- 基于点云条件的级联流匹配生成模型:并行生成结构、形状和材质潜变量,最终解码为纹理网格并组装场景。
- 大规模训练语料库:包含80k场景、140k视频片段、500k对象,结合Flux.2生成逼真图像增强数据多样性,提升模型泛化能力。
- 统一前馈框架:直接从带位姿的RGB-D观测中联合完成实例感知和纹理化重建,无需测试时优化或额外标注。
逐图理解论文
现有方法的瓶颈
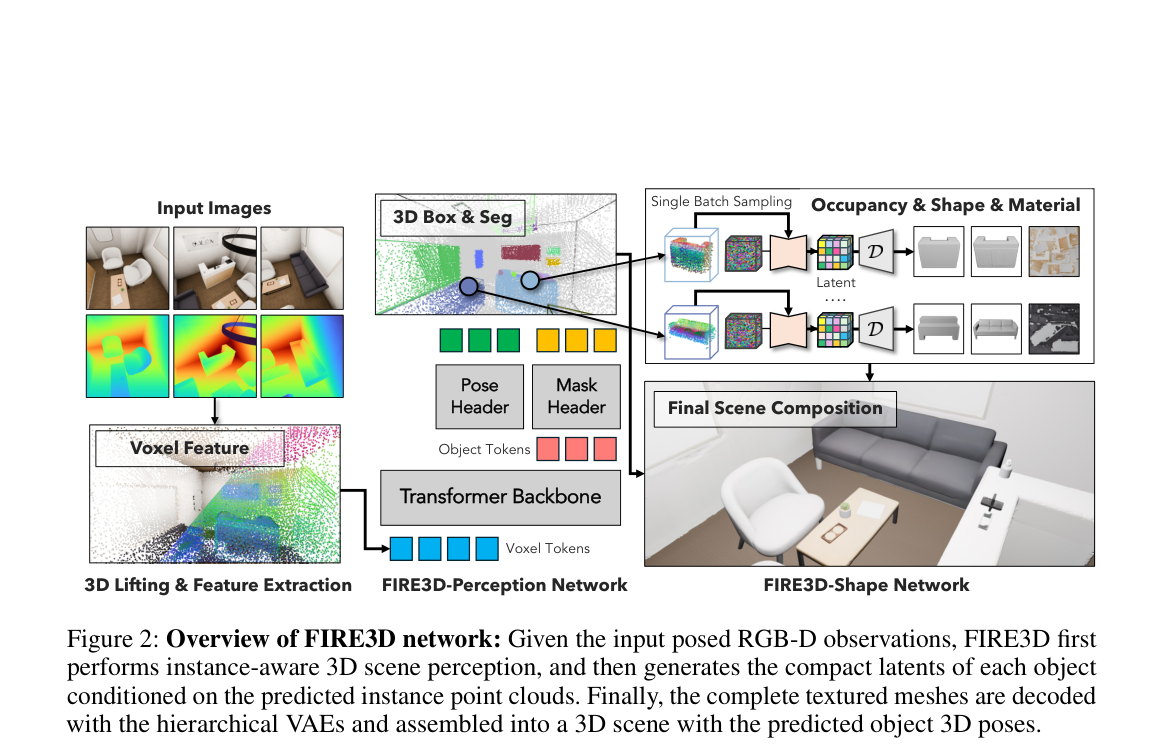
该图展示了FIRE3D网络架构,包括实例感知3D场景感知、对象潜变量生成和纹理网格解码。重点观察各模块的数据流,理解前馈框架如何实现联合感知和重建。
核心区分与研究空白
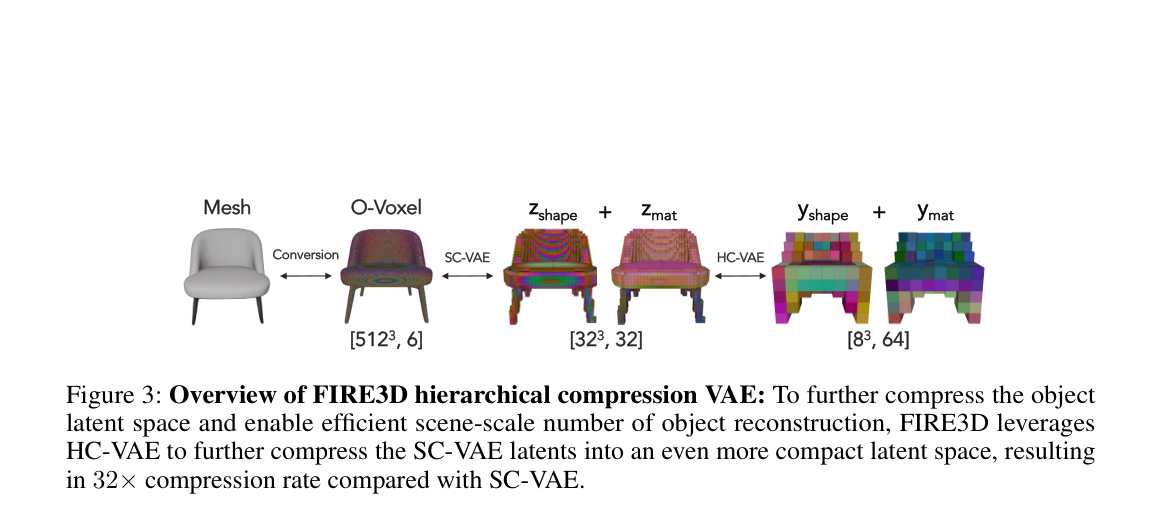
该图展示了HC-VAE层级压缩机制,将SC-VAE潜变量进一步压缩至8^3×64。重点观察压缩前后的潜空间维度,理解32倍压缩如何实现场景级并行生成。
方法贡献与验证
该表展示了视频3D场景重建的定量结果,对比了FIRE3D与基线方法在GT和推断感知下的性能。重点观察CD、F1、NC指标,理解FIRE3D在几何和纹理质量上的优势。
最强结论
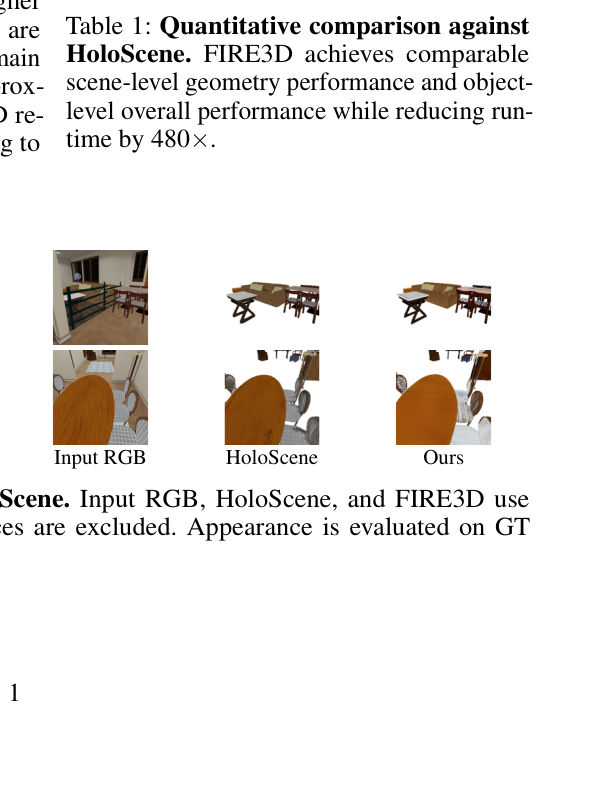
该表展示了FIRE3D与HoloScene的定量对比,验证了480倍加速和相当的几何性能。重点观察运行时间和CD指标,理解前馈框架在速度和质量上的平衡。
意义与局限
FIRE3D 为 AR/VR、机器人和游戏提供了高效3D资产生成方案,但仅适用于静态室内场景,且依赖外部几何预处理。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在AEO、iTHOR、Imaginarium等数据集上评估视频感知和重建性能,对比SceneScript、EFM3D、Boxer、ShapeR、SAM3D等基线。
- 在3D-Front数据集上评估单图像重建性能,对比Gen3DSR、MIDI、SceneGen。
- 与HoloScene、SimRecon、LiteReality及模块化流水线(Boxer+SAM2+TRELLIS.2)进行端到端对比,验证速度和质量优势。
- 消融实验分析输入位姿和深度噪声对性能的影响,以及HC-VAE压缩对重建质量的影响。
关键结果与论文证据
- 端到端推理时间 < 60秒(12个对象以上),相比HoloScene加速480倍(~1分钟 vs ~8小时)。
- 感知mAP: 0.52 (AEO), 0.58 (Imaginarium); mIoU: 0.41 (AEO), 0.46 (Imaginarium)。
- 重建CD: 1.08 cm (GT, Imaginarium); F1: 0.68; NC: 0.82。
- 单图像重建CD: 11.24 cm (3D-Front); F1: 0.10; NC: 0.66。
- 相比SimRecon加速31.93倍(8.23s vs 262.74s/场景)。
- 相比LiteReality几何重建加速7.46倍(2.44s vs 18.21s/对象)。
- HC-VAE压缩32倍后,Toys4K CD从0.261增至0.269,PSNR从26.801降至26.635。
阅读时需要注意
- 仅适用于静态室内场景,不支持动态或可变形物体。
- 依赖外部几何预处理(如Pi3)估计带位姿的RGB-D观测,RGB-only输入需额外步骤。
- 生成资产尚未保证物理稳定性、可重光照性或可关节化。
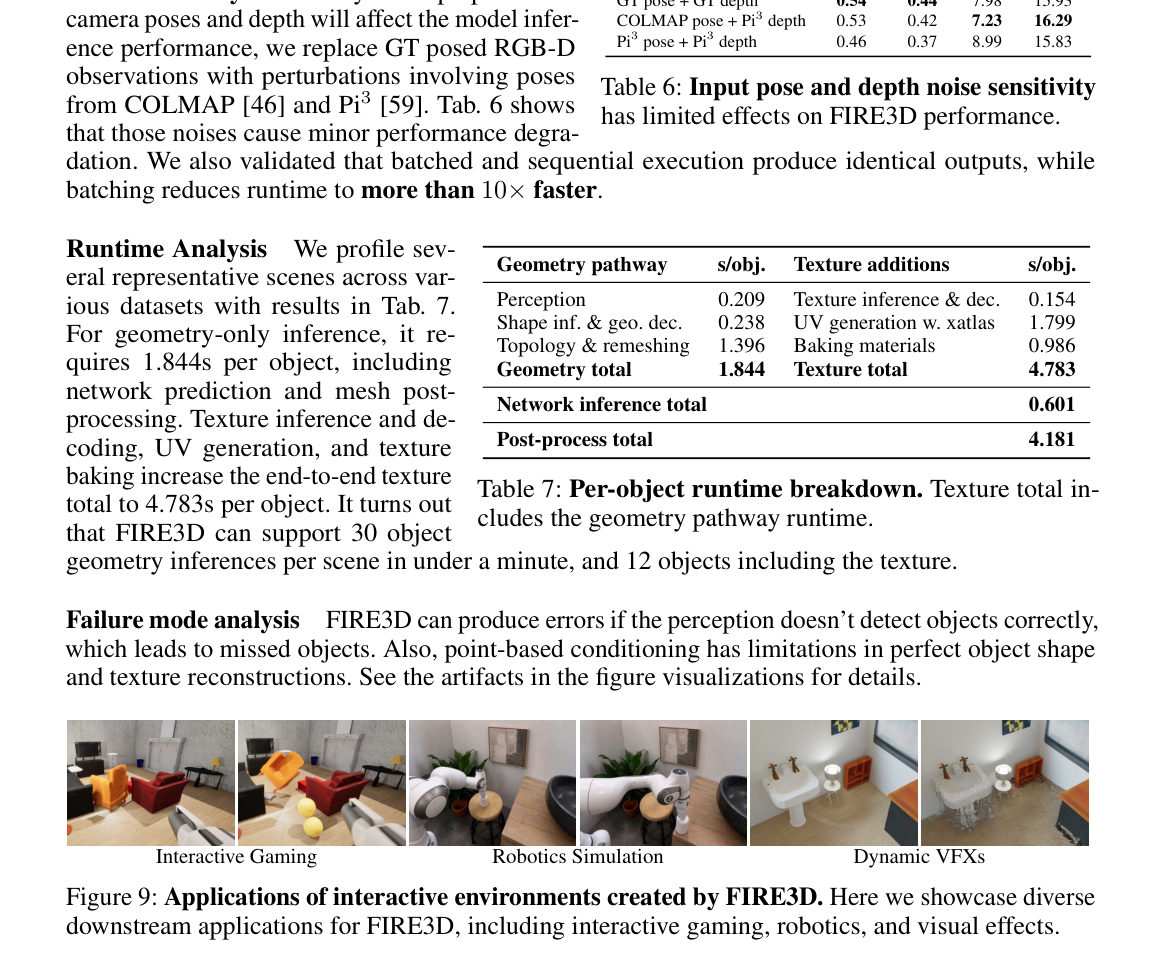
- 点云条件生成在完美重建物体形状和纹理方面存在局限性,可能出现伪影。
关联工作
- HoloScene:对比基线,优化方法,速度慢(~8小时/场景)。
- SimRecon:对比基线,优化方法,感知性能较低。
- LiteReality:对比基线,lift-then-instance流水线,几何精度较低。
- TRELLIS.2:SC-VAE来源,单对象生成,不支持场景级并行。
- ShapeR:对比基线,依赖文本提示和预分割,无纹理生成。
- SAM3D:对比基线,依赖用户点击,多视图一致性差。
- Gen3DSR, MIDI, SceneGen:单图像重建对比基线,FIRE3D在几何一致性上更优。
- Pi3:用于估计RGB输入的位姿和深度。
- Flux.2:用于生成逼真图像增强训练数据。