RYOPO:把端到端类别级物体位姿估计做到实时
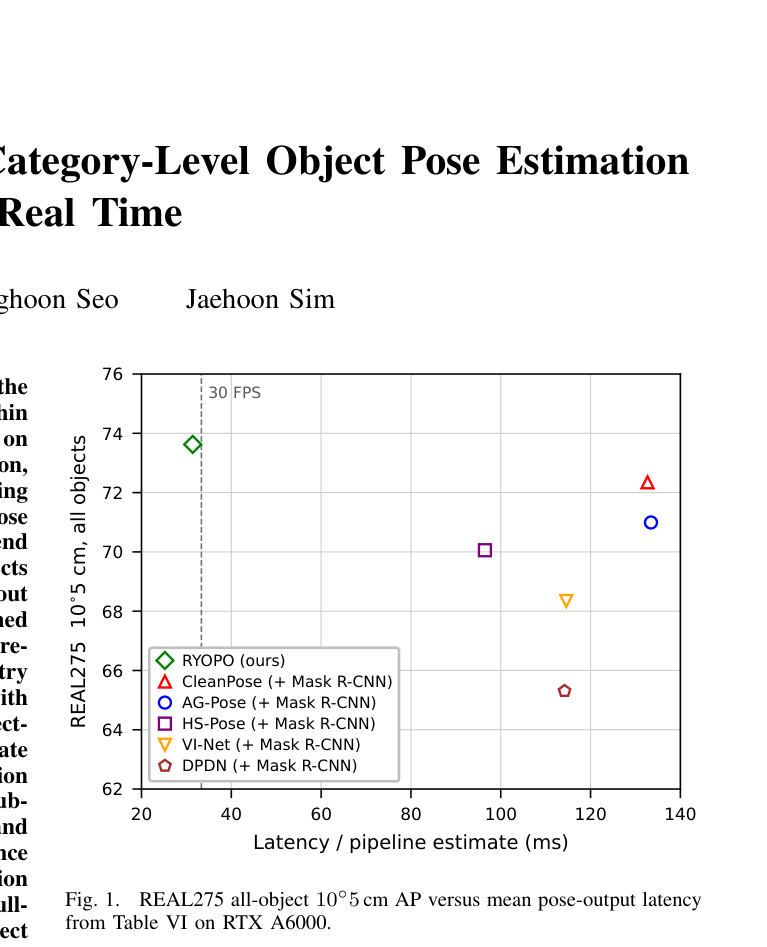
RYOPO 用查询式 RGB-D 集合预测把检测、分割与 9-DoF 位姿联在同一前向中,共享编码并做物体中心精炼,在 NOCS 上超过已发表联合方法,并以 31.8 FPS 接近两阶段全物体成绩。
RYOPO 用查询式 RGB-D 集合预测把检测、分割与 9-DoF 位姿联在同一前向中,共享编码并做物体中心精炼,在 NOCS 上超过已发表联合方法,并以 31.8 FPS 接近两阶段全物体成绩。
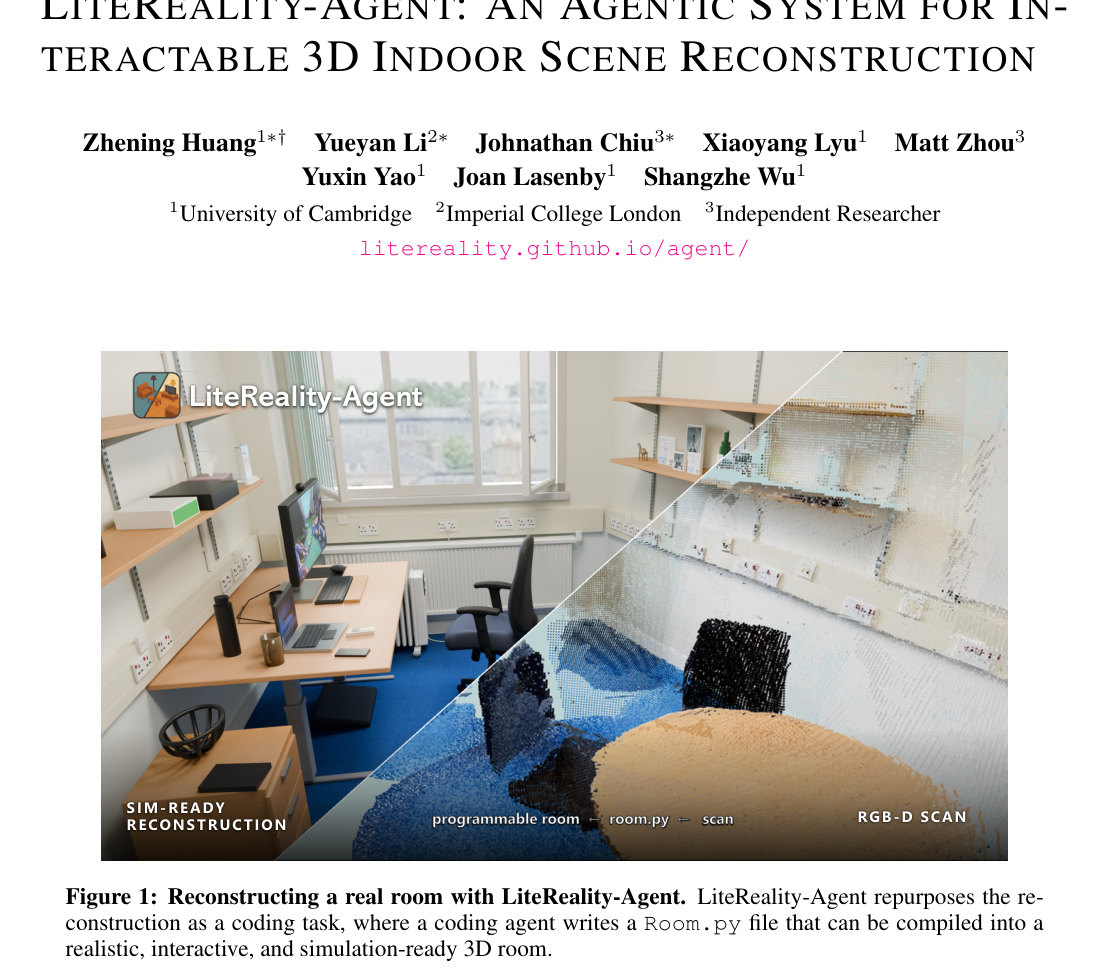
LiteReality-Agent 把室内 RGB-D 重建写成可执行的 Room.py,用 observe-edit-verify 编排把扫描变成可交互、可仿真的数字孪生。
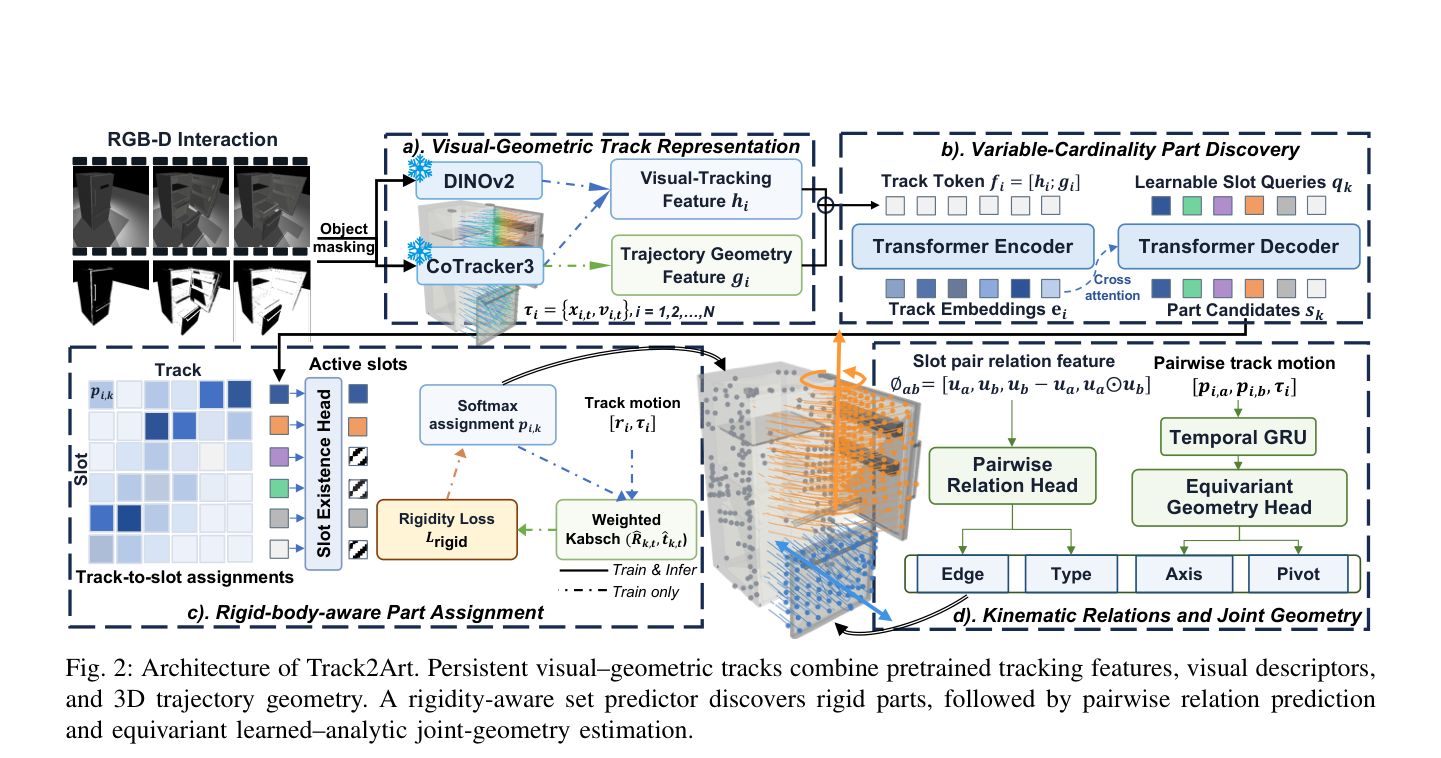
Track2Art 从带物体掩码的 RGB-D 交互视频构建持久视觉-几何轨迹 token,经可变基数刚体部件发现与旋转等变的学习-解析关节几何头,前馈恢复部件、有向运动学图、关节类型与轴枢,无需真值部件数或测试时优化。
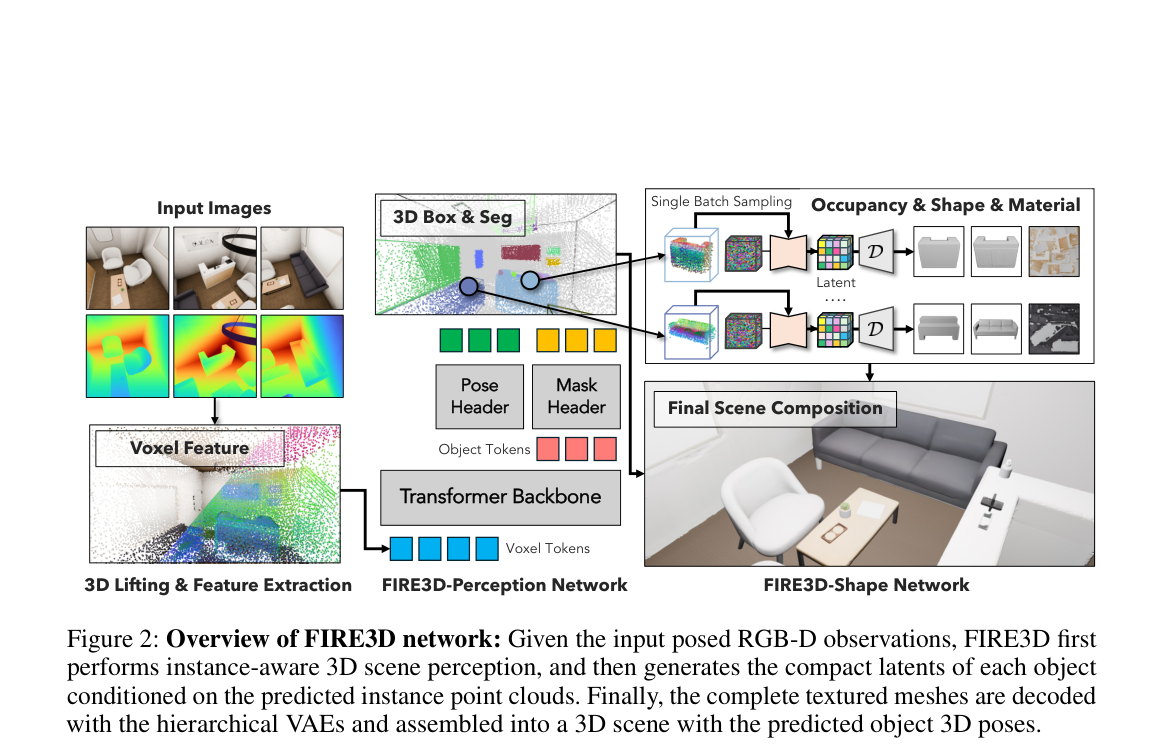
FIRE3D 提出了一种统一的前馈框架,能够从单张RGB图像或随意拍摄的RGB视频中,在60秒内重建出包含完整几何、纹理和6-DoF位姿的仿真就绪3D场景资产,无需测试时优化或额外标注。
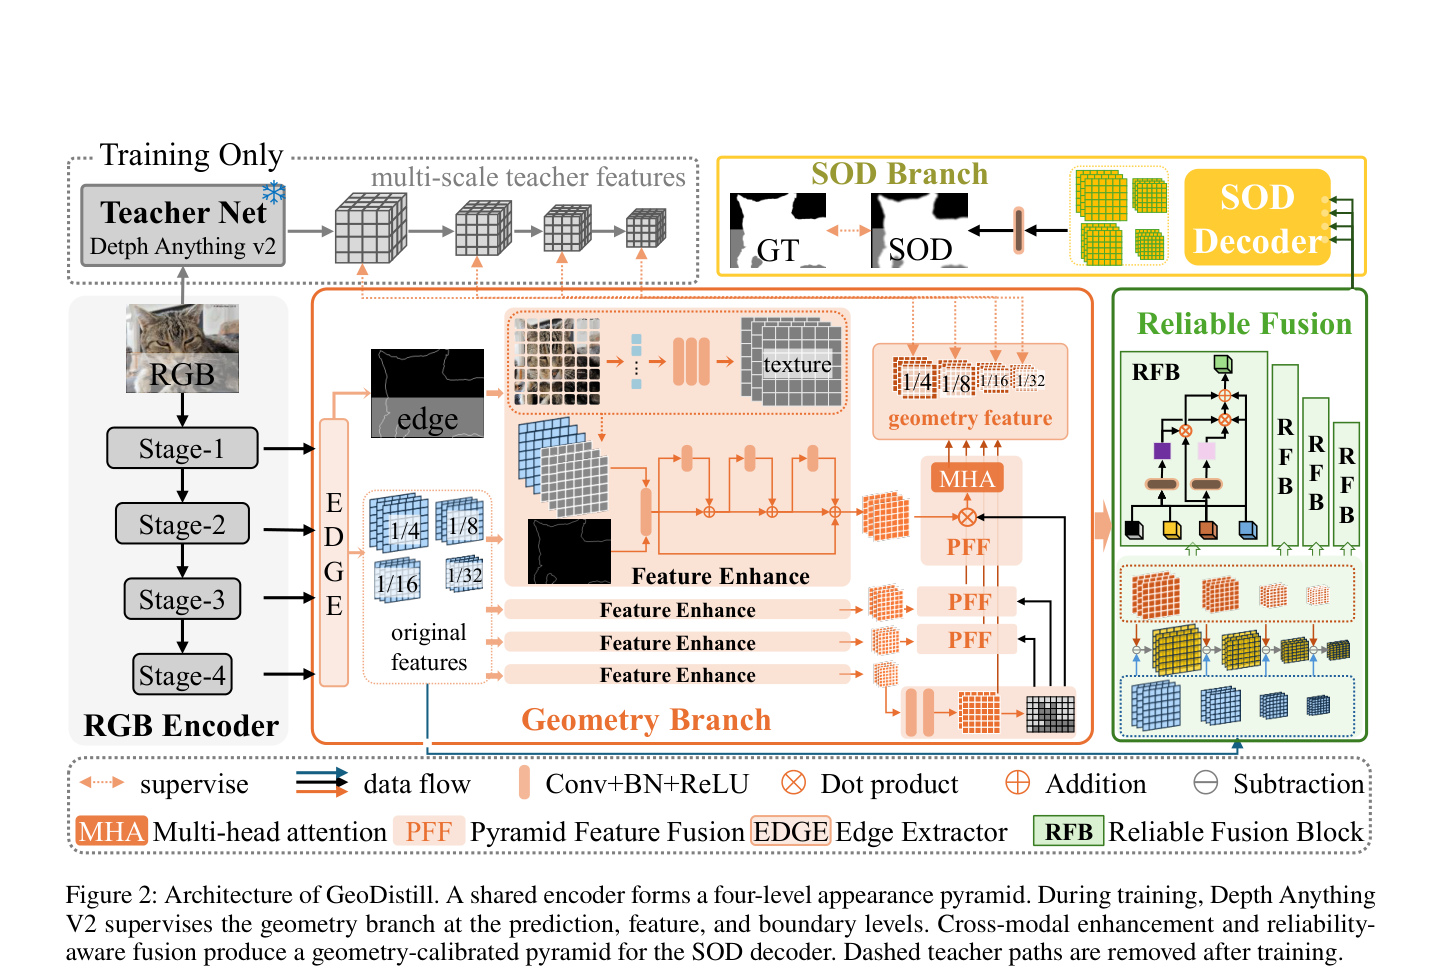
GeoDistill 提出一种深度无关的 RGB-D 显著性目标检测框架,通过从冻结的 Depth Anything V2 教师模型蒸馏几何信息,并在推理时移除教师,利用可靠性感知融合机制解决传感器深度噪声导致的性能下降问题。
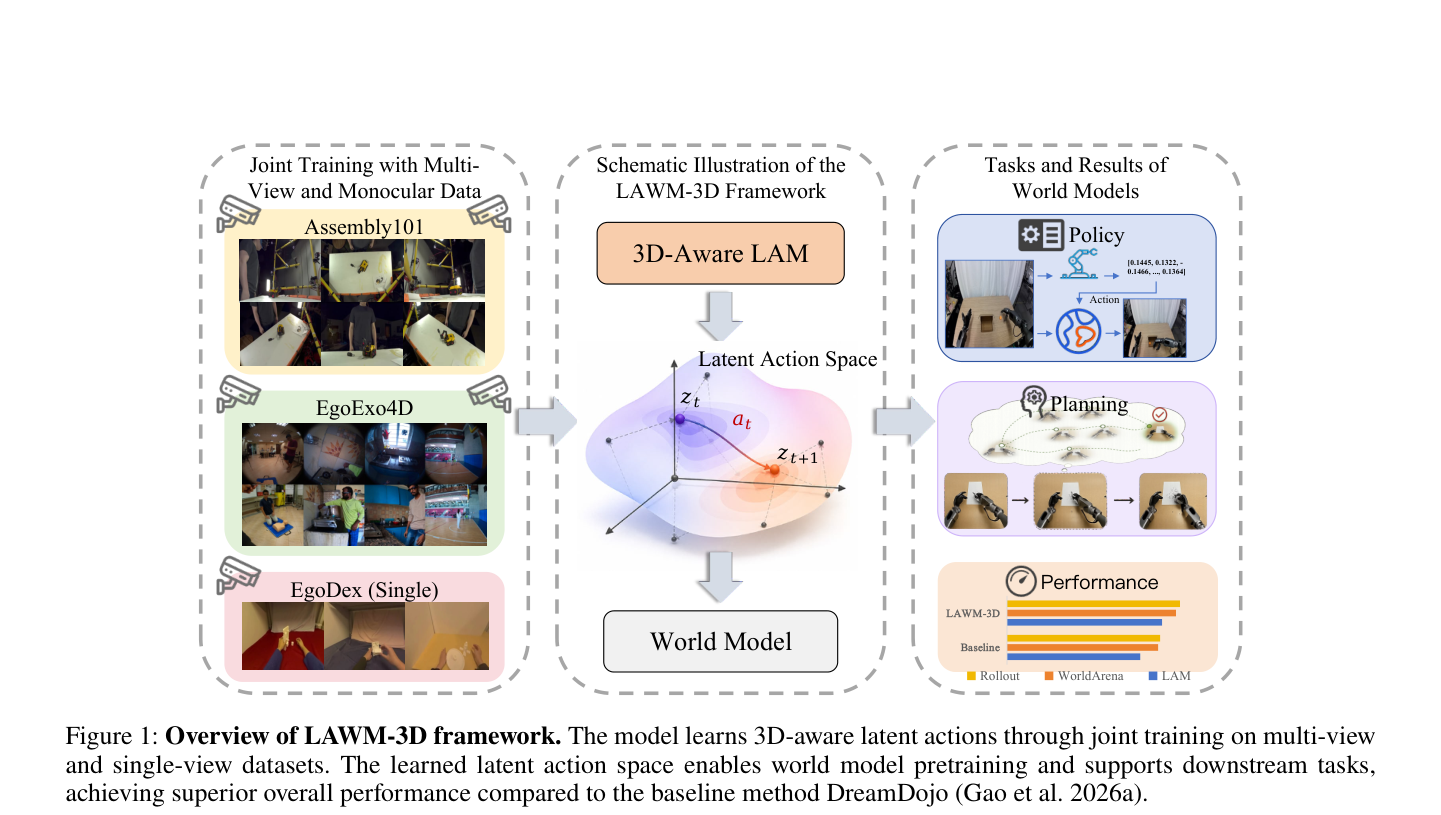
提出LAWM-3D框架,通过多视角联合训练、非单射RGB-D重建和几何特征对齐,从无标签人类视频中学习视角不变的3D感知潜在动作,显著提升世界模型的生成质量、物理一致性和泛化能力。