快速导读:GE-Act 2.0 提出了一种从零开始在操作数据上预训练的 World-Action 模型,通过 Control-Oriented Autoencoder (CoAE)、Single-Step Visual Planner (SVP) 和 Knowledge-Aligned Selective Optimization (KASO) 实现了视觉规划与逆动力学模型的解耦预训练及高效协同训练,显著提升了零样本 OOD 操作成功率。
GE-Act 2.0 提出了一种从零开始在操作数据上预训练的 World-Action 模型,通过 Control-Oriented Autoencoder (CoAE)、Single-Step Visual Planner (SVP) 和 Knowledge-Aligned Selective Optimization (KASO) 实现了视觉规划与逆动力学模型的解耦预训练及高效协同训练。该工作显著提升了零样本 OOD 操作成功率,证明了 World-Action 模型可以通过解耦预训练和选择性协同优化实现可扩展性。
现有 World-Action 模型通常继承预训练的视频生成器,导致预训练和扩展整体能力的问题未被充分探索。GE-Act 2.0 通过解耦视觉生成和逆动力学模型的预训练,利用无动作标签的视频和无指令的机器人轨迹进行独立预训练,并通过 KASO 解决联合训练时的 Validity Gap,为机器人操作提供了新的可扩展范式。
英文题目:GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2609.05588
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA 策略直接映射观测到动作,但未显式建模物理动力学。WAMs 通过预测未来状态来指导动作,但现有方法多依赖多步扩散模型,导致 IDM 无法独立预训练,且联合训练时存在生成未来与记录动作不匹配的问题(Validity Gap)。
现有方法将视觉生成与逆动力学模型耦合,导致无动作标签的视频和无指令的轨迹无法独立预训练。这种耦合限制了预训练数据的利用效率,并在联合训练时引入行为模式不匹配的问题,降低了模型的泛化能力。
GE-Act 2.0 的核心问题在于如何从零开始预训练 World-Action 模型,使其能够利用无动作标签的视频和无指令的轨迹进行独立预训练,并通过选择性协同优化解决 Validity Gap,从而提升零样本 OOD 操作成功率。
核心创新
- Control-Oriented Autoencoder (CoAE):在极端压缩下保留动作和指令相关信息,通过多教师对齐(SigLIP, V-JEPA 2.1, DINOv3)增强语义和时空结构。
- Single-Step Visual Planner (SVP):首个原生单步机器人世界模型,利用 MeanFlow 实现单步生成,解耦了视觉规划和 IDM 的预训练数据需求。
- Knowledge-Aligned Selective Optimization (KASO):通过在线 Top-k 选择机制,仅使用与记录动作兼容的生成未来状态进行训练,保留动作多样性并解决 Validity Gap。
方法概览
GE-Act 2.0 包含三个核心组件:1) CoAE:通过重建和多教师对齐学习高压缩率的控制导向潜空间;2) SVP:基于 Conditional MeanFlow 的单步视觉规划器,能在一次前向传播中生成完整未来状态;3) KASO:通过选择与记录动作行为兼容的生成未来状态进行协同训练,解决 Validity Gap。
- Control-Oriented Autoencoder (CoAE):通过重建和多教师对齐学习高压缩率的控制导向潜空间。CoAE 在极端压缩下保留动作和指令相关信息,通过多教师对齐(SigLIP, V-JEPA 2.1, DINOv3)增强语义和时空结构。
- Single-Step Visual Planner (SVP):基于 Conditional MeanFlow 的单步视觉规划器,能在一次前向传播中生成完整未来状态。SVP 解耦了视觉规划和 IDM 的预训练数据需求,允许在无动作标签视频上独立预训练。
- Knowledge-Aligned Selective Optimization (KASO):通过在线 Top-k 选择机制,仅使用与记录动作兼容的生成未来状态进行训练。KASO 保留动作多样性并解决 Validity Gap,避免生成未来与记录动作的行为模式不匹配。
- 解耦预训练:SVP 在无动作标签视频上学习视觉规划,IDM 在无指令轨迹上学习逆动力学。两者通过 KASO 协同训练,避免生成未来与记录动作的行为模式不匹配。
- 多教师对齐:CoAE 通过多教师对齐(SigLIP, V-JEPA 2.1, DINOv3)增强语义和时空结构,确保潜空间在极端压缩下仍保留动作和指令相关信息。
- 单步生成:SVP 基于 Conditional MeanFlow 实现单步生成,避免多步扩散模型的计算开销,并允许在无动作标签视频上独立预训练。
- 选择性协同优化:KASO 通过在线 Top-k 选择机制,仅使用与记录动作兼容的生成未来状态进行训练,保留动作多样性并解决 Validity Gap。
逐图理解论文
失效案例
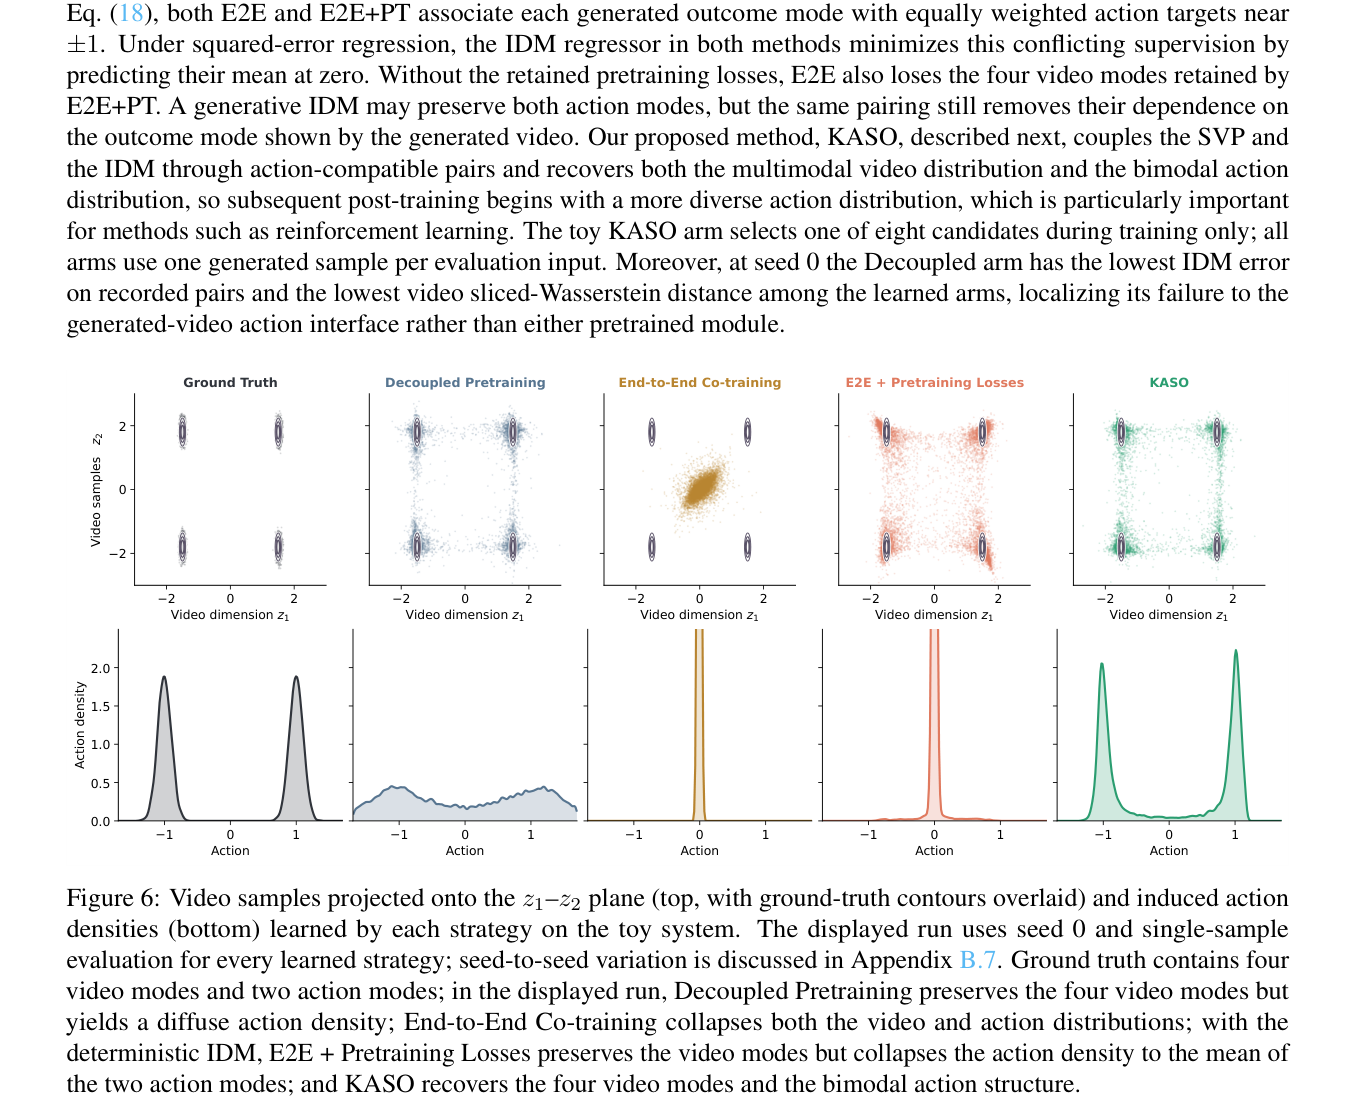
现有方法将视觉生成与逆动力学模型耦合,导致无动作标签的视频和无指令的轨迹无法独立预训练,联合训练时生成未来与记录动作不匹配,形成 Validity Gap。
核心区分
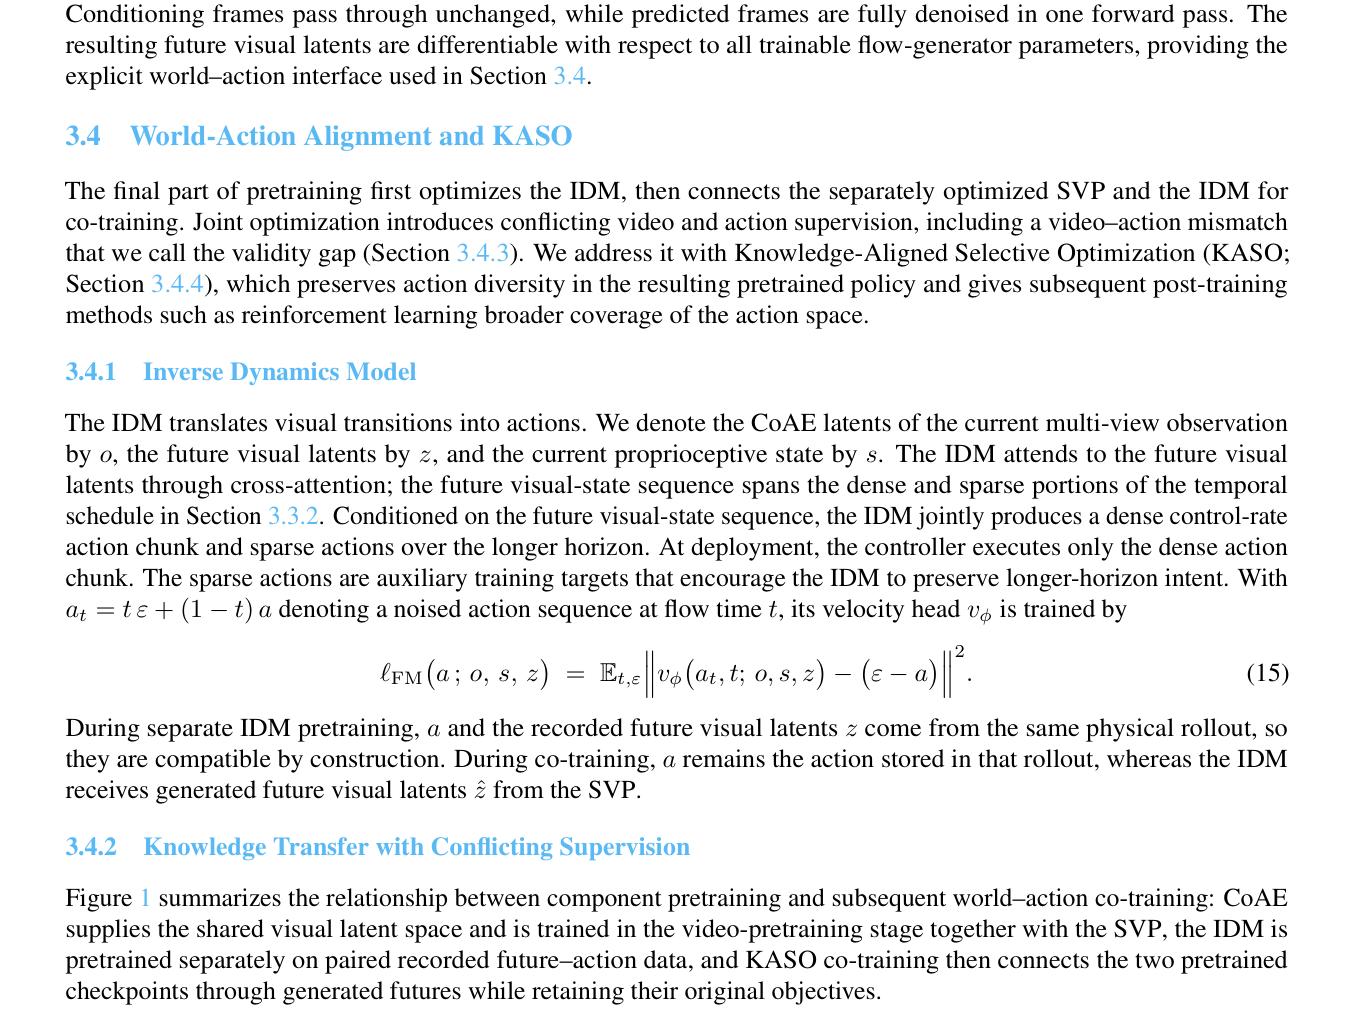
GE-Act 2.0 的核心贡献在于解耦预训练:SVP 在无动作标签视频上学习视觉规划,IDM 在无指令轨迹上学习逆动力学,两者通过 KASO 协同训练,避免生成未来与记录动作的行为模式不匹配。
方法贡献
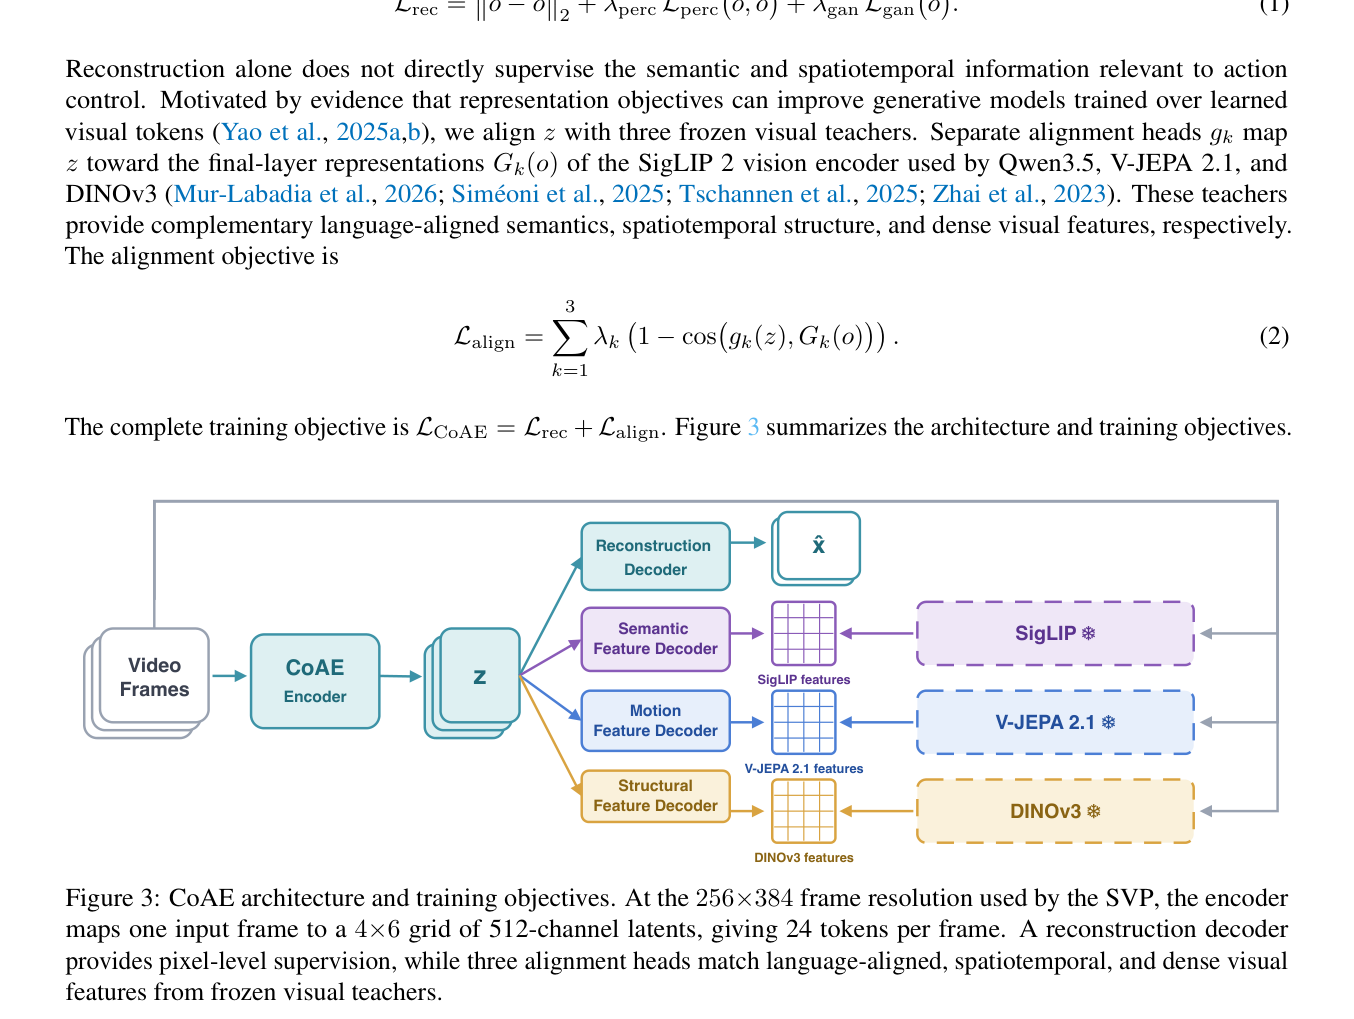
该图展示了 CoAE 的架构和训练目标。编码器将输入帧映射到 4×6 网格的 512 通道潜空间,重建解码器提供像素级监督,三个对齐头匹配冻结视觉教师的特征。该图说明了 CoAE 如何在极端压缩下保留动作和指令相关信息。
最强结论
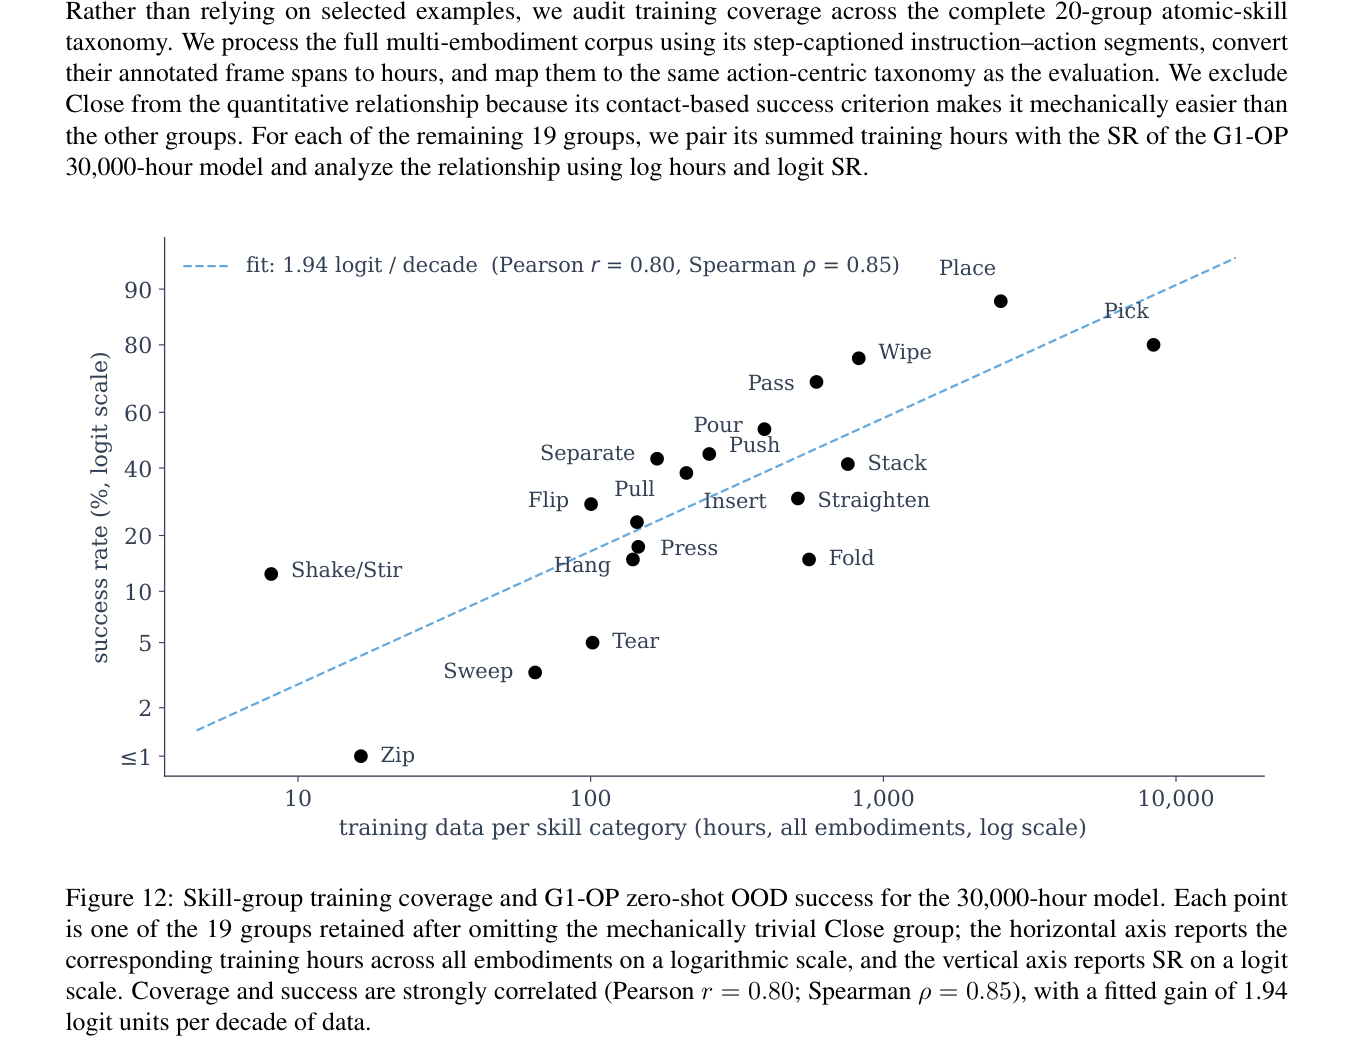
该图展示了技能组训练覆盖与 G1-OP 零样本 OOD 成功率的关系。每个点代表一个技能组,横轴为训练小时数(对数尺度),纵轴为成功率(logit 尺度)。该图直观展示了技能覆盖与成功率的强相关性,证明解耦预训练和选择性协同优化是提升泛化能力的关键。
实验如何设计?
- CoAE 表征探针:在动作恢复和指令接地任务上对比 CoAE 与 DINOv3, V-JEPA 2.1, SigLIP, DC-AE。
- KASO 消融实验:在受控真实机器人环境中对比 E2E, E2E+PT, KASO 对跟随分数和抓取成功率的影响。
- 零样本 OOD 扩展实验:在 100 个原子任务、20 个技能组上评估 G1-OP 和 G2-90D 在不同数据规模(300h 至 30,000h)下的成功率。
- 细粒度指令跟随:评估对象、颜色、形状、位置等维度的接地能力。
关键结果与论文证据
- G1-OP 零样本 OOD 成功率从 17.1% (300h) 提升至 44.1% (30,000h) (Page 1)。
- G2-90D 零样本 OOD 成功率从 13.4% (300h) 提升至 31.1% (30,000h) (Page 1)。
- CoAE 动作恢复 MAE 为 0.01673,比 DINOv3 高 13-31%,但 token 数量仅为 1/16 (Page 7)。
- KASO 在四物体协议中宏平均抓取成功率为 37.5%,比 E2E+PT 高 15 个百分点 (Page 15)。
- 技能覆盖与零样本 OOD 成功率强相关 (Pearson r = 0.80, Spearman ρ = 0.85) (Page 1)。
阅读时需要注意
- 模型主要关注低层操作策略,而非高层规划或开放式推理。
- KASO 的选择机制依赖于随机视频生成器的多样性,若噪声采样缺乏多样性,候选池将不包含替代模式。
- 评估主要基于零样本 OOD 设置,未包含任务特定的微调(SFT),这可能限制了在特定任务上的最终性能上限。
关联工作
- GE-Act 1.0:前代模型,GE-Act 2.0 改进了其并行动作分支,实现了 SVP 和 IDM 的解耦预训练 (Page 3)。
- MeanFlow:SVP 的方法论起点,GE-Act 2.0 将其扩展为条件多视图未来视觉状态生成 (Page 4)。
- V-JEPA 2.1, DINOv3, SigLIP:作为 CoAE 的冻结视觉教师,提供语义、时空和密集视觉特征对齐 (Page 6)。
- LingBot-VA, DreamZero:对比方法,这些系统通常从生成器的中间状态预测动作,而 GE-Act 2.0 使用完整生成未来 (Page 4)。