快速导读:本文综述了视频大语言模型(VideoLLMs)中针对帧采样、编码器、连接器及LLM执行阶段的推理效率机制,并提供了基于共享基准的定量对比。
视频大语言模型(VideoLLMs)在处理高分辨率、长时序视频时面临巨大的计算和内存开销,严重限制了其在实时、移动及资源受限场景下的部署。现有研究往往孤立地提出效率优化方法,且评估指标和输入协议不统一,导致不同策略的有效性难以直接比较。
本文通过建立基于流水线阶段的分类法,系统梳理了125种效率机制,并在共享宿主模型和输入协议下汇编了精度-成本对比。文章明确区分了分析性指标(如FLOPs、参数量)和系统级测量(如延迟、内存),为VideoLLM推理优化提供了统一的评估框架。
英文题目:Why Is Video Still So Expensive? A Survey of Inference-Efficiency Mechanisms in Video and Audiovisual LLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.10355
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VideoLLMs通常由视觉编码器、连接器和LLM组成。随着视频长度和帧数的增加,注意力计算和KV缓存内存开销显著增长。视觉编码器将采样帧转换为连续特征,连接器将其投影或压缩到LLM token空间,与文本提示结合进行任务条件生成。
现有效率优化方法往往针对特定阶段或特定任务,缺乏统一的评估标准。例如,帧采样策略的效果高度依赖于下游模型、帧预算和基准,不能仅凭单一精度数字判断。编码器FLOPs不等同于端到端VideoLLM效率,还需考虑输出token数和下游连接器/LLM成本。
视听效率评估存在空白,缺乏标准化的联合视听token预算评估协议。音频token压缩和音频引导的视觉选择对联合工作负载的影响尚未得到系统研究,限制了多模态模型在资源受限场景下的部署。
核心创新
- 提出了基于VideoLLM流水线阶段的效率机制分类法,将帧选择、编码器设计、连接器压缩和LLM侧优化统一分析。
- 汇编了共享宿主模型和输入协议下的精度-成本对比,明确区分了受控比较与异构跨论文证据。
- 专门分析了视听效率,包括音频token压缩和音频引导的视觉选择对联合工作负载的影响。
方法概览
作者建立了一个基于流水线阶段(输入构建、编码器计算、编码表示与连接器、LLM执行与状态)的分类法,系统梳理了125种效率机制。通过区分分析性指标(如FLOPs、参数量)和系统级测量(如延迟、内存),并在共享宿主模型和输入协议下汇编了文献报告的精度-成本对比。
- 建立基于VideoLLM流水线阶段的效率机制分类法,将帧选择、编码器设计、连接器压缩和LLM侧优化统一分析。分类法包括输入构建、编码器计算、编码表示与连接器、LLM执行与状态四个阶段。
- 区分分析性指标(如FLOPs、参数量)和系统级测量(如延迟、内存),明确不同指标的适用场景和局限性。分析性指标便于理论分析,但系统级测量更能反映实际部署性能。
- 在共享宿主模型和输入协议下汇编文献报告的精度-成本对比,明确区分受控比较与异构跨论文证据。受控比较在同一模型和输入条件下进行,而异构跨论文证据仅作为指示性参考。
- 专门分析视听效率,包括音频token压缩和音频引导的视觉选择对联合工作负载的影响。揭示音频模态在VideoLLM推理中的独特挑战和优化机会。
- 系统梳理125种效率机制,涵盖帧采样、编码器设计、连接器压缩、token剪枝、KV cache优化等多个方面。每种机制都标注其作用的流水线阶段和评估条件。
逐图理解论文
具体失败案例
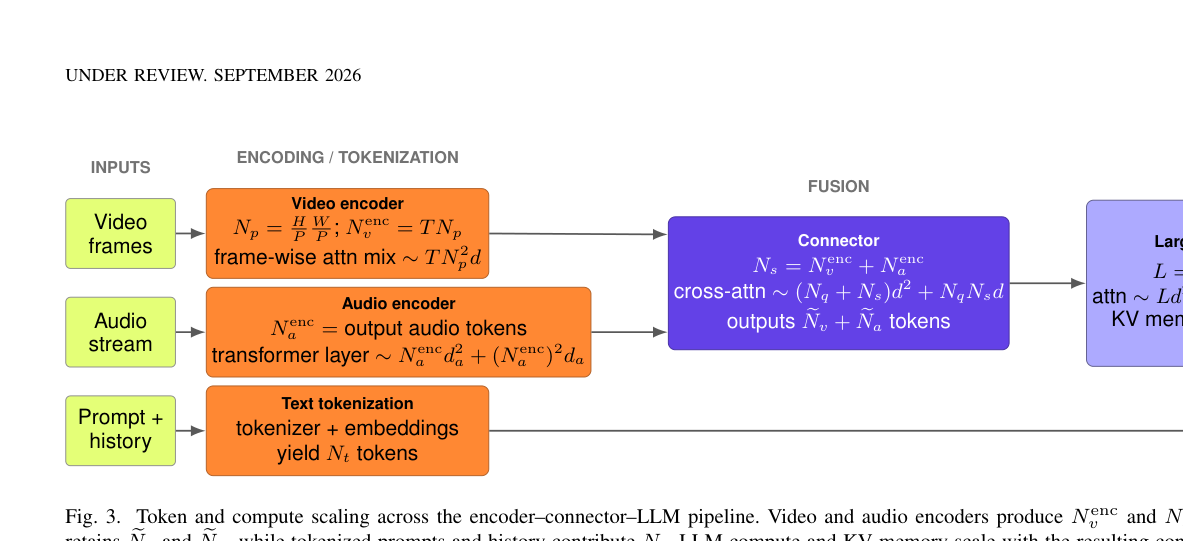
该图展示了编码器-连接器-LLM流水线中token和计算的扩展关系。视频和音频编码器产生Nenc个token,连接器将其压缩或投影,LLM处理这些token与文本提示的组合。这张图直观展示了token数量在各阶段的流动和计算开销的分布。
核心区分与研究空白
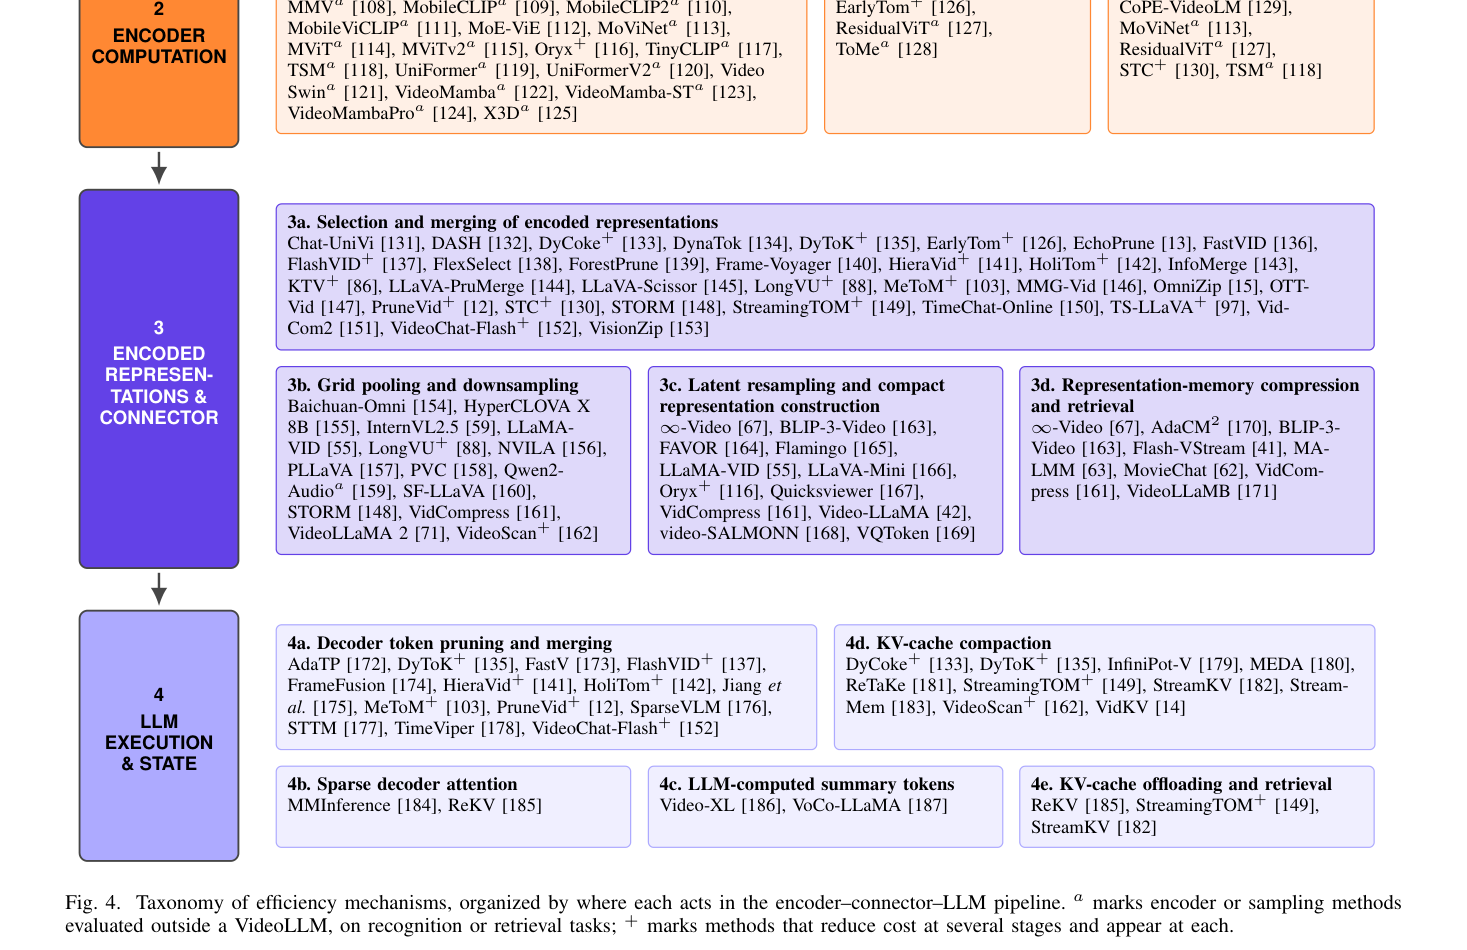
该图展示了效率机制的分类法,按其在编码器-连接器-LLM流水线中的作用位置组织。a标记在VideoLLM外部评估的编码器或采样方法,+标记在多个阶段降低成本的方法。这张图是本文的核心贡献,提供了统一的效率机制分析框架。
最强结论
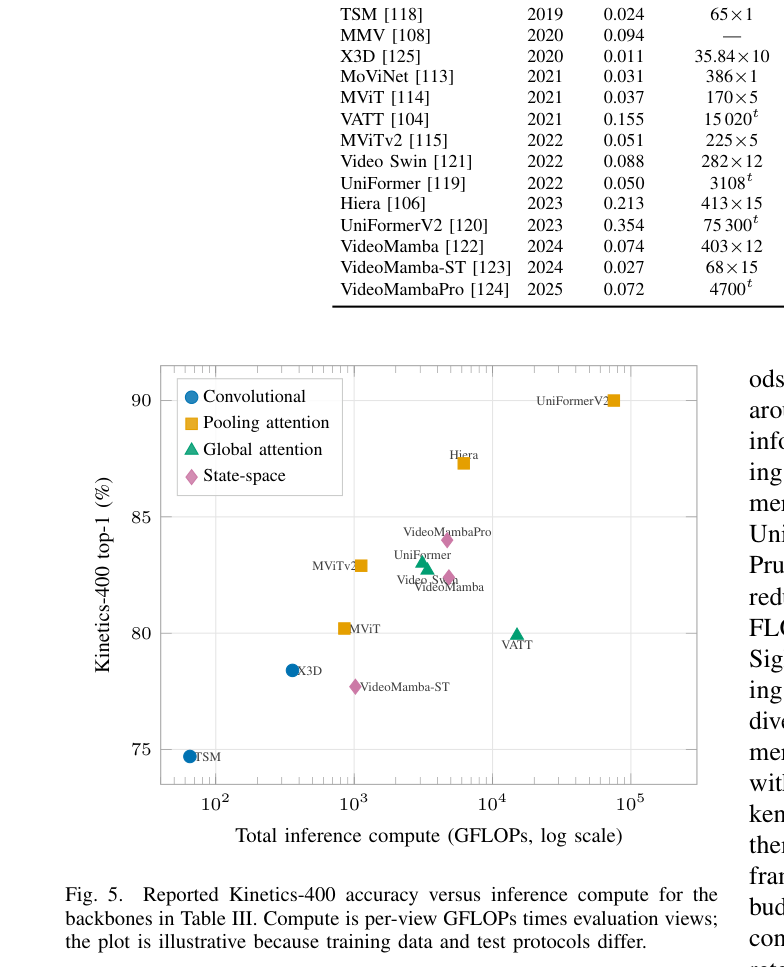
该图展示了Kinetics-400上报告的精度与推理计算量的关系,计算量为每视图GFLOPs乘以评估视图数。由于训练数据和测试协议不同,该图仅具说明性。这张图帮助读者理解编码器设计的效率-精度权衡,但需注意其局限性。
意义与局限
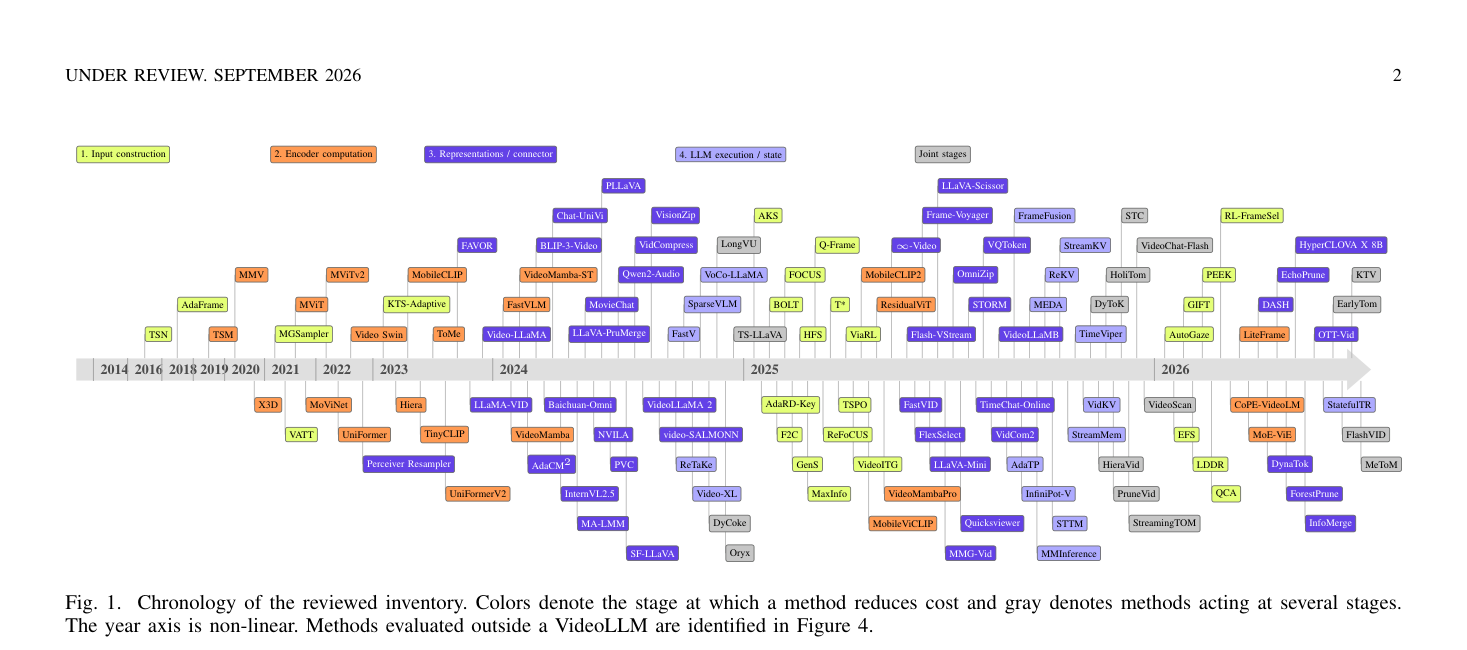
该图展示了所综述方法的时序分布,颜色表示方法降低成本的阶段,灰色表示在多个阶段起作用的方法。年份轴是非线性的,方法在VideoLLM外部评估的在图4中标识。这张图帮助读者快速了解效率机制的发展脉络和阶段分布。
实验如何设计?
- 在LLaVA-Video-7B上对比多种帧采样方法在LongVideoBench和Video-MME上的表现,评估不同采样策略对精度的影响。
- 对比多种视觉编码器(如MViTv2, Hiera, VideoMambaPro)在Kinetics-400等基准上的精度与计算量(GFLOPs),分析编码器设计的效率-精度权衡。
- 在冻结的LLaVA-OneVision-7B上对比多种token剪枝和合并方法在不同token预算下的精度保持率,评估连接器压缩的有效性。
- 在Qwen2.5-Omni-7B配置下评估OmniZip等视听压缩方法,分析音频token压缩对联合工作负载的影响。
关键结果与论文证据
- TSPO在LongVideoBench上达到63.9,Video-MME上达到65.5,优于均匀采样基线(58.9/64.4),表明智能帧采样能显著提升精度(第10页)。
- VideoMambaPro在Kinetics-400上达到84.0 top-1,计算量为4700 GFLOPs(总),展示了高效编码器设计的潜力(第10页)。
- HoliTom在25% token预算下,精度损失小于1.5%,而DyCoke损失超过7%,表明不同token压缩策略的效果差异显著(第12页)。
- VisionZip保留6.6%的token,实现7.8倍的预填充加速,展示了极端token压缩的可行性(第10页)。
- OmniZip在Qwen2.5-Omni-7B配置下,保留35% token时实现3.42倍加速和1.4倍内存减少,验证了视听联合压缩的有效性(第11页)。
阅读时需要注意
- 许多效率方法是在特定任务(如字幕生成、QA)上评估的,指标异构,难以直接比较。
- 分析性指标(如FLOPs)不一定能预测运行时性能,因为算子组合、并行化和内存访问模式会影响实际速度。
- 视听效率评估存在空白,缺乏标准化的联合视听token预算评估协议。
- 跨论文比较仅作为指示性证据,因为不同系统可能处理不同帧数、分辨率和模态。
关联工作
- Jin et al. [23]覆盖高效MLLM架构、视觉和语言组件及训练策略,将视频作为应用讨论,为本文提供了架构层面的背景。
- Shao et al. [24]按底层机制组织token压缩,比较指定宿主模型和token预算下的视频压缩方法,与本文的连接器压缩分析形成互补。
- Zhang et al. [25]围绕编码、预填充和解码组织LVLM推理,分析关键帧选择及阶段间优化影响,为本文的流水线阶段分类法提供了参考。
- Wu et al. [26]按输入、编码器、投影器和LLM干预点组织MLLM压缩,交叉五种压缩操作,与本文的分类法在结构上相似但侧重点不同。