为什么视频处理仍然如此昂贵?视频与视听大语言模型推理效率机制综述
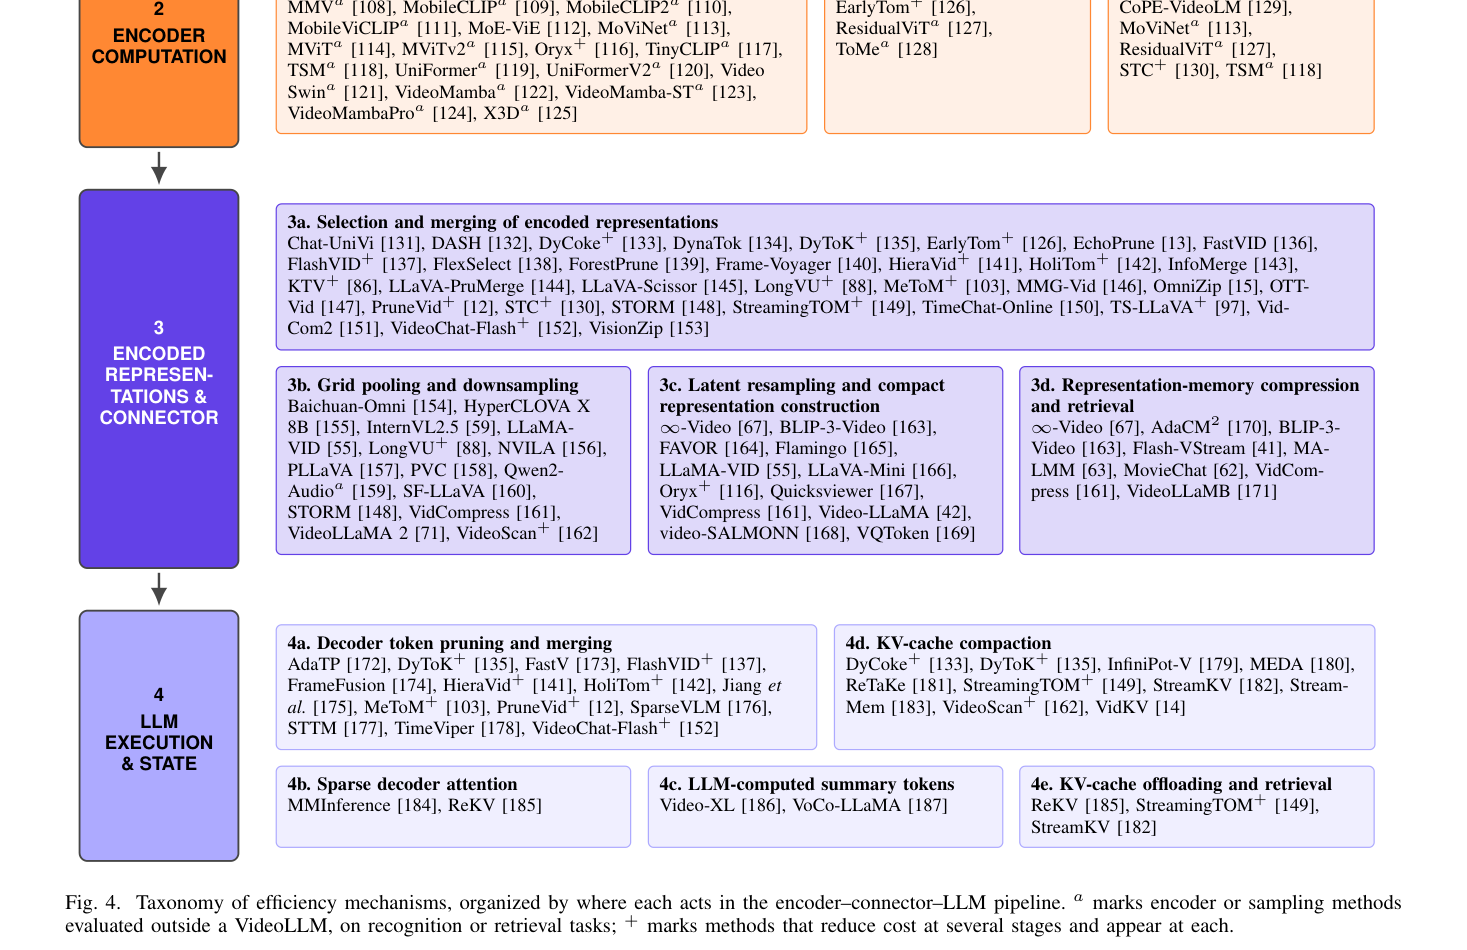
本文综述了视频大语言模型(VideoLLMs)中针对帧采样、编码器、连接器及LLM执行阶段的推理效率机制,并提供了基于共享基准的定量对比。
本文综述了视频大语言模型(VideoLLMs)中针对帧采样、编码器、连接器及LLM执行阶段的推理效率机制,并提供了基于共享基准的定量对比。
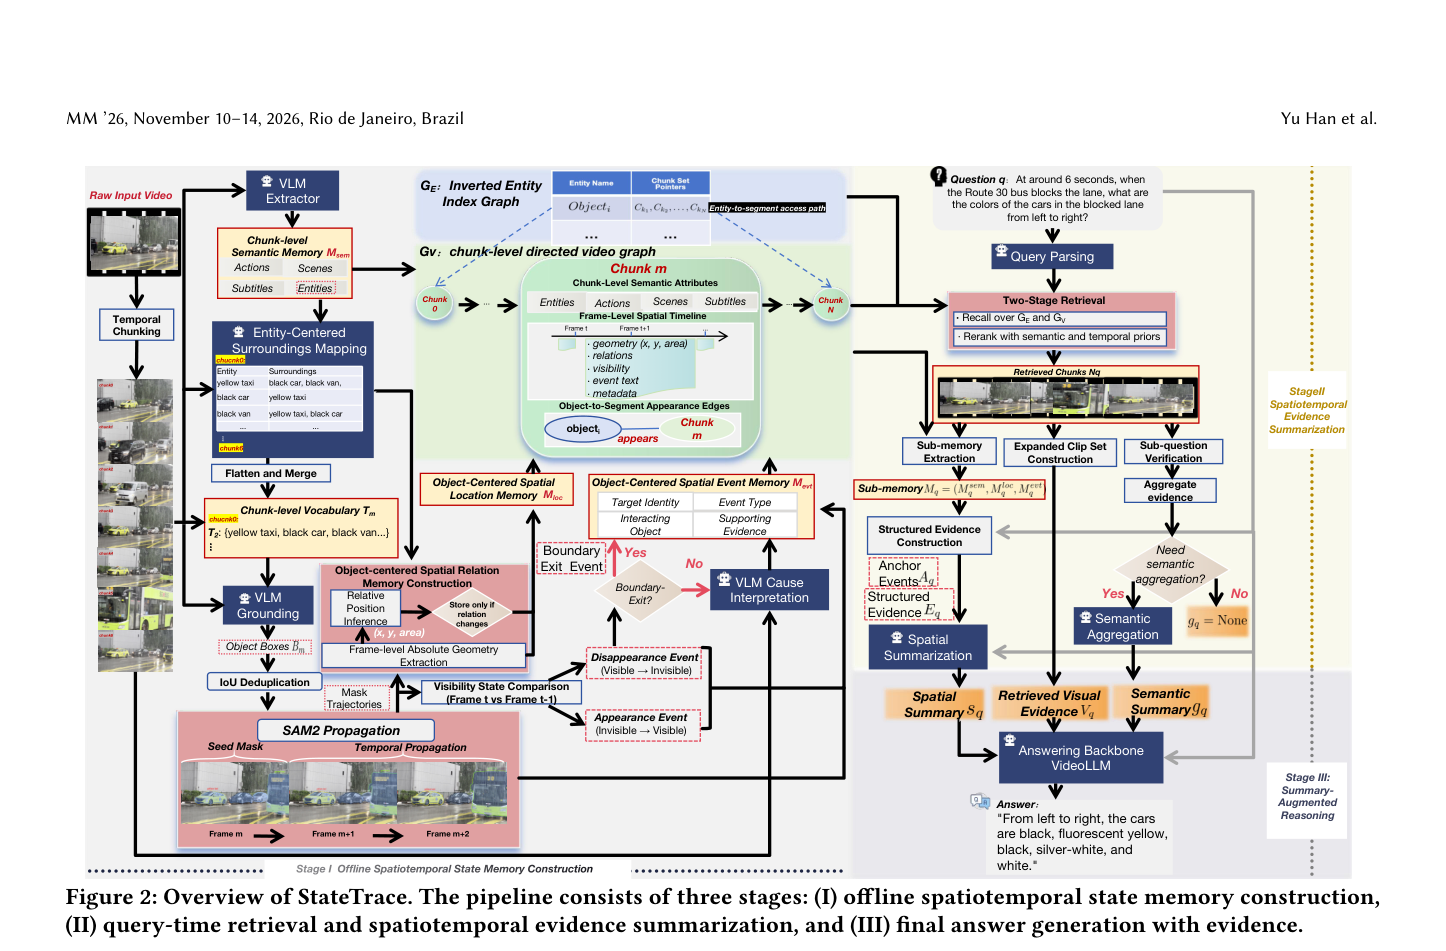
StateTrace 提出对象中心的时空状态记忆框架,使 VideoLLM 能够在目标物体长时间不可见时显式推理其隐藏状态,并在新基准 HSR-Bench 上取得 15–28 点的显著提升。