快速导读:本文提出了 Spot-the-shift 基准,用于评估多模态大模型(MLLMs)在真实驾驶场景中检测、描述并定位长期结构性变化的能力,并展示了一种通过合成数据微调以提升模型性能且保持通用能力的方法。
Spot-the-shift 针对多模态大模型在长期结构性变化理解上的不足,提出了一个包含自然语言描述和像素级掩码的街景变化基准。该基准基于 Mapillary 数据集,涵盖了跨越数年的真实移动视角图像对,填补了现有基准在时间跨度和空间定位上的空白。
除了基准构建,本文还提出了一种合成数据微调方法。通过利用 FLUX 模型进行结构性和非结构性编辑,并结合 Homography 变换模拟视角差异,该方法有效提升了 Qwen3-VL-8B 在变化检测任务上的性能,同时保持了模型在通用视觉问答任务上的能力。
英文题目:Spot-the-shift: Evaluating Grounded Image Difference Captioning of Long-term Changes
论文出处:arXiv 每日论文精选 · arXiv:2609.10356
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长期变化理解对于地图维护、城市基础设施监控和自主导航至关重要。然而,现有的图像差异描述基准通常缺乏空间定位信息,且多关注短期变化或固定摄像头场景,难以评估模型在移动车辆视角下对细微结构性变化的理解能力。
此外,标准评估指标如 BLEU 无法有效区分幻觉与遗漏,导致难以准确衡量模型性能。现有基准如 Spot-the-diff 和 STVchrono 虽有一定贡献,但缺乏 Grounding 信息或长期变化覆盖,无法全面评估 MLLMs 的能力。
因此,亟需一个包含自然语言描述和空间掩码的长期变化基准,以及一种能够有效评估模型幻觉与遗漏的评估协议,以推动 MLLMs 在真实场景中的应用。
核心创新
- 首个提供自然语言描述和空间掩码的长期变化基准 Spot-the-shift。
- 提出基于差异单元分解的评估协议,显著优于传统 n-gram 指标,能更好对齐人类判断。
- 设计合成数据生成管道,通过混合结构性和干扰性编辑,有效微调 MLLM 以提升变化检测能力而不损害通用能力。
方法概览
1. 构建 Spot-the-shift 基准:基于 Mapillary 数据集,包含 939 对相隔数年的街景图像,提供自然语言描述和像素级分割掩码(Masks)。
2. 提出新评估协议:将预测分解为差异单元(Difference Units),计算 Precision 和 Recall,并引入 TNR 和 HR 评估对无变化图像对的鲁棒性。
3. 合成数据生成管道:利用 FLUX 模型对真实图像进行结构性和非结构性编辑,结合 Homography 变换模拟视角差异,并使用 DINOv3 特征进行变化定位,生成训练数据以微调 Qwen3-VL-8B。
- 构建 Spot-the-shift 基准:基于 Mapillary 数据集,包含 939 对相隔数年的街景图像,提供自然语言描述和像素级分割掩码。
- 提出新评估协议:将预测分解为差异单元,计算 Precision 和 Recall,并引入 TNR 和 HR 评估对无变化图像对的鲁棒性。
- 合成数据生成管道:利用 FLUX 模型对真实图像进行结构性和非结构性编辑,结合 Homography 变换模拟视角差异。
- 变化定位:使用 DINOv3 特征进行变化定位,生成训练数据以微调 Qwen3-VL-8B。
- 数据组成研究:分析结构性、非结构性和 Homography 错位数据对模型性能的影响,验证合成数据的有效性。
逐图理解论文
现有基准的局限
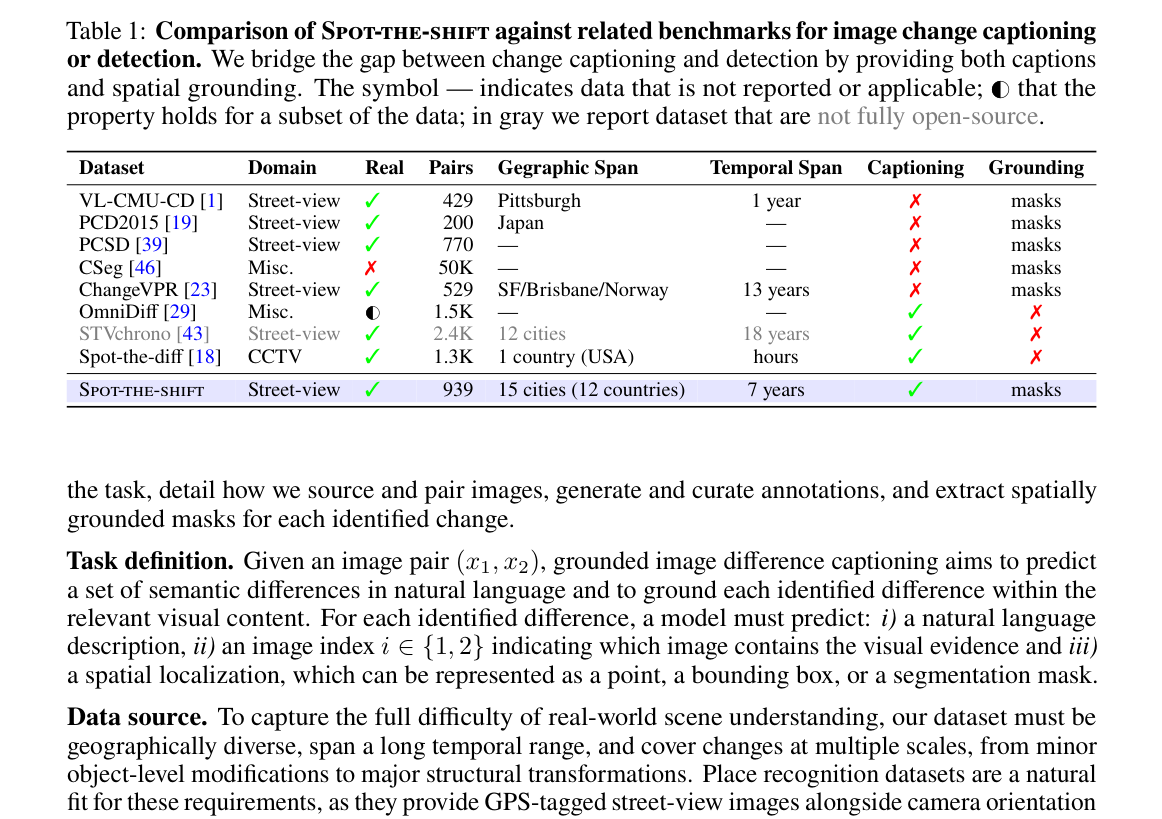
该表详细比较了 Spot-the-shift 与相关基准的属性,包括时间跨度、视角类型和 Grounding 支持。通过该表可以清晰看到 Spot-the-shift 在长期变化和空间定位上的优势。
Spot-the-shift 基准
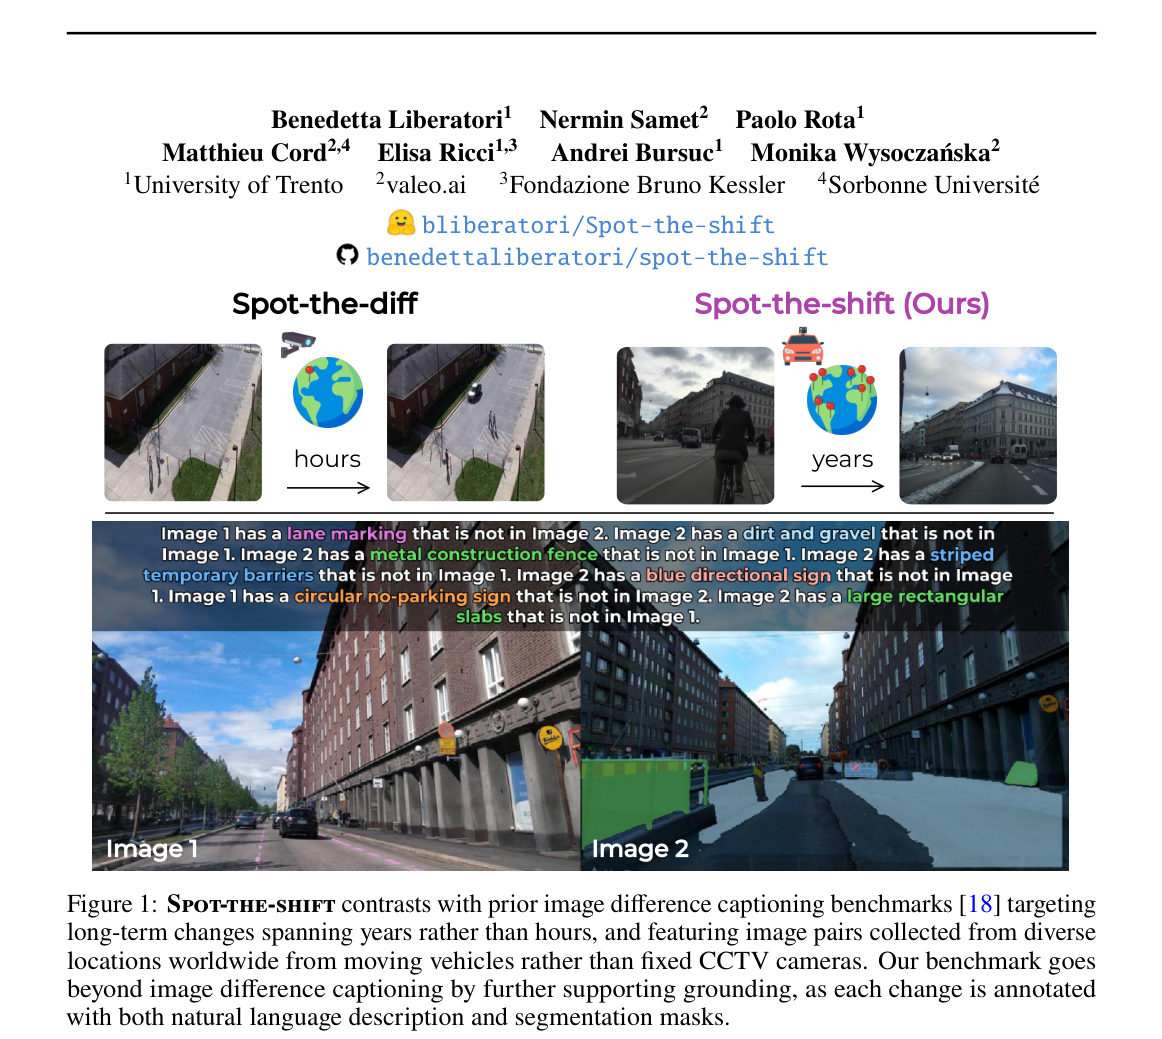
该图展示了 Spot-the-shift 与现有基准的对比,强调了其长期变化、移动视角和空间定位的特点。观察该图有助于理解基准的创新点和应用场景。
新评估协议
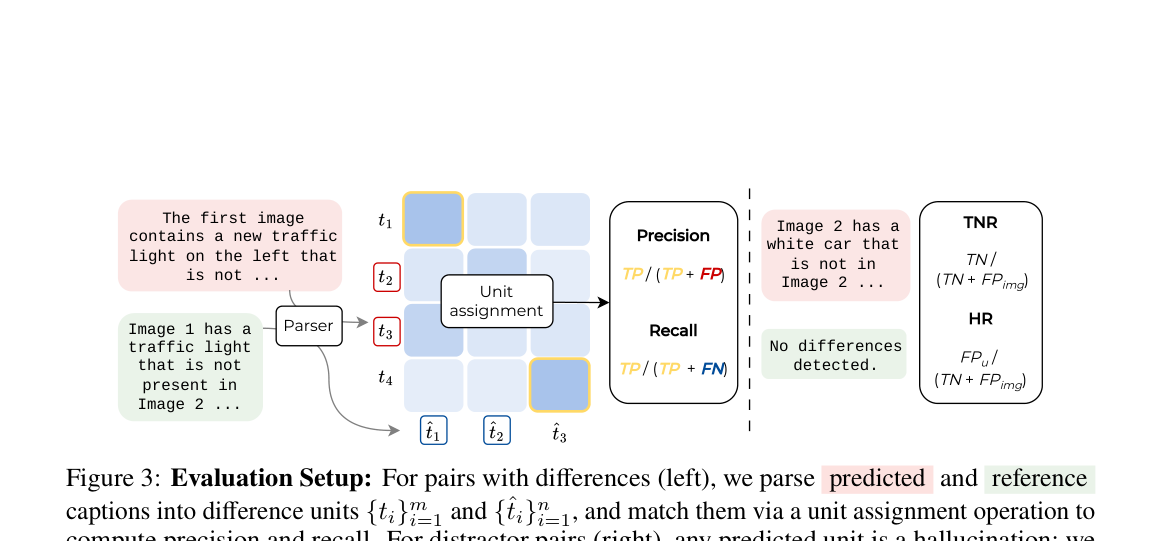
该图展示了评估设置,包括差异单元的解析和评估指标的计算。观察该图有助于理解评估协议的具体实现和指标定义。
合成数据微调
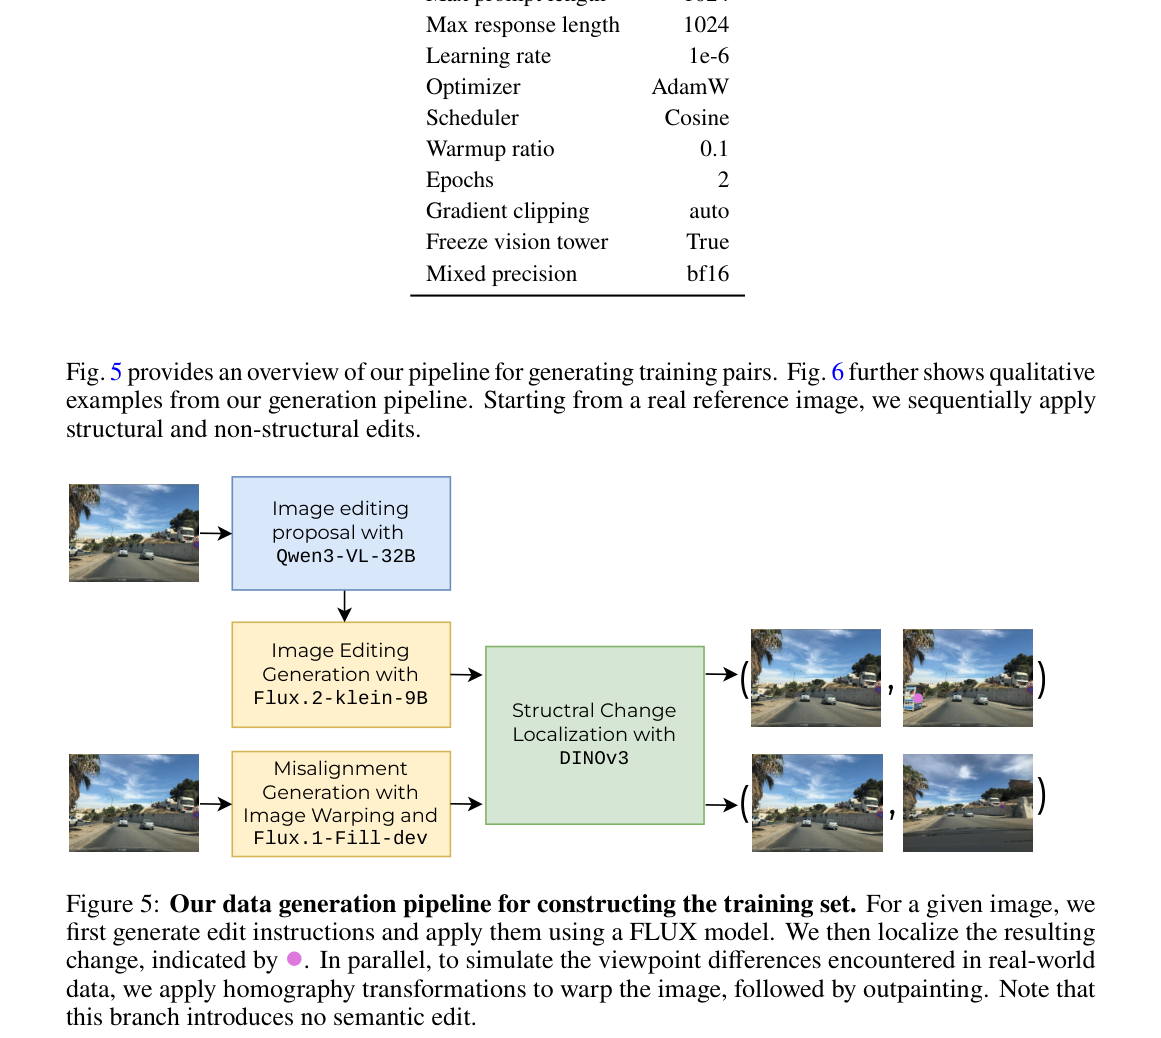
该图展示了合成数据生成管道,包括结构编辑、非结构编辑和 Homography 变换。观察该图有助于理解合成数据的生成过程和视角变换的实现。
核心结论与局限
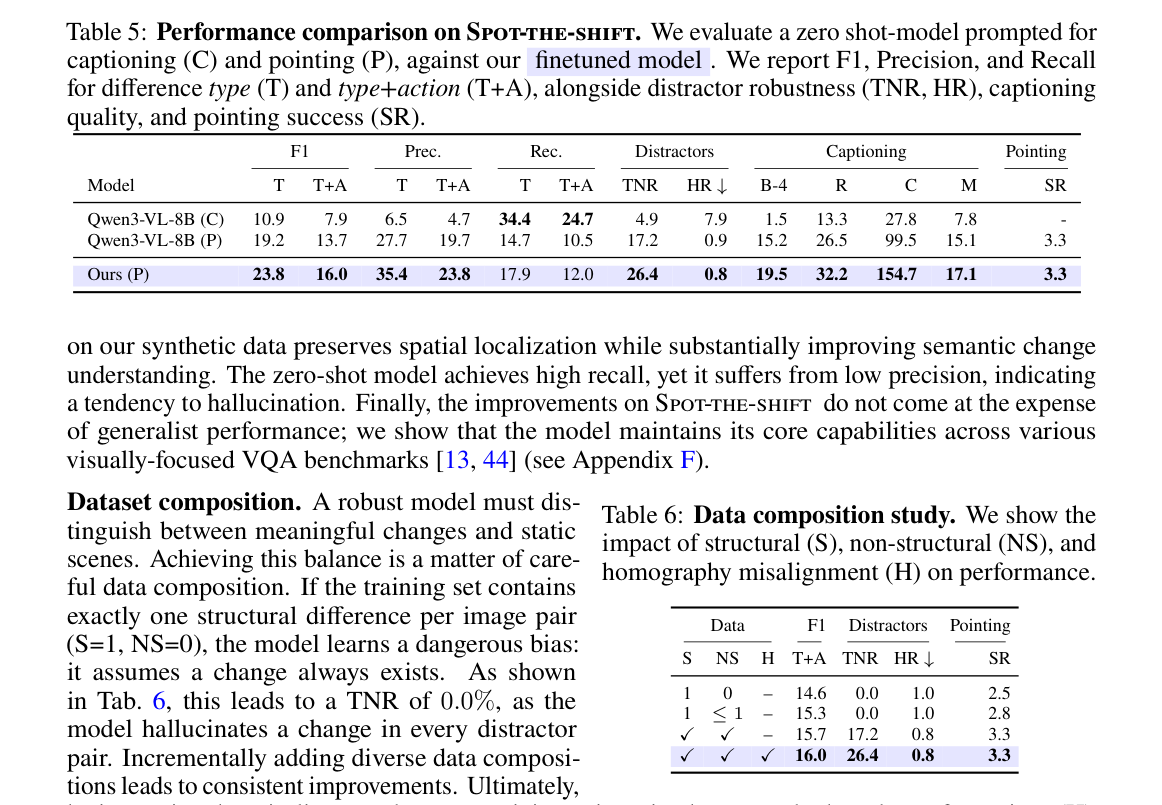
该表对比了 Zero-shot 模型和微调模型在 Spot-the-shift 上的性能,验证了合成数据微调的有效性。观察该表有助于理解微调对模型性能的提升。
实验如何设计?
- 在 Spot-the-shift 上对 Gemini 3 Flash, Claude Opus 4.6, Qwen3-VL 等 SOTA MLLMs 进行 Zero-shot 评估。
- 对比 Zero-shot 提示(Captioning vs. Pointing)与微调模型(Ours)的性能。
- 在 BLINK, POPE 等标准 VQA 基准上验证微调后模型的通用能力保持情况。
- 分析训练数据组成对模型性能的影响,验证合成数据的有效性。
关键结果与论文证据
- Gemini 3 Flash 在 Captioning 任务中 T F1 为 53.0,TNR 为 45.8,表现优于其他模型。
- Qwen3-VL-32B 在 Captioning 任务中 T Precision 仅为 14.2%,TNR 为 18.2%,表现较差。
- 微调后的 Qwen3-VL-8B (Ours) 在 Pointing 任务中 T F1 达到 23.8,TNR 提升至 26.4,HR 降至 0.8。
- 引入 Homography 错位数据使 TNR 提升 9.2%,验证了视角变换数据的有效性。
- 微调模型在 BLINK 基准上整体准确率保持 64.7%,与 Zero-shot 基线 64.9% 相当,表明通用能力未受损。
阅读时需要注意
- 整体性能仍然中等,空间定位(Pointing)精度较粗糙。
- 合成数据生成受限于上游生成模型(如 FLUX)的质量,可能引入系统性偏差。
- 基准规模相对较小(939 对),主要依赖标注质量而非规模。
关联工作
- Spot-the-diff 针对短期 CCTV 变化,缺乏 Grounding 和长期变化覆盖。
- STVchrono 基于 Google Street View,非完全开源,缺乏 Grounding。
- VL-CMU-CD 提供像素级掩码但缺乏自然语言描述。
- ALOHa 启发本文评估协议,将幻觉评估分解为 Precision 和 Recall,本文将其扩展至多图像差异场景。