快速导读:SenseNova-U1.5 是一个 8B 参数的原生统一多模态模型,通过空间联合重建解码器和多专家强化学习及蒸馏策略,在无需外部编码器和 VAE 的情况下实现了高质量的视觉理解、推理与生成。
SenseNova-U1.5 是一个 8B 参数的原生统一多模态模型,旨在解决传统多模态系统中感知和生成分离的问题。该模型通过空间联合重建解码器和多专家强化学习及蒸馏策略,在无需外部编码器和 VAE 的情况下实现了高质量的视觉理解、推理与生成。
与前代模型 SenseNova-U1 相比,U1.5 改进了视觉接口和训练策略,采用原生 Mixture-of-Transformers 架构,在单一 Transformer 骨干中整合理解和生成,通过共享自注意力实现跨流通信,同时保留特定流的参数。
英文题目:SenseNova-U1.5: Towards Native Unified Visual Intelligence
论文出处:arXiv 每日论文精选 · arXiv:2609.11929
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统多模态系统通常将感知(通过视觉编码器)和生成(通过 VAE)分离在不同的表示空间中,导致感知、推理和生成之间的协调受限,且难以在统一框架内无缝处理多样化的视觉创作任务。
原生统一建模直接从像素和文本中学习,SenseNova-U1 证明了这一范式的可行性,但其轻量级视觉接口独立重建每个视觉 token,导致高分辨率下出现接缝和纹理不连续。
为了解决这些问题,SenseNova-U1.5 引入了空间联合重建解码器,使用 Pixel Shuffle 和 3×3 卷积增强空间连贯性,并扩展分辨率感知噪声条件至 4096×4096,支持原生高分辨率合成。
此外,论文提出了 specialize-then-unify 策略,先针对特定能力(美学、文本渲染、信息图、编辑)训练专用 RL 专家,再通过多专家在线策略蒸馏整合到单一统一模型中,以平衡通用性和专业性。
核心创新
- 从独立 patch 预测转向空间联合重建,通过二维特征场和空间卷积实现像素级联合优化,减少高分辨率下的接缝和伪影。
- 提出 specialize-then-unify 策略,先针对特定能力(美学、文本渲染、信息图、编辑)训练专用 RL 专家,再通过多专家在线策略蒸馏整合到单一统一模型中。
- 扩展分辨率感知噪声条件至 4096×4096,支持原生高分辨率合成。
- 采用原生 MoT 架构,在单一 Transformer 骨干中整合理解和生成,通过共享自注意力实现跨流通信,同时保留特定流的参数。
方法概览
SenseNova-U1.5 采用原生 Mixture-of-Transformers (MoT) 架构,引入空间联合重建解码器(使用 Pixel Shuffle 和 3×3 卷积)以增强空间连贯性,并扩展分辨率感知噪声条件至 4096×4096。训练过程包括生成预训练、统一中期训练、统一 SFT、多专家强化学习(针对美学、OCR、信息图和编辑)以及多专家在线策略蒸馏。
- 采用原生 Mixture-of-Transformers (MoT) 架构,在单一 Transformer 骨干中整合理解和生成,通过共享自注意力实现跨流通信,同时保留特定流的参数。
- 引入空间联合重建解码器,使用 Pixel Shuffle 和 3×3 卷积增强空间连贯性,减少高分辨率下的接缝和伪影。
- 扩展分辨率感知噪声条件至 4096×4096,支持原生高分辨率合成,提高生成图像的细节和保真度。
- 训练过程包括生成预训练、统一中期训练、统一 SFT、多专家强化学习(针对美学、OCR、信息图和编辑)以及多专家在线策略蒸馏。
- 多专家强化学习阶段使用特定的奖励模型(如 HPSv3++, PaddleOCR),针对特定能力进行优化,提高模型在特定任务上的表现。
- 多专家在线策略蒸馏阶段将多个专用 RL 专家的能力整合到单一统一模型中,平衡通用性和专业性,提高模型的整体性能。
逐图理解论文
前代局限
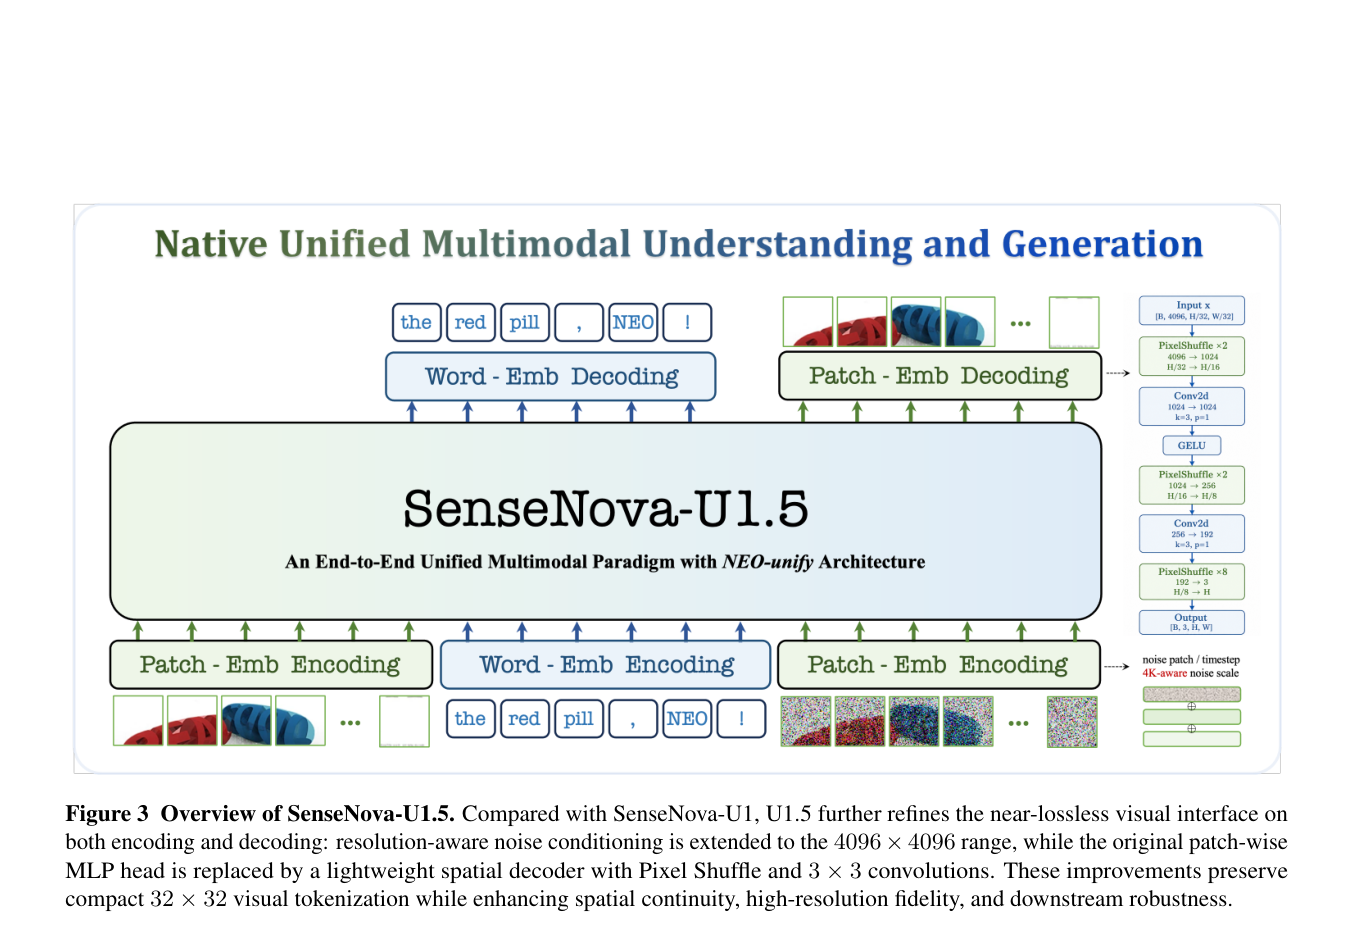
该图展示了 SenseNova-U1.5 的整体架构,重点突出了空间联合重建解码器和分辨率感知噪声条件的扩展。观察该图可以了解模型如何在单一 Transformer 骨干中整合理解和生成,以及空间联合重建解码器如何增强空间连贯性。
训练数据构成
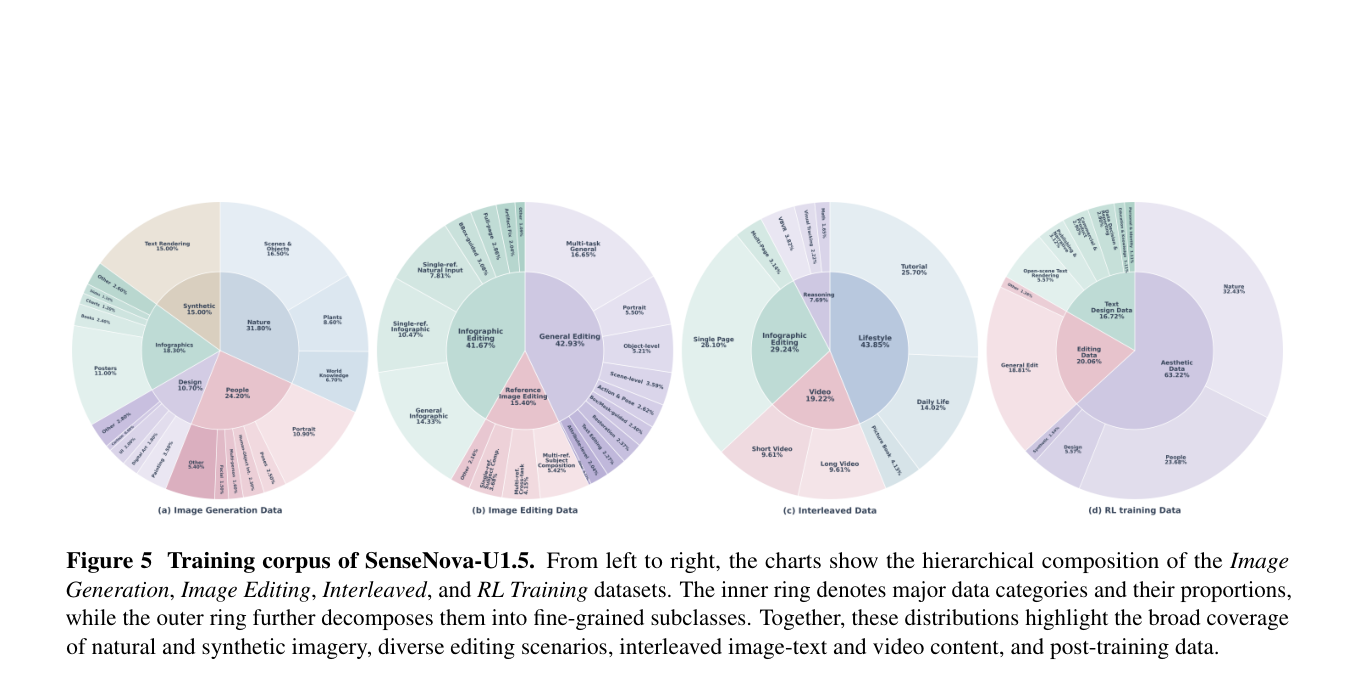
该图展示了 SenseNova-U1.5 的训练语料库,包括图像生成、图像编辑、交错和 RL 训练数据集的层次结构。观察该图可以了解训练数据的组成和分布,以及模型如何覆盖多样化的视觉任务。
方法贡献
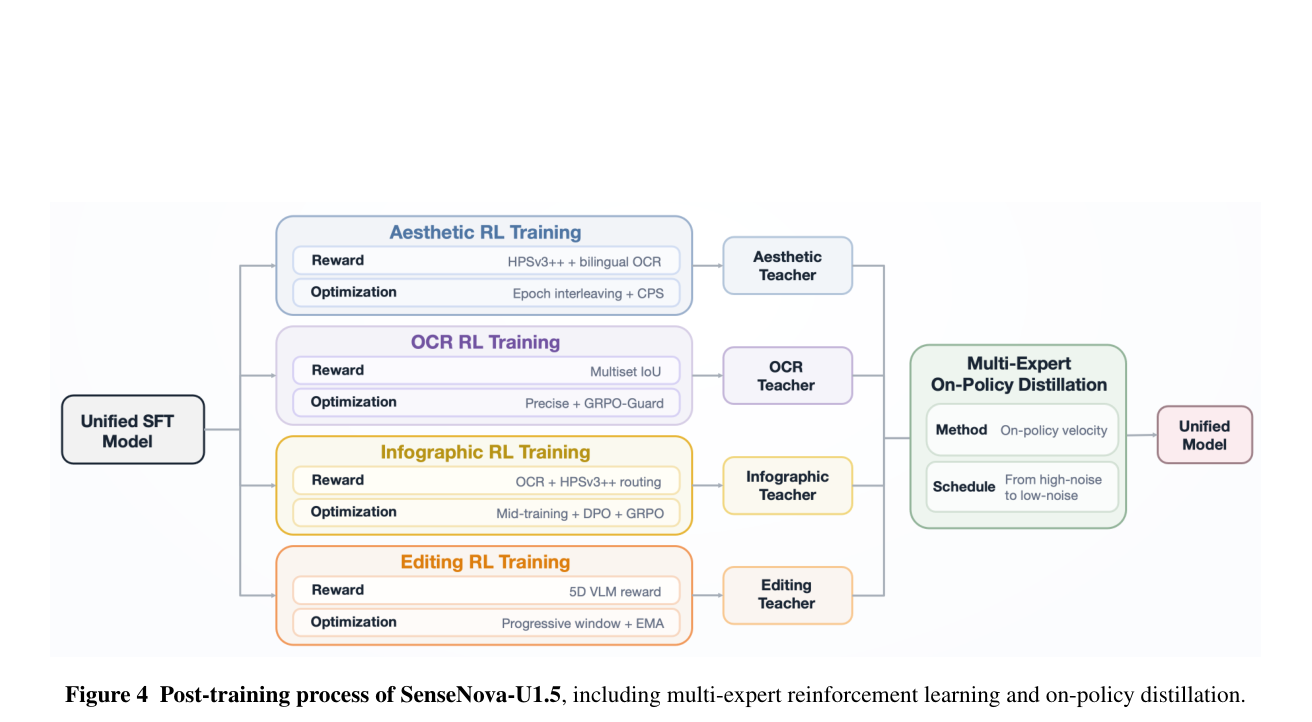
该图展示了 SenseNova-U1.5 的后训练过程,包括多专家强化学习和在线策略蒸馏。观察该图可以了解多专家强化学习和在线策略蒸馏的具体流程和模块交互。
最强结论
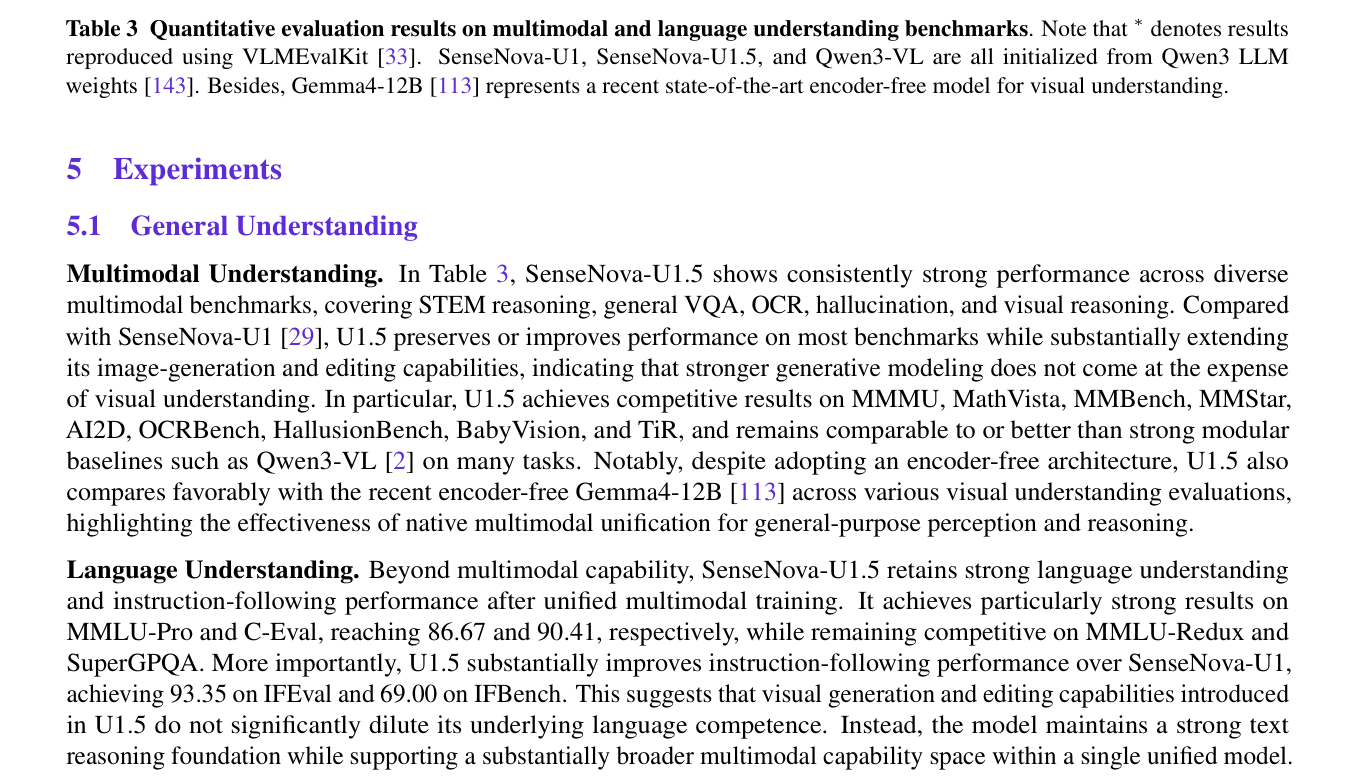
该表展示了 SenseNova-U1.5 在多模态和语言理解基准上的定量评估结果。观察该表可以了解模型在视觉理解方面的性能,以及与对比基线的比较。
实验如何设计?
- 在多个多模态理解基准(如 MMMU, MathVista, OCRBench)上评估通用理解能力,验证模型在视觉理解方面的性能。
- 在 Qwen-Image-Bench, GenEval, GenEval2, OneIG-Bench, DPG-Bench 等基准上评估图像生成质量,验证模型在图像生成方面的性能。
- 在 CVTG-2K, LongText-Bench, IGenBench, BizGenEval 上评估文本渲染和信息图生成,验证模型在文本渲染和信息图生成方面的性能。
- 在 ImgEdit, GEdit-Bench, WeEdit, OmniRef-Bench, RISEBench, OpenING 等基准上评估图像编辑能力,验证模型在图像编辑方面的性能。
- 在 VBVR-Pro-Bench, Uni-MMMU-GaU, RealUnify-GEU 上评估交错生成和视觉推理能力,验证模型在交错生成和视觉推理方面的性能。
关键结果与论文证据
- 在 MMMU 基准上,SenseNova-U1.5 取得了 73.86 的分数,证明了其在多模态理解方面的强大能力(第 15 页)。
- 在 Qwen-Image-Bench-EN 基准上,SenseNova-U1.5 取得了 60.22 的分数(w/ PE),证明了其在图像生成方面的优秀性能(第 16 页)。
- 在 GenEval 基准上,SenseNova-U1.5 取得了 0.92 的分数,证明了其在图像生成质量方面的竞争力(第 17 页)。
- 在 CVTG-2K 基准上,SenseNova-U1.5 取得了 0.948 的平均词准确率,证明了其在文本渲染方面的强大能力(第 19 页)。
- 在 LongText-Bench-EN 基准上,SenseNova-U1.5 取得了 0.988 的分数,证明了其在长文本渲染方面的优秀性能(第 20 页)。
- 在 ImgEdit 基准上,SenseNova-U1.5 展现了与顶级闭源系统竞争的能力,证明了其在图像编辑方面的有效性(第 22 页)。
- 在 VBVR-Pro-Bench 基准上,SenseNova-U1.5 在交错生成和视觉推理方面展现了强大的能力,证明了其在复杂视觉任务中的有效性(第 25 页)。
- 在 Uni-MMMU-GaU 基准上,SenseNova-U1.5 在视觉推理方面展现了优秀的性能,证明了其在多模态推理方面的能力(第 25 页)。
阅读时需要注意
- 在结构化格式(如复杂信息图)的生成数据暴露有限,尽管泛化能力较强,但与顶级闭源系统仍有差距。
- 模型参数量为 8B,相比一些大型闭源模型(如 GPT-Image-2)在绝对性能上仍有提升空间。
- 部分基准测试(如 Gemma4-12B 的结果)是使用 VLMEvalKit 复现的,可能存在细微差异。
- 强化学习阶段使用了特定的奖励模型(如 HPSv3++, PaddleOCR),其性能可能受奖励模型本身偏差的影响。
关联工作
- SenseNova-U1 是前代模型,SenseNova-U1.5 在其基础上改进了视觉接口和训练策略(第 5 页)。
- NEO-unify 是基础架构,SenseNova-U1.5 基于 NEO-unify 的 encoder-free 和 VAE-free 设计(第 5 页)。
- Qwen3-VL 是对比基线,用于评估多模态理解能力(第 15 页)。
- Gemma4-12B 是对比基线,代表最新的 encoder-free 视觉理解模型(第 15 页)。
- Flow-GRPO 是强化学习方法,用于扩散模型的在线 RL(第 6 页)。
- On-Policy Distillation (OPD) 是蒸馏方法,用于整合多专家能力(第 6 页)。