Mixture-of-Transformers
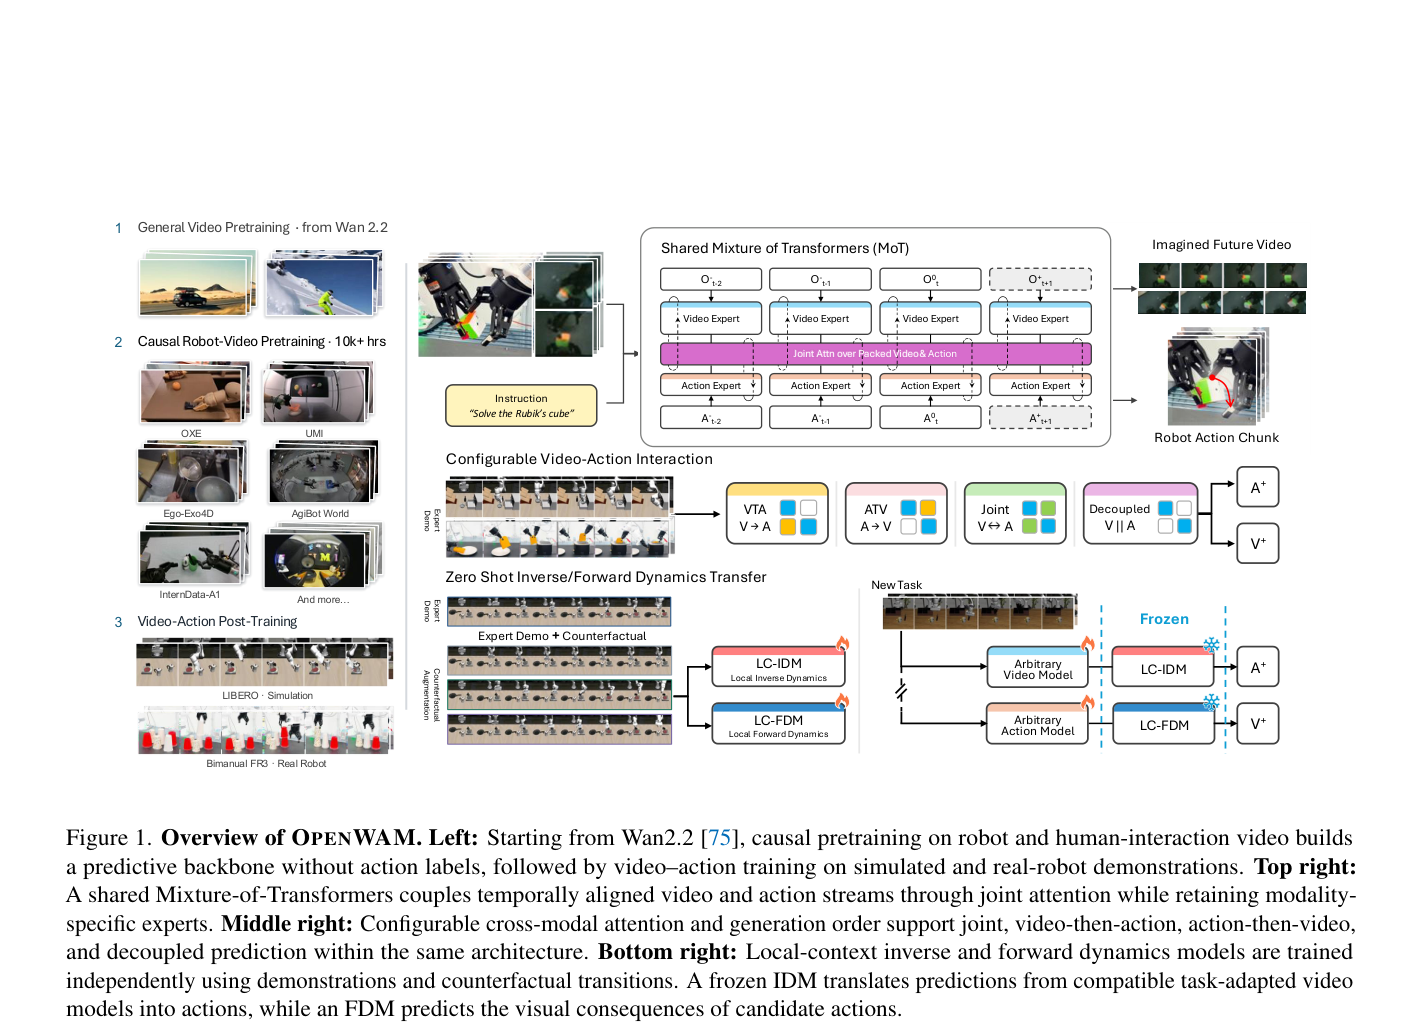
PixelUMM:无编码器的统一图像与视频理解生成
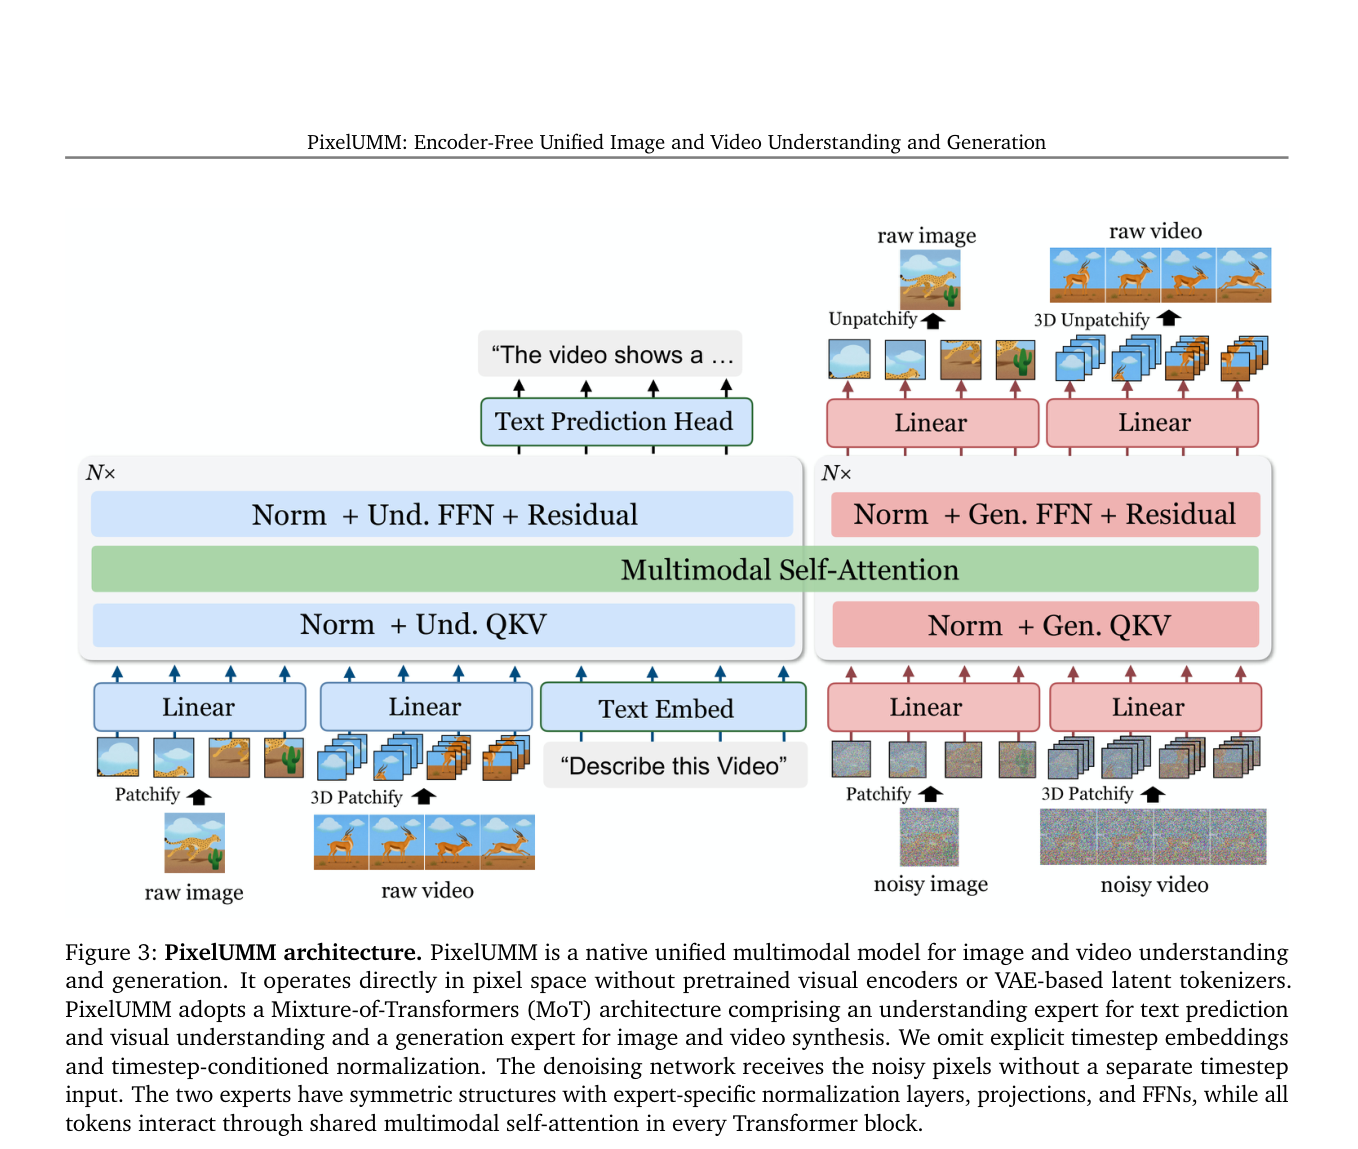
PixelUMM 用单层线性投影把图像 patch 与视频 tubelet 直接送入 Mixture-of-Transformers,在像素空间联合做理解与流匹配生成。
SenseNova-U1.5:迈向原生统一视觉智能
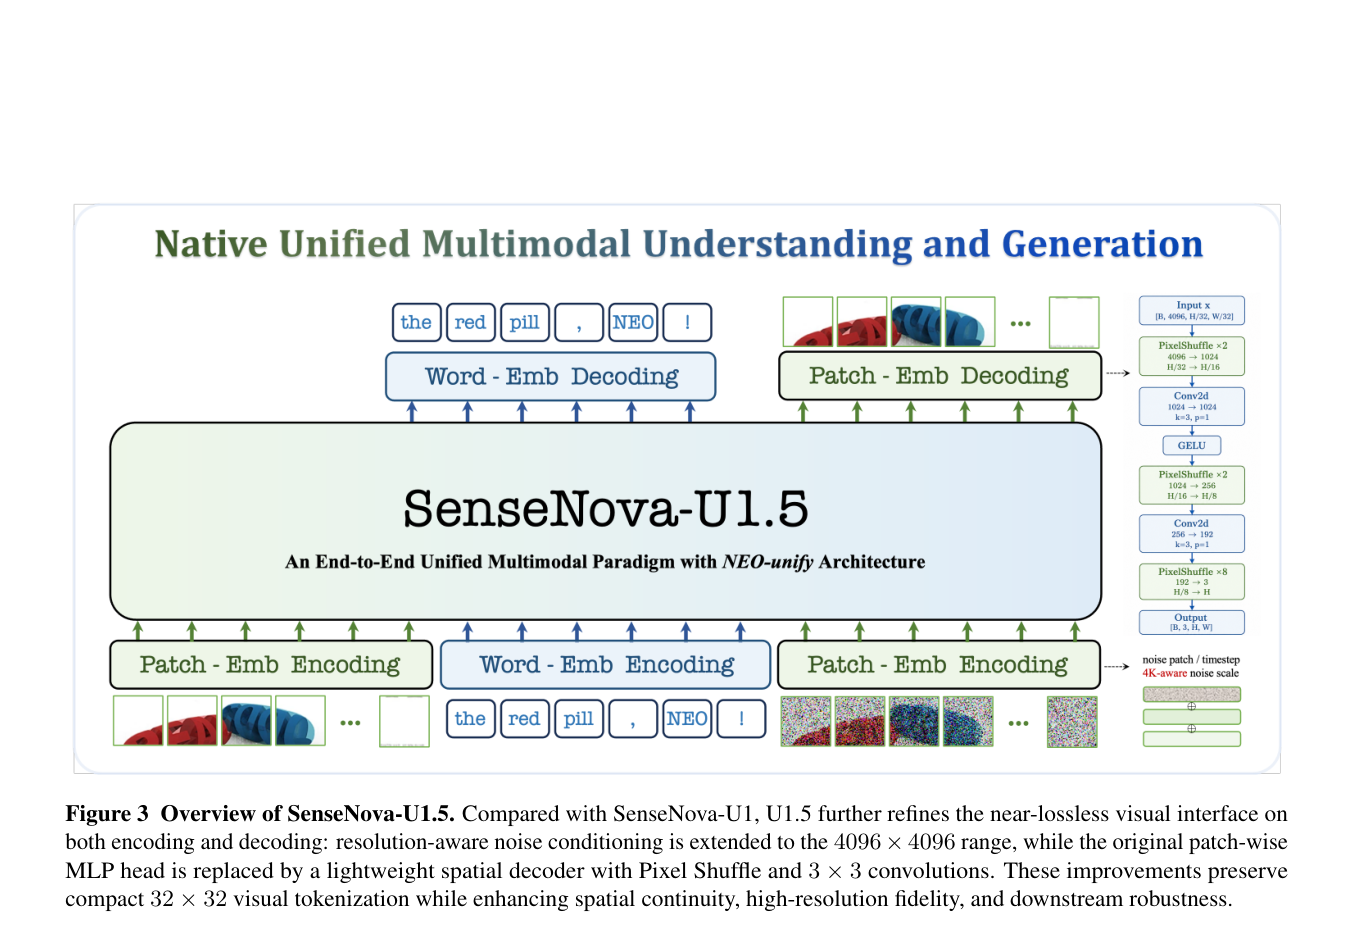
SenseNova-U1.5 是一个 8B 参数的原生统一多模态模型,通过空间联合重建解码器和多专家强化学习及蒸馏策略,在无需外部编码器和 VAE 的情况下实现了高质量的视觉理解、推理与生成。