快速导读:本文提出 HuRo 流水线,将大规模人类视频转化为对齐的机器人观测与动作数据,构建包含 630K 个 episode 的 HuRo 数据集,证明其作为 VLA 策略预训练源的可扩展性及在真实世界操作任务中的优越性能。
VLA 策略的性能高度依赖预训练数据的规模与质量,但真实机器人数据的采集成本极高且规模受限。人类视频虽然丰富,但存在显著的 embodiment gap,即观测和动作与机器人不对齐。本文提出 HuRo 流水线,旨在将大规模人类视频转化为对齐的机器人观测与动作数据,从而为 VLA 策略提供可扩展的预训练源。
HuRo 流水线包含三阶段:人类视频标注、动作转换和视觉转换。基于此构建的 HuRo 数据集包含 630K 个 episode 和 142M 帧,规模比先前方法大一个数量级。实验证明,使用 HuRo 数据进行预训练的 VLA 策略在真实世界操作任务中表现出清晰的 scaling 行为,且视觉机器人化显著提升了 OOD 鲁棒性。
英文题目:HuRo: Robotizing Human Videos for Scalable VLA Pretraining
论文出处:arXiv 每日论文精选 · arXiv:2609.10706
原始论文:PDF / 论文页面
这篇论文解决什么问题?
真实机器人数据稀缺且昂贵,限制了 VLA 策略的规模化预训练。现有方法要么仅在任务匹配场景下机器人化视频,要么在大规模下仅对齐观测或动作之一,缺乏联合观测-动作对齐的可扩展预训练数据源。
人类视频丰富但存在 embodiment gap。现有工作如 H2R、Masquerade 主要关注视觉对齐或辅助目标,VITRA、EgoScale 关注动作监督但保留人类观测,Phantom 等仅在任务匹配下联合对齐。这些方法在大规模预训练中的可扩展性和 OOD 鲁棒性尚未得到充分验证。
本文的核心问题是:如何将大规模人类视频转化为对齐的机器人观测与动作数据,以支持 VLA 策略的可扩展预训练,并验证其在真实世界操作任务中的有效性。
核心创新
- 提出联合观测-动作对齐的机器人化流水线,支持异构人类视频源转换为统一机器人格式
- 构建大规模 HuRo 数据集(630K episodes, 142M frames),规模比先前方法大一个数量级
- 证明机器人化人类视频预训练具有清晰的 scaling 行为,且视觉机器人化显著提升 OOD 鲁棒性
- 验证端到端 VLA 预训练(含 retargeted actions)优于仅视觉迁移
方法概览
开发三阶段机器人化流水线:1) 人类视频标注(估计相机几何、手部运动、VLM 生成指令);2) 动作转换(将人手运动 retarget 为机器人关节轨迹);3) 视觉转换(移除人手、渲染并叠加机器人)。基于此构建 HuRo 数据集(630K episodes, 142M frames),用于 GR00T-N1.6-3B 架构的 VLA 策略端到端预训练。
- 人类视频标注:估计相机几何、手部运动,并使用 VLM 生成指令。
- 动作转换:将人手运动 retarget 为机器人关节轨迹,使用 Flow Matching 作为动作头训练目标。
- 视觉转换:移除人手,渲染并叠加机器人,使用 MANO 手部姿态模型和 URDF 统一机器人描述格式。
- 构建 HuRo 数据集:包含 630K 个 episode 和 142M 帧,支持异构人类视频源转换为统一机器人格式。
- 端到端 VLA 预训练:使用 GR00T-N1.6-3B 架构,将 HuRo 数据用于 VLA 策略的端到端预训练。
- 消融实验设计:包括预训练规模消融、视觉机器人化消融、端到端预训练 vs. 仅视觉迁移、与视频生成预训练的 scaling 对比、跨 embodiment 迁移测试。
逐图理解论文
直觉与失败案例
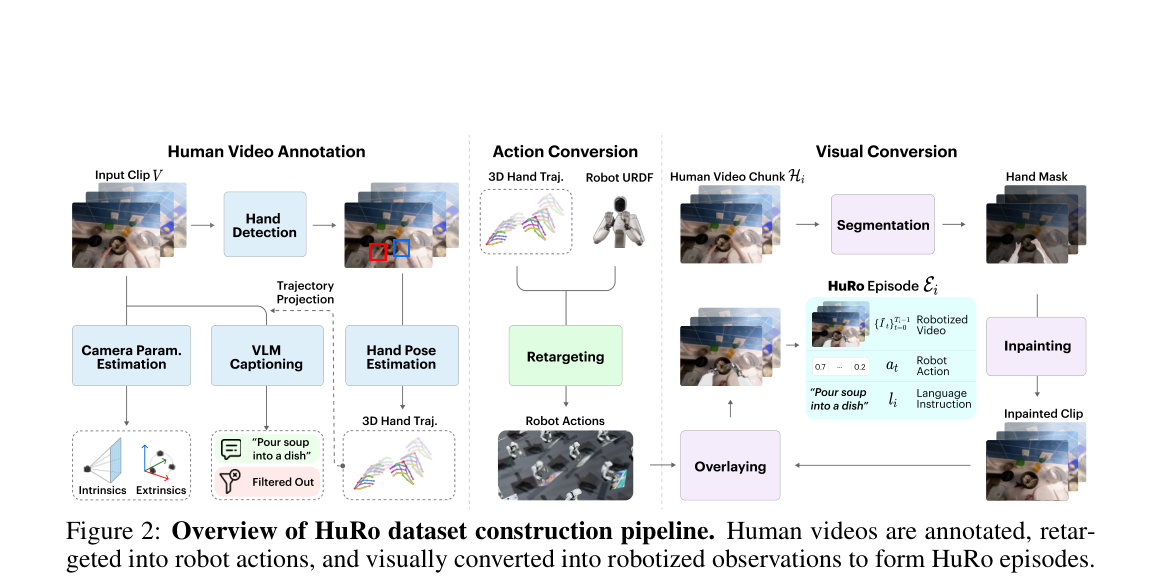
该图详细展示了 HuRo 数据集构建流水线,包括标注、retargeting 和视觉转换三个阶段。需要关注各阶段的具体算法和数据处理细节,以及最终 HuRo episodes 的构成。
论文贡献与验证
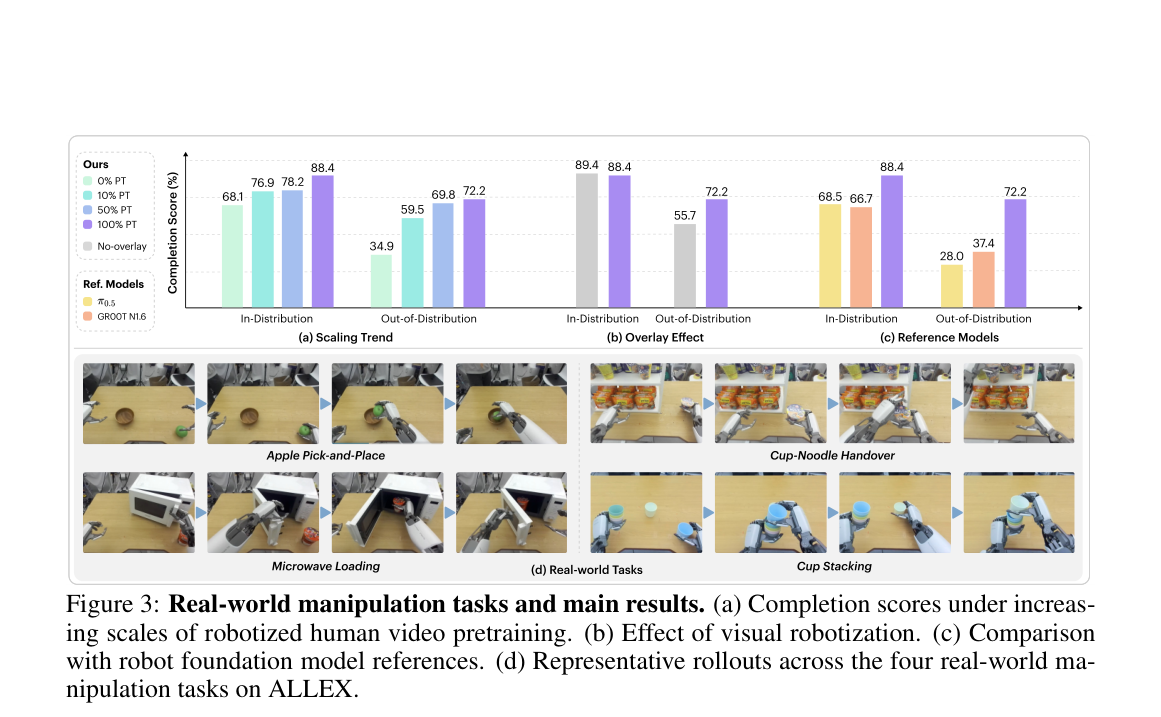
该图展示了真实世界操作任务和主要结果,包括预训练规模、视觉机器人化效果、与机器人基础模型对比以及代表性 rollouts。需要关注 OOD 评估的具体设置和性能提升的显著性。
最强结论
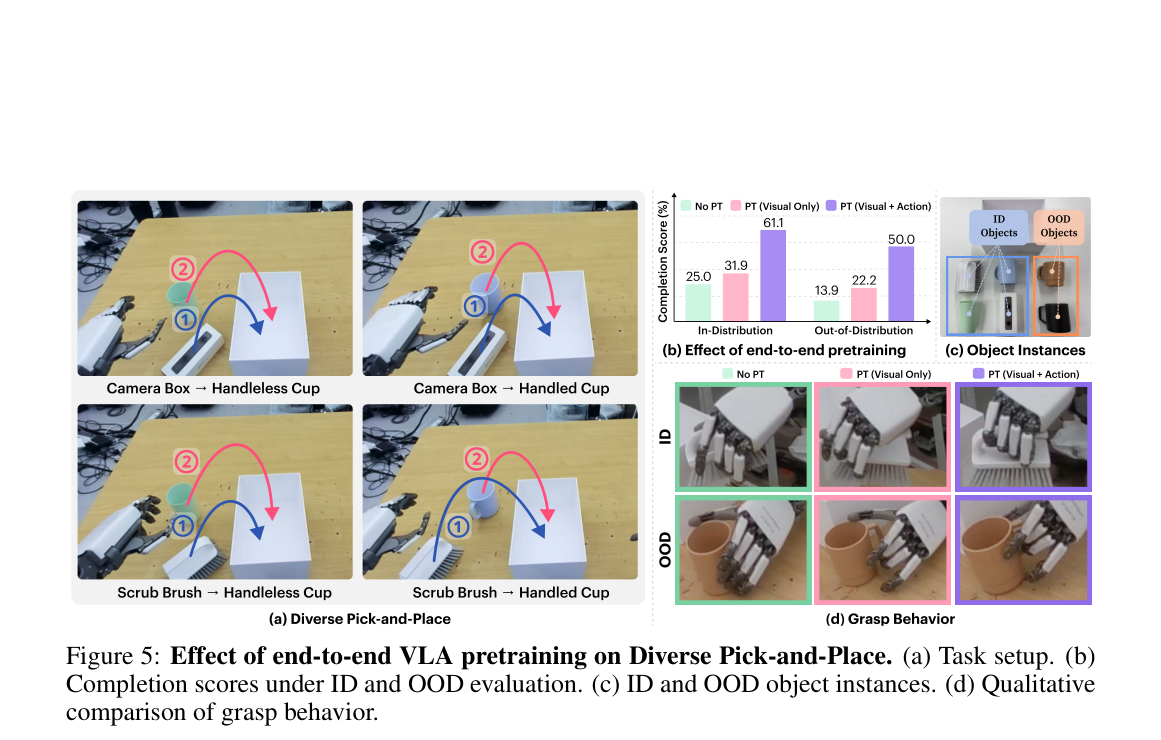
该图展示了端到端 VLA 预训练对 Diverse Pick-and-Place 的影响,包括任务设置、ID 和 OOD completion、ID 和 OOD 物体实例以及抓取行为的定性对比。需要关注端到端预训练相比仅视觉迁移的优势。
实验如何设计?
- ALLEX 真实世界四任务评估:Apple Pick-and-Place, Cup Stacking, Cup-Noodle Handover, Microwave Loading。
- 预训练规模消融:0%, 10%, 50%, 100% HuRo 数据。
- 视觉机器人化消融:no-overlay vs. full overlay。
- 端到端预训练 vs. 仅视觉迁移:Diverse Pick-and-Place 任务。
- 与视频生成预训练(I2V + IDM)的 scaling 对比。
- OpenArm 跨 embodiment 迁移测试。
关键结果与论文证据
- 预训练规模消融:Overall completion 从 51.5% (0% PT) 提升至 80.3% (100% PT),OOD completion 从 34.9% (0% PT) 提升至 72.2% (100% PT) (p. 6)。
- 视觉机器人化消融:No-overlay OOD 为 55.7%,Full PT OOD 为 72.2%,表明视觉机器人化显著提升 OOD 鲁棒性 (p. 7)。
- 端到端预训练 vs. 仅视觉迁移:Diverse Pick-and-Place 中,PT (Visual+Action) ID 为 61.1%,OOD 为 50.0%,而 No PT ID 为 25.0%,OOD 为 13.9% (p. 7)。
- 与视频生成预训练的 scaling 对比:HuRo 0.7M frames 在 OOD 上优于 I2V+IDM 7.0M frames (83.3% vs. 69.4%) (p. 8)。
- OpenArm 跨 embodiment 迁移:Ours (HuRo PT) Overall 为 72.9%,Human-HRDT 为 65.6%,表明 HuRo 预训练在跨 embodiment 迁移中保持竞争力 (p. 17)。
- Cup Stacking OOD:60.4% (10% PT) 提升至 79.2% (100% PT),表明预训练规模对 OOD 鲁棒性有显著影响 (p. 6)。
阅读时需要注意
- 机器人化观测保真度受限于重建和视觉转换质量,未显式建模遮挡,可能存在渲染伪影。
- HuRo 数据集仅提供视觉和运动学动作监督,缺乏力或触觉信号,不适合接触丰富操作。
- 运动学 retargeting 未建模自碰撞或物理接触,55.2% 的轨迹存在非抓取自接触,仅作为预训练监督而非可执行演示。
- 结果基于 ALLEX 和 OpenArm 两个 embodiment,其他形态泛化性未充分验证。
- OOD 评估仅涉及空间布局和视觉外观变化,未测试更复杂的语义或物理变化。
- 预训练数据中 EgoDex 占比最高(55.5%),可能影响对其他源数据的贡献评估。
关联工作
- H2R:视觉机器人化用于预训练视觉编码器,未联合动作对齐 (p. 2)。
- Masquerade:恢复 3D 手部轨迹用于预训练未来 2D 末端执行器预测,本文扩展其动作监督版本进行对比 (p. 2)。
- VITRA:将人手视为灵巧末端执行器,对齐机器人动作到统一人手动作空间,保留人类观测 (p. 2)。
- EgoScale:将人手运动 retarget 为目标机器人动作用于大规模第一人称预训练 (p. 2)。
- Phantom:联合对齐机器人动作和渲染机器人观测,但主要在任务匹配场景下研究 (p. 3)。
- DreamGen:视频生成预训练基线,本文与其进行 scaling 对比 (p. 8)。