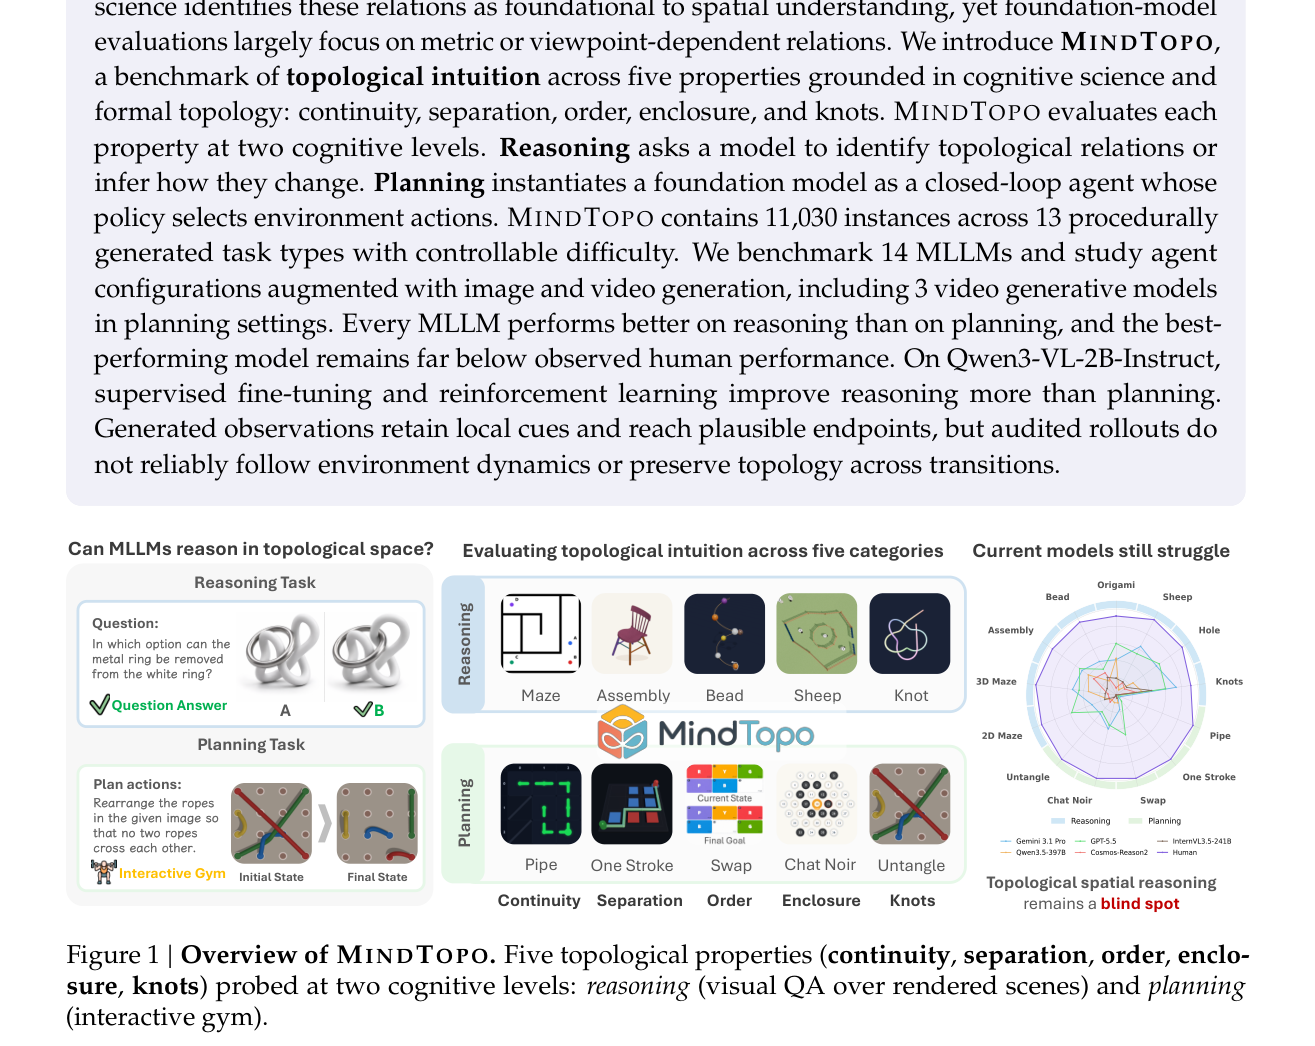
快速导读:本文提出 MINDTOPO 基准,基于认知科学和形式拓扑学定义五种拓扑属性,通过推理和规划两个认知层级评估 14 个 MLLM 的拓扑直觉能力,发现模型在静态推理上表现优于交互式规划,且视频生成代理无法可靠保持拓扑不变性。
MINDTOPO 是一项旨在评估多模态大语言模型(MLLM)拓扑直觉能力的基准测试。它基于认知科学中的 Piaget 理论和形式拓扑学,定义了连续性、分离性、顺序、封闭性和结五种核心拓扑属性。与现有主要关注欧几里得度量或视角依赖关系的基准不同,MINDTOPO 聚焦于在连续变形下保持不变的拓扑关系。
该基准包含 13 种程序化生成的任务类型,涵盖 11,030 个实例,分为推理和规划两个认知层级。推理任务通过视觉问答评估模型识别拓扑关系的能力,而规划任务则在交互式 Gym 环境中测试模型基于拓扑关系执行闭环动作的能力。这种双层级设计使得研究者能够区分模型是缺乏拓扑理解,还是缺乏将理解转化为行动的能力。
英文题目:MINDTOPO: Can Foundation Models Reason in Topological Space?
论文出处:arXiv 每日论文精选 · arXiv:2609.11900
原始论文:PDF / 论文页面
这篇论文解决什么问题?
认知科学指出,拓扑关系是人类空间理解的基础,先于欧几里得关系发展。然而,当前基础模型在拓扑直觉方面存在显著盲区。现有空间推理基准如 SpatialVLM 主要评估距离、角度等度量关系,而 CurveBench 和 TopoBench 仅关注特定拓扑结构或符号谜题,缺乏对多种拓扑属性的系统覆盖。
更重要的是,现有基准未区分“识别拓扑关系”与“基于拓扑关系进行规划行动”的能力差异。模型可能在静态图像上正确识别拓扑关系,但在需要连续动作执行的交互式环境中失败。这种推理到行动的迁移差距是理解模型空间认知瓶颈的关键。
此外,视频生成模型作为规划代理的观测预测模块,其拓扑保持性尚未得到系统验证。局部视觉合理性不能证明模型具备拓扑保持的世界模型,这为评估生成式代理的可靠性带来了挑战。
核心创新
- 首次将拓扑直觉作为空间推理的独立评估目标,基于 Piaget 分类和形式拓扑学定义五种属性。
- 提出双层级评估框架:推理(识别/预测拓扑关系)和规划(闭环代理执行动作),揭示推理到行动的迁移差距。
- 构建可扩展的程序化生成基准,包含 11,030 个实例,支持可控难度和自动标注。
- 引入视频生成模型作为规划代理的观测预测模块,并通过计算机视觉诊断验证拓扑保持性。
方法概览
构建 MINDTOPO 基准,包含 13 种程序化生成的任务类型,覆盖连续性、分离性、顺序、封闭性和结五种拓扑属性。每个属性在两个认知层级进行评估:推理(视觉问答)和规划(交互式 Gym 环境)。采用全自动数据收集流水线,包括场景生成、拓扑标注、难度控制和实例生成。评估 14 个 MLLM,并研究 SFT 和 RL 训练效果,以及结合图像/视频生成的代理配置。
- 基于 Piaget 分类和形式拓扑学定义五种拓扑属性:连续性、分离性、顺序、封闭性和结。每种属性对应特定的认知科学基础和形式化定义。
- 构建 13 种任务类型,覆盖 2D/3D 迷宫、组装、珠子、折纸点、羊、孔、结等推理任务,以及管道、一笔画、2D 拼图交换、Chat Noir、解结等规划任务。
- 采用全自动数据收集流水线,包括场景生成、拓扑标注、难度控制和实例生成。拓扑标注通过程序化构建参考答案和成功条件实现,而非人工标注。
- 实现可控难度参数化,每个任务包含 Easy、Medium、Hard 三个难度层级,通过拒绝采样抑制平凡可解场景。
- 设计交互式 Gym 环境,支持多步 rollout 和动作执行,评估模型在闭环决策中的拓扑保持能力。
- 引入视频生成模型(如 GPT-Image-2、Wan2.2-I2V-A14B)作为规划代理的观测预测模块,并通过计算机视觉诊断验证拓扑保持性。
- 实现严格的视频级 CV 检查,包括最终状态成功检查和过程有效性检查,后者要求所有静态和动态检查均通过。
- 评估 14 个 MLLM(5 个专有,9 个开源),并研究 SFT 和 RL 训练效果,分析推理与规划的提升差异及留出任务迁移能力。
逐图理解论文
直觉失败
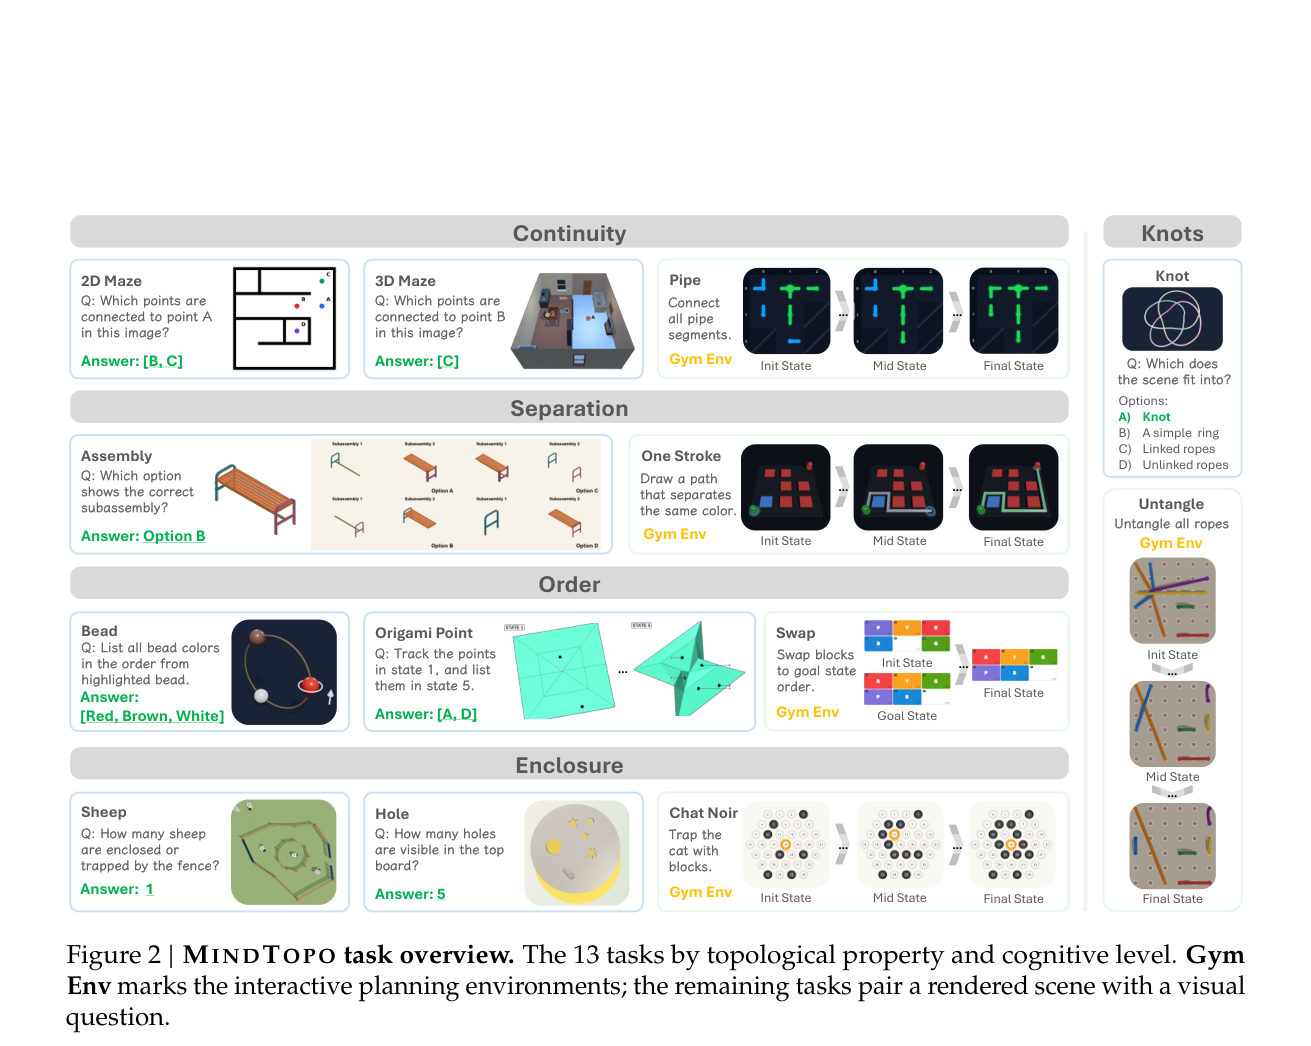
该图列出了 13 种任务类型及其对应的拓扑属性和认知层级。观察重点在于 Gym Env 标记的交互式规划环境,以及其余任务如何配对渲染场景和视觉问题。这有助于理解基准的任务覆盖范围和评估设计。
研究空白
现有基准主要关注度量或视角依赖关系,缺乏对拓扑不变性的系统评估,且未区分识别与规划能力。
核心贡献
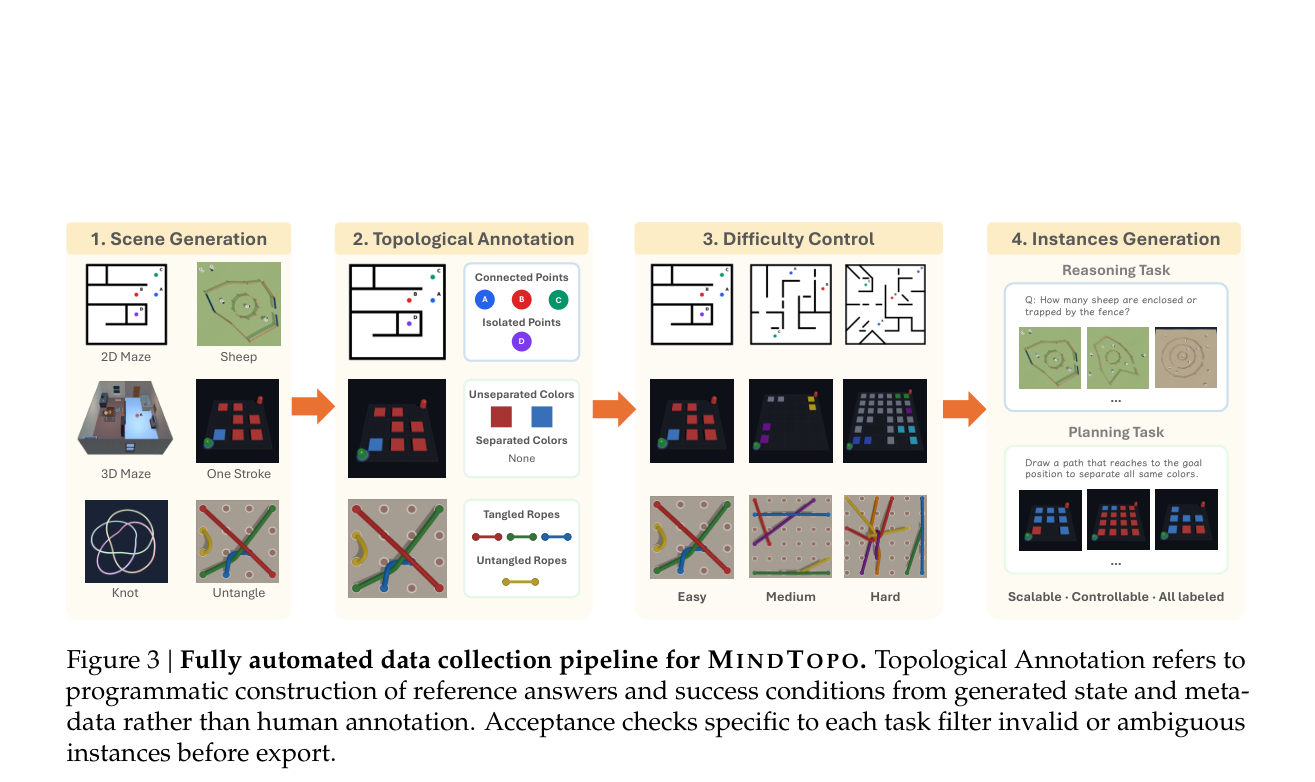
该图展示了 MINDTOPO 的全自动数据收集流水线。观察重点在于拓扑标注如何通过程序化构建参考答案和成功条件实现,以及接受检查如何过滤无效或模糊实例。这有助于理解基准的可扩展性和自动标注机制。
关键发现
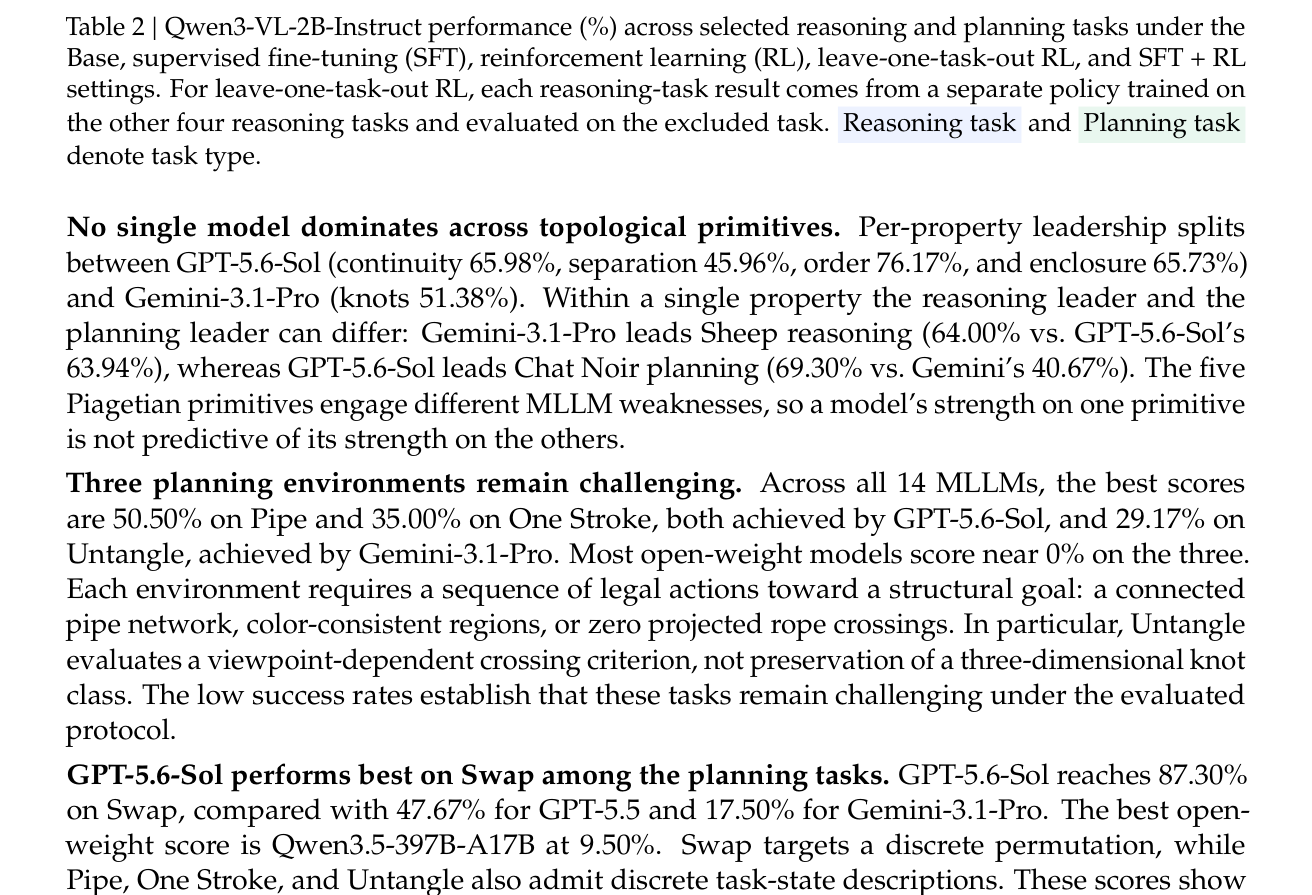
该表展示了 Qwen3-VL-2B-Instruct 在不同训练设置下的性能。观察重点在于 SFT 和 RL 对推理和规划能力的差异化影响,以及留出任务迁移实验的结果。这有助于理解训练策略对拓扑直觉习得的作用。
实验如何设计?
- 基准测试:评估 14 个 MLLM 在 13 个任务上的表现,对比人类和随机基线。
- 训练实验:在 Qwen3-VL-2B-Instruct 上比较 Base、SFT、RL 和 SFT+RL 的效果,分析推理与规划的提升差异。
- 错误分析:对 Gemini-3.1-Pro 和 InternVL3.5-241B 的 910 个错误样本进行七类错误分类,分析推理与规划失败模式的差异。
- 探针实验:测试结合 GPT-Image-2、Wan2.2-I2V-A14B 等生成模型的代理配置,评估生成观测对规划性能的影响。
- 视频诊断:审计 1,560 个视频 rollout,使用静态和动态检查验证拓扑保持性,发现端点成功不等于过程有效。
- 留出任务迁移实验:训练 RL 策略时留出特定推理任务,评估策略在未见任务上的泛化能力。
关键结果与论文证据
- GPT-5.6-Sol 在推理任务上平均 66.83%,规划任务上 52.75%,整体 61.42%,远低于人类的 97.87%(p. 7)。
- Qwen3-VL-2B-Instruct 在 SFT+RL 后,推理准确率从 14.24% 提升至 51.53%,规划成功率仅从 0.20% 提升至 6.33%(p. 9)。
- 推理错误中 58.1% 为感知接地失败,规划错误中 43.3% 为动作规划失败,24.5% 为动态违规(p. 10)。
- 在 1,560 个视频 rollout 中,没有生成器在 One Stroke、Pipe 或 Untangle 上实现过程有效的任务成功(p. 13)。
- Wan2.2-I2V-A14B 在 119 个审计 rollout 中,116 个违反动态约束,93 个存在拓扑不变性错误(p. 11)。
- 开源模型在规划任务上表现极差,如 Pipe 和 One Stroke 为 0%,反映当前开源架构在交互式决策上的瓶颈(p. 8)。
- SFT 主要提升推理能力,RL 对规划能力的提升有限,表明拓扑直觉的习得需要更复杂的训练信号(p. 9)。
- 视频生成模型的端点成功率高但过程无效,表明局部视觉合理性不能证明拓扑保持的世界模型(p. 12)。
阅读时需要注意
- 所有场景均为程序化渲染(Three.js 或特定模拟器),缺乏真实世界照片的视觉多样性。
- 视频策略评估仅覆盖 3 个视频生成模型,结论的普适性有待更广泛验证。
- 五种 Piaget 原始属性未涵盖所有拓扑空间,如方向、复合变换下的连续变形和高亏格曲面。
- 错误分析样本量有限(464 张图像,119 个视频),统计边界较宽。
- 规划任务的成功率极低,可能受限于动作空间复杂度和模型执行长序列动作的能力,而非单纯的拓扑理解。
关联工作
- CurveBench 仅评估嵌套曲线的包含树,未涵盖多种拓扑属性和规划任务(p. 13)。
- TopoBench 关注符号网格谜题的全局空间约束,缺乏交互式评估和认知科学基础(p. 13)。
- KnotGym 仅关注结的交互式操作,未涵盖其他四种拓扑属性(p. 13)。
- SpatialVLM 主要评估欧几里得空间关系,未涉及拓扑不变性(p. 13)。
- VAGEN 强化世界模型推理,但未专门针对拓扑保持性进行诊断(p. 13)。