快速导读:本文提出 SOFTPROMPT,通过在跨模态边界注入少量连续软提示 token 并采用空格初始化,在冻结 VLM 骨干网络的前提下,以极少的可训练参数实现了与 LoRA 相当的少样本检测性能,且无灾难性遗忘。
在专业领域的少样本目标检测中,视觉-语言模型(VLM)面临适配精度与通用能力保留的两难困境。现有方法要么修改大量骨干参数导致灾难性遗忘,要么受限于离散提示的表达瓶颈。SOFTPROMPT 提出在跨模态边界注入连续软提示 token,通过极简参数优化实现高效适配。
英文题目:Soft Prompting for Few-Shot Adaptation of Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.11310
原始论文:PDF / 论文页面
这篇论文解决什么问题?
航空、工业、医疗等垂直领域的 10-shot 检测任务中,通用 VLM 性能骤降。主流适配策略分为离散提示优化(如 DetPO、GEPA)和参数高效微调(如 LoRA)。离散提示缺乏梯度优化能力,表达受限;LoRA 虽精度高,但修改数百万骨干参数,导致 VQA 等通用能力显著下降。
核心创新
- 识别出跨模态边界注入(IST)和空格初始化是软提示在多模态检测中成功的关键因素,优于 NLP 标准的前缀位置和语义初始化。
- 证明在 10-shot 设定下,仅训练约 7K 参数的软提示即可达到 LoRA(r=64, 174.6M 参数)的检测精度(14.2 mAP),且完全避免骨干网络的灾难性遗忘。
- 提出 SOFT2HARD 蒸馏机制,将训练好的软提示转化为人类可读的硬提示,其性能与专用提示搜索方法(DetPO)相当,优于 GEPA。
- 验证了跨模型迁移能力:在 Qwen3-VL-8B 上训练的软提示可直接加载到 Qwen3.5-9B 中,无需重训练即可带来性能提升。
- 将方法扩展至视觉-语言-动作(VLA)策略,证明在机器人操作任务中,提示必须位于动作专家的梯度路径上才能有效适配。
方法概览
SOFTPROMPT 包含三个核心设计:1. 注入位置:将 L 个连续软提示 token 插入图像 token 和文本 token 之间的跨模态边界(IST 顺序),使其能关注所有视觉补丁并被所有文本 token 关注;2. 初始化:使用语义中性的空格 token 初始化,保持初始状态与冻结基线一致,避免语义干扰;3. 训练:仅优化这 L 个 token(平均 7,168 参数),骨干网络完全冻结。此外,提出 SOFT2HARD 蒸馏方法,将软提示转化为可编辑的自然语言硬提示。
- 注入位置:将 L 个连续软提示 token 插入图像 token 和文本 token 之间的跨模态边界(IST 顺序),使其能关注所有视觉补丁并被所有文本 token 关注。
- 初始化策略:使用语义中性的空格 token 初始化,保持初始状态与冻结基线一致,避免语义干扰导致的训练不稳定。
- 训练机制:仅优化这 L 个 token(平均 7,168 参数),骨干网络完全冻结,通过反向传播在冻结块末端形成单一可训练汇聚点。
- SOFT2HARD 蒸馏:通过两阶段过程将训练好的软提示转化为人类可读的硬提示,第一阶段生成富含细节的描述,第二阶段总结为可编辑文本。
- 跨模型迁移:验证了在 Qwen3-VL-8B 上训练的软提示可直接加载到 Qwen3.5-9B 中,无需重训练即可带来性能提升。
- VLA 扩展:将方法扩展至视觉-语言-动作(VLA)策略,证明在机器人操作任务中,提示必须位于动作专家的梯度路径上才能有效适配。
逐图理解论文
两难困境
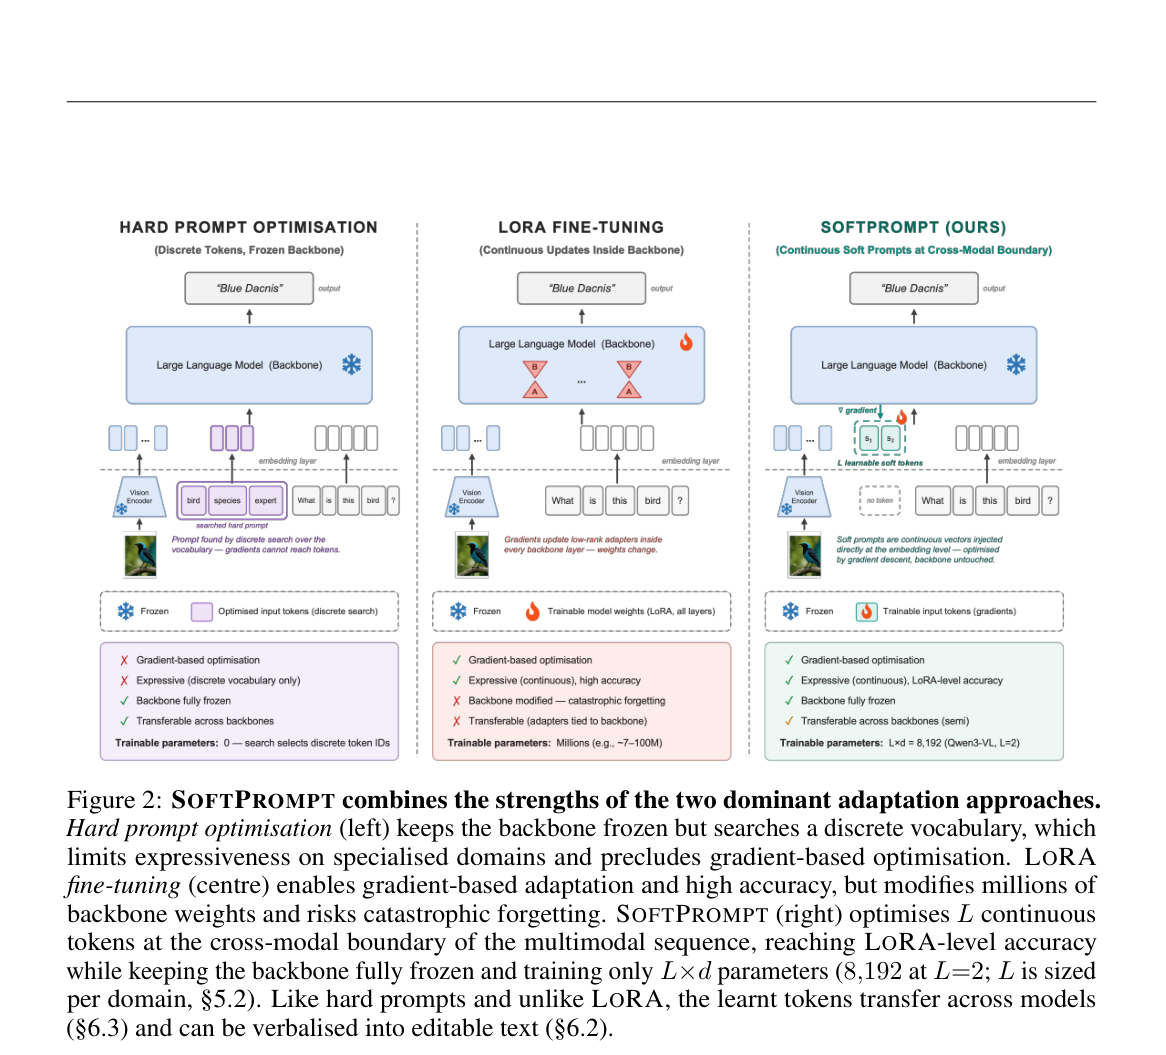
该图直观对比了三种适配策略:Hard Prompt 保持骨干冻结但受限于离散词汇;LoRA 实现梯度优化但修改数百万权重;SOFTPROMPT 在跨模态边界优化 L 个连续 token,达到 LoRA 精度同时保持骨干冻结。重点观察右侧 SOFTPROMPT 的 token 位置及其与 LoRA 的参数规模对比。
关键区分
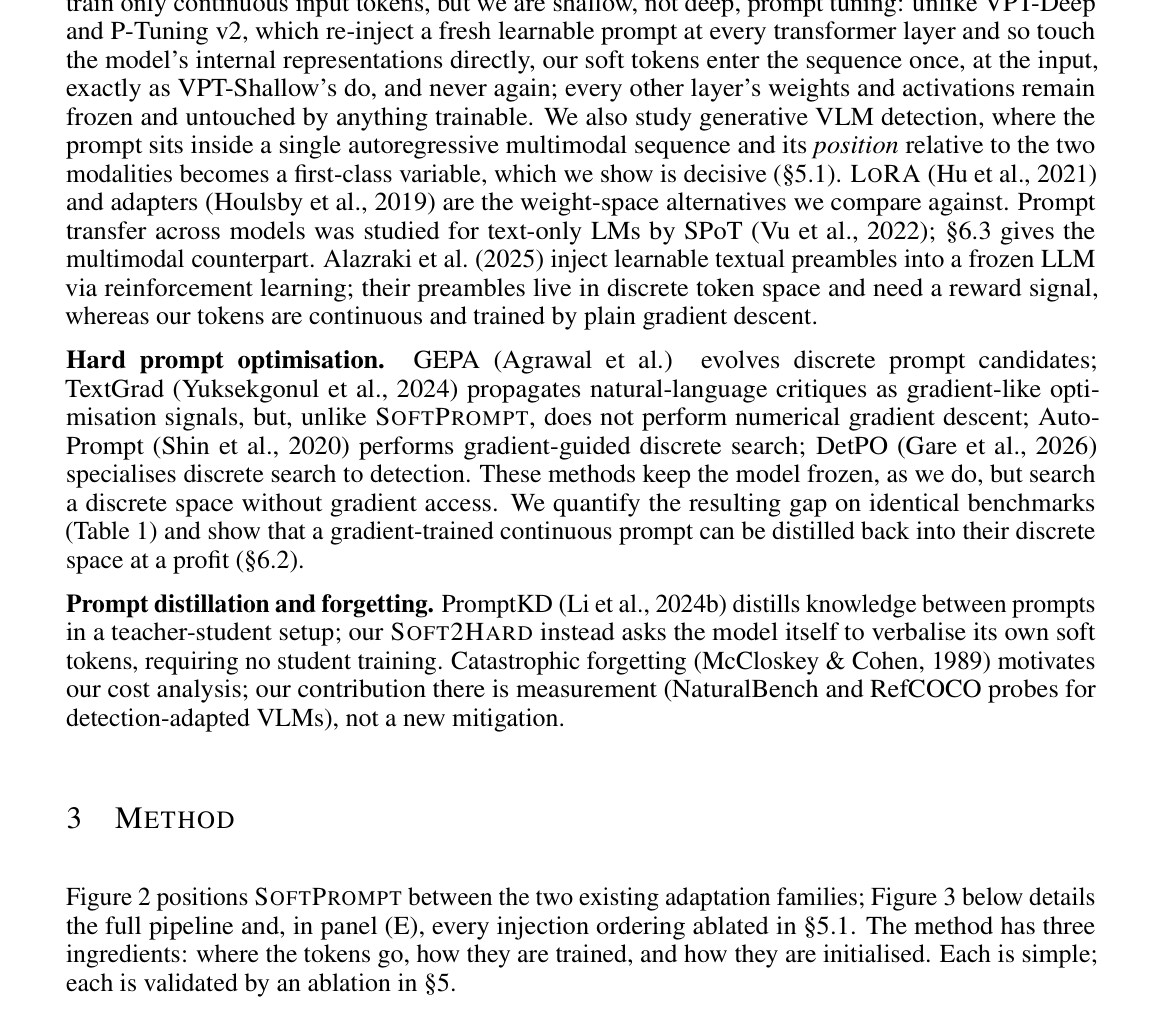
该图详细展示了 SOFTPROMPT 的完整流水线,包括 token 注入位置、训练过程和初始化策略。重点观察面板 (E) 中所有消融的注入顺序,理解 IST 顺序如何使软提示关注所有视觉补丁。
最强结论
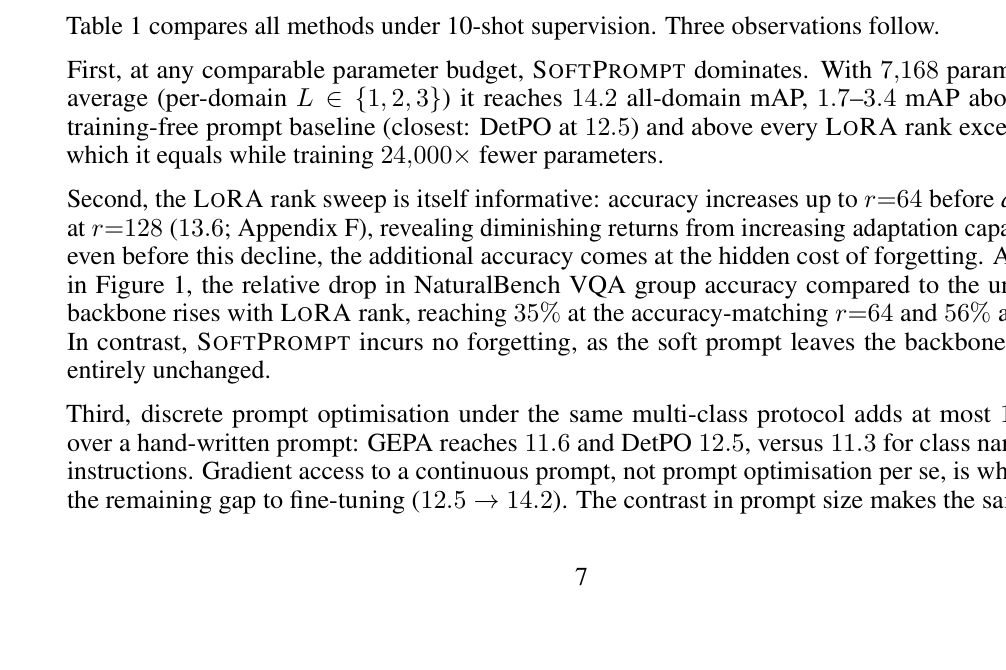
该表对比了所有方法在 10-shot 监督下的性能。重点观察 SOFTPROMPT 与 LoRA (r=64) 的 mAP 对比,以及 SOFTPROMPT 在 NaturalBench 上的遗忘率(0%)与 LoRA 的显著下降。
实验如何设计?
- 主实验在 Roboflow20-VL 基准(20 个领域,10-shot)上进行,对比 SOFTPROMPT、LoRA、Hard Prompt、GEPA、DetPO 和 Grounding DINO。
- 遗忘评估在 NaturalBench 和 RefCOCO 上进行,测量适配后的 VQA 和 Grounding 能力变化。
- 高基线场景测试在 LVIS Rare 50 上进行,验证方法在基础能力较强时的增益。
- 跨家族泛化性在 Gemma-4-12B-it 上验证,测试方法在不同 VLM 架构上的适用性。
- 机器人操作实验在 RoboCasa 任务上进行,使用 π0.5 VLA 策略骨干测试适配效果。
- 消融实验覆盖注入位置(6 种顺序)、提示长度(L=0-8)和初始化策略(5 种)。
关键结果与论文证据
- SOFTPROMPT 在 Roboflow20-VL 10-shot 全领域 mAP@50:95 达到 14.2,与 LoRA (r=64) 持平,但可训练参数少 24,000 倍(p.8)。
- LoRA (r=64) 导致 NaturalBench VQA 准确率相对下降 35%,r=128 时下降 56%;SOFTPROMPT 遗忘率为 0%(p.8)。
- 跨模态边界注入(IST)在 8 个非地板控制数据集中的 6 个上取得最佳性能,平均 mAP 12.4,优于前缀位置(SIT)的 9.6(p.11)。
- 空格初始化在 8 个非地板控制数据集中的 5 个上取得最佳性能,平均 mAP 12.4,优于任务文本初始化的 9.6(p.12)。
- SOFT2HARD 蒸馏出的硬提示达到 12.5 mAP,与 DetPO 持平,高于 GEPA (11.6)(p.14)。
- 跨模型迁移(Qwen3-VL-8B -> Qwen3.5-9B)平均提升 +0.8 mAP,在 13/20 数据集上有效(p.15)。
- 在 RoboCasa 机器人任务中,双提示(Dual Prompt)将 PickPlace 成功率从 5.0% 提升至 23.3%,Faucet 从 5.0% 提升至 31.7%(p.16)。
- 在 LVIS Rare 50 上,SOFTPROMPT 在最佳长度(L=1)时增加 +3.3 mAP,但错误长度(L=3)导致性能低于基线(p.9)。
阅读时需要注意
- 统计支持有限:所有结果均为单次运行,少样本设定下种子间方差较大(20-28%),小于 1 mAP 的差异应视为持平。
- 范围限制:主要检测结果和消融实验均在 Qwen3-VL 家族内进行;Gemma-4 验证了泛化性,但超参数搜索的 holdout-to-test 可靠性不如 Qwen3-VL。
- 选择偏差:部分蒸馏上限和迁移源使用了在测试集上选择的最佳位置(IST/TSI),已在文中披露,但主对比仅使用固定 IST。
- 训练内存:可训练参数少不代表训练内存节省,峰值内存仍由冻结骨干的激活值主导,与 LoRA 相当。
- 查询范围:所有结果使用最小类名查询,未测试结合描述性指令的变体。
关联工作
- LoRA (Hu et al., 2021) 是主要对比基线,权重空间适配方法,存在遗忘问题。
- DetPO (Gare et al., 2026) 是离散提示优化基线,SOFT2HARD 蒸馏后的性能与其持平。
- GEPA (Agrawal et al.) 是离散提示优化基线,性能低于 SOFTPROMPT 和 SOFT2HARD。
- Prompt Tuning (Lester et al., 2021) 是软提示方法的起源,本文改进其位置和初始化策略。
- Grounding DINO (Liu et al., 2024) 是专业检测器参考基线,在原始 mAP 上远高于通用 VLM 适配方法。
- π0.5 (Physical Intelligence et al., 2025) 是用于机器人操作实验的 VLA 策略骨干。