快速导读:本文提出大规模文档 VQA 答案溯源基准 DocAttriBench,并用掩码困惑度方法 MAPPET 自动把答案落到文本块、表格与图像等版面元素。
文档视觉问答长期按“答对没有”打分。模型可以写出 NTU 学生推荐率、蝴蝶拉丁名或布朗克斯区重新分区比例,却经常框不到页面上真正写着这些数字的信息图、图注或表格。University of Modena and Reggio Emilia 与 University of Pisa 的 DocAttriBench 把问题收成 Visual Answer Grounding:答案必须落到文本块、表格或图片等版面元素。项目页 https://aimagelab.github.io/DocAttriBench/。
规模来自自动标注而不是海量人工框。作者提出 MAPPET:用 Docling 切出版面元素,挡住每一块后看答案条件困惑度升了多少,升得最多的那块就是证据;再用置信度阈值和第一、第二名分差丢掉含糊样本。由此把八个公开文档理解集合收成 237,418 张图、295,554 条接地问答。十六个可定位 MLLM 的零样本文本准确率可以很高,定位却普遍很差;在 DAB 上 LoRA 微调的 7B–8B 模型,grounding 超过更大的通用模型。
英文题目:DocAttriBench: Benchmarking Answer Grounding in Document Visual Question Answering
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-20574.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Visual Answer Grounding 要求模型同时给出自然语言答案和证据框。文本侧已有 ALCE、AGREE 等可验证引用,ContextCite 用上下文消融做归因。视觉侧 ChartCitor 针对图表、VISA 在文档截图上联合生成答案与框、CiteVQA 做长文档元素级引用。但文档 VQA 主流基准仍以答题为中心:DocVQA 完整标注几乎只在验证集且缺框;VisualMRC 依赖五百多名标注者,页面偏短;LongDocURL 只有约 2.3k 问答且框常错位;MMLongBench-Doc 专家题少、无空间接地;DUDE 只给抽取式答案框,验证集还被作者发现错框和错页;DoclingMatix 有百万级合成指令,却没有页级归因。
非文档域已经提示:MLLM 可以答对,却指不出依据。文档页版面更碎——同一事实可能出现在标题、段落、表和信息图里——没有元素级监督时,模型更容易生成看起来对、却无法核对的句子。人工标框贵,商业 API 自动标又贵又不开放,所以既缺评测尺,也缺可训练的接地监督。
已有带框资源质量参差。Wiki-VISA 把人工问答落到网页元素,Paper-VISA 与 FineWeb-VISA 用带框截图合成问答,但 Paper-VISA 会出现询问框本身的不自然问题,并有相当比例错接地。DAB 的策略不是再造一套题,而是把这些来源连同 DocVQA、VisualMRC、SlideVQA 等一起过同一套管线,只留下高置信、单区域、单页对齐的样本。
评测协议也必须同时看字和框。自由生成的长答案不能靠精确字符串匹配;框的格式又因模型而异。本文因此拆成三种任务:问+图同时出答案和框、给定参考答案再标框、以及只定位不答题,并用 Acc_txt、Box F1 与二者同时过 0.5 的 Overall Acc 报告。
核心创新
- 构建 DocAttriBench(DAB):237k 文档图、296k 元素级接地问答,覆盖论文、报告、幻灯等,版面类型含段落、表格、图片等。
- 提出 MAPPET:用掩码后困惑度增量给版面元素打归因分,并以置信度与分差过滤噪声、幻觉和多源歧义样本。
- 在十六个可定位 MLLM 上显示零样本 grounding 远弱于文本准确率;用 DAB 微调的 7B–8B 模型在定位上超过更大的通用模型。
方法概览
MAPPET 先用 Docling 抽出版面元素,再用 Qwen2.5-VL-7B 把抽取式答案改写成抽象句;对每个候选区域做遮挡,计算答案条件困惑度增量 ΔQ=log(ρIQ)−log(ρI),取最高分区域为证据。再用阈值 τ=0.1 与第一、第二名分差过滤低置信和多源歧义样本。由此把八个公开文档理解集合统一成 DocAttriBench:237,418 张文档图、295,554 条带元素级框的问答,训练/测试图像不重叠。评测覆盖 grounded 生成、事后归因与纯定位三种任务,指标为 Acc_txt、Box F1 与二者同时过 0.5 的 Overall Acc。
- MAPPET 的分数定义在第 6–7 页。图像条件下答案 token 的困惑度为 ρI=exp(−1/N ∑ log P(ti|Ti,I))。挡住区域 Q 得到 IQ 后,归因分 ΔQ=log(ρIQ)−log(ρI)。若 Q 对生成答案必要,挡住它会抬高困惑度,ΔQ 为正;无关区域接近零或为负。对 Docling 抽出的全部候选算一遍,取最高分者为证据。
- 数据来自八个公开基准:DoclingMatix、DocVQA、VisualMRC、VISA(含 Wiki/Paper/FineWeb)、SlideVQA、VisualWebBench、LongDocURL、MMLongBench-Doc。只保留文档向、问答式、且单页或已有页-答案对齐的样本。DoclingMatix 与 FineWeb-VISA 无官方测试集,只进训练集;LongDocURL、MMLongBench-Doc、VisualWebBench 只进测试集;其余跟原划分。训练与测试图像不重叠。
- 管线如图 3:过滤掉多证据框和多页未对齐样本;Docling 预测段落、标题、题注、表格、picture/image、列表等类别,VisualMRC 上只保留最外层框以避免嵌套表单元格重叠;用 Qwen2.5-VL-7B 把抽取式答案改写成保留语义的抽象句,以贴近生成式 MLLM 的话语;再对抽象答案的每个句子跑 MAPPET。
- 过滤是两级:最高分低于 τ=0.1 的丢掉;第一名与第二名分差不够的也丢掉,以排除同一事实写在多处、证据分散、或页内根本不可答的情况。源数据已有证据时,只保留归因分过阈值的例子。作者用同一阈值处理上述情形。
- 评测三种提示:grounded 生成、事后归因、纯定位。Acc_txt 先把生成答案拆成信息单元,文本用 ANLS(τ=0.5)、数字要精确匹配;Box F1 按 IoU 降序匹配,IoU>0.5 算对。Overall Acc 要求这两个量都超过 0.5。零样本覆盖 Qwen2.5-VL、Qwen3-VL 与 InternVL2.5/3/3.5 共十六个可定位模型,外加 VISA-7B。
- 微调用 PEFT LoRA,打在注意力与 MLP 上,r=16、α=32、dropout 0.05。底座为 Qwen2.5-VL-7B、Qwen3-VL-8B、InternVL3.5-8B,分别命名 MAPPET-7B、MAPPET-8B、MAPPET-I-8B。训练时随机抽三种任务模板并随机图像尺寸;Qwen2.5 用绝对坐标,Qwen3 与 InternVL 用 [0,1000] 相对坐标。两张 A100、24 小时、学习率 1e-4、batch 32。另训 InternVL 是为了减轻“标注器恰好是 Qwen”的家族偏差。
逐图理解论文
失败直觉
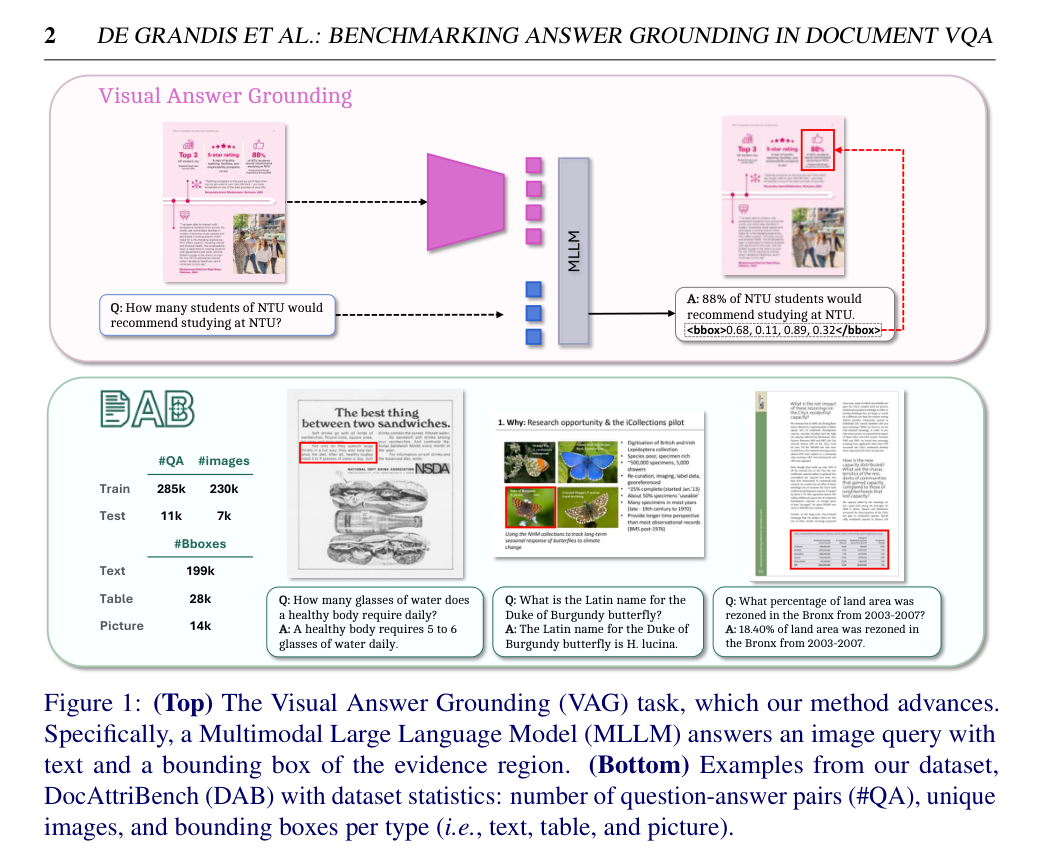
上半张是 VAG 任务示意:NTU 信息图进 MLLM,输出“88% of NTU students would recommend studying at NTU”和归一化框 0.68,0.11,0.89,0.32,红框落在推荐率卡片上。下半是 DAB 统计与三例:Train 285k QA / 230k 图,Test 11k / 7k;框类型 Text 199k、Table 28k、Picture 14k。三例分别把饮水量落到正文、把 H. lucina 落到蝴蝶图、把 18.40% 落到表格。先读任务定义,再对三类证据。
研究缺口
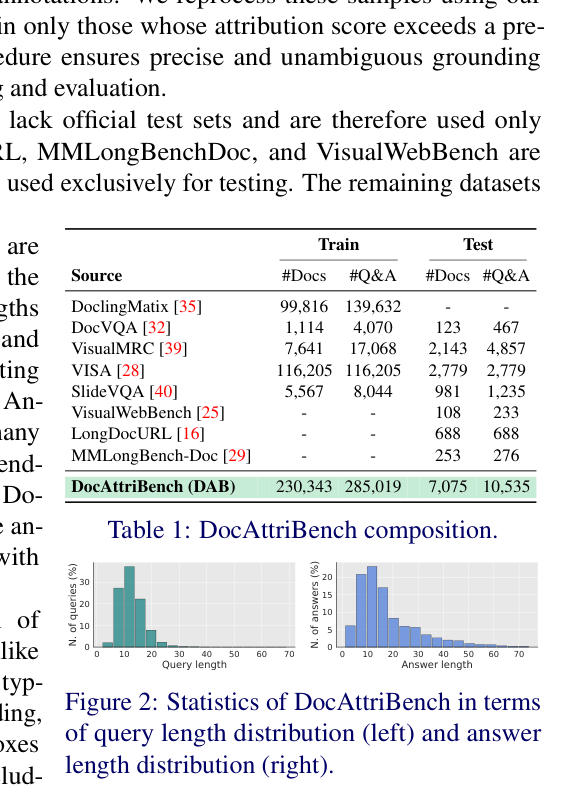
同一裁切里先是表 1 构成,后是图 2 长度直方图。表 1 绿行 DAB 训练 230,343 图 / 285,019 QA,测试 7,075 / 10,535;VISA 与 DoclingMatix 贡献最大训练量,LongDocURL、MMLongBench-Doc、VisualWebBench 只出现在测试列。左直方图问题长度峰值约 10 token、最高约 30%;右图答案峰值约 10–15 token、最高约 22%,并有超过 50 token 的长尾。上沿有正文残片,不要当表内容。
方法贡献
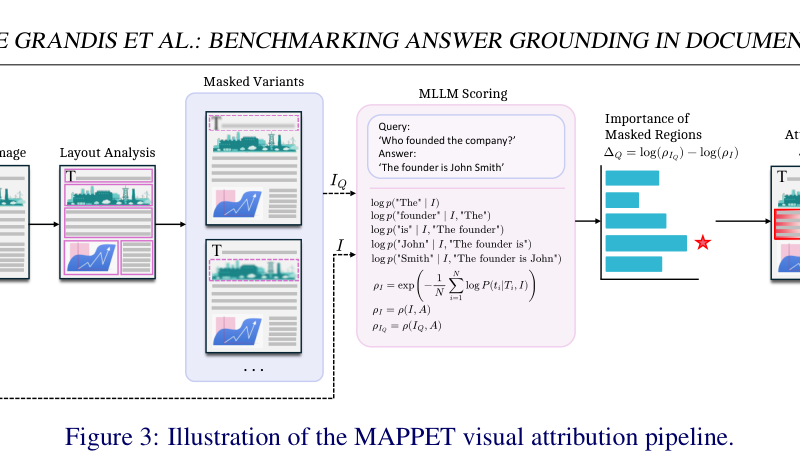
MAPPET 流程图。左侧版面分析把页切成带 T 标记的块;中间 Masked Variants 对块做遮挡,得到 IQ 与未遮挡 I;粉色 MLLM Scoring 对 Query/Answer 逐步算 token 对数概率并写出 ρI 与 ΔQ=log(ρIQ)−log(ρI);右侧条形图给各块打分,红星标最高分,再映回页上的红色证据区。裁切切掉了最左“Original Image”和最右 Attribution 的一部分,按从左到右补全。
实验如何设计?
- 表 1:DAB 训练 230,343 图 / 285,019 问答,测试 7,075 图 / 10,535 问答。VISA 训练贡献 116,205 条,DoclingMatix 139,632 条只用于训练。图 2 显示问题长度集中在约 5–20 token,答案有更长的尾部,覆盖抽取式短答和描述性长答。表 2 给出元素类型:训练集约 148k 段落、27k 表、11.5k picture。
- 标注质量:每个源随机 100 例(Paper-VISA 与 Wiki-VISA 各 100),三名标注者标出所有合理证据框并标记原答案幻觉。比较原始 Acc、过滤后 AccF,以及把幻觉一律判错的 %Filt。打分模型包括 DeepSeek-VL-7B、Qwen3-VL-8B、Qwen2.5-VL-7B(抽取 vs 抽象)和 Qwen2.5-VL-32B。
- 充分性与必要性:每测试集 200 例、VISA 400 例共 1,600 例。用管线内的 Qwen2.5-VL-7B 和独立的 InternVL2.5-8B,比较全页、仅保留证据、只掩证据、以及同尺寸随机掩的答案 token 对数似然差。
- 主结果在七个测试源上报告 grounded 生成(表 5)以及定位 / 事后归因(表 6)。对照含零样本各规模模型、VISA-7B 与三个 DAB 微调模型。
关键结果与论文证据
- 表 3(第 11 页):过滤后 AccF 相对原始 Acc 稳定上升,若干格超过 95%,说明阈值能丢掉噪声标注。Qwen2.5-VL-7B 抽象答案在 DocVQA 上 Acc 93.0、AccF 98.9、%Filt 88.0;32B 并未一致优于 7B,作者因此没有再上更大标注模型。抽取式答案原始 Acc 略高,但过滤后抽象答案的归因准确率更好。
- 表 4(第 12–13 页):Qwen2.5-VL-7B 仅证据总体 Δ=+0.061,掩证据 Δ=−0.914,且 98.8% 的例子似然下降;InternVL2.5-8B 为 +0.107、−0.714、88.9%。同尺寸随机掩只有 −0.232 / −0.178。选中区域对答案既充分又必要,且不是任意一块同等面积。
- 表 5(第 12 页,本条目 table-04 裁切实为该表):零样本 Acc_txt 可到 60–70,F1box 却普遍很低。作者概括:>30B 的 F1box 平均低于 40%,7–8B 低于 20%,2–3B 低于 10%。最强零样本 Qwen3-VL-32B 平均 Overall Acc 25.4,DocVQA 上 Acc_txt 72.9、F1box 41.8、Acc 29.3。许多 InternVL 变体答题不差,框 F1 接近 0。
- 同一张表的微调行:MAPPET-8B 平均 Acc 37.0,MAPPET-7B 33.8,MAPPET-I-8B 33.4,都高于 VISA-7B 的 24.3。MAPPET-8B 在 DocVQA 上 F1box 75.3、Acc 44.1,VisualMRC 上 F1box 76.7、Acc 54.5。7B–8B 微调模型的 grounding 超过 32B/38B 通用模型,作者据此认为接地监督比单纯放大更关键。平均 Overall Acc 超过 30%,比无接地监督的最强对照高 5 分以上。
- 表 6(第 13 页):只出框时定位往往好于“同时答题+出框”。Qwen3-VL-32B 事后平均 F1QAbox 46.8,比其 grounded 生成 F1box 高约 7 点。微调增益很大:Qwen2.5 两任务均约 +31;Qwen3 定位 +32、事后 +23;InternVL 定位 +46、事后 +49。MAPPET-I-8B 在定位/事后上平均 61.7 / 68.1,是该表最强。
- 图 1 的三条 DAB 例子分别把饮水杯数落到正文、把 H. lucina 落到蝴蝶图版、把 18.40% 落到表格,对应 Text / Picture / Table 三类框。图 2 与表 1 说明训练规模由 DoclingMatix 与 VISA 撑起,而测试覆盖七个异构源。
阅读时需要注意
- 附录 F:实验主要是单句答案、单页文档;MAPPET 虽可扩到多句,但不是主结果设定。
- 每个答案被假设对应单一区域。证据分散在多块、或必须跨页拼凑的问题在过滤阶段被丢掉,数据集对这类推理不具代表性。
- 构建时丢弃多证据框、多页未对齐样本,因此不能用 DAB 分数直接比较需要多框或多页的方法。
- 困惑度打分与答案抽象都用了 Qwen2.5-VL-7B,该模型又是 MAPPET-7B 的底座。作者用 InternVL3.5 微调来交叉验证,仍不能完全排除标注器自偏好。
- 人工核验按源只抽 100 例;附录还指出源数据本身含幻觉与错框。本文为 2026-09-17 预印本,尚未同行评审。
关联工作
- VISA 是最直接的文档 VAG 对照:联合生成答案与框,并贡献了 DAB 中最大的已有接地子集。DAB 重打分、过滤后再评,微调模型在 VISA 测试子集上的框质量也超过原 VISA-7B。
- CiteVQA 做长文档元素级引用,题量约 1.9k,适合忠实度诊断,不足以支撑本文这种 7B–8B 全量微调。
- ContextCite 与 ALCE/AGREE 解决的是文本证据;MAPPET 把消融对象换成页面上的空间元素,才能接到 Document VQA。
- DocVQA、VisualMRC、LongDocURL、DUDE、SlideVQA、MMLongBench-Doc 提供了题和页,但不提供统一、经过滤的元素级框。DAB 把它们放进同一版面taxonomy(Docling)和同一过滤阈值。
- Qwen2.5-VL、Qwen3-VL、InternVL 代表当前可输出框的通用 MLLM。表 5 显示放大能抬高 Acc_txt,对 F1box 帮助有限,除非像 VISA 或 MAPPET 那样做接地监督。