快速导读:MintAct 在 2B/4B/8B 规模用同一套权重统一 UI grounding、手机/桌面/网页多步导航与视觉工具使用,并以多阶段监督加异步强化学习稳住跨域训练。
能直接对着屏幕干活的视觉语言模型,被看成通用数字助手的一条路:既要把指令点到正确控件,又要在手机、电脑和网页上走完多步任务,还要在界面点不到时调用外部工具。现有工作却把 UI grounding、移动导航、桌面控制、网页浏览和视觉工具使用拆成各自的专家模型,服务成本高,也不适合可上设备的紧凑规模。Apple 的 MintAct 用同一套权重在 2B、4B、8B 三个尺度上同时覆盖这三项能力。
方法侧并不硬把各域动作表拼成一张大表,而是共享原始截图与归一化像素坐标,用域系统提示条件化动作集,并在监督与强化学习阶段都显式均衡跨域数据。训练分成高分辨率单步 SFT、低分辨率多步 SFT、分域 RL 专家经拒绝采样蒸馏的 RFT,以及联合异步 agentic RL。环境包括 AndroidWorld、OSWorld、Weblica、MM-ToolSandBox 和可高吞吐的合成环境。作者报告 MintAct-8B 在 OSWorld-Verified 上达到 48.9。摘要与 arXiv abs 页未见公开代码。
英文题目:MintAct: A Unified Visual Agent for Digital Environments
论文出处:arXiv 每日论文精选 · arXiv:2609.22083
原始论文:PDF / 论文页面
这篇论文解决什么问题?
对真实设备有用的 Agent 必须同时完成三件事:把自然语言落到屏幕目标、跨移动/桌面/网页完成多步导航,以及在低层 UI 动作够不到时发出结构化工具调用(第1页)。
这些能力长期分开训练评测:grounding、手机导航、桌面控制、网页导航和 visual tool use 各有模型与基准。分专家既贵又难扩展,在适合端侧的小规模上尤其不现实(第1页)。
统一的障碍超出建模。各域观察、动作、数据源和可执行后端不同;硬合并动作或乱混合数据会让域互相侵蚀。在线强化学习还要面对慢、不稳、轨迹很长的异构环境;异步执行时训练分布会滑向当时最快的域(第1页)。
核心创新
- 在 2B/4B/8B 用单一模型同时覆盖 UI grounding、mobile/desktop/web 导航和 visual tool use。
- 共享像素观察、提示条件化动作集与显式均衡混合,使联合训练不牺牲分域质量。
- 为异构环境搭建异步 RL 基础设施,用配额、反压与过期控制稳住跨域分布。
方法概览
共享原始截图与归一化像素坐标;用域系统提示条件化动作集而不是硬合并;监督与强化学习阶段都显式均衡跨域数据。训练四段:高分辨率单步 SFT 打 grounding,低分辨率多步 SFT 学导航与工具,分域 RL 专家经拒绝采样 RFT 蒸馏,最后联合异步 agentic RL。环境覆盖 AndroidWorld、OSWorld、Weblica、MM-ToolSandBox 与合成环境。
- 问题写成策略 πθ(at|s):给定系统提示、指令、历史截图与先前推理动作,先写中间推理再输出动作;动作解析为界面操作或外部工具调用。Grounding 是单步坐标预测,导航与 visual tool use 是多步(第4页)。
- 统一设计三点:所有 UI 域只看原始截图,坐标归一化到 999×999,不用 DOM、无障碍树或平台 API;各域动作集通过系统提示暴露,而不是合成一张总表;监督与强化学习全程显式均衡跨域混合(第4页,Table 1)。
- 训练四段见图2:高分辨率单步 SFT 打 grounding;低分辨率多步 SFT 用各域轨迹学导航和工具;为 Desktop/Mobile/Web/VTU 各训 RL 专家,经拒绝采样 RFT 蒸馏回一个模型;最后联合异步 RL(第5页)。
- 桌面基于 OSWorld 的 Docker 虚拟机,经 HTTP 中间件与 GPU 训练解耦,在线 rollout 可并发超过 200 个实例,约 3k 任务用于 RL;移动基于 AndroidWorld,并发超过 100,同样约 3k 任务(第6页)。
- 网页用 Weblica-Cache 离线回放与 Weblica-Synth 合成站点;SFT 保留约 5.17 万成功轨迹,RL 约 1 万任务。VTU 基于 MM-ToolSandBox,十六个应用域、五百多种工具,用 search_tool 动态检索,避免把全部工具塞进提示(第6–7页)。
- 异步 RL 基建见图3:Env Manager、SGLang Rollouter 与 Megatron Trainer 通过消息队列解耦,参数同步器回写权重。轨迹组按域整数配额入队,配额归一化反压让快域等待慢域;全零优势时有超时回退以免训练卡死(第11、13–14页)。
逐图理解论文
失败直觉
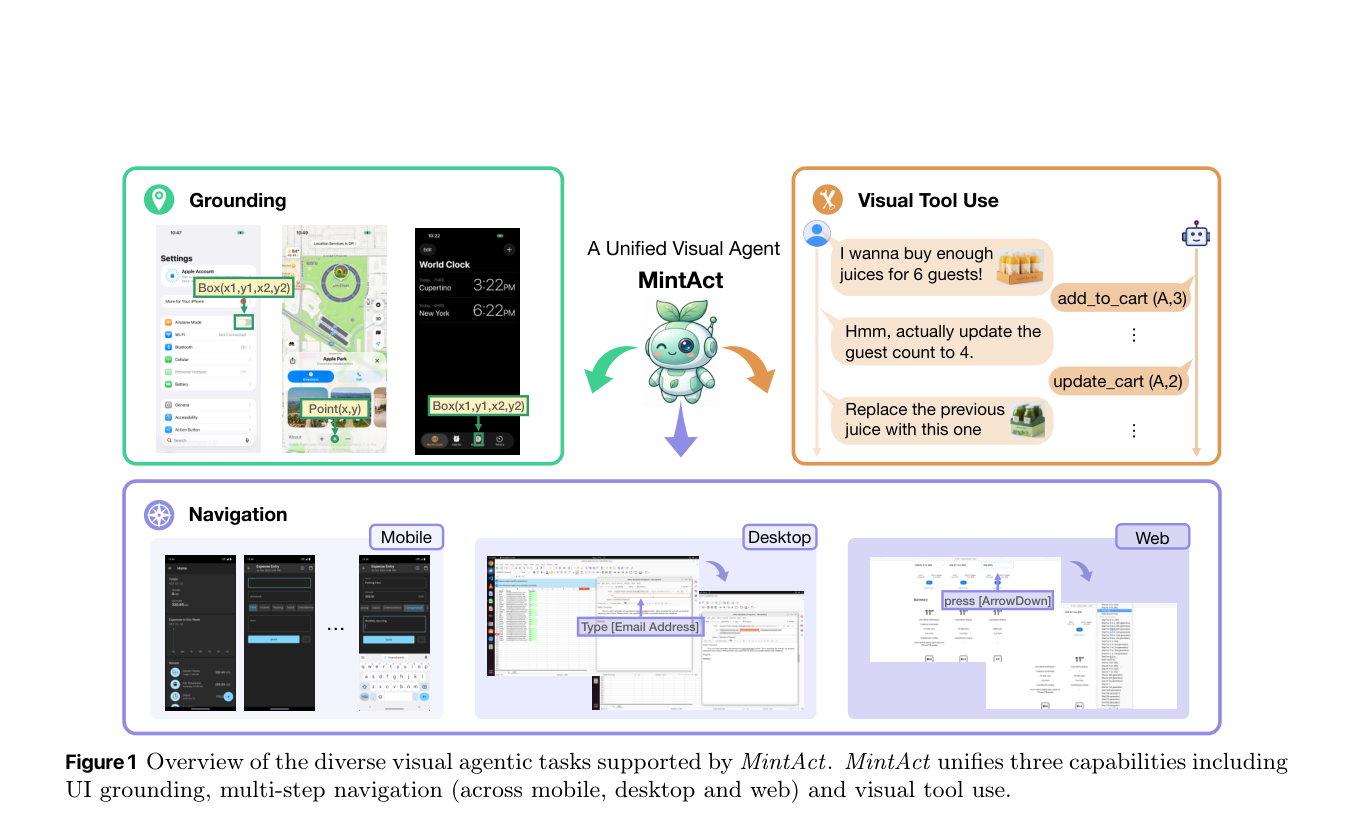
先看中央浅绿机器人与三色箭头,确认一篇模型要同时做三件事。左上绿框里设置、地图、时钟上的 Box 与 Point 说明 grounding 直接标在截图像素上。右上橙框是改购物车人数的多轮对话,回复是 add_to_cart、update_cart 这类函数而不是点击。底部紫栏从手机滑到桌面打字再到网页按方向键,对应跨端多步导航。不要把对话里的 6 和 4 当成评测分数。
方法贡献
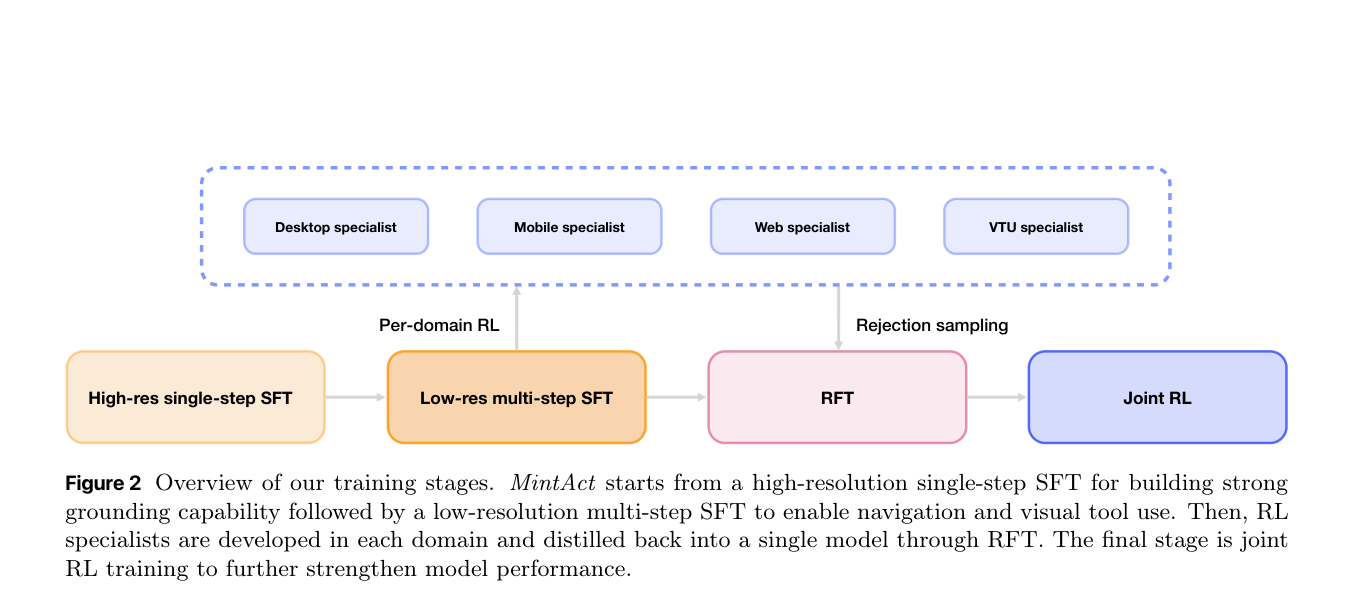
从左到右读四个色块:高分辨率单步 SFT、低分辨率多步 SFT、粉色 RFT、蓝色 Joint RL。上方虚线框四个 specialist 由第二段向上的 Per-domain RL 训出,再经 Rejection sampling 蒸馏进 RFT。这张图适合当训练食谱/方案特色图,它画的是阶段而不是网络层。四个专家最终要回到一套权重,不要理解成部署时仍要四套模型。
关键机制
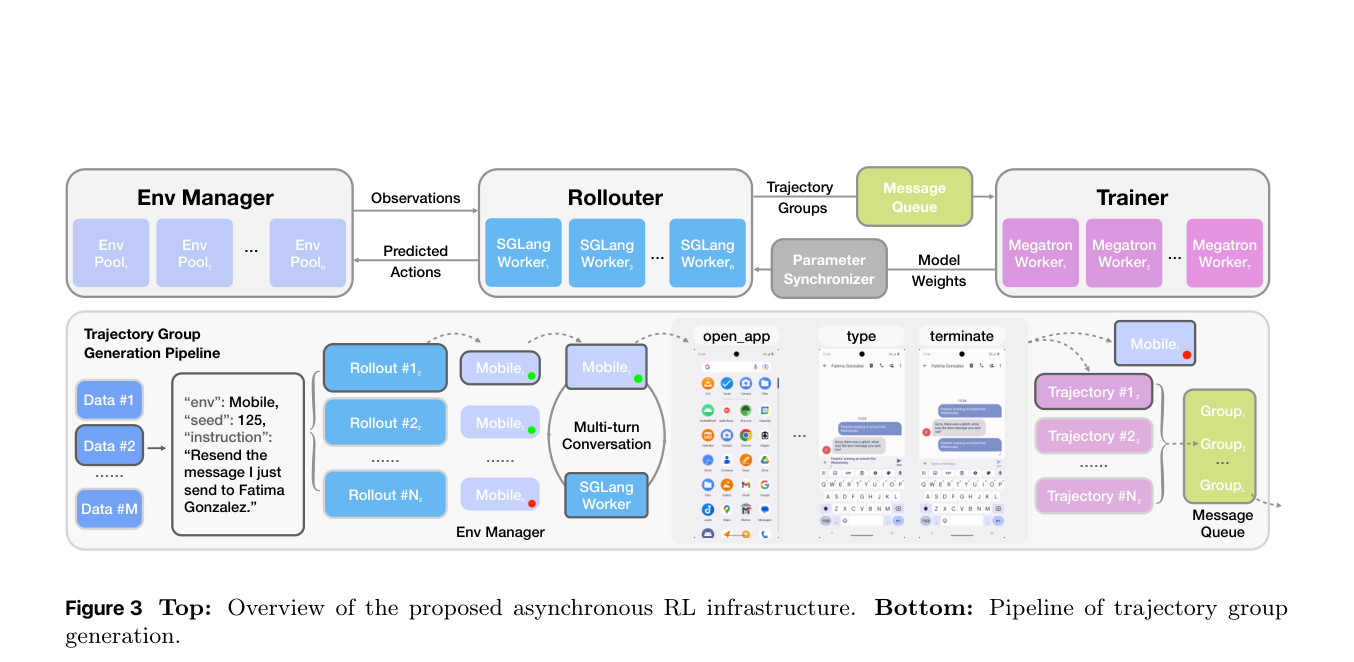
上层从 Env Manager 的环境池出发,和 SGLang Rollouter 交换观察与动作,轨迹组进绿色消息队列,右侧 Megatron Trainer 更新,中间 Parameter Synchronizer 回传权重。下层用一条 Mobile 任务(seed 125,重发消息)采多条 rollout,截图序列标了 open_app、type、terminate,再打包成 trajectory group。用它理解异步 RL 如何一边 rollout 一边训练,并按组混合不同环境。
实验如何设计?
- Grounding 报 MMBench-GUI、ScreenSpot-v2、UI-Vision、OSWorld-G;移动报 AndroidControl 与 AndroidWorld;桌面报 OSWorld-Verified;网页报 Weblica 与 Online-Mind2Web;工具报 MM-ToolSandBox。在线导航最大步数 30,工具任务 100(第14页)。
- 主表按 2B/4B/8B 对照同规模 Qwen3-VL-Instruct,以及 Jedi、ScaleCUA、Ferret-UI Lite、MAI-UI、OpenCUA、UI-TARS-1.5、EvoCUA、WEBLICA、Qwen3.5 等公开模型(第14页,Table 3)。
- 消融包括:分域 SFT 专家 vs 联合 MintAct-SFT-8B(Table 4);两段 SFT 的贡献(Table 5);RFT 蒸馏 vs 分域 RL 专家与最终联合 RL(Table 6–7);从 Qwen3-VL-8B 或 MintAct-SFT 出发的合成环境 RL(Table 8)(第15–17页)。
关键结果与论文证据
- 作者报告 MintAct-8B-Final 在 OSWorld-Verified 上为 48.9,相对初始化 Qwen3-VL-8B 的 33.9;同表还有 AndroidWorld 67.0、Weblica 74.7、Online-Mind2Web 39.1、MM-ToolSandBox 24.5、UI-Vision 56.6、OSWorld-G 64.5(第14页,Table 3)。该 48.9 应按作者自报引用。
- 2B 与 4B 同样全面高于各自的 Qwen3-VL 初始化:MintAct-2B 的 OSWorld-Verified 为 36.1,MintAct-4B 为 44.8(第14页)。
- 联合 SFT 模型在移动、桌面和工具上匹配或超过分域 SFT 专家,grounding 与 web 也在相近区间,说明一台模型覆盖多域不一定掉分(第15页,Table 4)。
- 只做高分辨率单步 SFT 时导航很弱,例如 OSWorld-Verified 9.4、Weblica 15.6;加上低分辨率多步 SFT 后分别回到 41.5 与 59.1,但单独第二段会伤 grounding,所以两段都需要(第15页,Table 5)。
- RFT 把分域 RL 专家蒸馏回单一模型后,再联合 RL:8B 的 OSWorld-Verified 从 43.1 升到 48.9,并迁移到未一起做联合 RL 的网页与工具设定(第16页)。
- 仅在合成环境上 RL、完全不用真实 AndroidWorld/OSWorld 交互,也能把 AndroidWorld 从 47.6 提到 60.3、OSWorld-Verified 从 33.9 提到 38.6;再与真实环境联合 RL 会继续改写各域分数(第17页,Table 8)。
阅读时需要注意
- 联合强化学习实验主要在 mobile 与 desktop 上证明有益,把 web 与 visual tool use 同时纳入联合 RL 仍受异构环境并发成本限制,作者留作后续(第17页)。
- 训练时每张新截图都追加进上下文,长轨迹会迅速抬高显存;更精细的摘要或剪枝尚未做(第17页)。
- visual tool use 目前大体当作独立能力,尚未在同一策略里按需在像素导航与动态调工具之间切换(第18页)。
- arXiv abs 页未见公开代码或训练基础设施,读者无法从论文页面直接复现异步 RL 集群。
关联工作
- Qwen3-VL-Instruct 是各尺度初始化;主结果应对照同规模公开模型,而不是跨尺度混比(第14页)。
- UI-TARS、OpenCUA、EvoCUA 代表桌面计算机使用;Ferret-UI Lite 与 MAI-UI 代表移动端;ScaleCUA 与 Weblica 代表网页。MintAct 的论点是一台模型同时覆盖这些设定(第3页)。
- AReaL、Magistral、AsyncFlow、AsyncWebRL 把异步 RL 用于长响应或单域网页;MintAct 把它扩到多域视觉 Agent,并显式控制跨域配额(第3–4、13页)。
- MM-ToolSandBox、OSWorld-MCP、MobileWorld 等基准推动 GUI 与工具混合;MintAct 用结构化函数调用与 search_tool 来消化超过五百个工具(第3、7页)。