快速导读:VGGT-CAD 把预训练 VGGT 几何先验与相机条件编码迁到参数化 CAD 序列预测,用可变视角聚合和非自回归解码,并发布 VideoCAD 基准。
工业上真正能进 CAD 软件的模型,不是看起来像的三角网格,而是带草图与拉伸参数、可被内核执行的命令序列。从一张图或一段随手拍的环绕视频还原这种表示很难:遮挡会丢掉拓扑,而命令里一个坐标或一次删除就能让几何面目全非。IEEE TII 投稿 VGGT-CAD 把预训练 VGGT 的跨视图几何先验迁到参数化 CAD 重建,让同一套前馈框架同时服务单图与多视角输入。
相机内外参被编成条件 token,与图像 token 一起进入几何多视角编码器;可变视角聚合模块把数量不定的视图收成全局表示,非自回归解码器并行预测命令类型与量化参数。推理阶段用训练免费的几何感知选帧,在覆盖、图像可靠性与冗余之间做子集优化。作者基于 ABC-mono 渲染 VideoCAD,每模型三十六视图并记录相机,实验表明几何先验与相机条件能同时提高命令准确率和形状保真。
英文题目:VGGT-CAD: Reconstructing Parametric CAD 3D Model with Geometric Grounding
论文出处:arXiv 每日论文精选 · arXiv:2609.21225
原始论文:PDF / 论文页面
这篇论文解决什么问题?
参数化 CAD 以草图、拉伸等结构化操作定义实体,具有无限分辨率、精确约束和下游工艺兼容性;网格、点云或神经场通常不可直接编辑(第1页)。
从视觉观察自动恢复 CAD,要求的不只是像,而是正确的操作顺序、拓扑和参数。图2用改 CIRCLE 参数或删除中心圆柱说明程序对几何极度敏感(第2页)。
Img2CAD、GenCAD、CADCrafter 等主要从单图外观隐式猜三维,遮挡时结构约束不足。多视角本可提供几何,但需要相机条件、可变视图聚合和选帧,否则冗余或劣质帧会干扰序列预测(第2页)。
核心创新
- 把预训练三维视觉先验通过相机条件编码迁到参数化 CAD 序列。
- 可变视角跨视图聚合,适应单图到多视图。
- 训练免费的几何感知选帧,在覆盖、可靠性与冗余间做子集优化。
- 构建 VideoCAD 多视角视频基准。
方法概览
几何感知确定性选帧;相机内外参编成条件 token,与图像 token 在 VGGT 风格多视角编码器中交互;可变视角跨视图聚合得到全局 z;非自回归 Transformer 并行预测命令类型与 256 级量化参数;辅助相机解码提供位姿重建监督。训练随机采 2–8 帧,推理可选确定性子集。
- 输入是目标物体的单目视频,训练时从三十六帧中随机抽 N∈[2,8] 张,并给定对应内外参。输出长度 Nc 的命令序列,每步含离散类型 tj 与十六维参数向量,未用槽填 -1,连续量归一化到 [-1,1]^3 后量化为二百五十六档(第3–4页,Table I)。
- 推理可选几何感知确定性选帧,按覆盖、可靠性与冗余挑互补视图;训练期随机采样以模拟随意视频(第4页)。
- 相机条件编码器把每位姿变成空间 token,与图像 patch 一起进入 VGGT 风格的 Frame Attention 与 Global Attention,同时建模视图内与跨视图关系(第4页,Figure 3)。
- 可变视角跨视图聚合把不定数量的视图与相机 token 收成固定维全局 z,避免视图数变化时无法解码(第4页)。
- 辅助相机解码器从相机特征重建位姿,用 Lcam 提供显式几何监督。序列解码器非自回归地在预定义位置并行预测 SOL/Line/Arc/Circle/Extrude/EOS 等,再交 CAD 核生成实体(第4页)。
- 视觉骨干用 LoRA(秩三十二)适配预训练权重;四卡 A800、Adam、批大小四、输入 512×512(第8页)。
逐图理解论文
失败直觉
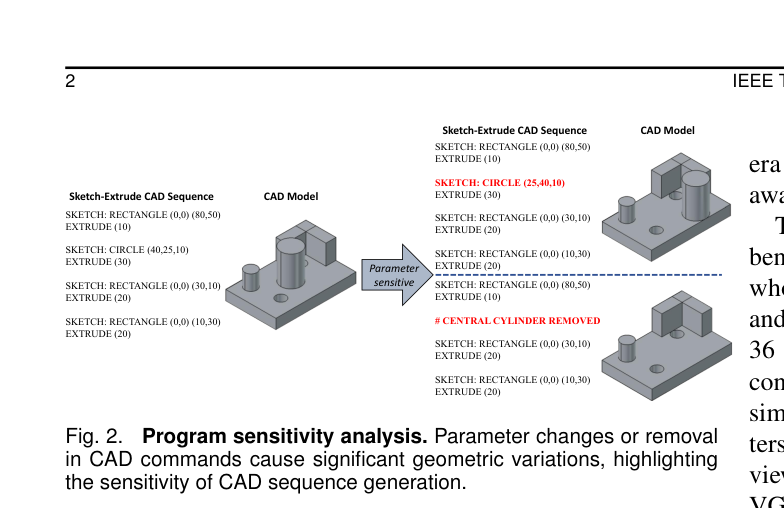
左列命令做出带中心圆柱的底板。中间 Parameter sensitive 箭头指向两种破坏:把 CIRCLE 改成 (25,40,10) 后圆柱挪位;删除该命令后圆柱消失。用它理解为什么 CAD 重建对参数和拓扑如此苛刻。右缘有正文裁切,不要把残字读进图。
研究缺口
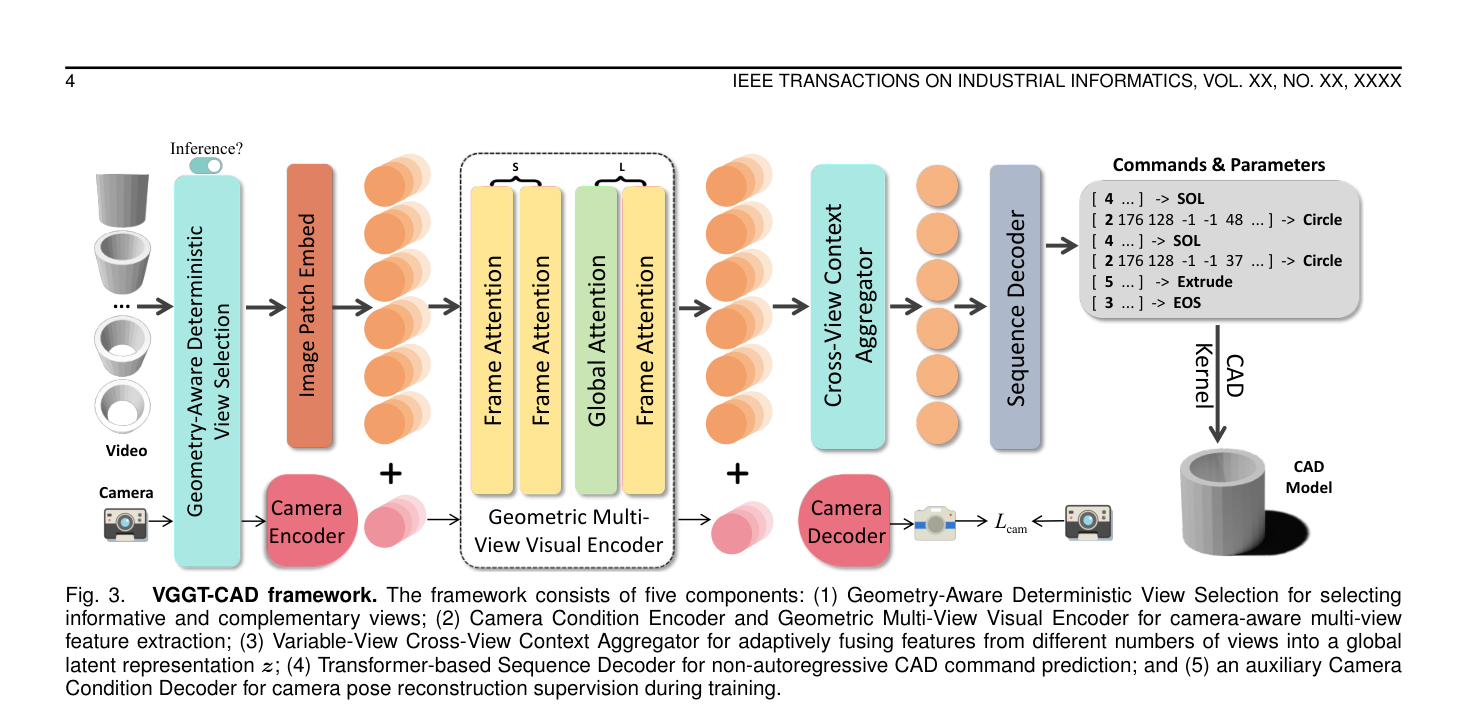
从左输入经几何感知选帧,图像 token 与相机 token 进入 Frame/Global Attention,再经跨视图聚合与序列解码得到 SOL/Circle/Extrude/EOS,最后 CAD Kernel 出实体。下方 Lcam 是训练期相机重建。这张图适合当架构特色图。Inference? 开关提示选帧主要用于推理。
关键机制
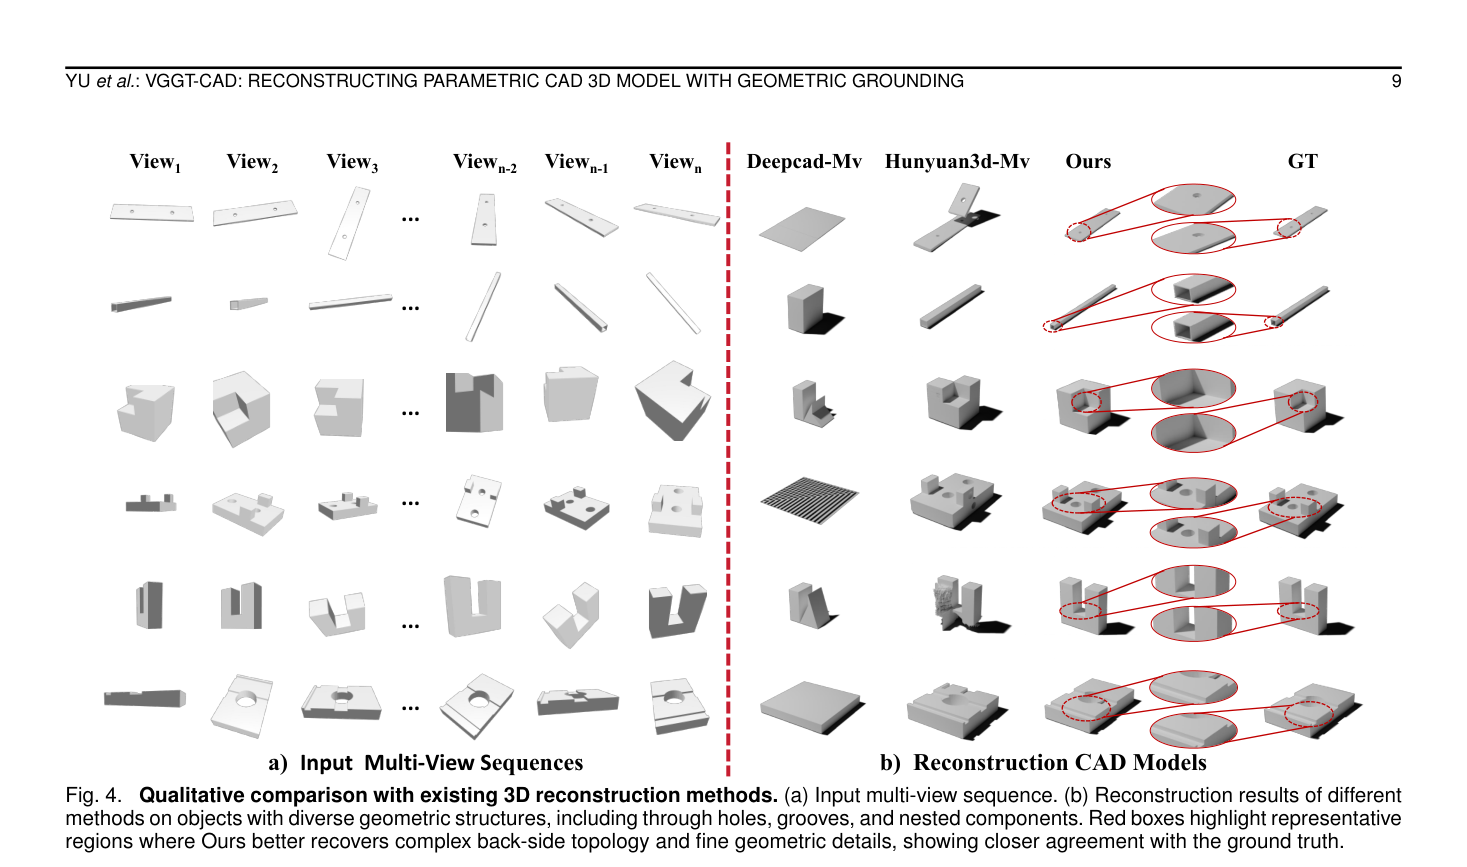
左栏六行多视角输入,右栏 Deepcad-Mv、Hunyuan3d-Mv、Ours、GT。对比基线缺孔、错误拉伸或糊成实心块,再看 Ours 与 GT 红圈中的通孔、背面槽和嵌套缺口。红圈是作者强调区域,不是误差热图。
实验如何设计?
- VideoCAD 基于 ABC-mono 的 208,853 个唯一 CAD 模型,按原 90%/5%/5% 划分,每模型三十六视图,共 7,518,708 帧,并记录相机与命令(第8页)。
- 因为缺少现成的多视角到 CAD 框架,作者把 DeepCAD 与 Hunyuan3D 的编码器换成同一几何多视角骨干,得到单图 DeepCAD*、Hunyuan3d* 与多视角 DeepCAD-Mv、Hunyuan3d-Mv;另用 TripoSR、One-2-3-45 作为仅比 Chamfer 的网格基线(第8页)。
- 序列指标为 ACCcmd 与 ACCparam(参数容差 η=3),几何指标为两千点 Chamfer 与无法编译成 B-Rep 的 Invalid Rate(第8页,Table II)。
- 消融覆盖相机输入/输出与 GAD 选帧(Table IV)、聚合器对 mean pooling(第10页)、测试时视角数一至八(Figure 6),以及选帧目标权重(第11页)。
关键结果与论文证据
- 多视角完整模型 ACCcmd 0.8213、ACCparam 0.7104、Mean CD 0.0670、IR 0.3020,优于 DeepCAD-Mv 的 0.7509 / 0.6352 / 0.2123 / 0.3826;单图 Ours* 的 Mean CD 0.1482 也低于 DeepCAD* 的 0.3513 和 Hunyuan3d* 的 0.4157(第8页,Table II)。
- 定性上 Deepcad-Mv 与 Hunyuan3d-Mv 常把通孔填实、丢掉背面槽或嵌套缺口,Ours 与 GT 在红圈细节上更一致(第9页,Figure 4)。
- 加入相机输入降低 Mean CD,再加相机输出与 GAD 选帧继续把 ACCcmd 提到 0.8213(第10页,Table IV)。
- 用跨视图聚合替换 mean pooling 后,ACCcmd 从 0.7626 到 0.8213,Mean CD 从 0.1699 到 0.0670(第10页)。
- 视角从一增到八时 ACCcmd 从 0.7854 升到 0.8213,六到八视图后增益变平(第10页,Figure 6)。
- 注意力可视化给正视带孔视图很高归一化权重,给侧视薄边接近零,重建仍保住孔槽(第10页,Figure 5)。
阅读时需要注意
- 细管结构和全封闭空腔的内部几何很难从外观推断,作者列为后续(第11页)。
- 连续参数量化为二百五十六档,过细尺寸会受离散化限制(第4页)。
- 多视角对照是改装 DeepCAD/Hunyuan3D,不是原论文设定;网格方法不能报命令准确率(第8页)。
- VideoCAD 由已有 CAD 语料重渲染,相机与外观比真实车间视频更干净,迁移到手机随手拍仍待验证。
关联工作
- VGGT 证明 Transformer 能建模跨视图几何;VGGT-CAD 把它当作可迁移先验,而不是从零学多视角(第2页)。
- DeepCAD 把生成写成命令自编码,SkexGen、HNC-CAD 做无条件或层次序列,但不做实例级视觉反求(第3页)。
- Img2CAD、GenCAD、CADCrafter 降低了对三维扫描的依赖,但主要靠二维外观;本文强调相机条件与可变视图聚合(第3页)。
- NeRF、3DGS、LRM、InstantMesh 可出网格或辐射场,缺少工业所需的参数可编辑性(第3页)。