快速导读:GIST 与华盛顿大学塔科马分校用公开实现把视觉 MOT 拆成检测和关联,在受控对照里检验“检测质量主导跟踪”这一长期直觉,并给出相机运动补偿矩阵的写法。
视觉多目标跟踪要回答的不是“这一帧里有没有人”,而是“下一帧的这个框还是不是同一个人”。检测给出位置和特征,关联把它们连成轨迹。Linh Van Ma、Juhua Hu、Wei Cheng、Unse Fatima 与 Moongu Jeon 的这篇实证认为,现有综述把这条流水线讲成了分类法,却没有在公开实现上把两个模块的贡献拆开。论文是 arXiv:2609.22291,选稿记录写明评论行标注已被 Artificial Intelligence Review 接收。
作者的核心判断来自受控实验:检测质量主导跟踪表现,换检测器的收益通常大于细化关联;现代检测器配上专用重识别模型,优于把检测和嵌入绑在一起训练;基于 Transformer 的端到端方法对检测质量波动更稳,但计算代价明显更高。代码与实验设置放在 https://github.com/linh-gist/VisualMOT 。正文里的 TBD 一律指 tracking-by-detection,也就是先检测再关联,不是待填写的占位符。
英文题目:Beyond the Survey: A Systematic Empirical Study of Detection and Association in Visual MOT
论文出处:arXiv 每日论文精选 · arXiv:2609.22291
原始论文:PDF / 论文页面
这篇论文解决什么问题?
一条典型流水线是:每一帧先定位目标,再把新检测连到已有轨迹上。定位可以是点、框或掩码,并带类别和置信度;关联则计算 IoU 或外观相似度,解一个分配问题,同时决定新生轨迹和失效轨迹。可选的插值和平滑只改善连续性。因为两步紧紧咬合,弱检测留下的误差很容易被误当成关联算法的失败。
文献里 TBD 与端到端常被写成两条路线。TBD 把检测和关联拆开,方便换检测器,也更省算力,所以仍然是主流。端到端把两边放进同一网络联合训练。作者强调,即使是 MOTR 这类不显式输出传统检测框的模型,高层面上仍是“先产生检测相关特征,再做时序对应”。DiffusionTrack 也被他们归入 TBD,因为它先产生检测相关特征,再用单独的关联网络建立对应。
Table 1 把既有综述分成三类局限:只做定性归纳或汇总别人论文里的数字;只研究关联、把检测器固定住;或者只覆盖检测、嵌入或遮挡中的一个组件。于是“检测质量主导跟踪、关联相对鲁棒”从未在匹配条件下被验证。这就是本文要补的缺口。
核心创新
- 用同一条检测—关联流水线覆盖 TBD 与端到端,把定性分类变成可替换组件的实证框架。
- 在公开实现上一次只改检测或只改关联,比较检测质量、重识别特征和关联策略的贡献。
- 给出不同目标状态表示下的相机运动补偿矩阵,用来减轻检测噪声和阈值敏感。
- 用合成杂波和统一外观特征,把关联对坏检测的补偿能力从检测器差异里剥出来。
方法概览
统一视图是:输入帧经过目标检测(框与外观/运动特征),再经数据关联得到轨迹。端到端网络把这一过程写成可训练模块:检测参数 θ_det 与关联参数 θ_assoc 输出预测轨迹,与真值做二分匹配,总损失为 λ1 L_det + λ2 L_assoc,梯度同时更新两边。轨迹初始化和删除多半仍是不可微启发式,文中从训练图里省略。实验每次只改一个因素:固定检测换跟踪器,或固定关联换检测器,并扫描置信度阈值。相机运动部分给出状态分量的补偿矩阵:位置走旋转缩放加平移,面积按行列式缩放,宽高按线性尺度缩放,长宽比在各向同性缩放下不变,速度跟随对应状态分量。
- Fig. 1 把输入帧、目标检测、数据关联和轨迹画成一条链。检测块用红色,关联块用蓝色,外围虚线表示二者可以包在同一个系统里。图注写明:这套结构传统上叫 tracking-by-detection,但近年的端到端方法也可以按这两个功能来读。
- Fig. 2 把端到端训练画完整。检测参数 θ_det 和关联参数 θ_assoc 产出预测轨迹 Ŷ,与真值轨迹 Y 做损失。总损失写成 λ1 L_det + λ2 L_assoc。反向传播同时把梯度送回两个参数,优化器更新后再进入下一轮。检测本身已被研究得很深,多数深度学习跟踪论文把精力放在关联,并让两个模块都能端到端训练。轨迹的生灭管理多是按轨迹年龄或置信度做的不可微规则,图中省略。
- Fig. 3 的分类法(本篇选定图未收入这张表格式图)把 2016 到 2025 的代表方法分成解析式关联、深度关联和端到端。解析式一支用手工运动和外观模型,分配多用匈牙利算法或最短路,包括 SORT、DeepSORT、ByteTrack、OCSORT、StrongSORT、HybridSORT、TrackTrack 等。深度关联一支如 SUSHI、LTTrack、LG-MOT,直接从数据学习对应,但数据和跨域泛化成本更高。端到端一支包括 MOTR、MeMOTR、MOTIP、CO-MOT、SambaMOTR,梯度可以穿过检测模块。
- 实验设计强调一次只动一个旋钮。固定检测、更换跟踪器,用来看关联;固定关联策略、更换检测器,用来看检测。置信度阈值和匹配阈值单独扫描,其余保持作者推荐默认值。这样得到的差异才能说成组件贡献,而不是“整篇论文换了一个更强的检测器”。
- 相机运动补偿被写成可复用的状态变换,而不是某一个跟踪器的私有技巧。Table 2 按状态分量给出规则:位置(中心或角点)用旋转缩放矩阵再加平移;面积按矩阵行列式缩放,宽高按线性尺度因子缩放,长宽比在各向同性缩放下不变;速度跟随它派生自的那个量。由此可以给不同状态向量拼出补偿矩阵,而不必只停留在文中两个例子。
- 重识别不是另起一套 CMC/mAP 协议。作者在跟踪框上直接看特征是否把不同身份分开,并用 SBS50(FastReID 的 Stronger Baseline ResNet 变体)作为更强的外观提取器,替换联合检测嵌入模型自带的特征,同时保持其余跟踪组件不变。
逐图理解论文
失败直觉
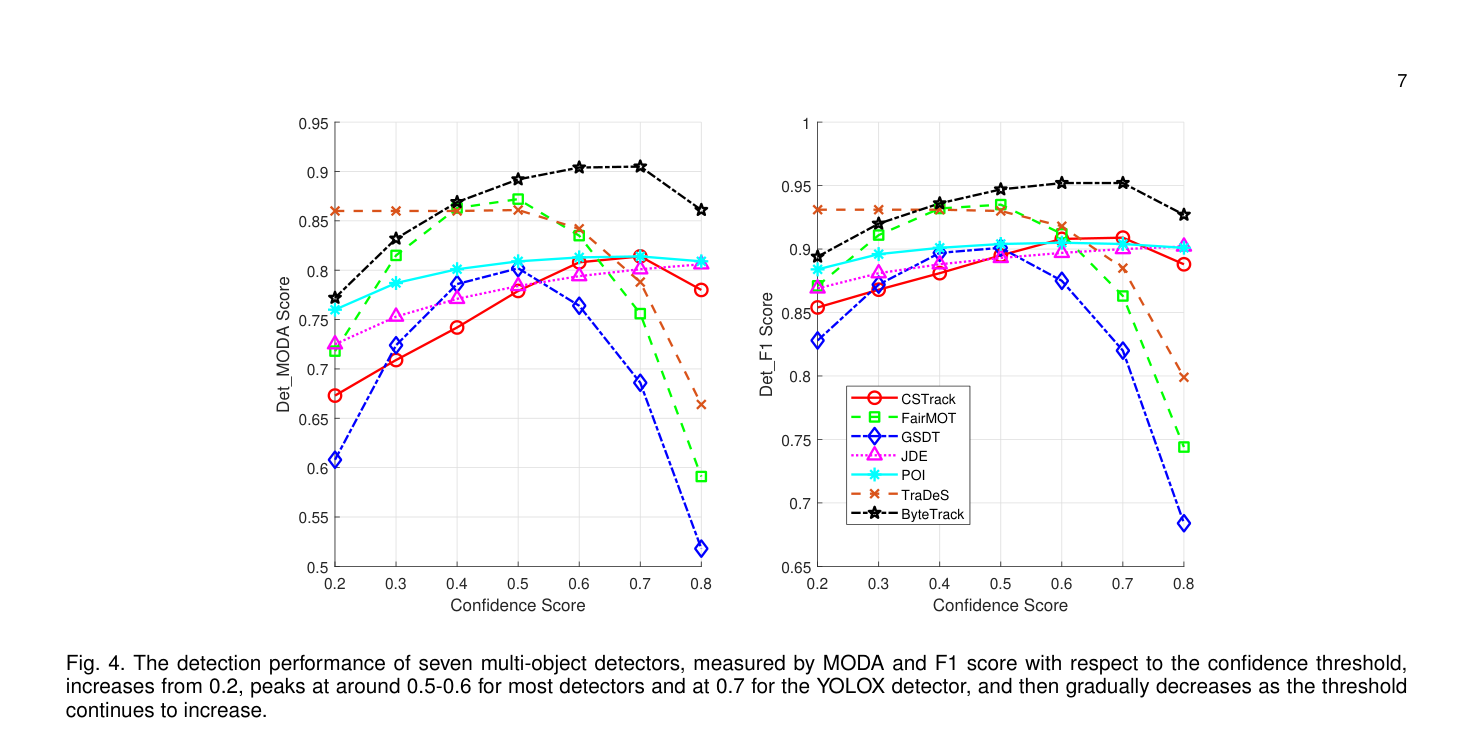
左右两幅都是置信度从 0.2 到 0.8。左轴是 Det_MODA,右轴是 Det_F1。七条曲线对应正文的 CSTrack、FairMOT、GSDT、JDE、POI、TraDeS 和 YOLOX。先看谁在 0.5–0.7 见顶,再看 0.8 处谁跌落;F1 上最高、并在大约 0.7 见顶的是 YOLOX。这是检测质量曲线,不能直接当成 HOTA 排名。
方法贡献
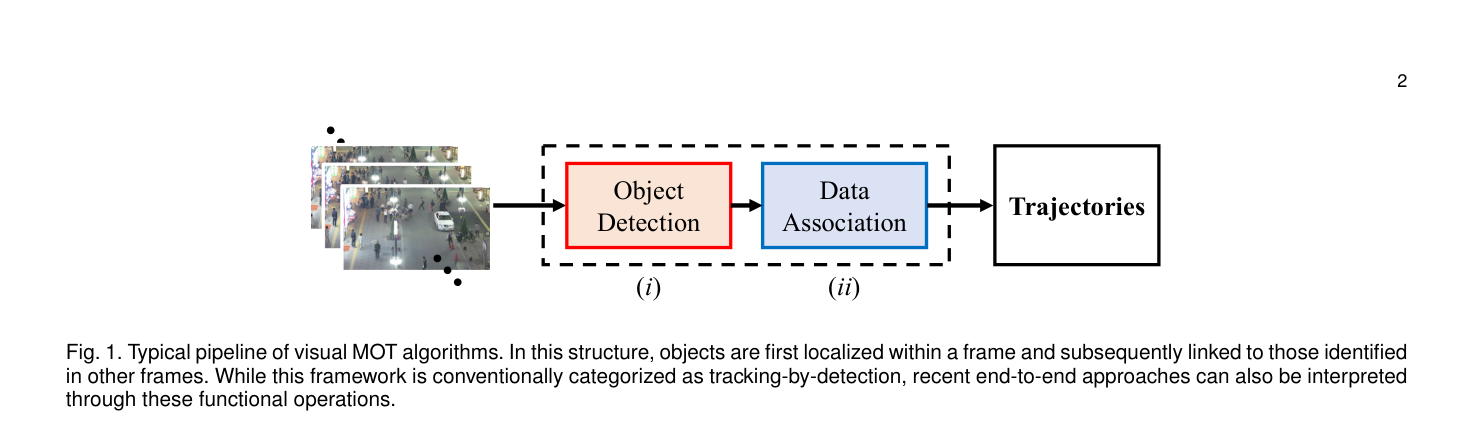
从左到右看:一段俯视人群画面进入红色的 Object Detection,再到蓝色的 Data Association,最后输出 Trajectories。虚线框把前两步收成系统的两个功能,标成 (i) 和 (ii)。这张图适合当特色图,用来记住 TBD 与端到端都可以按“先定位、再连身份”来读,不要把它当成某个数据集的定量结果。
核心结论
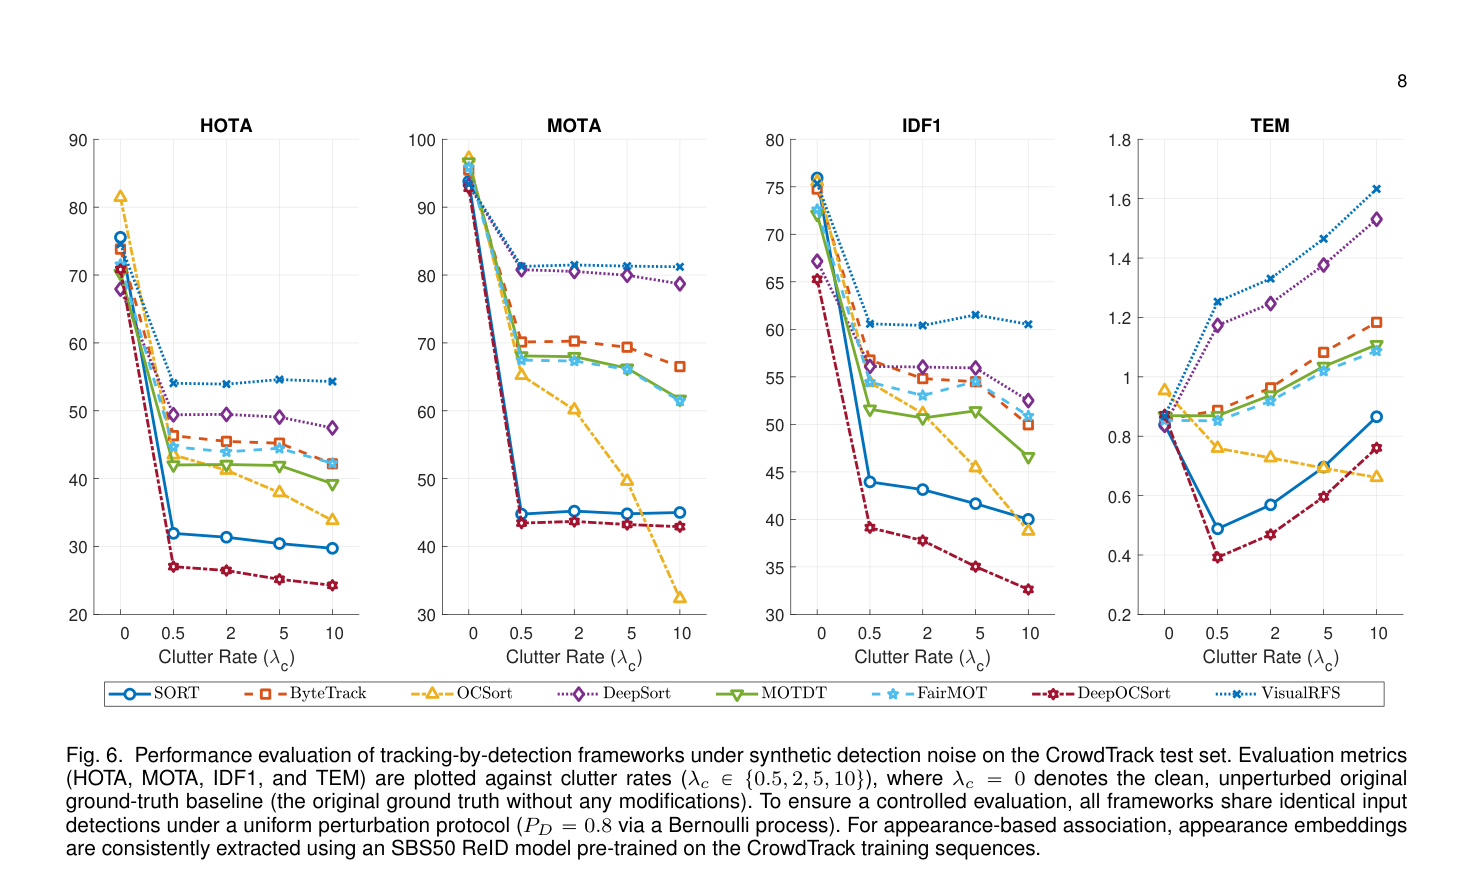
四列依次是 HOTA、MOTA、IDF1 和 TEM,横轴杂波率包括干净的 0 以及 0.5、2、5、10。八个 TBD 跟踪器共享同一套扰动检测和 SBS50 外观。先看前三列从 0 到第一档杂波的下跌,再看 TEM 是否反向升高。图上没有逐点数值标注,只适合判断趋势:关联没有把坏检测拉回干净基线。
实验如何设计?
- 硬件与评测:Ubuntu 20.04,Intel Core i7-8700,官方 TrackEval。检测报 F1 和 MODA;跟踪报 MOTA、身份切换、IDF1、HOTA 和 AssA,并加入 TEM。TEM 的用意是:HOTA、IDF1、MOTA 可能只是因为输入框已经很好,TEM 才反映跟踪器相对这份检测的额外贡献。
- 数据覆盖 MOTChallenge 的 MOT16/17/20、DanceTrack、SportsMOT 和 CrowdTrack。MOT17 相对 MOT16 标注更好并提供多检测器;MOT20 是拥挤静态机位。DanceTrack 强调相似外观、遮挡和非线性运动。SportsMOT 是篮球、排球和足球的快速运动。方法主要在其原论文报告的数据集上评估,超参改动集中在检测阈值和关联阈值。
- Fig. 4 的七个检测器是 CSTrack、FairMOT、GSDT、JDE、POI、TraDeS 和 YOLOX,在 MOT17 上扫描置信度 0.2 到 0.8。匹配 IoU 为 0.5,只评估可见度大于 0.5 的真值。这些检测器的训练集并不相同:若干联合检测嵌入模型在 Mix of Six 上微调,YOLOX 则按 ByteTrack 的配方在 MOT Challenge、CrowdHuman、CityPersons 和 ETHZ 上训练。
- Fig. 6 在 CrowdTrack 测试集上比较 SORT、ByteTrack、OCSORT、DeepSORT、MOTDT、FairMOT、DeepOCSORT 和 VisualRFS。所有跟踪器吃同一套合成检测:每个真值框以 0.8 的概率保留,中心和尺寸加相当于宽高 5% 的高斯噪声,再按泊松杂波率加入均匀假框。真框置信度抽在 0.7–1.0,杂波框抽在 0.3–0.6。外观统一用 CrowdTrack 训练集上的 SBS50。
- 端到端部分在 DanceTrack 与 SportsMOT 上扫描置信度,并在第 21 页用 YOLOX 作为 TBD 一侧的检测器,比较总速度和 HOTA。作者特别提醒:很多已发表增益没有在相同检测条件下做消融。
关键结果与论文证据
- 检测阈值是非线性的。Fig. 4 上 MODA 从 0.2 上升,正文说多数在超过 0.6 后下降,因此 TBD 常把检测分数设在 0.6 附近,以兼顾真阳性和误检。F1 面板里,ByteTrack 论文所训练的 YOLOX 最高;图注写多数检测器在 0.5–0.6 见顶,YOLOX 在约 0.7 见顶,阈值再升高后 FairMOT、GSDT 等掉得更陡。这是检测曲线,不是跟踪排行榜。
- 第 6 页把 DanceTrack 上表现最好的 YOLOX-X 配给 TrackTrack、OCSORT、ByteTrack、LTTrack 和 HybridSORT,只改变检测置信度。HOTA 和 IDF1 从 0.1 升到大约 0.5–0.7 后饱和或下降,MOTA 则在中低阈值见顶,因为阈值太高会增加漏检。HybridSORT 和 LTTrack 更高也更稳,ByteTrack 和 OCSORT 对高阈值更敏感。图注称仔细选择该阈值可使 HOTA 提高超过 5%。
- 坏检测不是靠更巧的关联就能补回来。Fig. 6 里,λc 从 0 增到第一档杂波时,HOTA、MOTA、IDF1 对大多数跟踪器明显下跌,之后曲线变平。TEM 常常随杂波上升,说明在输入已经很差时,跟踪器相对这份检测的“额外努力”变大,但标准跟踪分数仍然差。干净输入上的高分不能外推到噪声输入。
- 外观特征的区分度取决于检测器/网络,而不只取决于关联公式。Fig. 7 在 MOT16-04 与 MOT20-05 的第 100 帧上,置信度高于 0.3。图注规定颜色越浅、越白,身份区分越好,对角线是同一身份自比。YOLOv11 与 YOLOX 配 SBS50 的矩阵整体更浅、对角线更干净;POI、TraDeS 偏深,MOT20 上的 CSTrack 几乎是密网格。正文说把原重识别特征换成 SBS50 后,多种检测器—跟踪器组合的 IDF1 和 AssA 大约提高 2% 到 5%,联合检测嵌入模块仍有明显余量。
- 相机运动补偿对剧烈运动机位有效,但不是免费的。Table 4 在 MOT16 验证集上用 AdaptByteTrack 和 YOLOX:打开 CMC 后总体 IDF1 +2.6、MOTA +1.4、HOTA +1.8,身份切换从 729 降到 448,也就是减少 281 次、相对 38.5%。MOT16-10、MOT16-13 这类运动明显的序列收益大;MOT16-02、04、09 这类机位稳定的序列几乎没有收益,02 甚至略降。正文同时写明执行时间大约增加到 180 倍。结论里的“最多 38.5%”指的是身份切换次数,不要说成 HOTA 涨了 38.5%。
- 端到端更不挑阈值,但慢,而且比较口径要公平。第 20 页的 DanceTrack/SportsMOT 曲线里,MOTR 和 CO-MOT 随置信度几乎持平,MOTIP 在中低阈值更好、高阈值下降,MeMOTR 在 0.5–0.6 附近较稳。第 21 页在 TBD 使用 YOLOX 的设定下,端到端 HOTA 约 62.65 到 65.42,TBD 约 46.50 到 61.72,大约高出 3 到 15 个百分点;端到端大约 4 FPS,总速度主要由检测器决定,TBD 关联阶段的高效率不会等比例变成整系统加速。TBD 的实际优势是可以更换更快或更准的检测器而不必重训整条跟踪网络。
- 额外关联轮次的收益有限。Fig. 14 图注写,在 MOT17 上多轮关联对 HOTA、IDF1、MOTA 的提升一般低于 5%,只有 OCSORT 配 TraDeS 或 YOLOv11 时,因为第一轮关联偏弱才会出现更大涨幅。DanceTrack 上用 YOLOX 的补充实验同样多半低于 5%。因此“再匹配一轮”不是替代好检测的办法。
阅读时需要注意
- 样本是有公开、文档较全的代表方法,不是 2016 年以来全部跟踪器。没有代码的工作即使性能高也不在实验表里。
- 公平性仍不完整:各方法主要沿用原论文数据集和默认超参,只有阈值类旋钮被系统扫描。YOLOX-X 在部分 GPU 上也不能实时,作者把寻找又快又准的替代检测器留作后续问题。
- ReID 结论来自相似度矩阵和替换特征后的跟踪指标,不是独立的行人重识别榜单。不同检测器的训练数据本来就不同,Fig. 4 的高低不能全部归因于网络结构。
- 端到端与 TBD 的速度—精度对照建立在 TBD 使用 YOLOX 的当前设定上。换一个更强或更快的检测器,这段差距可能改变,这也是作者强调公平检测条件的原因。
- CMC 的 38.5% 只描述 MOT16 验证集上 AdaptByteTrack 的身份切换降幅,并伴随很大的耗时。静止相机不该默认打开补偿。
关联工作
- Luo 等人 2021 年的文献综述、2025 年的深度跟踪综述和开放评测工具,提供了分类和可视化,但数字多来自各论文自行报告的结果。
- 关联综述把概率、端到端和亲和学习统一成分配问题,交通场景的相似度与滤波综述则比较稳定性、精度和速度。它们都把检测器留在系统外面。
- SORT 到 ByteTrack、OCSORT、TrackTrack 这条线说明,解析式关联可以很轻,但身份错误会在遮挡和拥挤时暴露;DeepSORT、FairMOT、StrongSORT、HybridSORT 加上外观后改善身份,也更依赖特征质量。
- MOTR 之后的查询式跟踪把检测和关联一起训练。本文的贡献不是再提出一个新跟踪器,而是说明:若不控制检测,新关联模块的增益无法和“用了更强检测器”分开。