快速导读:CoDeR 用大语言模型和编程智能体把概念写成可执行白盒世界,再让视频扩散模型沿轨迹渲染观察,并把画面按深度登记回同一世界。
现有视频世界模型通常把房间、物体和规则都藏在画面历史里。单帧可以很好看,可是相机转回去之后墙面文字会丢,门打不开,离开画面的杯子也不会自己继续进水。中国科学技术大学与通义实验室的预印本 CoDeR(arXiv 2609.26458,未经同行评审)把世界模型和它的视觉实现拆开:先用语言和代码建成一个可执行的白盒世界,再用视频扩散模型沿着采样轨迹把观察画出来。
系统里有五个角色。概念之神用文字或图像提出意图,创造者由大语言模型担任并写下规则与蓝图,执行者是编程智能体、用 Three.js 把蓝图做成白盒,艺术家是视频生成模型,旅行者则在世界里走动并决定哪里需要渲染。配合逻辑空间和“观察即世界登记”,作者希望记忆、开放交互、离屏演化和多智能体都发生在显式状态上。项目页 https://becauseimbatman0.github.io/CoDeR 返回 HTTP 200;论文写代码和权重将会公开,本次没有核到独立代码仓库,仓库状态写待核验。
英文题目:Code Plans, Diffusion Renders: Open-Ended Generative World Modeling
论文出处:arXiv 每日论文精选 · arXiv:2609.26458
原始论文:PDF / 论文页面
这篇论文解决什么问题?
世界模型要服务具身、游戏和虚拟环境,状态就得随着动作、事件和时间往前走,而不是只放出一条预先画好的视频。近期工作把相机、姿态和布局送进视频生成器,交互能力因此变强,但动作空间仍常常是导航或预定义控制。视觉观察只露出世界的一部分:资源归属、物理约束和社会关系可以在看不见的时候继续影响以后的事件(第1–2页)。
作者用一个日常例子说明这一点。放进正常冰箱的水会继续变冷并结冰,这个过程取决于物理条件,不取决于有没有人看着。只把历史帧压进隐记忆,适合在回到旧地点时找回已经见过的样子,却不负责在镜头外面把状态继续演完。LiveWorld 把渲染和全局状态分开,ReMind 训练生成器跨过观察空档去取回隐藏动态,开放式、任意长时间的自主演化仍然很少被显式建模(第2–3页)。
像素描述外观,不直接写出概念、规则和因果。Agent World Model 用代码和数据库给交互智能体提供可靠状态转移。CoDeR 沿着这条混合路线往前走,但不用单一视觉动态模型包办一切,而是让专门角色分别负责世界逻辑、自主过程和视觉实现(第3–4页)。
核心创新
- 用五个角色把概念意图拆成可执行白盒,而不是让视频模型在像素历史里隐含世界动态。
- 逻辑空间用接口契约组织并行建造,再用空间、状态或事件绑定合成一个共享世界。
- 观察即世界登记把已生成画面按深度写回白盒,使离屏状态和多智能体观察共用同一份持久表示。
方法概览
五个角色协作。概念之神提出文本或图像意图;创造者用大语言模型写下规则、内部状态和蓝图;执行者按逻辑空间的接口契约用代码并行建造 Three.js 白盒,并用绑定把模块合成可执行世界;艺术家以白盒视频、真值深度和语义提示生成彩色观察;旅行者采样轨迹。观察即世界登记按式6把部分像素经深度可见性检查投回表面。视觉线索黑客用 Canny 和深度制作训练视频。艺术家是 MiniMax H3,骨干 LoRA、ControlNet 全参,32 张 A800 上训练 200 步。论文写创造者与执行者使用 GPT-6 Astra。
- 概念之神可以说“Let there be a city block.”。系统只做很少的格式整理,不把这段话直接送进扩散变换器。创造者用一组智能体递归拆分意图,先把交通规则、健康或声誉这类内部状态,以及牛顿定律这类运动规律写成世界状态。执行者再按蓝图生成可执行代码。白盒是完全由代码搭出来的三维块面,因此隐藏信息是被编码和强制执行的,而不是从纹理里猜(第4–5页,Fig.2)。
- 逻辑空间把总目标 g 分解成图 G=(V,E)。每个节点是局部目标 gi 加接口契约 Ki,契约带上共享规则,又把具体实现留给对应的执行者。一个逻辑空间是功能范围,不一定是互不重叠的地块。执行者得到 Bi=Ai(gi,Ki),可以在依赖就绪后并行写代码。最后用绑定把模块拼成世界 W:绑定可以是空间变换、状态映射或事件连接。论文举例,车辆外形和碰撞体可以分开做,再绑到同一个车辆状态;驾驶舱相机也可以绑到车辆位姿(第5–6页,式3–5)。
- 艺术家看到的是乏味的白盒视频 W、对应的真值深度 D,以及从白盒状态取出的地点和周围语义所写成的提示 P,输出彩色视频 V。登记时,从以往视频里随机抽一部分像素,用已知相机和几何反投影到表面,只保留同一表面且通过深度可见性检查的颜色。式6写成 R=M⊙Π(V,D)+(1-M)⊙W:已观察区域带上旧颜色,未观察区域仍是白盒。艺术家被训练成从这种部分登记里恢复完整彩色视频(第6页)。
- 人类相关场景用 SMPL-H 表示运动、手物交互和视点绑定。创造者与执行者的实现写的是 GPT-6 Astra,论文称它是具有三维空间意识的多模态编程智能体;这是预印本中的方法组件名称,不是本次独立复核过的公开模型卡(第6–7页)。艺术家选用开源视频模型 MiniMax H3。作者发现直接重绘白盒会得到硬边、单调纹理和平光,也难以直接适配登记范式,因此提出视觉线索黑客:从白盒抽取 Canny 边缘和深度,用 ControlNet 生成多种风格的训练视频,得到 (W 或 R, D, P, V)(第7页)。
- 训练使用 32 张 NVIDIA A800,全局批量 16,共 200 步,AdamW 学习率 1×10⁻⁵。片段被调整到 1280×704、124 帧。变换器骨干用 LoRA 微调,ControlNet 分支做全参数微调(第7页)。旅行者可以是有外观的实体,也可以只是一个相机,由它决定艺术家渲染哪一段轨迹。
逐图理解论文
失败直觉
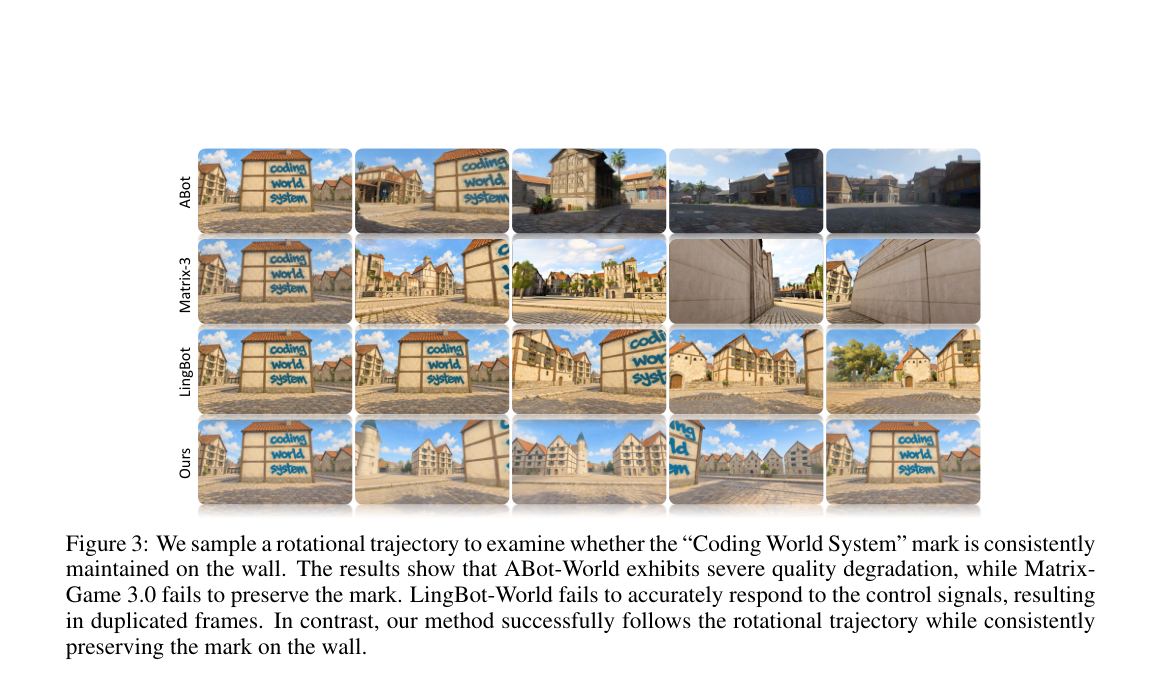
第7页的旋转记忆对比,四行五列,标签 ABot、Matrix-3、LingBot、Ours。欧洲小镇广场的墙上有蓝色涂鸦 coding world system。ABot 后几帧变暗变糊,涂鸦和房子一起消失。Matrix-3 第三帧涂鸦没了并切到空街,接着一帧发灰,最后是一面白墙。LingBot 中间两帧几乎重复,涂鸦大小和位置不稳。Ours 绕到广场另一侧时,涂鸦仍留在那栋楼的墙面上。这是定性闭环,不是 Table 1 的平均分。
方法贡献
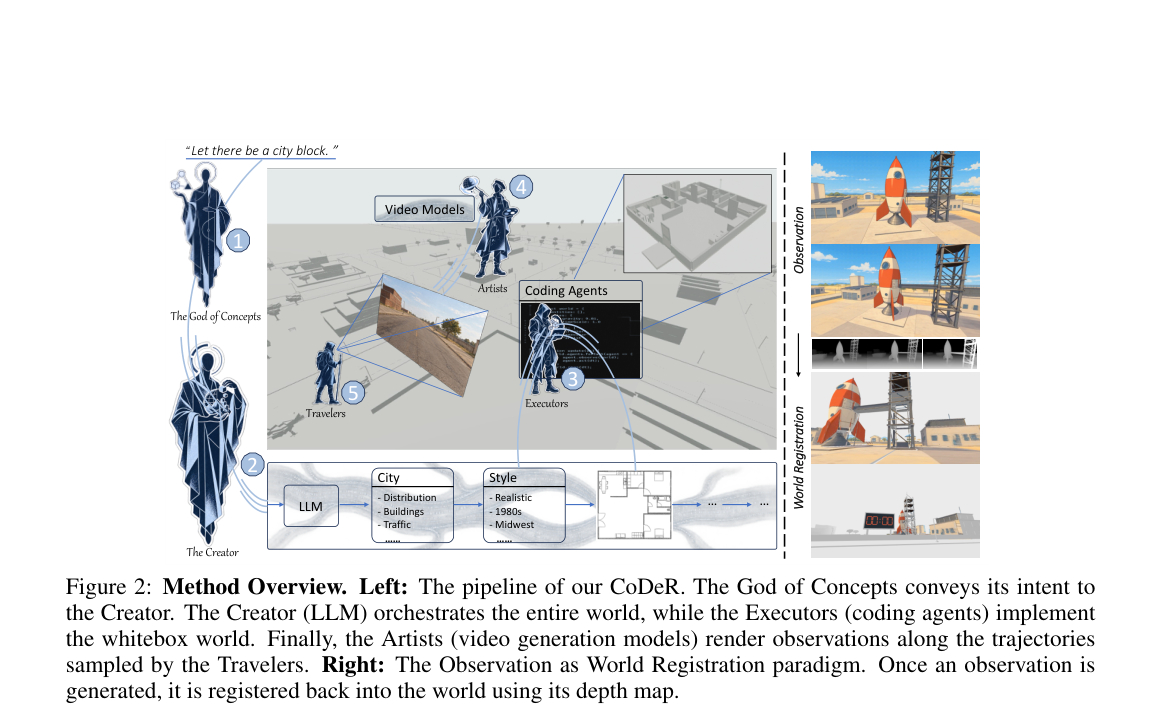
第5页方法总图,适合作为架构主图。左栏五个编号:概念之神举着卷轴,引语是 Let there be a city block;创造者把意图送进 LLM,分出 City(Distribution、Buildings、Traffic)和 Style(Realistic、1980s、Midwest),再通向平面图。灰白块面城市里,执行者对着代码,艺术家标着 Video Models,旅行者站在插有道路照片的平面旁。右栏上方 Observation 是彩色火箭与发射塔,下方 World Registration 是同一几何的灰白块面,其中一帧塔楼上有红色数字钟 10:00。阅读顺序是先从意图到代码世界,再看彩色观察如何按深度回到白盒。
演化观察
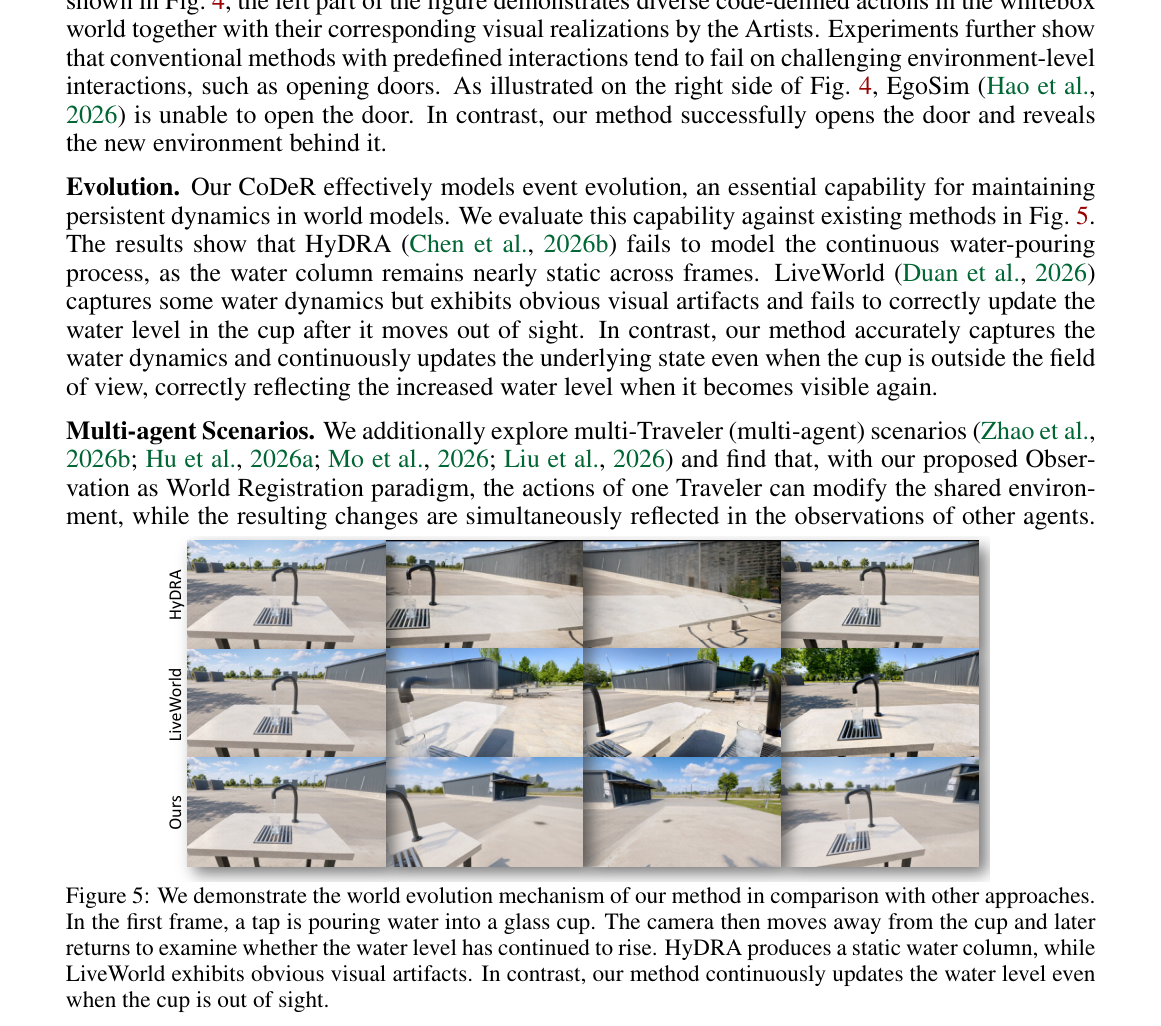
这张 PNG 上方先露出关于开门、演化和多智能体的正文,下面才是 Fig.5。三行四列,标签为 HyDRA、LiveWorld、Ours,场景是室外混凝土台、黑色水龙头和玻璃杯。HyDRA 的水柱在各帧变化很小,镜头回来后杯子仍接近起始状态。LiveWorld 中间帧桌面被拉白,几何明显变形。Ours 能看到水流进杯,镜头转到空台和远处房屋,回来时杯中水位更高。图中没有毫米级水位读数,升高是定性观察,对照图注所说的离屏更新。
实验观察
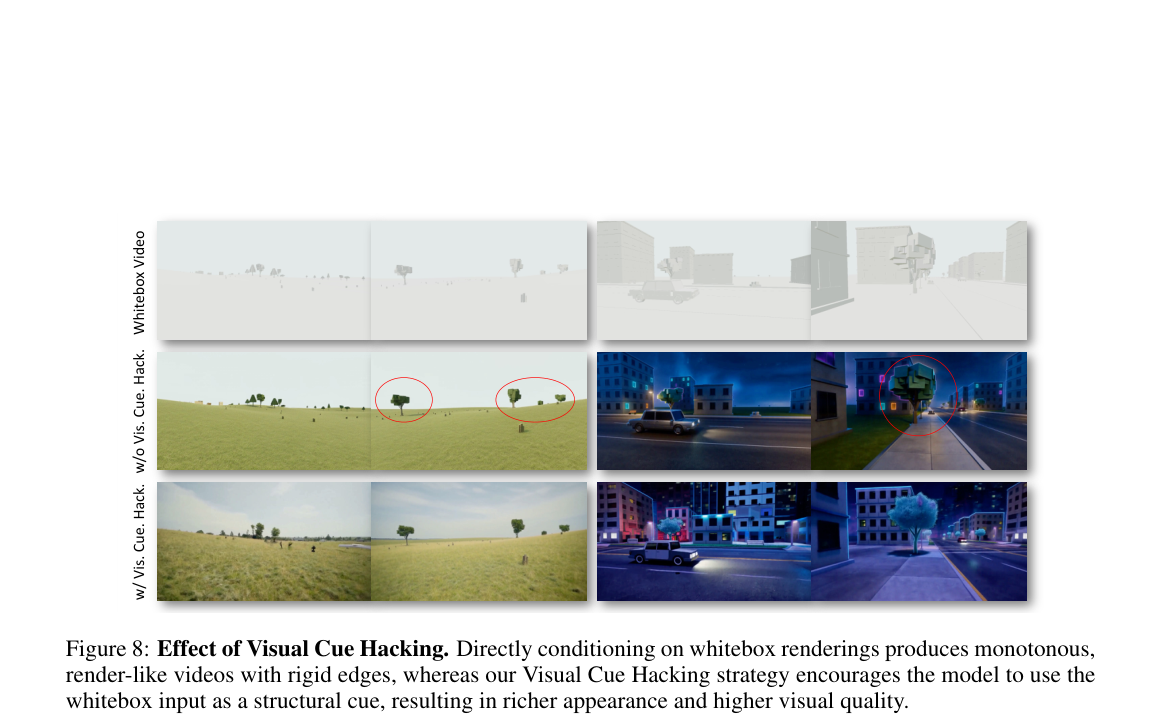
第21页视觉线索黑客的对照,三行两景。行标签是 Whitebox Video、w/o Vis. Cue. Hack. 和 w/ Vis. Cue. Hack.。左景是白天草地,右景是夜晚街道。白盒行几乎是空白浅灰草地,以及线框城市、一辆车和楼块。无该策略的一行把草地里两棵树和夜景里一棵发亮的方块树用红圈标出,边缘更像直接渲染。有该策略的一行草地更自然,夜景有霓虹、路面和更完整的树冠。红圈是图中的标注,不是额外检测框。它说明白盒应作为结构提示;长视频退化不在这张图里。
实验如何设计?
- 定性比较围绕记忆、开放交互、演化和多智能体。记忆测试是一段 360 度旋转,看墙上的 “Coding World System” 标记能否留住。对照是 ABot-World、Matrix-Game 3.0 和 LingBot-World(第7–8页,Fig.3)。开放交互展示弹钢琴、骑龙、开门和驾驶飞船;开门对照 EgoSim(第8页,Fig.4)。演化用水龙头往杯中倒水:镜头离开杯子再回来,对照 HyDRA 与 LiveWorld(第8页,Fig.5)。多智能体示例里,一名旅行者击倒目标时,另一名同时看到事件(第9页,Fig.6)。
- 定量比较在 WorldScore 的 10 项指标上对照 ABot-World、LingBot-World 和 Matrix-Game 3.0(第9页,Table 1)。消融去掉视觉线索黑客或观察登记,报告 WorldScore 的内容对齐、照片一致、主观质量,以及 VBench 的成像质量、美学质量、主体一致性和动态程度(第9页,Table 2)。用户研究收集 30 份有效问卷,维度是视觉质量、交互一致性、记忆与持久、世界演化和总体偏好,对照 Matrix-Game 3.0、LingBot-World、EgoSim 和 LiveWorld(第20页,Fig.7)。
- 因为方法不能直接套进许多基准的输入格式,评测时先由首帧重建白盒再采样视频。具体做法是用 SAM 3 分割物体,用 Depth Anything V2 估计深度,再把首帧、分割和深度交给 GPT-6 Astra。重建不必与首帧完全对齐,生成时仍用原始首帧锚定外观(第20–21页,Fig.9)。
关键结果与论文证据
- Fig.3 的旋转轨迹上,ABot-World 后段明显变暗变糊,标记消失;Matrix-Game 3.0 丢失建筑并出现空墙;LingBot-World 出现重复帧,没有跟上控制。CoDeR 转完一圈后,几何和墙面涂鸦都还在(第7–8页)。Fig.4 中 EgoSim 打不开门,本文方法打开门并露出门后的新环境。动作不必来自固定动作表:创造者可以定义新动作,执行者再用代码实现,因此动作空间被写成可扩展的(第8页)。
- 倒水实验里,HyDRA 的水柱在各帧几乎静止;LiveWorld 有一些水的动态,但出现明显视觉伪影,杯子离开视野后水位也没有正确更新。CoDeR 在杯子出画后仍更新底层状态,镜头回来时水位升高(第8页,Fig.5)。Fig.6 里智能体 1 击倒目标时智能体 2 看得到,反向亦然。这是共享白盒被登记更新后的定性结果,不是大规模多智能体基准分数(第9页)。
- Table 1 中本文十项全部高于所列对照,平均 87.88。分项为相机控制 98.91、物体控制 92.25、内容对齐 98.44、三维一致 88.65、照片一致 91.10、风格一致 89.40、主观质量 69.08、运动精度 82.76、运动幅度 84.92、运动平滑 83.31。对照平均分是 ABot-World 69.24、Matrix-Game 3.0 74.20、LingBot-World 74.79。运动幅度的差距尤其大:三个对照分别是 26.89、24.75 和 27.93(第9页)。这些数字来自经过白盒重建的评测协议,不宜说成未改输入格式的原始 WorldScore 提交。
- Table 2 里,去掉视觉线索黑客后内容对齐从 98.44 降到 82.48,主观质量从 69.08 降到 49.05,成像质量 63.52、美学质量 66.18、主体一致性 87.54。去掉观察登记后照片一致从 91.10 降到 84.85,主体一致性从 96.31 降到 84.63,主观质量 53.98。完整模型的 VBench 四项是 70.77、72.29、96.31 和 98.16。动态程度三项都在 97 以上,分开的主要是一致性和主观质量(第9页)。
- 30 份问卷里本文在五个维度都最高:视觉质量 84.40、交互一致性 92.75、记忆与持久 81.60、世界演化 87.25、总体偏好 88.20。LiveWorld 的世界演化为 82.85,是对照里最接近的一项,但它的交互一致性只有 46.80。Matrix-Game 3.0、LingBot-World 和 EgoSim 的世界演化分别是 28.80、30.00 和 24.40(第20页,Fig.7)。论文没有报告这份问卷的显著性检验。
- Fig.8 把同一条白盒视频、直接条件生成和视觉线索黑客并排。白盒行是发灰的空草地和线框城市;直接条件一行里,草地中两棵树和夜景里一棵发亮的方块树被红圈标出,边缘更像渲染。使用线索黑客后,草地纹理和夜城霓虹更丰富,白盒更多被当成结构提示而不是逐像素临摹目标(第21页)。
阅读时需要注意
- 艺术家只在固定的 124 帧窗口上微调,没有专门的长视频后训练。长序列靠分块自回归拼接,误差会累积。Fig.10 在大约 5000 帧时已经能看到退化,图中例子的时间戳从 t=5160 到 t=6861(第22页)。因此“长时记忆”主要来自白盒登记,不等于任意长度的画面都不崩。
- 白盒本身会失败。复杂手物交互里手的姿态可能严重扭曲,几何或碰撞不完善时物体会互相穿透(第22页,Fig.11)。逻辑空间保证的是接口能被绑定,不保证物理仿真已经正确。
- WorldScore 数字依赖一条改编协议:先从首帧重建白盒,而且论文明确说重建不必与首帧几何完全一致(第20–21页)。Table 1 的“全部最优”应和这条协议一起读。用户研究是 30 份问卷的均分,没有置信区间。定性演化例子是作者挑选的场景,不是大规模离屏动态测试集。
- 代码和模型权重在论文中写的是将会公开。项目页可访问,但没有独立代码仓库记录,本次写作不能把它写成已核验的开源发布。创造者和执行者依赖论文所称的 GPT-6 Astra,换一个编程智能体后,白盒质量会如何变化并没有消融。预印本尚未同行评审。
关联工作
- 视频生成一侧,流匹配学习数据与噪声之间的速度场,条件可以是人体姿态、相机轨迹或场景布局(第2–3页)。这些信号约束的是一段视频的空间和时间行为,不是一个离开相机仍在演化的可执行状态。
- 交互世界模型从 Genie、GameNGen、GameGen-X 到 Matrix-Game 及其实时扩展,重点在动作可控、画质和流式效率。ActWorld 开始支持生成途中更丰富的物体交互。记忆路线包括 RELIC 的相机感知隐记忆,以及 AlayaWorld 的压缩历史和几何空间记忆。它们延长了可回看的时间,记忆对象仍主要是曾经观察到的状态(第3页)。
- 离屏动态的近邻是 LiveWorld 和 ReMind,结构化世界的近邻是 Agent World Model。CoDeR 的差别是用五个角色和逻辑空间组织建造过程,并用深度登记把视频观察写回同一份可执行世界,而不是只在视觉模型内部保存一个全局状态(第3–6页)。