快速导读:FleXray 用已标注 CT 的在线投影、生成式外观编辑和 60 类标签协调,训练可重叠的全身X光分割模型;它是研究模型,不是临床诊断产品。
X光是使用最广的医学成像之一,却很难做密集、全身的定量分割。投影把三维结构叠在同一张检测器上,边界连专家也难画,公开标注又集中在胸部。麻省理工学院计算机科学与人工智能实验室、麻省总医院与哈佛医学院的预印本 FleXray(arXiv 2609.26756,未经同行评审)不靠大规模手标X光,而是用已标注的三维 CT 做物理投影,再配合生成式图像编辑,合成带 60 类解剖标签的训练视图,训出一个不需要提示或采集参数的分割模型。
必须先说清用途。FleXray 不是临床诊断产品,不能替代放射科医生,也不能根据一次分割做疾病诊断或治疗决定。下文所有 Dice、Cobb 角误差和配准误差都只描述论文里的研究基准。论文与项目页 https://flexray.csail.mit.edu 声称模型、代码、数据和浏览器演示放在该站,该页 HTTP 200;本次没有打开页面复核仓库条目,不能写成已核验的 GitHub 星标。
英文题目:FleXray: Universal Clinical X-ray Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2609.26756
原始论文:PDF / 论文页面
这篇论文解决什么问题?
CT 和 MRI 已经能自动勾出大量解剖结构,X光却把器官重叠在一起。标注每一张、每一个结构不现实,采集体位、视野、骨密度、造影剂和植入物又差得很远。结果是现有数据往往只标心脏、肺等少数结构,而且采集条件很窄(第1页)。Fig.1 的图注写,12 个公开数据集共有 667,380 张带标签X光,标签仍不均匀,并偏向胸部。
图1a 引用联合国原子辐射效应科学委员会的年度检查量。可见柱状图里,X光柱标着 Chest/ribs 40.2%,CT 柱标着 403M/year,纵轴画到 0.5B。正文用这张图说明X光更常用,但没有在正文里逐项列出其余检查类型的百分比,解读时不要补写图上未看清的分项(第1–2页)。
先前从 CT 渲染带标签X光的工作多半针对胸部、标准正侧位或交互式流程。全身 CT 又常常只覆盖颈到膝,体位标准化,儿童少,手和足更稀缺。FleXray 把模拟扩大到身体区域、人群和连续变化的采集几何,并用真实肢端X光补上 CT 覆盖不到的位置(第3页)。
核心创新
- 用可控的 CT 射线投影生成可重叠的二维解剖监督,而不是依赖逐张手标全身X光。
- 用未微调的生成式编辑补充临床纹理,并把多来源标签收成 60 类共同词汇。
- 按数据集覆盖路由损失,使不完整标注能联合训练,推理时不必提供提示或几何参数。
方法概览
六套 CT 共 2,159 名受试者,其中 MOOSE 1,597 例,加四套真实X光 764 例,协调到 60 类。在线物理投影随机化几何和逐结构衰减,并为每个结构输出可重叠概率图。flux.2-klein-9b 编辑 MOOSE 的 DRR 以补充临床外观,质控去掉约 4% 改解剖的样本。不完整标注用路由损失,确定不可能的结构才当阴性。五个七级 U-Net 成员只在在线/增强 DRR 比例上不同,发布时加 16 视图测试时增强。推理不需要提示或采集参数。
- 数据引擎有三条来源。六套 CT 共 2,159 名受试者,其中 MOOSE 提供 1,597 例密集标注的全身 CT;另外五套 CT 补解剖和人群缺口。外周仍然不够,于是加入四套真实X光共 764 例,包括公开的手、足标注,以及作者在 MURA 上新标的前臂和上臂。标签定义不一致,例如一套数据写“脊柱”,另一套写“L1 椎体”,所以用自动协调把它们收成 60 类。这个词汇只保留X光上有意义的结构,脑和骨骼肌这类通常看不见的结构被排除(第3页,Fig.2c)。
- 训练时用物理渲染器从 CT 和标签在线投影。每次采样解剖目标、视点、视野、放大率和投影几何,并按结构随机改变衰减,用来模拟与几何无关的密度差异(Fig.2a)。因为多块组织可以落在同一检测器像素上,每张三维掩码单独投影,目标保持重叠,而不是一张互斥分区图。射线穿过的每个器官都标成阳性,网络为每个结构输出独立概率图(第3、5页)。
- 解析 DRR 仍缺临床外观:分辨率差、画面文字、剂量、探测器响应和散射都难高效模拟。作者把预训练的文本条件编辑模型 flux.2-klein-9b 用在 MOOSE 的 DRR 上,要求加入临床纹理和采集痕迹,同时保留投影解剖,且不做任务微调(第3、18–19页,Fig.2b)。编辑有时会改掉解剖,于是用只在原始 DRR 上训练的 U-Net 比较 SoftDice,丢掉偏差大的样本,大约移除 4% 的增强 DRR(第3页)。
- 每个数据源只标注 60 类中的一部分。把没标的结构一律当成不存在会误导训练,所以损失按标注覆盖路由:状态不明的标签忽略;解剖上确定不可能出现的结构,例如足部X光里的手,才作为明确阴性。最终系统是五个成员的集成,成员架构相同,只是 MOOSE 那 75% 采样预算里,离线增强 DRR 所占比例不同,其余由在线渲染补足;补充 CT 和真实X光占另外 25%。每个成员再做 16 视图测试时增强。消融和微调使用等比例的 FleXray(single)(第5、22页)。
- 单个成员是七级二维卷积 U-Net,编码器与解码器在对应分辨率上的宽度为 64、128、256、512、512、720、1024。每个编码块是三次 3×3 卷积、LeakyReLU 和实例归一化,并带残差;最后 1×1 卷积接逐通道 sigmoid,得到可重叠概率图。输入分辨率在计时设置里是 256×256。优化共 2,000 个 epoch,每 epoch 500 次混合加载,批量 16,AdamW 初始学习率 3×10⁻⁴,权重衰减 0.01,EMA 系数 0.9999。推理用最后一个 epoch 的 EMA 权重,不按留出X光集挑检查点。损失是前景 Soft-Dice 与二元交叉熵的等权求和(第22页)。发布配置的五个成员合计约 507.0M 参数;单个无测试时增强的成员约 101.4M,和 PAXray 的 73.4M 同一量级(第28页)。
逐图理解论文
标注瓶颈
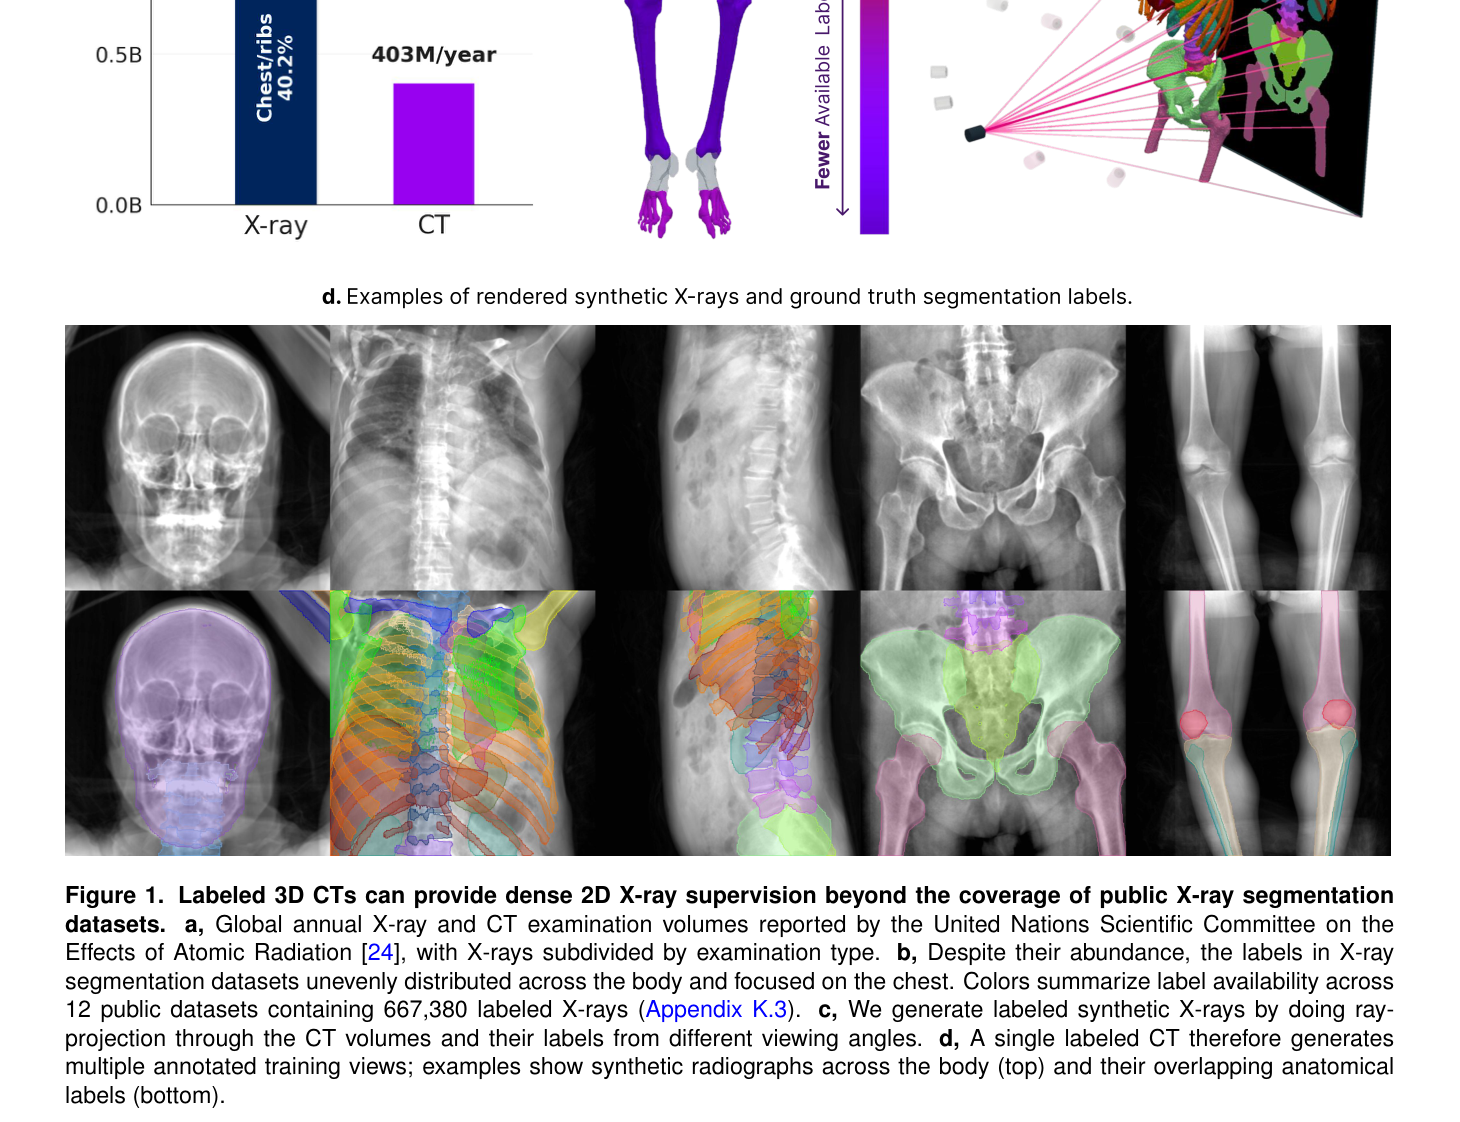
第2页 Fig.1。左上柱状图纵轴标到 0.5B,X光柱内写着 Chest/ribs 40.2%,CT 紫色柱写着 403M/year,其余检查类型的小字在这张裁图里看不清,不要补写。中间是人体与足部示意,旁边有一条向下的紫色条,写着可用标签更少。右上是彩色骨盆和股骨的三维模型,粉色射线从一点投到探测器平面。下方 d 面板两行六列:上排是头颅、胸椎、侧位躯干、骨盆、膝关节附近的合成X光,下排是同一视图上半透明、互相重叠的彩色解剖标签。底部图注说明 12 个公开数据集共 667,380 张带标签X光,标签偏胸部。这是数据来源示意图,不是诊断示例。
数据引擎
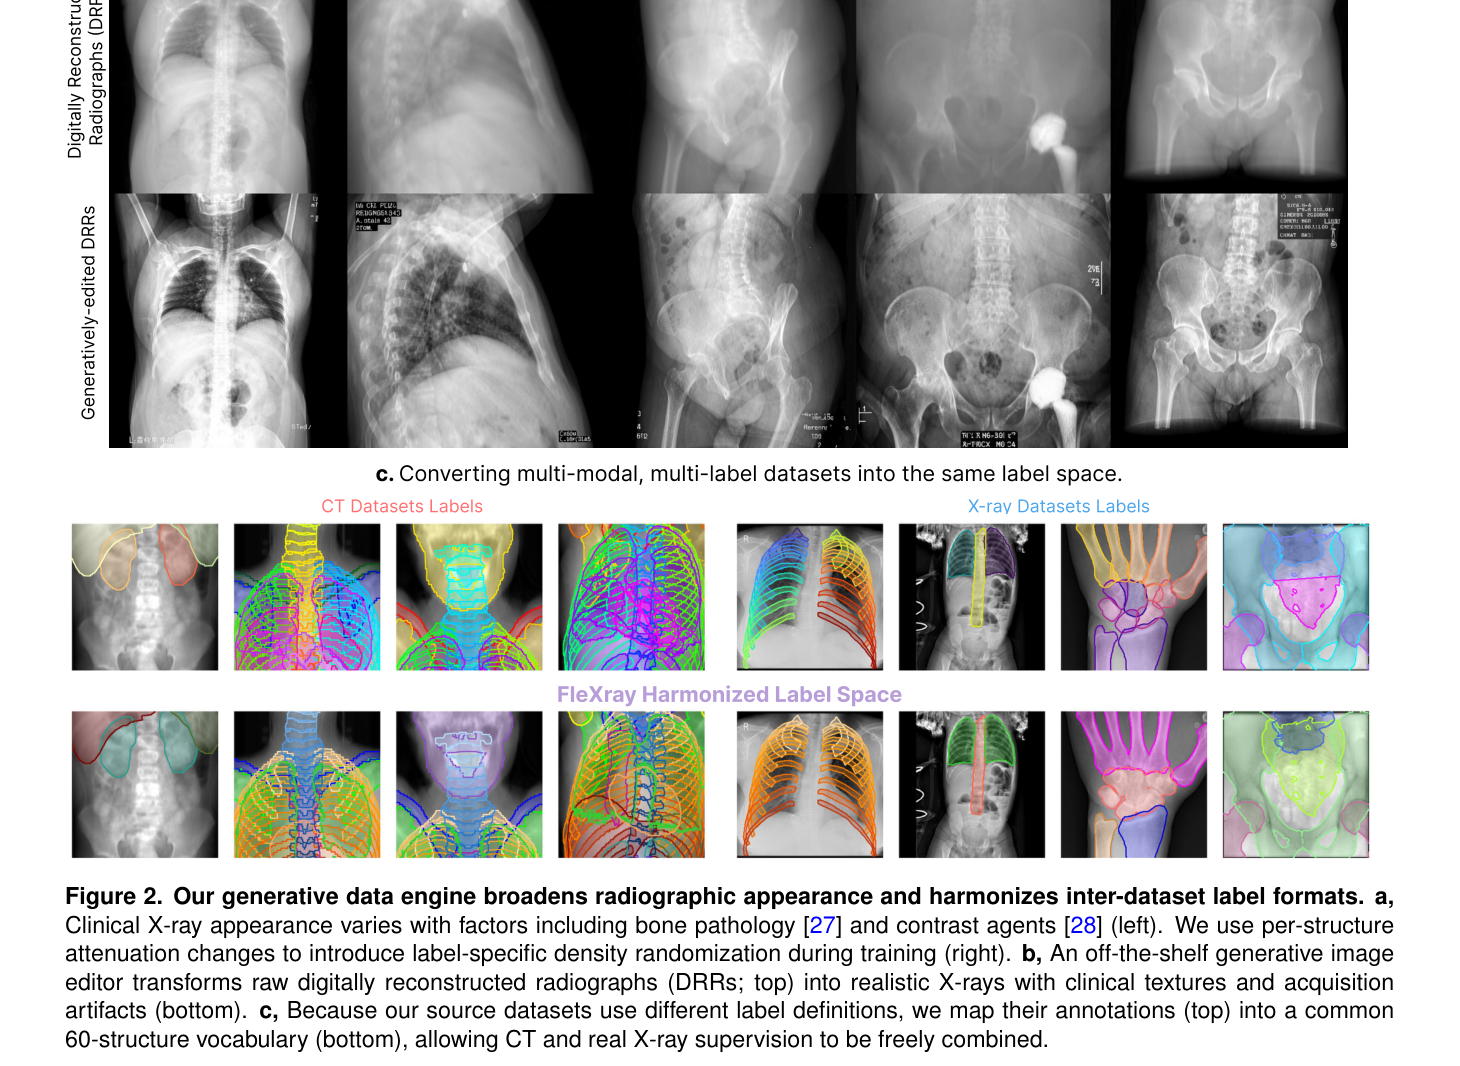
第4页数据引擎图,PNG 主要留下 b、c 两面板,密度随机化的 a 面板基本在裁切之外,只能根据图注知道它对比骨病、造影和按结构改衰减。可见的 b 面板上排是解析 DRR:脊柱、躯干、带高密度植入物的髋和骨盆;下排是生成式编辑后的片子,出现颗粒、标记和类似采集界面的亮斑,解剖轮廓仍大致对应。c 面板先是 CT 数据集标签和X光数据集标签,结构粗细不一致,下面一行是收成 FleXray 统一标签空间后的彩色图,能看到脊柱、胸廓、双肺、手和骨盆。阅读时先看编辑是否只改外观,再看上下标签是否被收成同一套词汇。它不是临床读片界面。
留出结果
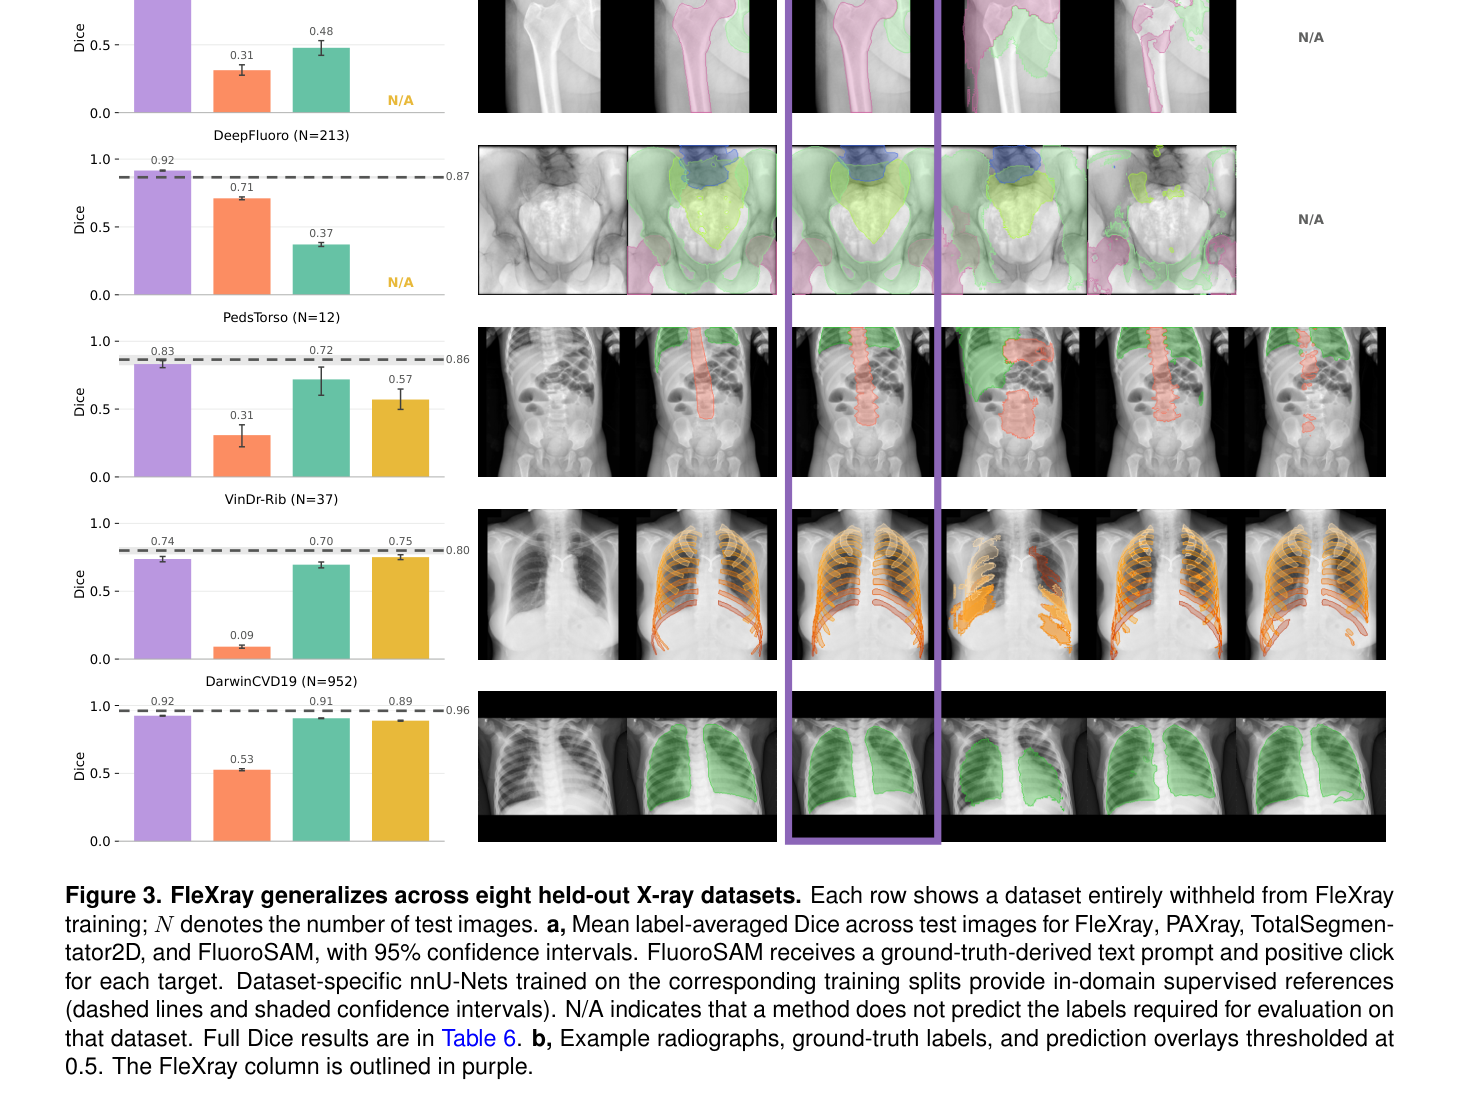
第6页 Fig.3 的下半部分。PNG 从 DeepFluoro 开始,腕、下肢、肘和髋四行在裁切之外。可见四行及图上约数:DeepFluoro(N=213)紫柱 0.92、橙柱 0.71、青柱 0.37、黄柱位置为 N/A,虚线 0.87;PedsTorso(N=12)0.83、0.31、0.72、0.57,虚线 0.86;VinDr-Rib(N=37)0.74、0.09、0.70、0.75,虚线 0.80;DarwinCVD19(N=952)0.92、0.53、0.91、0.89,虚线 0.96。右侧定性列被一条紫色竖框圈出,依次是髋部重叠彩膜、儿童躯干椎体、橙色肋骨和绿色双肺;部分对照列写着 N/A。对照 Table 6,紫柱是 FleXray,橙柱是 FluoroSAM,青柱是 TotalSegmentator2D,黄柱是 PAXray,虚线是域内 nnU-Net。柱上数字是四舍五入,引用时要用表内区间。
实验如何设计?
- 分割评测使用八个完全不参与训练的真实X光集,覆盖腕、下肢、肘、髋、透视、儿童躯干、肋骨和胸部,图像数见 Table 6:RAM-W600 124、LowerLimbs 8、ElbowLat 91、HipRay 21、DeepFluoro 213、PedsTorso 12、VinDr-Rib 37、DarwinCVD19 952。通用对照是 PAXray、TotalSegmentator2D 和 FluoroSAM。FluoroSAM 对每个目标都得到由真值派生的文本提示和一次正点击。每个评测集另训一个 nnU-Net,作为域内参照,不参与“零样本通用模型”的排名(第5、29页,Fig.3)。
- 预测会按数据集的标注约定做后处理,主指标是逐例、再对标签平均的 Dice。八个数据集的总平均对每个数据集等权,而不是按图像数加权。PAXray 与 TotalSegmentator2D 只在它们覆盖的部位上比较,表中短横线表示标签不够。显著性比较只在 FleXray 与每个有覆盖的通用基线之间,并在数据集内做 Holm 校正(第29页)。
- 下游研究任务有三项,仍然是基准而不是临床部署。AASCE 的 218 张脊柱正位片上,由椎体掩码估计主 Cobb 角,并按不超过 20 度、20 到 40 度、大于 40 度分层(第8页)。DeepFluoro 的 213 帧上,把分割距离变换的双向 Chamfer 项加进 xvr 的二维/三维配准,失败定义为 mTRE 大于 10 毫米(第8–9页)。少样本微调则把 FleXray(single)的输出头换成任务头,在儿童髋发育不良 MTDDH 和骨肿瘤 BTXRD 上使用 1% 到 100% 的训练划分,对照从随机初始化训练的 nnU-Net(第10页)。
关键结果与论文证据
- 八个留出集上等权平均 Dice,发布的五成员加 16 视图增强为 0.875,域内 nnU-Net 为 0.914,平均落后 0.039。论文写它在七个数据集上显著优于每个有标签覆盖的通用基线,其中六个数据集 p<0.001。VinDr-Rib 上与专门做胸部的 PAXray 没有显著差异:0.737 对 0.751,n=37,p=0.146(第5、28–29页)。
- Table 6 的 FleXray(ours)分项是:RAM-W600 0.949 [0.947, 0.950],LowerLimbs 0.834 [0.715, 0.931],ElbowLat 0.871 [0.855, 0.884],HipRay 0.938 [0.934, 0.942],DeepFluoro 0.915 [0.912, 0.919],PedsTorso 0.831 [0.806, 0.855],VinDr-Rib 0.737 [0.716, 0.756],DarwinCVD19 0.924 [0.921, 0.927]。FluoroSAM 在八个集上的等权平均只有 0.348。腕、肘和下肢只有 FluoroSAM 有足够标签,FleXray 仍高出 0.42 到 0.71 Dice,而对方还带有真值提示和点击(第28–29页)。
- 域内 nnU-Net 在七个集上高 0.03 到 0.09 Dice。例外是 DeepFluoro:只用两名受试者 70 帧训练的 nnU-Net 在两名留出受试者的 213 帧上为 0.866,FleXray 为 0.915,p<0.001。Fig.3 可见柱上的数字是约数,例如 DeepFluoro 的 0.92、0.71、0.37 和虚线 0.87,应对回 Table 6 的 0.915、0.711、0.371 和 0.866(第5–6、28页)。
- DeepFluoro 上按离开正位的测地距离看,5 度分箱的平均 Dice 从 5–10 度的 0.925 [0.921, 0.928] 到 35–40 度的 0.888 [0.847, 0.923]。股骨、髋和骶骨在全角度范围内相对正位下降不超过 0.05。腰椎在 15 度以内为 0.840(n=136),超过 25 度为 0.751(n=27)。同一批帧上 FluoroSAM 与 TotalSegmentator2D 的平均 Dice 为 0.711 和 0.371(第5页)。
- 生成式增强的等权平均 Dice 可以不变:增强与原始都是 0.870(n=1,458)。收益集中在难投影的结构。VinDr-Rib 第 5 到第 10 肋合并提高 3.9 个 Dice 点 [2.2, 5.8],p<0.001,从第 5 肋的 +2.5 到第 10 肋的 +7.4(第5、8页)。衰减随机化把等权平均从 0.863 提高到 0.870;DarwinCVD19 的肺 Dice 从 0.907 到 0.922(n=952)。健康肺几乎不变,0.945 到 0.946(n=241),肺炎从 0.894 到 0.914(n=711),低于 0.85 的肺炎图像从 122 张降到 50 张(第8页)。这些仍是分割重合度,不是肺炎诊断性能。
- 集成把等权平均从单模型 0.866 提到 0.874,16 视图增强再给单模型加 0.004、给集成加 0.001。发布集成约 74.2 毫秒每张,加上测试时增强延迟到 1.24 秒,显存峰值 2.36 GB。单模型无增强大约保留发布配置 99% 的精度,延迟约为 1/84(第28页)。在线渲染单独为 0.858,且 LowerLimbs 降到 0.705;离线单独为 0.852。代表单模型选用验证集上更稳的 37.5/37.5 混合(第29页)。
- AASCE 上 218 张全部能测出弯曲、没有失败,主 Cobb 角平均绝对误差 5.13 度 [4.55, 5.74]。TotalSegmentator2D 失败 1 张、其余 6.38 度;PAXray 失败 7 张、24.94 度;FluoroSAM 失败 42 张、31.82 度。分层误差为低 2.08 度、中 4.12 度、重 7.50 度。论文把 5.13 度与文献中观察者之间大约 6 到 7 度的变异对照,并写 61% [55, 67] 的估计落在 5 度以内、88% [83, 92] 落在 10 度以内(第8页)。这只说明该研究集上的测量误差,不是临床读片一致性试验,更不是批准的测量器械。
- 配准同样是研究基准。手动正位初始化的起始中位误差 324.5 毫米,粗失败率 100%。只优化图像相似度时中位 mTRE 仍有 335.3 毫米,粗失败率 86.4%。加上 FleXray 掩码的 Chamfer 项后,中位误差降到 1.2 毫米,粗失败率 12.7%(第8–9页)。用基础模型初始化时,起始中位 76.6 毫米;图像细化后粗失败率 7.0%,仍有 8 例误差在 93 到 1,628 毫米。Chamfer 项把这 8 例都收到 10 毫米以下,总粗失败率 3.3%,最差 21 毫米。两边都成功的 198 帧上,中位 mTRE 为 1.01 与 1.04 毫米(第9页)。
- 少样本只说明迁移实验。MTDDH 用 1% 训练数据,即 6 名患者时,微调后的 FleXray 平均 Dice 0.896 [0.892, 0.900],随机初始化 nnU-Net 为 0.867 [0.852, 0.879],髂骨 0.948 对 0.907。BTXRD 在约 10% 数据、约 130 例时 AP50 为 23% 对 7%,差值 16 个百分点 [11, 22];1%(13 例)为 5% 对 0.4%。该检测集的测试图都含肿瘤,不含正常片,因此不估计正常片上的特异性(第10、28页)。
阅读时需要注意
- 定量评测受可用真值数据集数量限制。没有任何一项定量实验使用带有大量临床文字叠加的X光,尽管这种文字在真实片子上很常见(第12页)。
- 数据引擎继承 CT 来源的偏差:以仰卧成人为主,肢体常常在视野外。真实肢端X光只占训练迭代的大约 4%,能补一部分,但没见过的采集几何仍会失败(第10、12页)。
- 病变、植入物和手术器械没有在源 CT 已有内容之外被显式合成,严重创伤和其他强烈分布外样本会失败(第12页,Fig.12)。生成式编辑本身也可能改解剖,所以才需要丢掉大约 4% 的增强 DRR(第3页)。
- LowerLimbs 只有 8 张测试图,Dice 区间 0.715 到 0.931,很宽。PedsTorso 只有 12 张。DeepFluoro 的角度曲线来自两名留出受试者。胸部成人片上与专用模型的差距最小,VinDr-Rib 上 PAXray 数值更高(第28–29页)。
- Cobb 角、配准和肿瘤检测都是离线研究协议。模型没有被证明可以进入临床工作流,也不能替代放射科医生的判断。预印本未经同行评审。项目页上的代码、模型、数据和演示本次没有逐项打开复核。
关联工作
- 从分割 CT 渲染 DRR 的前作通常使用单一投影模型,平行束或锥束,并且在训练前渲染好有限集合。评测也多停在胸部,少数涉及骨盆。FleXray 把在线可变几何和离线生成式外观放在一起,并为每个结构独立抽样衰减,而不是只扰动椎体和肋骨(第10–12页)。
- PAXray 与 TotalSegmentator2D 是按部位或标签集训练的通用分割器,FluoroSAM 依赖提示和点击。nnU-Net 在本文里是每个评测集自己的域内上界。附录还把 SAM2 的四种 Hiera 编码器全量微调后接线性头,与同一数据引擎上的 U-Net 比较,没有看到显著优势(第12、29页)。
- 下游协议分别接在 AASCE 的 Cobb 角、xvr 的二维/三维配准,以及 MTDDH、BTXRD 的少样本分割或检测上。论文的主张是同一套解剖概率图可以变成测量、优化项或初始化,这些主张的证据范围就是上述研究集(第8–10页)。