快速导读:差一个像素若跨过视觉配置边界,答案比邻近的等幅缩放更容易翻转;不少错误里目标仍然可读,显式引导能把其中一大部分原答案找回来。
这篇只有六页的预印本讨论一个很具体的现象:视觉语言模型已经答对的题,图像只改一个像素,答案却可能翻转。作者认为动态分辨率模型内部有一道离散开关,叫做视觉配置,包括分块数、视图数和视觉 token 网格。输入尺寸跨过配置边界时,同样幅度的小缩放比不跨边界的邻近缩放更容易把对错换掉。
更反直觉的是后一半。配置变了以后答错,不代表目标已经读不出来。把出错时送进语言模型的视觉表示锁住,再用字段或位置去引导阅读,300 个此类错误里有 178 个仍能完整转写出目标,占 59.3%(第5页图3)。把模型自己的转写送回原问题,可以恢复一部分答案;若再允许用标注选择记录,178 个可读目标里恢复 173 个,即 97.2%。这个比例不能当成一个自动系统的准确率。
英文题目:Reading Right, Answering Wrong: How Visual Configuration Changes Affect Evidence Use in VLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.25770
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视觉问答、文字识别和文档理解都要在有限计算里保住细节。近期模型用动态分辨率按输入尺寸决定内部图像尺寸、分块和 token 网格。作者把这些处理选择叫做视觉配置,把切换发生的尺寸阈值叫做视觉配置边界。已有评测已经表明,分辨率、空间变换和重采样会让结果波动;填充甚至可以在不增加图像内容时改变准确率,计数失败也会在图案对齐 patch 网格时周期出现。
这些结果还没有回答一个更窄的问题:跨过配置边界的那一个像素,是否比附近一次保持配置不变的缩放带来更多正确性翻转。因为跨边界同时改变了像素和配置,只比较跨不跨还不够,必须再做固定图像只改配置、固定配置只改图像的对照。东北大学和 NiuTrans 的这篇 arXiv:2609.25770 就是按这个顺序写的。它是预印本,未经同行评审,也没有随文给出独立代码或项目页,后者应标为待核验。
全文用三个问题组织。第一,跨边界的小缩放是不是更不稳定。第二,由此产生的错误里,模型是丢失了目标,还是没有在回答时用上仍可读的目标。第三,字段线索和模型自己的转写能不能把原答案找回来。图1用 MiniCPM-V-4.5 的一个 TextVQA 例子把这三步串起来。
核心创新
- 用差一个像素的跨边界配对和配置不变的邻近对照,度量配置边界上的超额正确性翻转。
- 固定图像只改配置、固定配置只改图像,把像素变化和完整视觉配置拆开。
- 在出错的同一视觉表示上做引导阅读,并用 LLaVA-NeXT 的注意力敲除比较原问题与引导阅读对目标区域的依赖。
- 用字段线索和模型自己的转写做引导回答,并分开报告不含标注选择和含标注选择的累计恢复。
方法概览
原生配置由默认预处理按尺寸决定。跨边界的一对和邻近对照都只差一个像素的高或宽;对照两侧配置相同。正确性翻转率 CFR 是对错发生变化的比例,Δ 是跨边界 CFR 减去对照 CFR。进一步在固定图像时只改配置,或固定配置时只改图像。引导阅读锁定出错时的视觉表示 Z_c(I),不给参考答案。LLaVA-NeXT 上做目标注意力敲除,并用同等数量的非目标 token 作对照。引导回答由答案核对、目标提示、先读后答、再按标注选择记录或摘录逐级加码。
- 原生配置就是默认预处理按图像宽高自动选中的配置。一对跨边界图像的高或宽只差一个像素,两侧原生配置不同,并按视觉 token 或分块/视图数分成 Low 和 High。Qwen 按 token 数区分,其他家族按分块或视图数区分。邻近对照也只差一个像素,但两侧配置相同,并且匹配跨边界一对中的某一侧(第3页)。
- 正确性翻转率 CFR 是 N 对样本中对错发生变化的比例。边界超额 Δ 等于跨边界 CFR 减去对照 CFR,单位是百分点(第3页公式1和2)。每个跨边界图像还会在 Low 和 High 下各评一次。
- Z_c(I) 表示图像 I 在配置 c 下送给语言解码器的全部视觉嵌入。固定 I、改变 c,测的是配置;固定 c、改变 I,测的是像素。两种对比各自再对两个方向取平均(第3页)。
- 证据分析只保留那些固定图像、只改配置就能把错误改回正确的样本。引导阅读继续使用导致错误的那个 Z_c(I),要求模型阅读图像内容,必要时加上字段描述或位置,但不提供参考答案。目标可读是指转写完整,包括必要的符号和单位(第3页)。
- 注意力敲除只用于视觉 token 能映射回图像区域的 LLaVA-NeXT。在提示处理和生成全程,阻断文本对目标区域视觉 token 的注意,并在同一视图里对同等数量的非目标 token 做对照。原问题 Q 看答案内容是否变化,引导阅读 R 看是否失去完整转写,两者都减去非目标对照的效应(第3、5页)。
- 概率分析把未敲除时生成的文本固定住,比较目标敲除和非目标敲除造成的平均 token 对数概率下降,差记为 d。交互 J=(d_GQ-d_BQ)-(d_GR-d_BR),用来比较从正确配置 G 到错误配置 B 时,原问题和引导阅读哪一个更失去对目标的依赖(第3页公式3)。
- 引导回答按四步累计,而不是四套互不重叠的测试。答案核对之后,目标提示指向标注字段或位置;先读后答让模型先转写字段、描述图像或更仔细地读目标,再用这段输出回答原问题;最后一步用参考字段值挑选转写最完整的整段记录,或用标注从模型自己的文本里选摘录。参考值只参与选择,不替换模型写出的内容(第4页)。
逐图理解论文
一个球衣号码的翻转
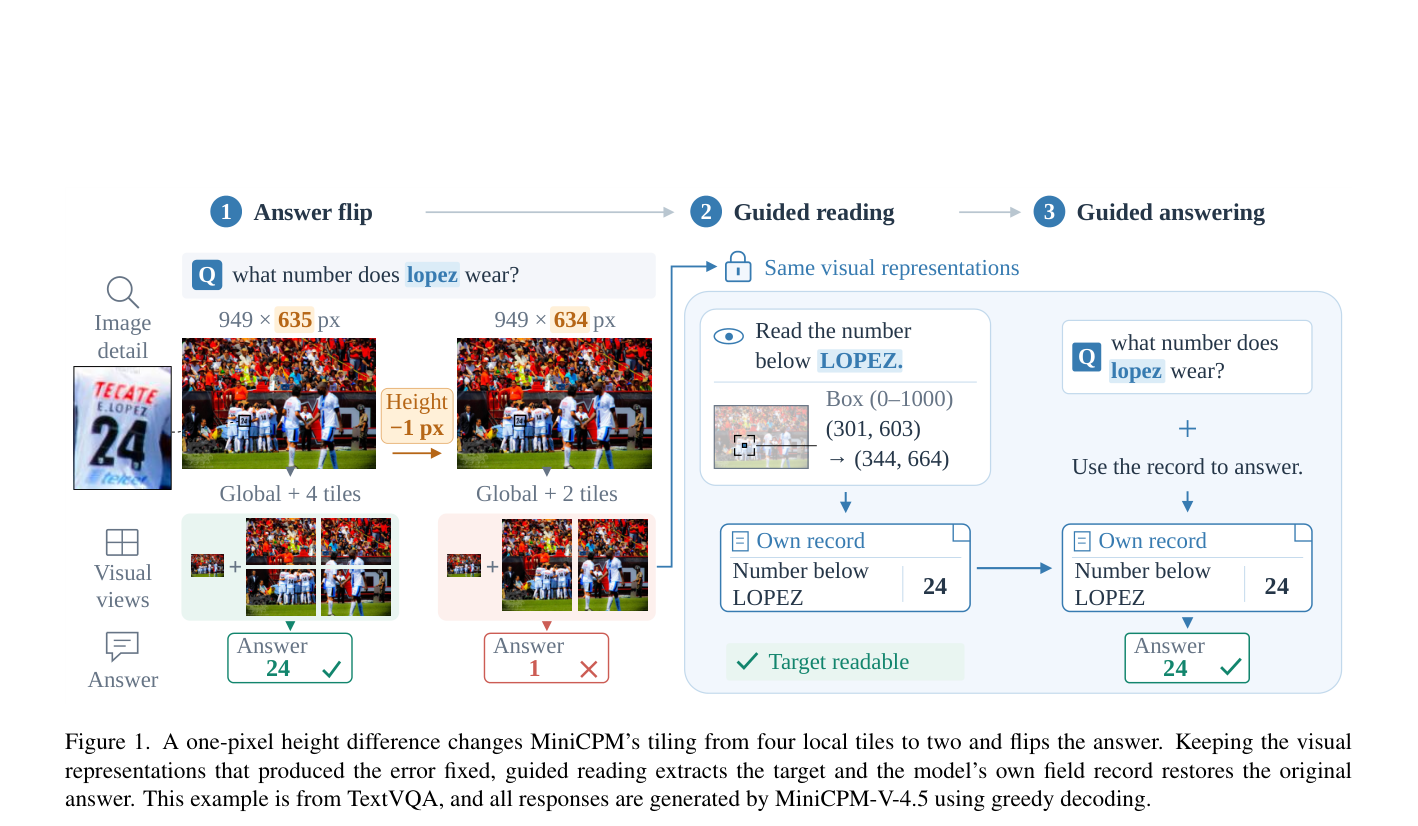
图从左到右是答案翻转、引导阅读和引导回答。左侧 949×635 的图像走全局视图加四块局部图,贪心答案是 24,标成正确;高度减 1 像素变成 949×634 后,局部视图剩两块,答案变成 1。右侧锁住的是这份出错的视觉表示:按 LOPEZ 下方和给定框去读,模型自己记下 24,再把记录交回原问题,答案回到 24。例子来自 TextVQA 和 MiniCPM-V-4.5。
把像素和配置拆开
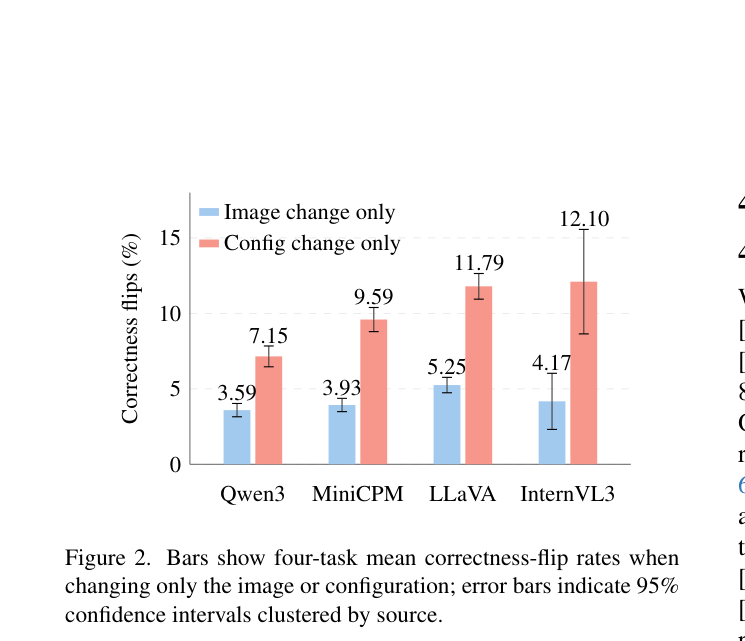
四组柱是四个家族代表的四任务平均正确性翻转率。蓝柱只改图像,红柱只改配置。可读数值是 Qwen3 的 3.59 对 7.15、MiniCPM 的 3.93 对 9.59、LLaVA 的 5.25 对 11.79、InternVL3 的 4.17 对 12.10,单位是百分比。误差线是按来源聚类的 95% 区间。InternVL3 的红柱区间明显宽于其他三组,和它较小的样本量一致。
读得对,用得少
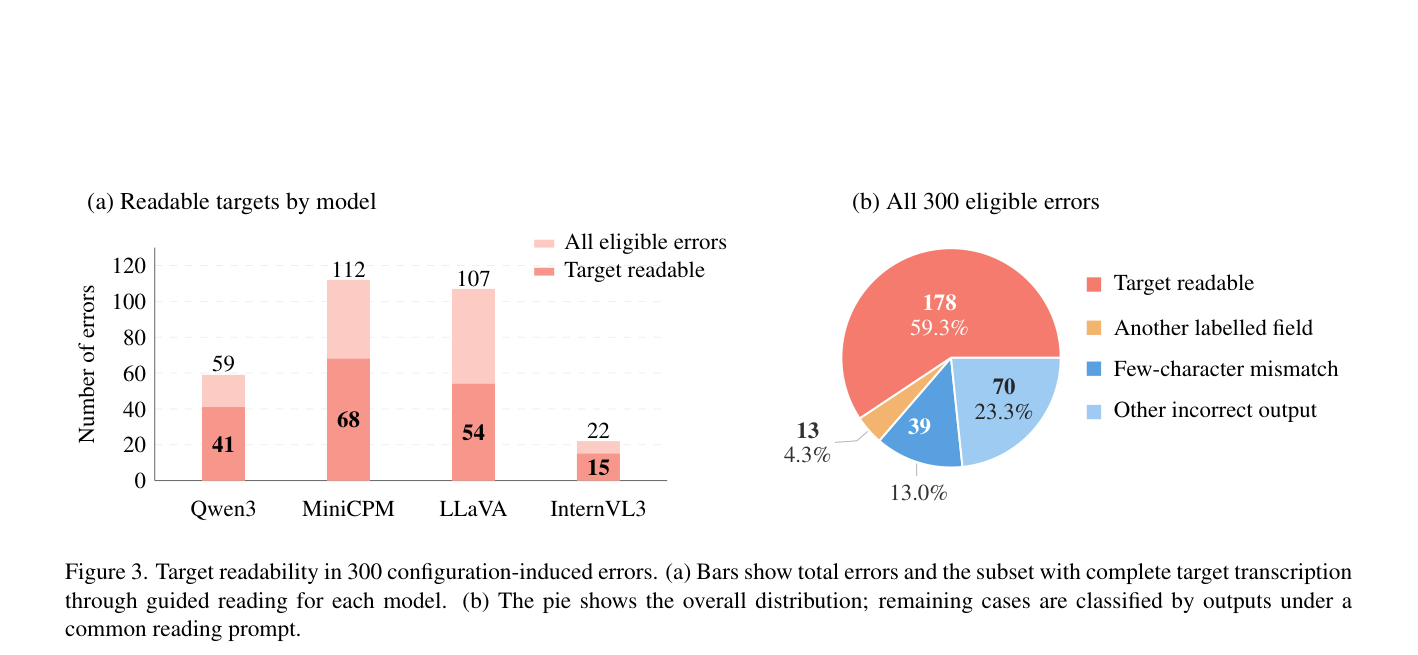
左图每个模型有总数和可读子集:Qwen3 59 与 41,MiniCPM 112 与 68,LLaVA 107 与 54,InternVL3 22 与 15。右图把 300 个错误分成目标可读 178(59.3%),以及另一个已标注字段 13(4.3%)、少数字符不匹配 39(13.0%)、其他错误输出 70(23.3%)。这里的 Qwen3、MiniCPM、LLaVA、InternVL3 是四个家族代表,不是全部七个检查点。
实验如何设计?
- 七个检查点是 Qwen3-VL-8B、MiniCPM-V-4.5、LLaVA-NeXT-7B、InternVL3-8B、Qwen2.5-VL-7B、InternVL3.5-8B 和 Qwen3-VL-32B。前四个是图2、图3、表2和表5–6里的家族代表(第4页)。
- 四个任务是 VQAv2、TextVQA、DocVQA 和 ChartQA。字段问题还用到 Visual-CoT 中的 DocVQA、TextVQA、SROIE 和 InfoVQA。主比较为贪心解码,长度上限 96 token(第4页)。
- 判分规则:VQAv2 和 TextVQA 要求 VQA consensus 不低于 0.6,DocVQA 用归一化精确匹配,ChartQA 允许 5% 数值容差。区间是按来源聚类的 95% bootstrap,任务和检查点均值按等权计算(第4页)。
- 表1的每任务样本量:Qwen3-8B、MiniCPM、LLaVA 为 512;Qwen2.5 和 Qwen3-32B 为 256。两个 InternVL 检查点只有 95、46、30、22,分别对应四个任务(第3页)。
- 图3和表5–6使用 300 个经过核验的配置诱发错误。恢复表统计的是任一条件命中即计一次的累计数,并包含对子集的后续追问,因此不是某一个提示词单独跑完全集的准确率(第4–5页)。
关键结果与论文证据
- 表1几乎所有模型—任务组合的 Δ 都为正,总均值 +5.59 个百分点。DocVQA 的任务均值最高,为 +7.32;VQAv2 最低,为 +3.84。InternVL3-8B 的模型均值 +10.47 最大,但多个单元格没有 †,不能把它读成每一格都排除了零(第3页)。
- 图2把像素和配置拆开后,四个家族都是只改配置的翻转率更高:Qwen3 从 3.59% 到 7.15%,MiniCPM 从 3.93% 到 9.59%,LLaVA 从 5.25% 到 11.79%,InternVL3 从 4.17% 到 12.10%。正文给出的差距是 3.56–7.93 个百分点,与这些柱值之差一致(第4页)。InternVL3 的误差线明显更长。
- 表2里,强制两侧都用 Low 或都用 High,不一致相对原生处理下降。MiniCPM、LLaVA、InternVL3 的 High 把准确率提高 3.03、2.00、0.70 个百分点,代价是 token 或分块大约增加 37.6%、24.0%、44.2%。Qwen3 的 token 只变约 3.4%,Low 和 High 的准确率却是 -0.34 和 -0.02。共享配置更稳,但不自动更准(第4页)。
- 图1的例子来自 TextVQA,MiniCPM-V-4.5 贪心解码。问句是球衣号码。949×635、全局视图加四块局部视图时答 24;高度减到 949×634、变成两块局部视图时答 1。引导阅读仍使用答错时的视觉表示,提示读取 LOPEZ 下方的数字,框由 (301, 603) 到 (344, 664),模型自己的记录写出 24,再把这份记录送回原问题后答案回到 24(第2、4页)。
- 300 个错误的引导阅读结果是:目标完整可读 178 个(59.3%)。柱状图分模型为 Qwen3 59 个中的 41 个、MiniCPM 112 个中的 68 个、LLaVA 107 个中的 54 个、InternVL3 22 个中的 15 个,加总就是 178。饼图其余三类按图例为另一个已标注字段 13(4.3%)、少数字符不匹配 39(13.0%)、其他错误输出 70(23.3%)(第5页图3)。
- LLaVA-NeXT 的敲除在减去非目标效应后,原问题对正确配置的影响是 82.1%,对错误配置只有 38.5%;引导阅读在两种配置上是 71.8% 和 74.4%,几乎没有拉开(第5页表3)。对数概率交互在全文和关键内容上分别为 +0.451 和 +1.596 nats,两个 95% 区间都不含零(第5页表4)。
- 表6的新增恢复依次是 33、32、82、26,累计为 18.5%、36.5%、82.6% 和 97.2%,分母都是 178。最后一步的 † 表示含参考协助的选择。表5按模型是 39/41、67/68、52/54、15/15。这 173 例等于全部 300 个错误的 57.7%(第5页)。
- 因此论文的结论不是模型在错误配置下丢失了像素,而是原问题没有稳定调用仍可读的证据。显式说明要读什么,可以把目标对生成的影响拉回来。自动、无需标注的恢复还没有被证明(第6页)。
阅读时需要注意
- 97.2% 依赖逐步加码后的并集,最后一档还用标注选择模型自己的哪一段转写。表6明确这不是单一程序的准确率,结论也把可靠的自动恢复留成未解决。
- 可读目标只占 59.3%。另外约四成错误在共同阅读提示下表现为读到别的字段、差几个字符或其他错误输出,不在 97.2% 的分母里。
- InternVL 的每任务样本只有几十个,图2的区间很宽,表1也有未标 † 的正值。不能把 +10.47 的均值理解成每一项都同样稳定。
- 敲除证据只有 LLaVA-NeXT。一个像素的局部边界也不能直接外推成所有分辨率下的稳健性。论文只有六页,且没有可核验的独立代码或项目页。
关联工作
- Res-Bench、VLM-RobustBench 和 patch 网格计数失败说明分辨率稳健性和视觉处理方式有关。本文补的是跨边界与不跨边界的配对,以及固定图像后的配置干预。
- NaViT、FlexiViT、Qwen2.5-VL、LLaVA-UHD 和 MiniCPM-V 解释了配置为什么会离散跳变。Qwen 的 token 变化只有约 3.4%,分块模型则可到百分之几十,所以不同家族的 High 配置成本不一样。
- Set-of-Mark 和 ViP-LLaVA 提供字段或位置提示这一路先验。本文的恢复实验把这类提示和模型自己的转写结合起来,并承认最完整的一档使用了标注选择。
- Seeing but Not Believing 与 Attention is not Explanation 是敲除实验的方法前提:看见或注意到某区域,不等于回答依赖它。作者因此同时报非目标对照和概率下降。
- FixRes、SNIP 和 Clean-FID 属于更早的分辨率、采样和评价流程文献。它们说明问题不新,但没有直接测量 VLM 的配置边界。