快速导读:GTR 用无 softmax 的门控线性递推、四方向扫描和 Spatial SwiGLU 做单尺度骨干,只蒸馏教师最后一层 patch 特征,再换任务头覆盖六种密集预测。
GTR 要回答的是:去掉全局 softmax 之后,线性递推还能不能同时保住密集预测的精度,并把高分辨率下的显存和延迟真正降下来。它的骨干只有一个尺度,十二层都做门控线性注意力;每一层只沿一个方向扫描,四层一轮换完从左到右、从右到左、从上到下、从下到上。局部关系不靠位置编码,而靠 Spatial SwiGLU 里的 3×3 深度卷积。
训练上它也不堆蒸馏损失。冻结的、已经按检测任务改过的 DINOv3 教师和学生看同一张整图,只把学生最后一层 patch 特征投影到教师维度,再用平方 ℓ2 对齐。随后同一套骨干分别接上检测、实例分割、姿态、旋转框、语义分割和单目深度的任务头。带 Objects365 预训练时,GTR-L 在 COCO val2017 上达到 58.9 box AP,RTX 4090 上编译 FP16、batch one 的中位延迟是 1.908 ms(第6页)。这个数字不能脱离预训练来读。
英文题目:GTR: Gated Token Recurrence for Efficient Dense Prediction
论文出处:arXiv 每日论文精选 · arXiv:2609.26590
原始论文:PDF / 论文页面
这篇论文解决什么问题?
密集预测要把每个空间位置都算清楚,输入一加大,token 数就上去。softmax 注意力对 token 数是平方开销,所以高分辨率首先挤的是显存和吞吐,而不只是纸面精度。第2页把问题收成一句:线性注意力能不能做成通用视觉骨干,既在多种密集预测上保持准确,又把理论上的线性复杂度变成端侧硬件上的实际收益。
已有工作各自覆盖了一块。EfficientViT 说明线性注意力可以做端侧语义分割,ViG 用门控线性递推做过检测和分割。它们还没有证明同一套单尺度设计可以换头走到六种任务,并且在 RTX 4090 和车载平台上给出统一测法的延迟。另一边,把 softmax ViT 蒸馏成线性模型时,ViT-Linearizer 要中间层匹配再加掩码预测,ViT-AdaLA 要先对齐注意力模块。GTR 想验证:最终 patch 特征上的一个平方 ℓ2 是否就够把教师的检测表征交过来。
作者单位包括滴滴国际业务、滴滴研究、Intellindust AI Lab、中科院自动化所和港科大(广州)。论文是 arXiv:2609.26590 预印本,未经同行评审。项目页和代码仓库可以打开,但仓库星标和更新日期是外部核验,不是论文里的实验指标。
核心创新
- 单尺度、无 softmax 的十二层骨干:每层一次方向扫描,四方向沿深度轮换,长程上下文复杂度对 token 数线性。
- Spatial SwiGLU 用 3×3 深度卷积补上递推缺少的局部、非因果混合,从而去掉显式位置编码。
- 跨架构蒸馏只对齐最终 patch token:一个线性投影加一个平方 ℓ2,没有掩码,也没有中间层损失。
- 推理专用分块 GLA 算子,以及 DRIVE AGX Thor 上的 TensorRT 图—核协同部署。
方法概览
输入变成 stride-16 的 patch 网格,十二个块分辨率不变。每块只做一次 key-only GLA 扫描,方向在从左到右、从右到左、从上到下、从下到上之间轮换。Spatial SwiGLU 在 value 分支上用 3×3 深度卷积混合邻居,不用显式位置编码。检测从第 4、8、12 块取特征,做成 stride 8/16/32 的轻量金字塔,再交给 query 解码器。蒸馏时,冻结的检测向 DINOv3 教师和学生看同一张整图,学生最后一层特征经线性投影后用平方 ℓ2 对齐。推理使用分块 CUDA 算子;车载端再接入 TensorRT。
- 骨干从 RGB 图像抽出 stride-16 的 patch,token 数 L=HW/16²,十二个块都保持这个分辨率。检测需要的多尺度不在骨干里做,而在后面的颈里做(第3页)。
- 每个块使用 key-only GLA。状态 S_t 等于保留门 γ_t 对上一状态的逐行缩放,再加上当前 k_t 与 v_t 的外积;输出是查询与该状态的乘积,再乘 d_k 的负二分之一次方。γ_t 由低秩投影、sigmoid 和温度 τ=16 得到,秩 r=16。value 侧衰减固定为 1。另外还有一个独立的输出门 r_t=SiLU(x_t W_r),乘在 RMSNorm 之后,不要和保留门混成同一个门(第3–4页)。
- 递推沿扫描顺序是因果的,所以一层只能收集一个方向。GTR 让相邻块轮换四种方向:从左到右、从右到左、从上到下、从下到上。每块扫完就把 token 放回原来的空间顺序(第4页,图2)。
- Spatial SwiGLU 负责局部混合。公式是 Y=[SiLU(X W_g) ⊙ DWConv3×3(X W_v)] W_o。value 先还原成二维网格,过 3×3 深度卷积,再排回序列;门控分支仍是逐 token 的。模型不使用显式位置编码(第4页)。
- 检测头从第 4、8、12 块取特征,用轻量投影做成 stride 8、16、32 的金字塔,再加 query 选择和 DETR 式解码器(第3页,图2)。四个尺度的嵌入维分别是 192、256、384、384,GLA 头数是 3、4、6、6,S-SwiGLU 扩展比是 4、4、4、6,解码器都是 4 层、300 个 object query(第25页表16)。
- 蒸馏教师是按 EdgeCrafter 做法、在检测上适配过的 DINOv3,前向时冻结。ECTeacher-S 监督 GTR-S,ECTeacher-B 监督 M/L/X。师生看同一张整图,只在最后一层 patch 上计算 L_align,即投影后学生特征与教师特征之差的平方 ℓ2,对 patch 取平均,不含非 patch token(第4–5页公式2)。图像池是 ImageNet-1K 加 COCO train2017,AdamW,全局 batch 2048,300 个 epoch(第25页)。
- 推理算子把 GLA 改写成块大小 C=64 的三段:并行计算块摘要,再只递推边界状态,最后各块独立出结果。它锁定 FP16、d_k=32、d_v=64、零初始状态,不改变递推本身。训练仍用 FLA(第5页)。
- 车载部署把标准 TensorRT 算子和 GLA、S-SwiGLU 的融合 CUDA 核放进同一张图,减少启动和显存往返,计算定义不变(第9页)。
逐图理解论文
分辨率一高就顶住
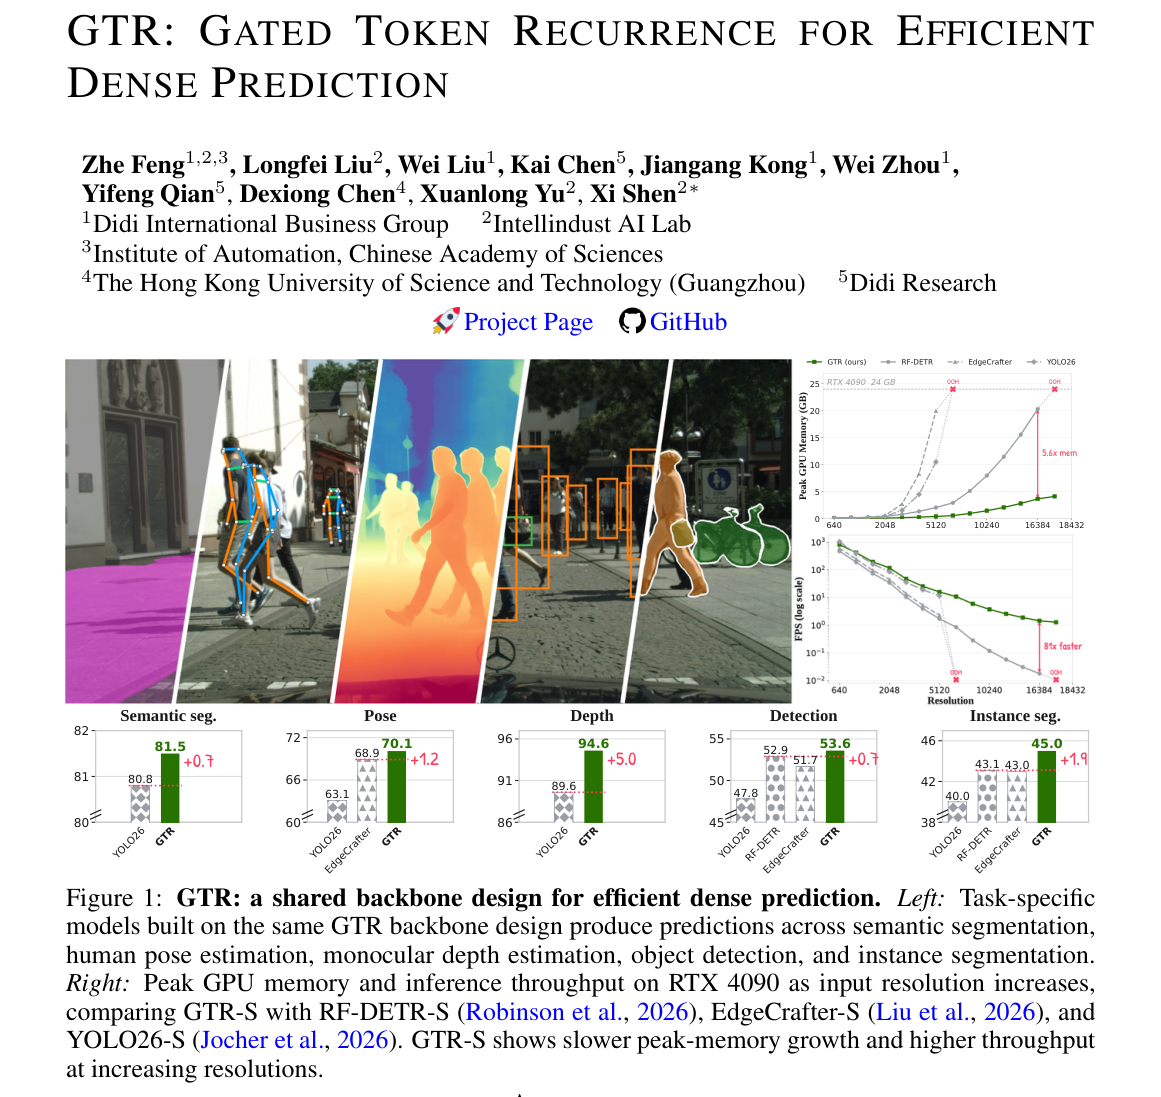
左半是同一骨干设计换头后的五类输出:语义分割、姿态、深度、检测框和实例分割。下面五根柱是 S 尺度,不是最大模型:语义分割 81.5 对 YOLO26 的 80.8,姿态 70.1 对 EdgeCrafter 的 68.9,深度轴上的 94.6 对 89.6 实际是 δ1 的百分显示,检测 53.6 对 RF-DETR 的 52.9,实例分割 45.0 对 43.1。右半两条曲线比较峰值显存和吞吐随分辨率的变化,GTR-S 更晚碰到显存墙;图上的 5.6× 和 8× 是高分辨率标注,对照在那里被标成 OOM。
递推补全局,卷积补邻居
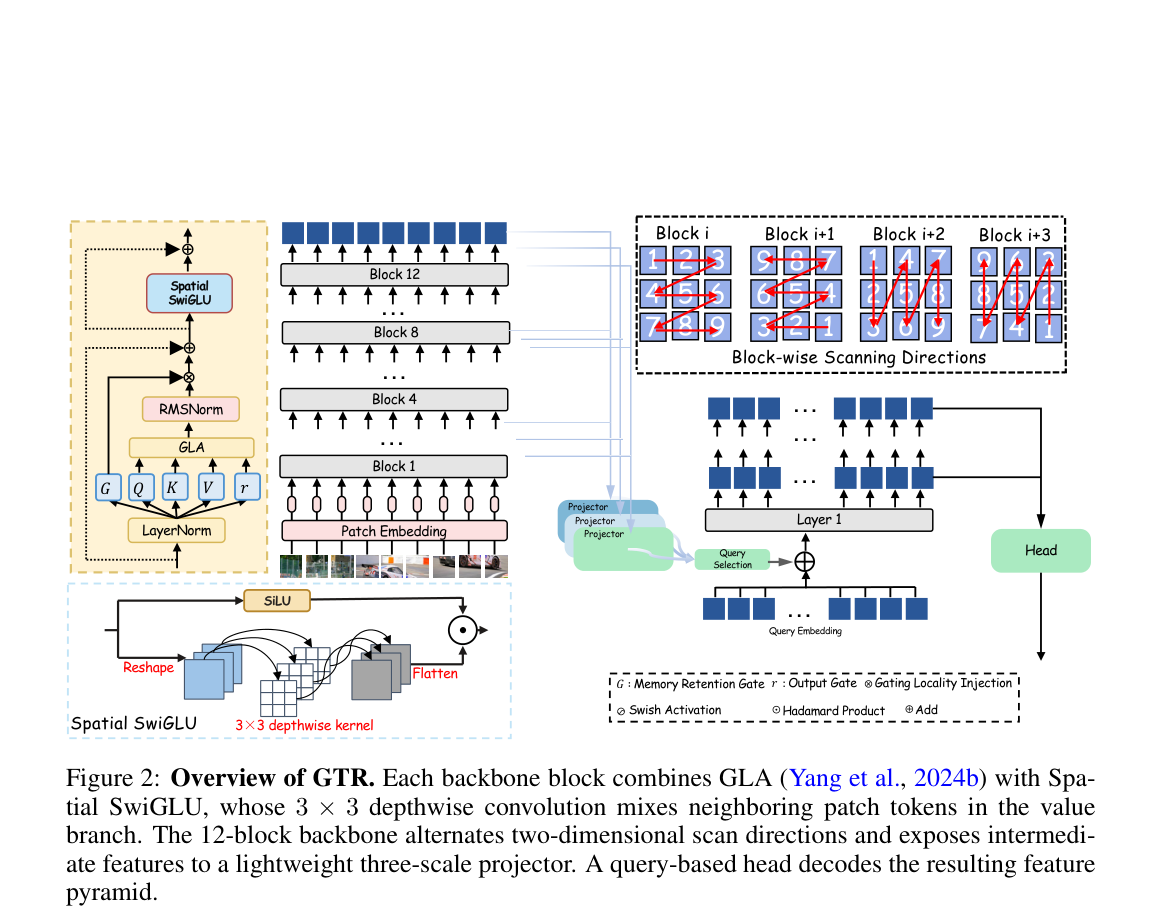
这是全文的结构总图,应作为主图来看。左侧一个块先做 LayerNorm,再分出保留门 G、Q、K、V 和输出门 r,GLA 之后接 RMSNorm 与 Spatial SwiGLU。下方放大图表明 value 会 reshape 成网格,过 3×3 深度卷积再展平,并和 SiLU 门控做逐元素乘法。中间十二层在第 4、8、12 块把特征送进三个 projector,右侧四格则是一层一个方向的扫描;最后才是 query 解码器。骨干本身没有多尺度,金字塔出现在颈里。
只对齐最后一层
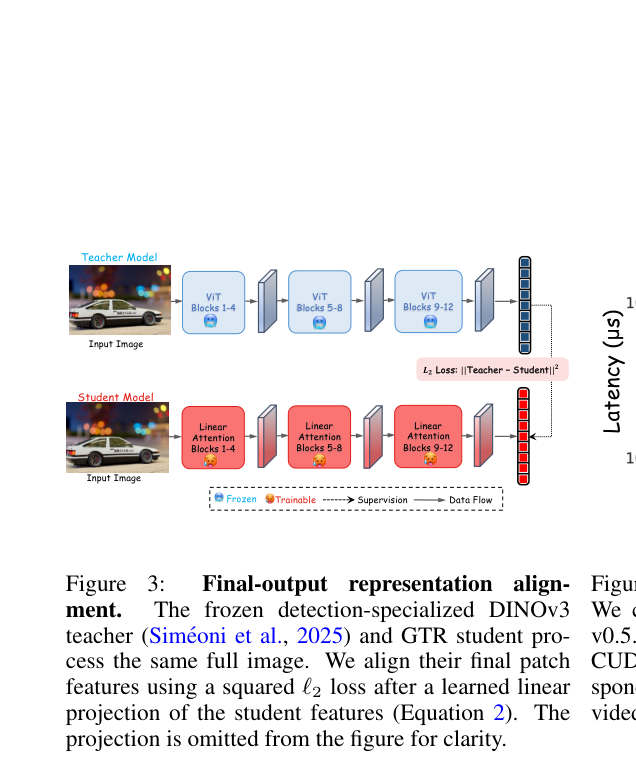
这张图只说明蒸馏监督放在哪里。上下两条支路吃同一张图,教师是冻结的 ViT,学生是可训练的线性注意力,两边都按 1–4、5–8、9–12 分成三段。损失画在最终 token 之间,写法是 ℓ2 Loss: ||Teacher-Student||²;正文补充学生侧还有一个线性投影,图中为了清楚省略了。图的右缘露出相邻延迟图的坐标残边,不要把它读成蒸馏结果。
实验如何设计?
- 检测主结果:骨干蒸馏之后,在 Objects365 上训练 36 个 epoch,再在 COCO train2017 上训练 30 个 epoch。表1的 epoch 列写 30,指的是 COCO 阶段。带 ‡ 的行跳过 Objects365。评估是 COCO val2017、640×640(第6页)。
- 延迟在 RTX 4090 上测量:FP16、batch one、torch.compile、CUDA Graphs,预热后取 CUDA event 的中位数。DETR 类模型量前向;需要单独后处理的方法另外加上 CUDA NMS。对照的精度来自原文,延迟在这套协议下重测。RF-DETR 使用它自己的尺度分辨率,不是 640(第6页表1说明)。
- 迁移任务各自训练,不共享一个多任务头。实例分割和姿态的部分对照带 Objects365 或 SAM2 伪掩码,表2用 † 标出;GTR 的实例分割数字不使用 SAM2 伪掩码(第6–7页)。深度用八个实测或伪标签数据源混合训练,不做 NYU 专用微调。
- 结构消融先用同一教师和图像池分别蒸馏,再走同一下游日程,检测一律看 COCO val2017(第8页)。
- 算子微基准是 RTX 4090、FP16、CUDA Graph,不含输出尾融合。端侧是 DRIVE AGX Thor 上的 FP16 TensorRT(第5、9页)。
关键结果与论文证据
- 带 Objects365 时,GTR-S/M/L/X 的 box AP 为 53.6/57.3/58.9/59.4,参数量 12.1/22.7/37.2/46.5M,计算量 33.8/62.6/106/130.2 GFLOPs,中位延迟 1.225/1.462/1.908/2.115 ms。四个尺度的 AP 都是表1本组里最高的(第6页)。
- GTR-L 的 58.9 AP、1.908 ms 同时好于同组的 RF-DETR-L(56.5 AP、1.968 ms)、YOLO26-L(54.3 AP、1.967 ms)和 ECDet-L(57.0 AP、2.730 ms)。GTR-X 的 59.4 AP、2.115 ms 对比 RF-DETR-X 的 58.6 AP、3.243 ms(第6页)。
- 去掉 Objects365 后 AP 降到 50.7/54.0/55.5/56.2,延迟不变。此时 GTR-S 的 50.7 低于 RF-DETR-S 的 52.9 和 ECDet-S 的 51.7,但 1.225 ms 仍快于 ECDet-S 的 1.652 ms(第6页)。
- 实例分割上 GTR-S/X 为 45.0/49.8 mask AP。GTR-X 延迟 2.472 ms,RF-DETR-Seg-X 为 3.311 ms,正文称低 25.3%。姿态上 GTR-S/X 为 70.1/75.5 keypoint AP,高于 ECPose 的 68.9/74.8,延迟也更低(第6–7页)。
- DOTA-v1.0 上 GTR-S/X 的 AP50 是 80.1/81.3,略低于 YOLO26-obb 的 80.9/81.7;X 尺度延迟 3.960 ms 对 5.085 ms。附录还写 GTR-X 比 RTMDet-R-l 高 0.8 AP50 且参数少 6.0M,比单尺度 Oriented-DETR(Swin-T)高 1.5 AP50 并快 3.9 倍;有逐类结果的检测器里,plane 和 harbor 的 AP50 为 89.5 和 84.5(第7、21页)。
- Cityscapes 上 GTR-S/X 为 81.5/83.6 mIoU。GTR-S 比 YOLO26-sem 的 80.8 高 0.7,但延迟 1.495 ms 慢于 0.758 ms。GTR-X 与 YOLO26x-sem 同为 83.6,参数少 20.0%,FLOPs 少 63.2%,中位延迟低 19.5%(第7、22页)。S/M/L 相对同尺寸 YOLO26-sem 的 mIoU 差是 0.7/1.0/0.3(第22页)。
- NYU Eigen 测试上,GTR 在两个尺度都提高 δ1、AbsRel 和 RMSE。表2只给出 δ1:S 为 0.946 对 0.896,X 为 0.954 对 0.933。GTR-X 延迟 2.158 ms,YOLO26-depth 为 2.730 ms。这些分数使用六视图和逐图 log-affine 拟合,不是未对齐的原始深度误差(第7、23页)。图1把 S 尺度 δ1 画成 94.6 对 89.6。
- 图1的 S 尺度柱状图还可与正文对上:语义分割 81.5(+0.7),姿态 70.1(相对 EdgeCrafter 的 68.9 为 +1.2),检测 53.6(相对 RF-DETR 的 52.9 为 +0.7),实例分割 45.0(相对 43.1 为 +1.9)。右侧曲线标注 GTR-S 显存增长更慢、吞吐更高,并在高分辨率端标出约 5.6× 显存和 8× 速度,同时把对照标成 OOM(第1页图,需与第6页的 640 延迟分开)。
- 蒸馏消融在不带 Objects365 的 GTR-S 上进行:最终 ℓ2 为 50.7 AP,ViT-Linearizer 在掩码率 0.5 时为 50.0,ViT-AdaLA 为 48.2,随机初始化只有 31.1(第8页表3)。50.7 与表1里不带预训练的 GTR-S 一致。
- S-SwiGLU 在 768² 上把 AP 从 53.9 提高到 55.1,1024² 上从 55.3 提高到 56.6,GFLOPs 只增加 0.2 和 0.5。GTR-L 四方向为 55.5 AP,水平双向 55.1,垂直双向 55.0,单向 54.4;单向若再换成可学习位置编码,降到 45.6。局部混合的影响大于再加两个扫描方向(第8页)。
- 十二层里换进三层 softmax,AP 仍是 55.4–55.6,参数仍是 37.2M,峰值显存仍是 0.19 GB,但 GFLOPs 从 106 增到 119,延迟从 1.908 ms 增到 2.094–2.117 ms(第9页表5)。这组 55.5 AP 对应不带 Objects365 的 GTR-L,不是 58.9。
- 分辨率从 640² 增到 1280² 时,GTR-S 的 AP 从 53.6 到 57.0,小目标 AP 从 36.4 到 42.4,延迟从 1.225 ms 到 2.529 ms,显存从 0.096 GB 到 0.249 GB。延迟约 2.06 倍,token 约 4 倍(第9页表6)。孤立算子在 1.6K token 上比 FLA v0.5.0 快 4.0×,256 和 16.4K token 上为 2.6× 和 6.4×(第5页)。
阅读时需要注意
- 58.9 和 59.4 这些标题级 AP 带有 Objects365 预训练。去掉之后,L 尺度 55.5 AP 并不是表1里最高的,S 尺度 50.7 也低于 RF-DETR-S 和 ECDet-S。
- 效率优势取决于尺度和任务。检测、语义分割和深度的 S 模型都慢于对应的 YOLO26 小模型;旋转框精度也略低。
- 和 RF-DETR 的延迟比较没有锁死同一输入分辨率。深度数字经过测试时多视图和对数仿射对齐,图5的融合还借用了激光雷达尺度。
- 这不是一个模型同时输出六种任务。推理核与训练核也不是同一条实现,端侧余弦相似度至少 0.9989,说明 FP16 部署接近 FP32 参考,但不是逐值相同。
- 论文为预印本。图1的 5.6× 与 8× 是曲线标注,不应写成 640 输入下的加速比。
关联工作
- EfficientViT 和 ViG 说明线性或门控递推可以做密集预测,但还没有这套跨六任务、并带统一边缘延迟的骨干。
- EdgeCrafter 提供了检测向 DINOv3 教师和 ECDet 基线。GTR 沿用教师适配,学生换成同质 GLA。
- ViT-Linearizer 与 ViT-AdaLA 代表多阶段跨架构蒸馏。GTR 用它们做同等教师、学生和 COCO 日程下的对照,而不是只在文字上比较流程。
- YOLO26 与 RF-DETR 是实时检测和多项像素级任务的强基线。GTR 在大尺度检测上同时看 AP 和重测延迟,在部分小模型和旋转框上并不占优。
- GLA 与 FLA 提供递推定义和训练核。本文的系统贡献是推理调度和 TensorRT 融合,不改变公式。