快速导读:浙大、西湖与百度提出 LeWAM:用冻结 I-JEPA 嵌入同时支撑动作生成与未来嵌入预测,再以 DemoDPO 做离线偏好精炼,0.4B 可训练参数在 RoboTwin 2.0 上平均成功率 92.28%。
World Action Model 想同时会出动作、又理解世界怎么变,但很多系统先把观察压进 VAE,再挂上大型视频扩散骨干。浙大、西湖大学与百度的 Xueji Fang、Boqiang Duan、Hua Wu、Jingdong Wang、Guo-Jun Qi 提出 LeWAM(Latent Evolving World Action Model,arXiv:2609.27455,预印本):冻结 I-JEPA 嵌入既作动作条件,也作未来状态目标,用约 0.4B 可训练参数在同一预测器里学动作与表征空间动力学,推理只输出动作。
作者还指出纯模仿会贴演示动作,却分不清好坏微小偏差;DemoDPO 用演示相似度在候选动作间做离线偏好精炼,不额外滚环境、也不手写奖励。摘要写 RoboTwin 2.0 平均成功率 92.28%,并在三项真实操作上报告更高任务进度。代码与权重入口写在 github.com/XuejiFang/LeWAM 与对应 Hugging Face 页;本次解读未复现。
这篇论文解决什么问题?
VLA 把视觉与语言直接映射到动作,泛化指令方便,却不显式建模动作如何改变场景。WAM 用未来视觉监督补这块,但近期动作中心 WAM 部署时又常去掉未来帧生成,只保留类 VLA 的动作推理。
矛盾在于:训练仍依赖视频扩散骨干从压缩 VAE 潜变量里挖特征,成本与可扩展性被视频生成预训练绑住。作者从信息论角度讨论重建式选择未必保留动作相关方向,并强调“信息是否还在”和“固定轻量头能不能抽出来”不是一回事。
已有编码器研究覆盖不全,或只把新表示当作 VLA 附加通道;潜空间世界模型多用于目标条件规划,而不是直接给同一动作头喂冻结表示。因此需要在同一预测头与配方下比较重建、对比、对齐与 JEPA 预测等目标。
核心创新
- 在同一轻量动作预测设定下系统比较冻结编码器,理论与实验都指向 JEPA 类预测嵌入优于压缩 VAE 潜变量,I-JEPA-Huge 在对照中最强。
- AdaFuse 与表征空间未来嵌入预测共用一个预测器,推理时去掉未来视觉生成,避免依赖视频扩散骨干。
- DemoDPO 从演示直接构造离线偏好对,把模仿学到的策略再往更接近成功演示的动作分布推。
方法概览
LeWAM 冻结 I-JEPA,用 AdaFuse 按通道融合多层 patch 嵌入作为当前观察;单一预测器同时做条件流匹配动作生成,以及在同一表征空间里对可学习 future query 做未来嵌入回归。注意力掩码阻止干净动作泄漏到动作预测,并让每个 future query 只看见对应时域的动作前缀。推理只生成动作。第二阶段 DemoDPO 用演示相似度在冻结参考策略的候选动作间构造偏好,离线精炼,不额外与环境交互、也不手写奖励。
- Fig.2(d) 把 LeWAM 画成:冻结 JEPA 编码当前帧得到嵌入,单一 WAM 块同时出动作与预测未来嵌入,损失对着未来帧的 JEPA 目标。它不同于 (a) 的 VDM 骨干联合出帧,也不同于 (b)(c) 那种 VLA 与单独世界模型分家、JEPA/DINO 只当旁路监督的结构。
- Fig.3 是实现细节。AdaFuse 对 L 层 patch 嵌入学通道维 logits,经 softmax 加权并 LayerNorm 后得到当前观察表示 Z0;未来目标 Zi 直接取冻结编码器在未来帧上的嵌入。动作块用条件流匹配:对干净动作加噪得到 A′_τ,预测速度场。
- 预测器吃序列 [Z0, 噪声动作, 干净动作, future queries],层内用 AdaLN、带 QK Norm 与 3D RoPE 的自注意力,再分出 action head 与 state head。掩码保证干净动作不泄漏进动作预测,且每个 future query 只能看见对应 horizon 的动作前缀。
- DemoDPO:冻结参考策略采样候选动作组,用与演示的相似度差异过滤 pair,在离线 DPO 目标下更新策略。正文报告 εpair=10^{-3}、β=5000、候选组大小 G=4 较稳。
逐图理解论文
表示瓶颈
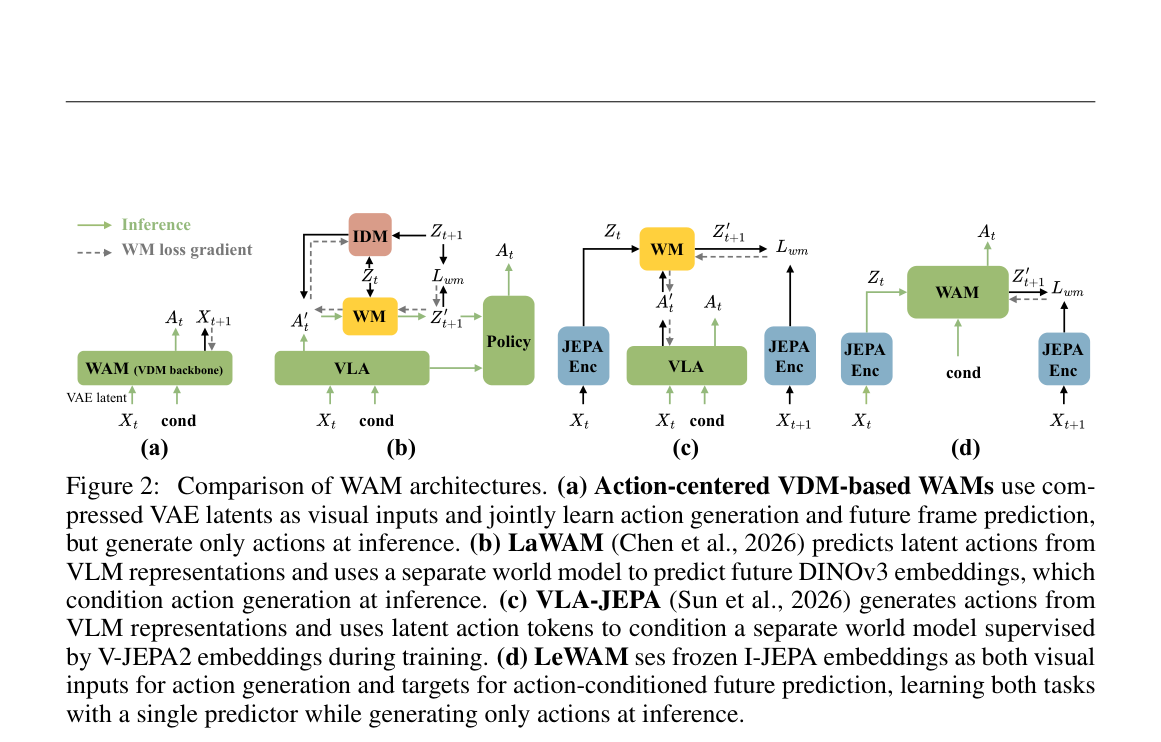
四格结构对照。(a) VDM-WAM 吃 VAE latent;(b) LaWAM 分 VLA/WM/IDM/Policy;(c) VLA-JEPA 用单独 WM 吃 JEPA 目标;(d) LeWAM 单块同时出 At 与未来嵌入。绿实线是推理,灰虚线是世界模型损失。
LeWAM 结构
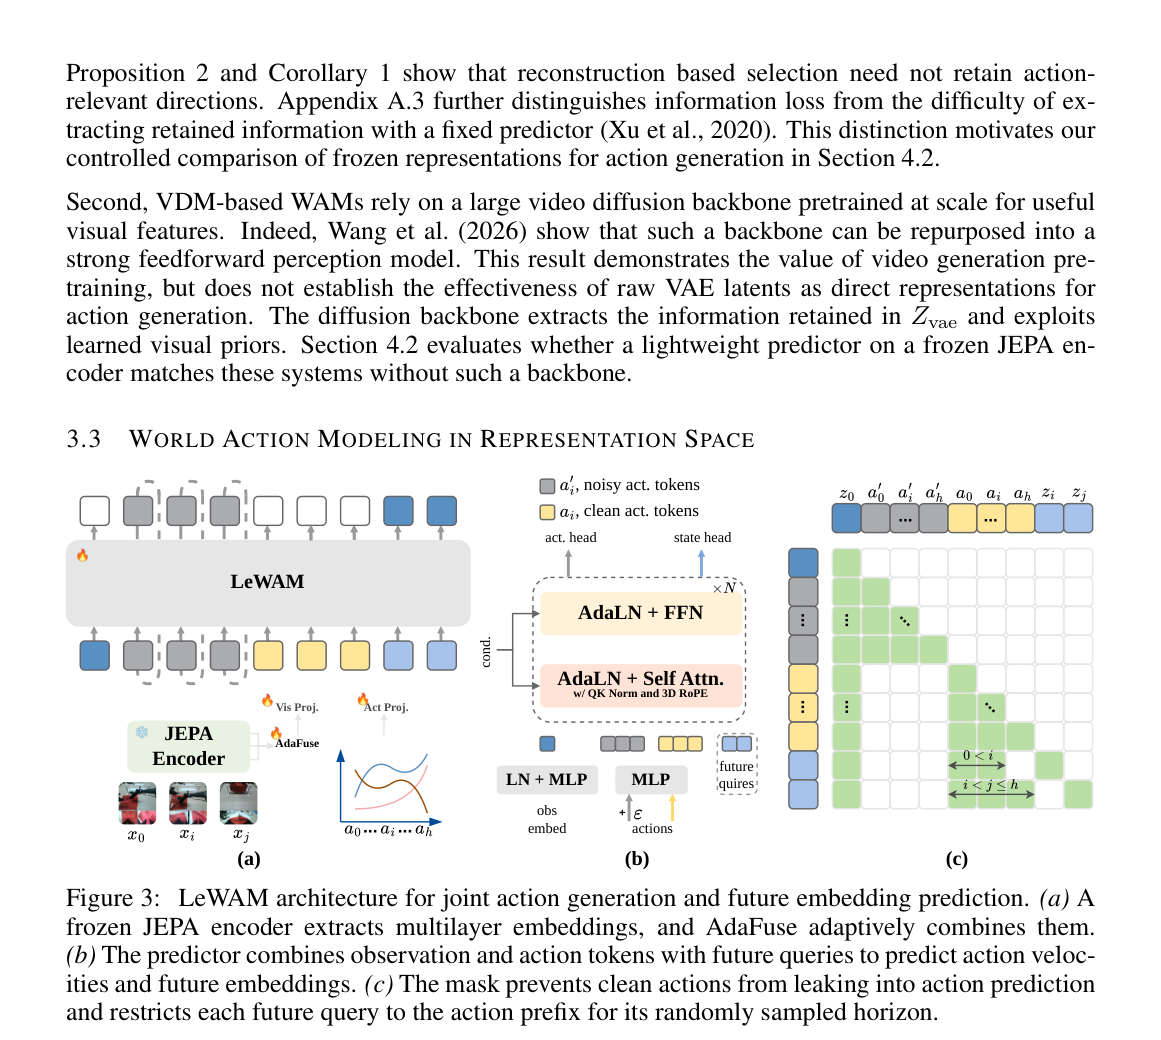
架构总图。左列冻结 JEPA 吃多帧观察,AdaFuse 融多层嵌入,Vis/Act Proj 后进入可训练 LeWAM 块;中列展开 LN+MLP、噪声动作 MLP、AdaLN 自注意力(QK Norm + 3D RoPE)与 FFN,以及 act/state 双头;右列注意力掩码标明哪些 token 可见。适合做特色图。
表内结果
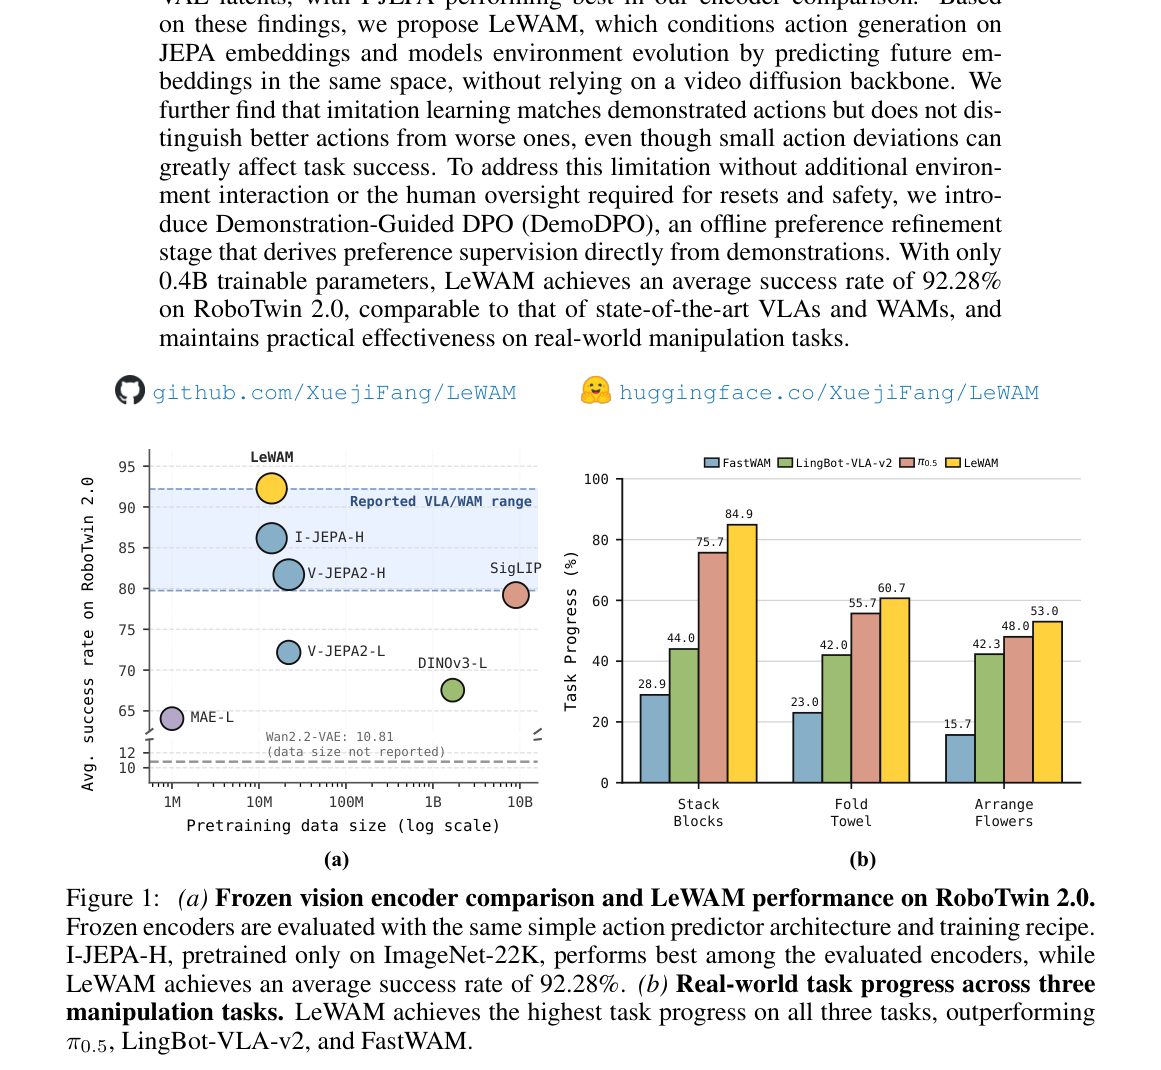
左散点:各冻结编码器平均成功率对预训练数据量,Wan2.2-VAE 虚线 10.81,LeWAM 标 92.28%。右柱:三真实任务进度,LeWAM 84.9 / 60.7 / 53.0。摘要区还写 0.4B 与 DemoDPO。
注意力与效率
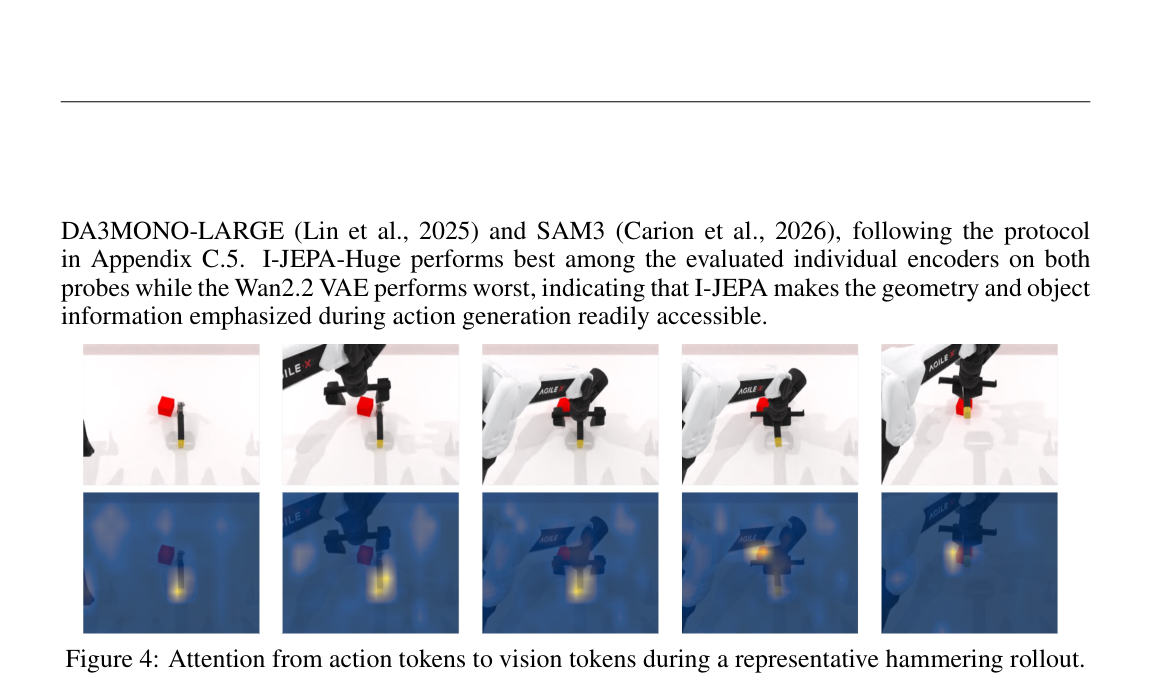
五帧敲击序列与对应注意力热图:关注点从红块工具转到黄柱目标。这是定性可解释性图,不是成功率表。
实验如何设计?
- 仿真主表在 RoboTwin 2.0 的 50 个任务上,干净与随机化设定各评 100 次/任务,报平均成功率。Table 1 的冻结编码器对照共用简单动作头;完整 LeWAM 变体与 VLA/WAM 基线在 Table 2。
- 探针:从训练轨迹每 episode 随机一帧,约 27,500 样本,8:1:1 划分,冻结视觉,用 DA3MONO-LARGE 深度与 SAM3 实例掩码作教师。
- 真实实验报告 Stack Blocks、Fold Towel、Arrange Flowers 的任务进度柱状图,对照 FastWAM、LingBot-VLA-v2、π0.5。效率表在附录 Table 3,测延迟与峰值显存。
关键结果与论文证据
- Fig.1(a):在相同简单头设定下,I-JEPA-H 明显强于 Wan2.2-VAE(表内平均 10.81)等对照,完整 LeWAM 标到 92.28%。Fig.1(b) 三真实任务上 LeWAM 进度分别为 84.9、60.7、53.0,均高于同图对照。
- Table 1:I-JEPA-Huge 平均成功率 86.17,深度与分割探针也最好;加 AdaFuse 到 86.88,并改善探针指标。
- Table 2:直接预测未来嵌入 87.02,高于流匹配 86.21 与 Action Only 86.17;再加 AdaFuse 到 90.69;DemoDPO 后到 92.28(clean 93.14 / rand 91.42)。同表 Fast-WAM 91.83、LingBot-VA 92.20、LaWAM 91.22。
- 八任务子集:同等 1000 次额外监督几乎不动(73.31→73.25),DemoDPO 到 76.63。附录 Table 3:LeWAM 在所列模型中延迟与峰值显存最低(Graph on 31.90 ms,1.988 GiB)。
- Fig.4 锤子敲击 rollout 上,动作 token 对视觉 token 的注意力随抓取—瞄准—击打迁移到工具与目标,支持“几何与物体信息可被动作头直接用到”的叙述。
阅读时需要注意
- 真实评测只有三项进度指标,样本量与任务多样性有限。
- 系统仍吃视觉自监督预训练;与“需要视频扩散骨干 / 额外具身预训练”的基线对比时,要分清省掉的是哪一段成本。
- DemoDPO 的偏好来自演示相似度代理,不是环境回报;阈值与候选集合会改变增益。
- 部署只出动作,训练期未来嵌入预测是否转化为可检查的想象能力,论文没有单独的在线规划评测。
关联工作
- Diffusion Policy / Octo 等说明可以不做显式世界模型也能出动作序列;WAM 路线则强调动态监督。
- LaWAM 与 VLA-JEPA 把潜空间预测和动作头拆开;LeWAM 的卖点是同一嵌入空间、同一预测器。
- π0.5 等大规模 VLA 仍是强基线;Table 2 显示 LeWAM 在更小可训练规模上进入相近平均成功率区间,但是否公平取决于预训练数据与具身 PT 标记。