快速导读:HelloWorld 是约 2B 参数的驾驶世界模型系统:从异质视频先验渐进特化到位姿/高精地图/3D框可控的七相机 RGB 生成,再经少步蒸馏与条件 LiDAR 分支,服务可交互仿真与可扩展反事实数据生成。
驾驶日志只能复现已经发生过的轨迹与交通局面,却回答不了“同一路口如果改走另一条自车轨迹、或替换另一种交通布局,传感器会看到什么”。生成式驾驶世界模型承诺补上这块反事实数据与可交互仿真能力,但落到工程上往往卡在四件事:场景够不够广、控制够不够准、多相机/激光雷达是否同场景一致,以及反复推演时算不算得起。
HelloWorld(arXiv:2609.28931,HelloWorld Team,项目页 https://helloworld-4d.github.io)把约 2B 参数的系统级方案对准这些要求:先从异质视频学到位姿条件的因果视觉动力学,再特化到七相机同步与高精地图/3D 框控制,最后用少步蒸馏和 RGB 条件 LiDAR 分支把“好看的视频”推成可部署的多传感器世界接口。
英文题目:HelloWorld: Towards Practical Applications of Generative Driving World Models
论文出处:arXiv 每日论文精选 · arXiv:2609.28931
原始论文:PDF / 论文页面
这篇论文解决什么问题?
孤立提升单帧画质并不能自动得到可用世界模型。交互仿真里未来观测不可见,每一步都必须基于已提交历史与外部条件生成;训练却常在真实历史上做,推理却吃模型自己滚出来的上下文,分布落差会在长程回滚中放大。
监督也是嵌套的:位姿可在更广的车队与通用视频上获得,标定多视角与结构化标注只存在于更小子集。若一上来只在稠密标注驾驶数据上训练,多样性受限;若只用通用视频,又缺少可操纵的几何语义接口。
能力表还显示另一条鸿沟:许多系统用低维动作或布局隐含运动,而不是独立可控的度量 6-DoF 自车位姿;同时具备多视角、结构化控制、因果自回归与少步推理的组合并不常见。
核心创新
- 渐进特化:从异质视频位姿先验到七视角同步,再到 HD map/3D box 结构化控制,同时保留因果观测接口。
- 把度量 6-DoF 自车位姿作为独立可控条件,支持同场景反事实左右转与非常规变道生成。
- 20→4 少步蒸馏(dCM/DMD)与解耦超分,兼顾交互式反复推理成本。
- 七视角 RGB 条件 LiDAR 分支,把观测空间扩展到几何传感。
方法概览
系统以块因果 RGB 生成器为核心:Stage-1 在车队与通用视频混合上学习位姿条件因果动力学;Stage-2 特化到标定七视角同步生成;Stage-3 引入高精地图与 3D 框等结构化场景条件。训练侧用上下文破坏与自回滚适应自生成历史。部署侧将 20 步因果教师蒸馏为 4 步学生,解耦超分提升分辨率,并以 RGB 条件的 LiDAR DiT 合成 range+intensity,必要时做时序径向残差整流。
- 任务形式化为块因果观测转移:在已提交历史与外部条件(文本、相机位姿、场景控制)下生成当前时间块的多视角观测,再更新历史。模型负责观测,不负责从控制指令推车辆动力学。
- 渐进三阶段:Stage-1 用 29 帧窗口在车队(约 35.1% 窗口)与通用视频混合上学习位姿条件因果基底;Stage-2 进入标定七视角同步;Stage-3 注入 HD map 与 3D box。嵌套关系可写为 D_ctrl ⊂ D_mv ⊂ D_pose。
- 生成骨干把自车几何经 Ray Encoder + AdaLN 注入,布局经 Control Tower 产生 VACE 残差,文本走 cross-attention;层内再叠加 per-view causal attention 与 neighbor cross-view attention,以共享场景状态约束环视一致性。
- 为对齐交互用法,训练引入上下文破坏与自回滚,让模型习惯不完美自生成历史。效率路径把 20 步 CFG=3 的 rectified-flow 教师蒸馏成 4 步 CFG=1 学生(dCM/DMD),并解耦超分(示意 480×832→1440×3328)。
- 模态扩展上,七视角 RGB 经图像编码器进入 LiDAR DiT,与噪声 LiDAR latent 联合去噪,解码为 range+intensity;再可用 Temporal RRN 等径向残差整流抑制深度渗色与波纹表面。
逐图理解论文
渐进特化
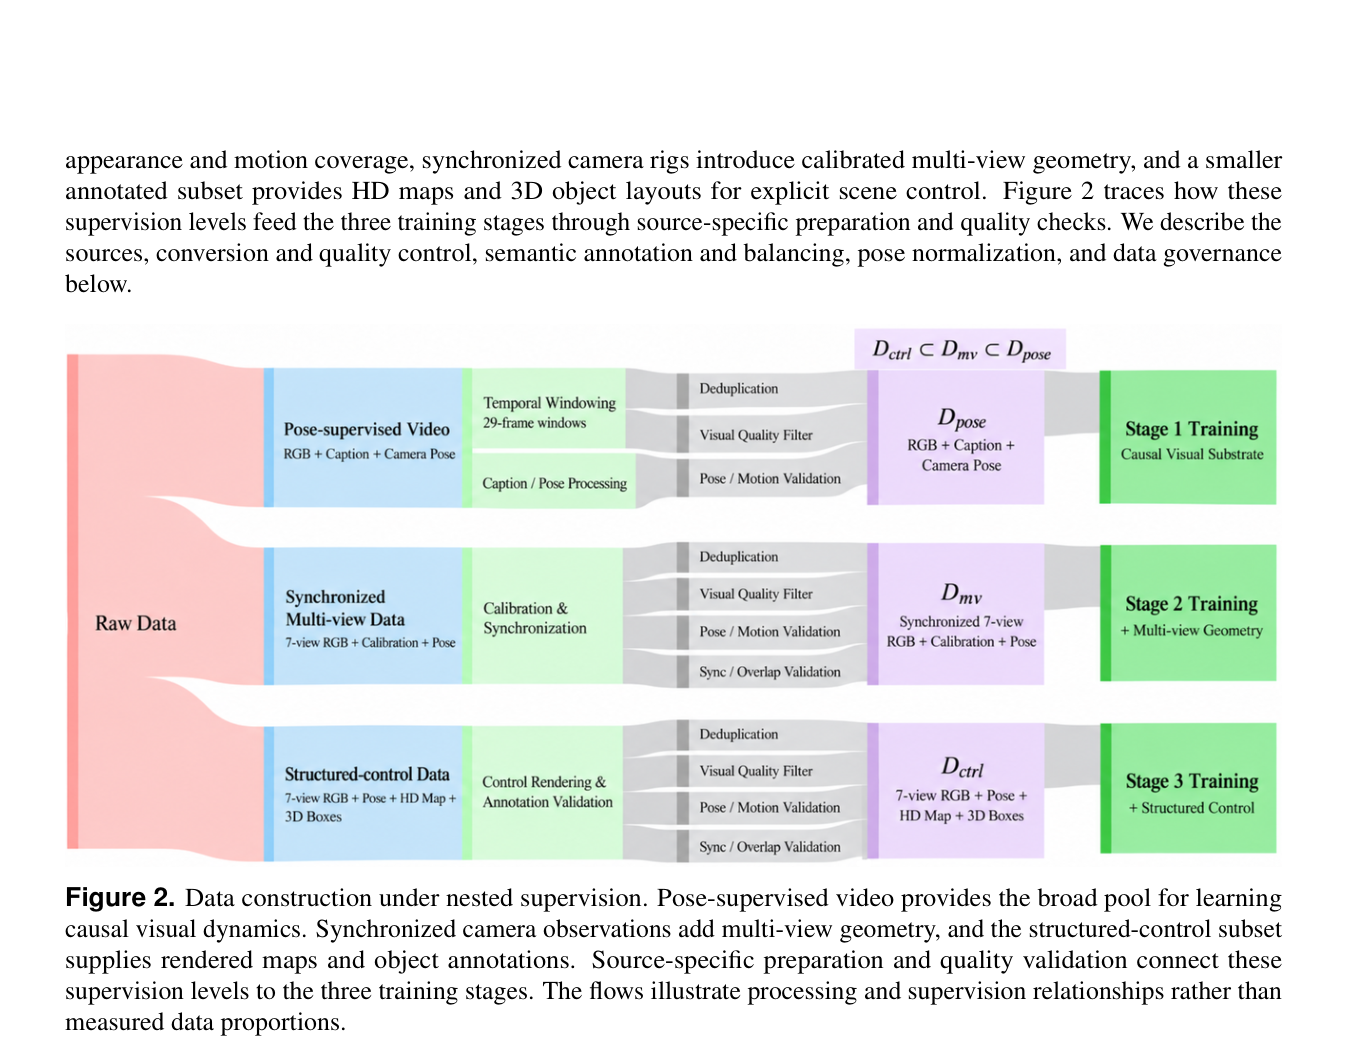
图2说明嵌套监督数据流:位姿视频喂 Stage-1,同步七视角喂 Stage-2,HD map/3D box 子集喂 Stage-3,并强调质检与 29 帧窗口,解释为何必须渐进而不是一步到位。
框架细节
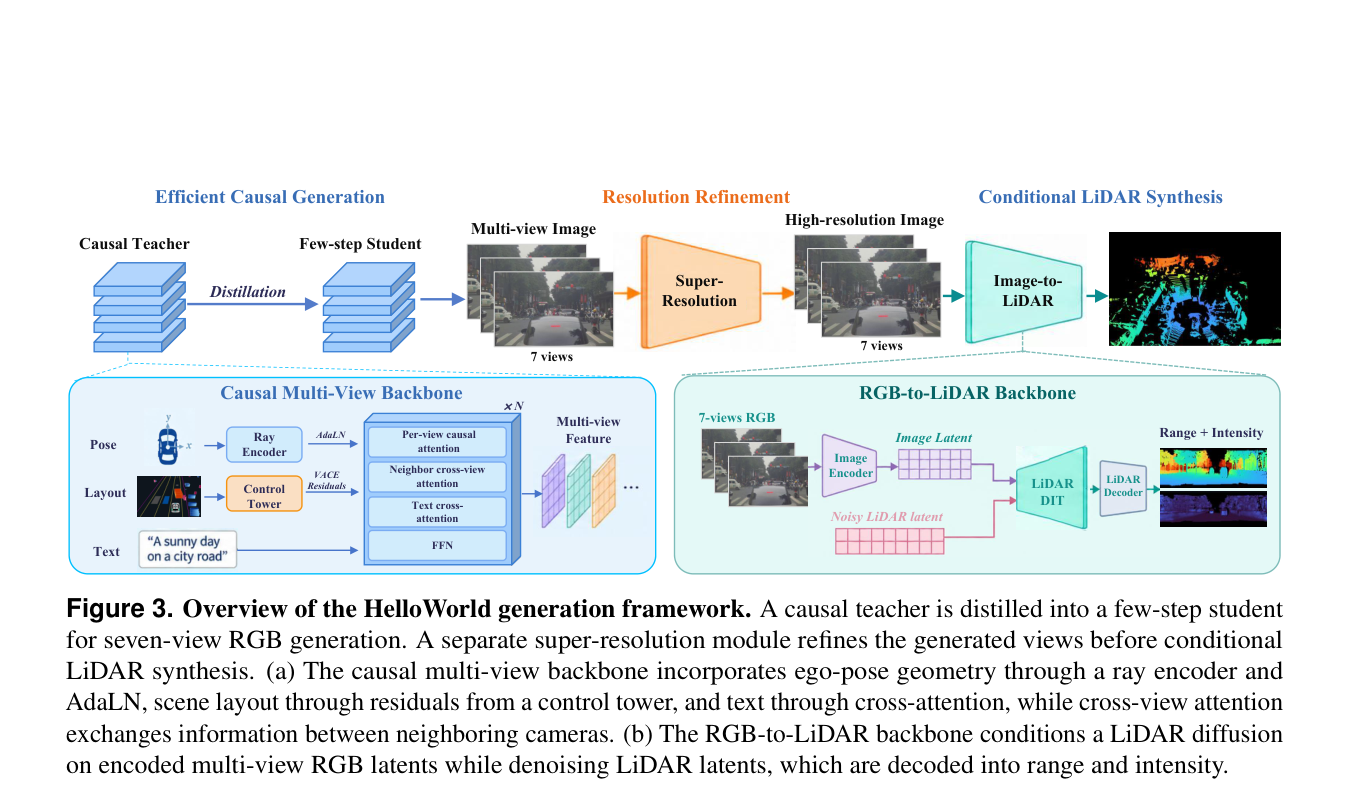
图3是生成框架总图:上方从因果教师蒸馏到少步学生,再经超分进入 Image-to-LiDAR;下方左支展示位姿/布局/文本如何进入多视角因果骨干,右支展示七视角 RGB 条件的 LiDAR DiT。适合作为方法主图与特色图。
关键证据
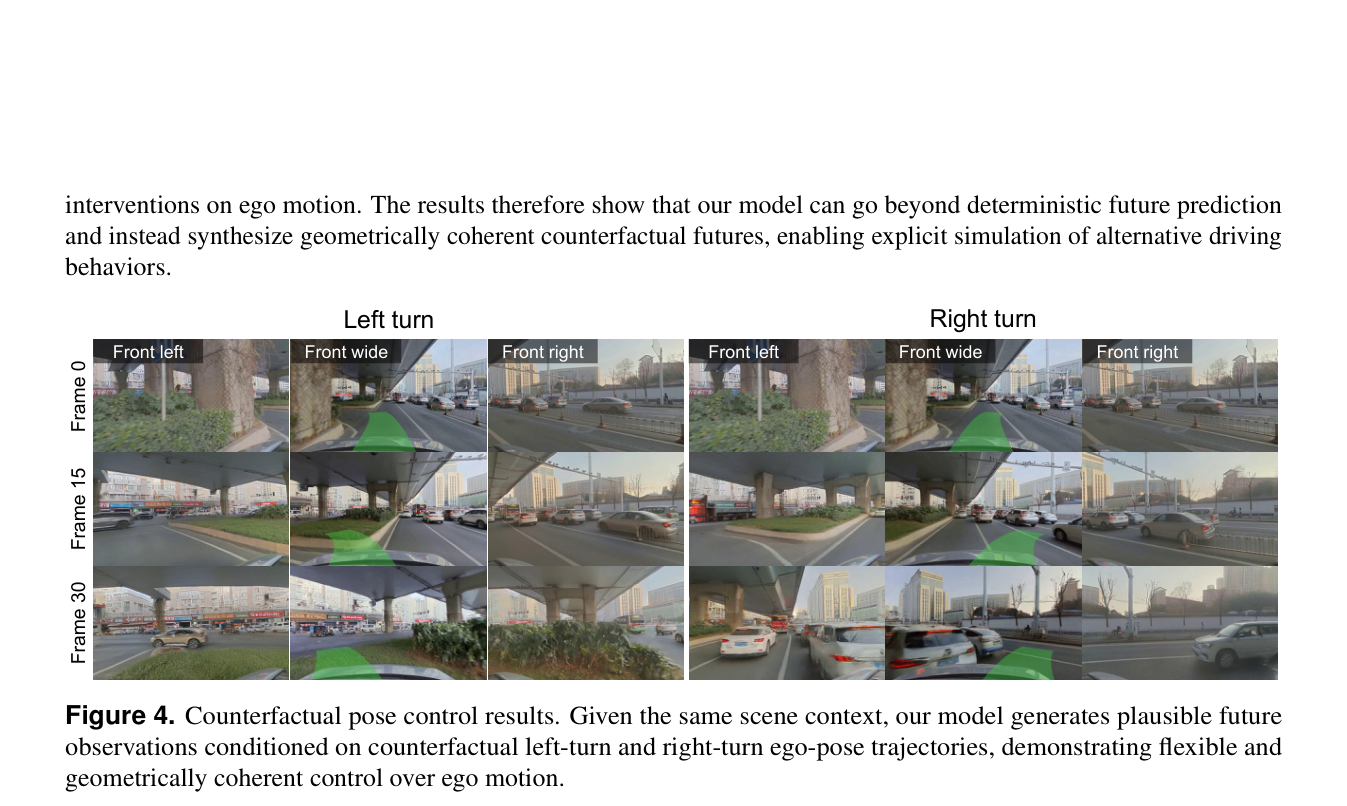
图4给同场景反事实左右转:Frame 0 相同,Frame 15/30 随绿色位姿轨迹分别左/右转向,前左/前广/前右三视角保持几何连贯,是可控性最直观的证据。
实验如何设计?
- 视觉与几何:单视角 29/100 帧位姿 RMSE(Pi3X 估计轨迹 vs 参考)与 VBench;多视角位姿、CSE、VBench,对照 Cosmos Transfer 2.5 等。
- 分布保真:nuScenes 短/长时域 FID 与 FVD,覆盖 AR/多视角/视频生成设定。
- 可控性:同场景前缀下反事实左右转与非常规变道;对比仅控制视频 vs 控制视频+位姿。
- 系统指标:少步蒸馏后的位姿/CSE/VBench 与推理成本;LiDAR VAE 重建与全景 RGB-to-LiDAR 生成的 MAE、Chamfer、Ray/Static-Align 等。
关键结果与论文证据
- 单视角 29 帧上,HelloWorld 的 Rot/Trans 为 2.0620/0.2570,低于 Lingbot World 2.0 的 3.2310/0.2853(页18),说明位姿条件生成轨迹更贴参考。
- 多视角后训练在首帧条件下把 CSE 从 6.192 降到 4.180(约 32.5%),相对 Cosmos Transfer 2.5 的 6.549 改进约 36.2%,但仍高于真实视频参考 1.730(页20)。
- nuScenes 短时域 HelloWorld 录得 FID 7.75、FVD 41.08;相对 FAR-Drive 的 11.92/82.78,分别约降 35.0% 与 50.4%(页21)。长时域相对 HorizonDrive 则是 FID 更高、FVD 略低的权衡。
- Figure 4 显示同场景上下文下,左右转绿色轨迹可驱动前视三相机几何一致地转向不同未来,支持反事实仿真而不只是确定性外推(页22)。
- DMD 少步学生在匹配条件下可改进位姿与 CSE,并相对教师给出约 9.91× DiT ODE 与 4.60× 采样加速(页28);Temporal RRN 把全景生成 Static-Align 从 67.41% 提到 83.10%(页30)。
阅读时需要注意
- 跨视角几何仍未达到真实视频参考水平;长程分布保真存在帧级与视频级指标张力。
- 蒸馏配方敏感:dCM 可能牺牲旋转与 CSE 换少步,需与 DMD 等路线区分阅读。
- LiDAR 质量依赖同步多相机与后处理协议;公开能力表条目来自各系统自述,横向对比需保持口径谨慎。
关联工作
- MagicDrive-V2、GAIA-2、Cosmos 系列与 HY-World/Genie 等提供了布局/动作条件与世界模型能力坐标。
- FAR-Drive、OmniNWM、DiST-4D 等构成 nuScenes 生成质量对照。
- UniScene、Sensor2Sensor、Cosmos RGB-to-LiDAR 与 L3DR 整流思路,分别对应多模态场景、传感器翻译与深度后处理相关线。