快速导读:UltraBench 2 用统一下载、划分与评测协议覆盖十余项超声分类/分割任务,复盘显示病理任务仍最难,通用 DINOv3 已在分割上追平超声专项模型。
超声视觉基础模型近几年发布很快,但公开评测往往各用各的数据集、预处理和划分,横向对比很难站稳。UCLA 与 Université Laval / Mila 的预印本 UltraBench 2(arXiv 2609.28610)试图补上这条缺口:把下载、标准化预处理、固定 train/test 划分和统一评测脚本捆在一起,覆盖 11 个分类与 10 个分割任务、约 10 个解剖区域,并提供开源模型排行榜。
作者在同一协议下复盘多款超声专用模型与通用 DINOv3 骨干。总体结论是:病理相关任务仍明显更难;分类上超声专项预训练仍占优,但分割上 DINOv3 等通用模型已经把差距压得很小。本文是研究用评测稿,不是临床产品,不能外推为可部署诊断系统。论文宣称代码仓库 https://github.com/adamtupper/ultrabench2,制作时 GitHub API 返回 404,记为宣称仓库未找到。
英文题目:UltraBench 2: Towards Robust Evaluation of Vision Foundation Models on Ultrasound
论文出处:arXiv 每日论文精选 · arXiv:2609.28610
原始论文:PDF / 论文页面
这篇论文解决什么问题?
基准的价值在于可比与可复现。引言指出,超声基础模型声称“通用、可低监督迁移”,却缺少覆盖多样任务、协议清晰、入口够低的评测(第1页)。
既有超声基准如 UniUS-Bench、UltraBench、UltraFedFM、US-43d,或缺少统一下载与预处理接口,或只给原始数据链接,或含竞赛限制许可,导致别人很难复现同一图像集合(第2–3页,Table 1)。
MedMNIST、MedSegBench、MedIMeta 等生物医学多域基准更标准化,但超声任务与解剖覆盖不足。U2-Bench 面向视觉语言模型,不直接评视觉基础模型(第2页)。
作者因此把设计原则写成:宽覆盖、可复现预处理、固定划分、低门槛接口、尽量非商业许可,以及可演化的排行榜(第3–4页)。
核心创新
- 把下载、标准化预处理、固定划分与框架无关评测捆成可复现协议,并设开源排行榜。
- 按病理/非病理与分类/分割组织宽覆盖任务矩阵,显式记录预训练重叠。
- 同一协议复盘超声专项与通用 DINOv3,分离任务难度与发布时间伪进步。
- 训练图少做强制预处理,把增强与尺度留给提交者,降低协议绑定偏见。
方法概览
整理 11 分类 + 10 分割公开任务,经 Hugging Face 统一接入与固定划分;在全量微调与 head-only 下评超声模型与 DINOv3,并用类别均值与患者级误差条汇总。
- 任务矩阵:病理分类 8 项(乳腺病理/组织学、COVID-19、胆囊肿瘤、肝占位、MASLD、卵巢肿瘤、甲状腺结节等)、非病理分类 3 项(心超图像质量、胎儿脑平面、胎儿平面)、病理分割 4 项、解剖分割 6 项,合计 11 分类 + 10 分割,训练侧常按任务封顶约 1000 例(第5页,Table 2)。
- 数据接入:数据集经 Hugging Face Datasets 统一暴露,可用 load_dataset 拉取托管或本地路径;提供参考 PyTorch 模型与任务头,以及基于 CSV/RLE 的框架无关评测脚本(第4–5页)。
- 预处理刻意克制:图像统一到 RGB,患者级标签按患者划分,测试集固定。训练图不做强制 resize,把增强与输入尺度留给提交者;分类用线性头与交叉熵,患者/序列任务对帧预测取平均;分割按骨干输出结构选用上采样解码器(第4、6页)。
- 协议双设定:全量微调与 head-only;报告类别分数为任务均值,误差条用患者级重采样标准误。排行榜仅接受开源模型,以避免公开测试集上的不诚信提交(第5–6页)。
- 复盘对象包括 USFM、DeblurringMIM、URFM、UltraFedFM、SAMUS、EchoCare、TinyUSFM、OpenUS 等超声模型,以及 DINOv3 ViT/ConvNeXt 作通用参照;预训练与评测集重叠在附录记录(第3、6页)。
逐图理解论文
方法贡献
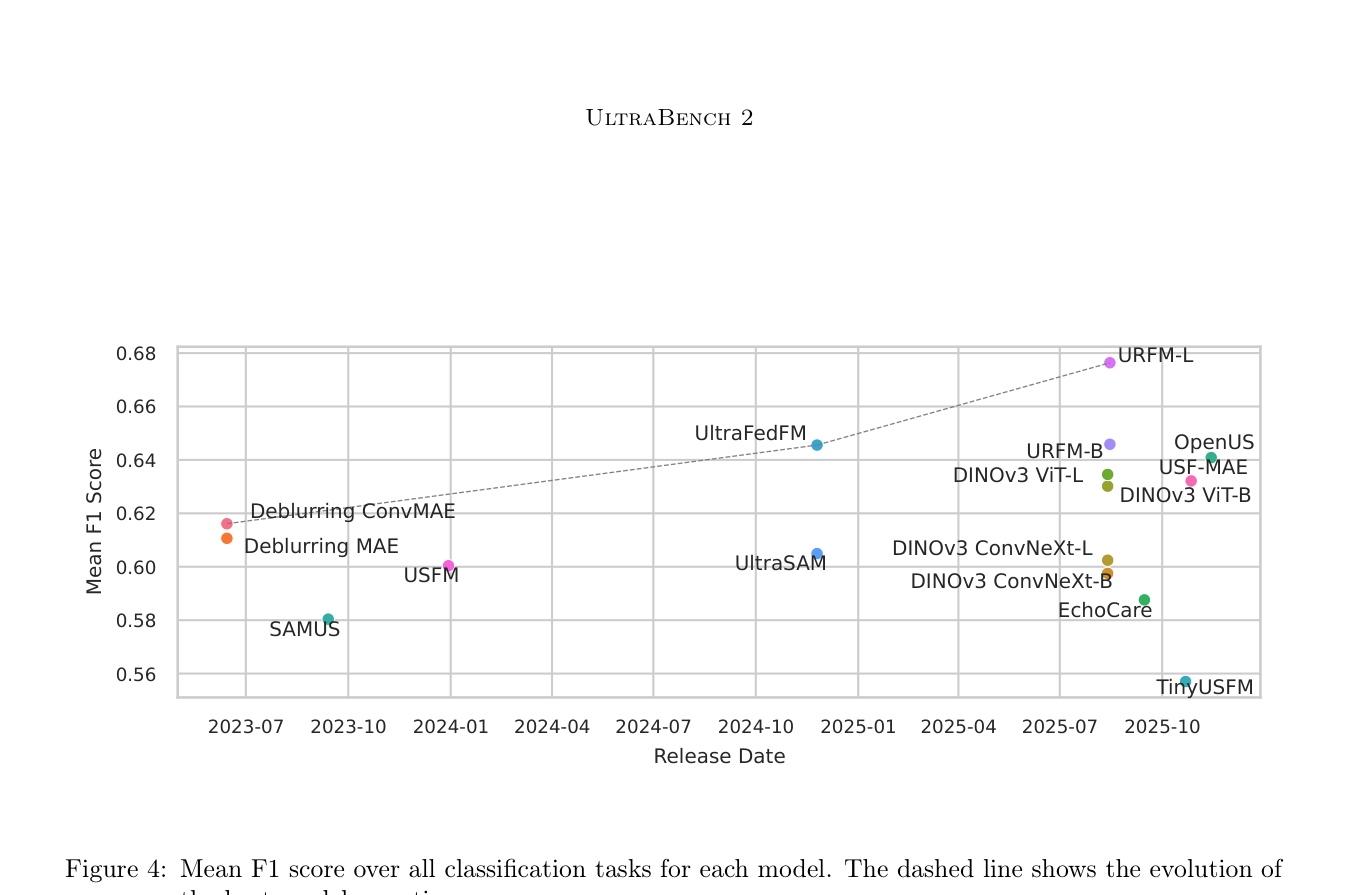
分类 mean F1 对发布日期散点,虚线连各时期最优。URFM-L 约在 2025-08 冲到约 0.67;UltraFedFM、OpenUS 次之;2025 末的 EchoCare、TinyUSFM 明显低于前沿。说明发布时间不等于进步,读数以图上点位为准。
关键证据
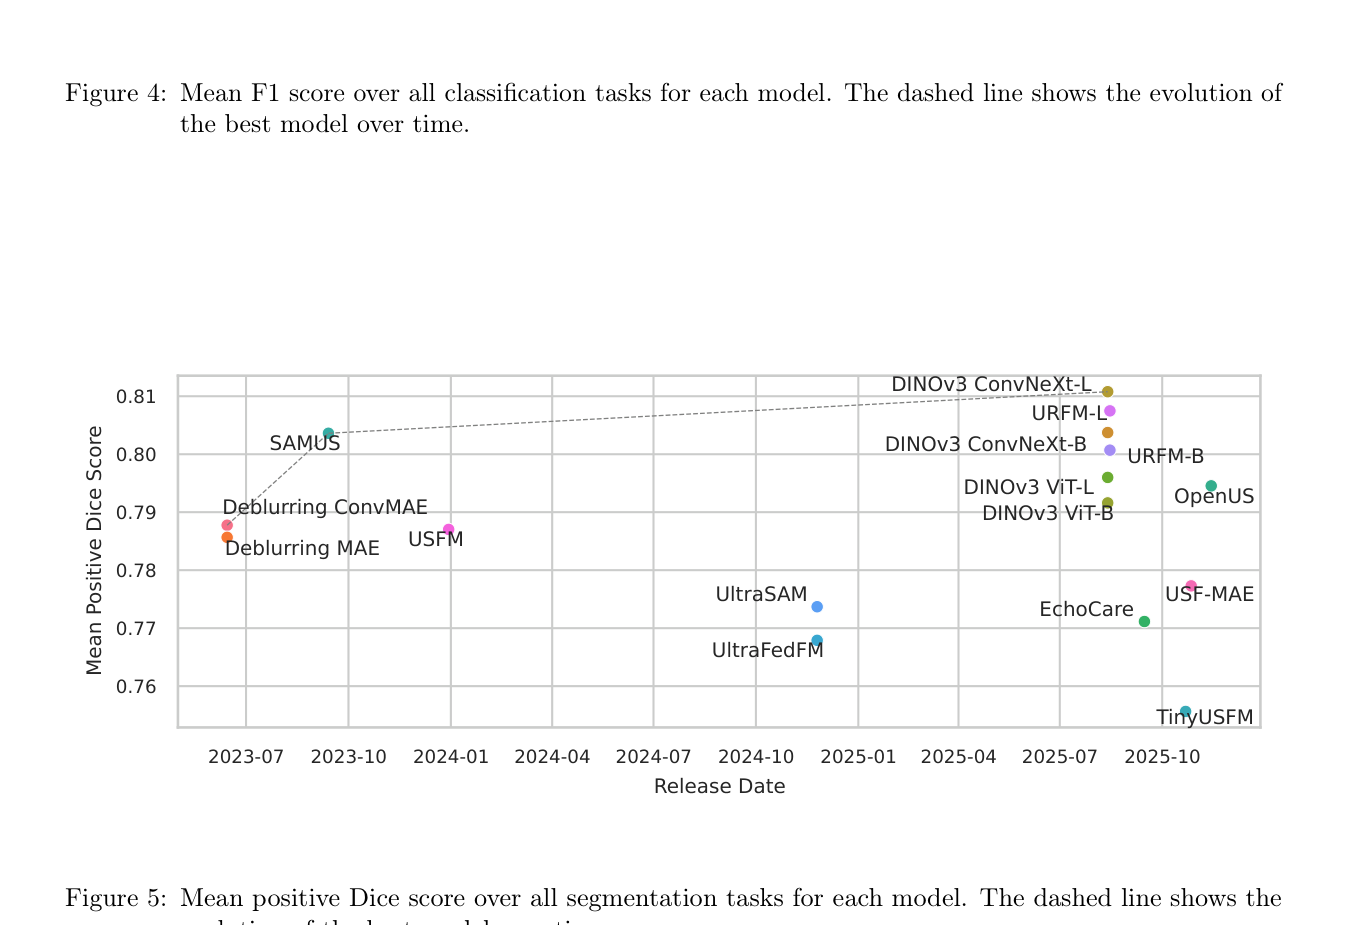
分割 mean positive Dice 对发布日期。SAMUS 先把前沿推到约 0.80,DINOv3 ConvNeXt-L 再提到约 0.81;UltraFedFM、EchoCare、TinyUSFM 落在更低带。与 Figure 4 对照,可看分类与分割前沿是否由同一模型族推动。
核心结论
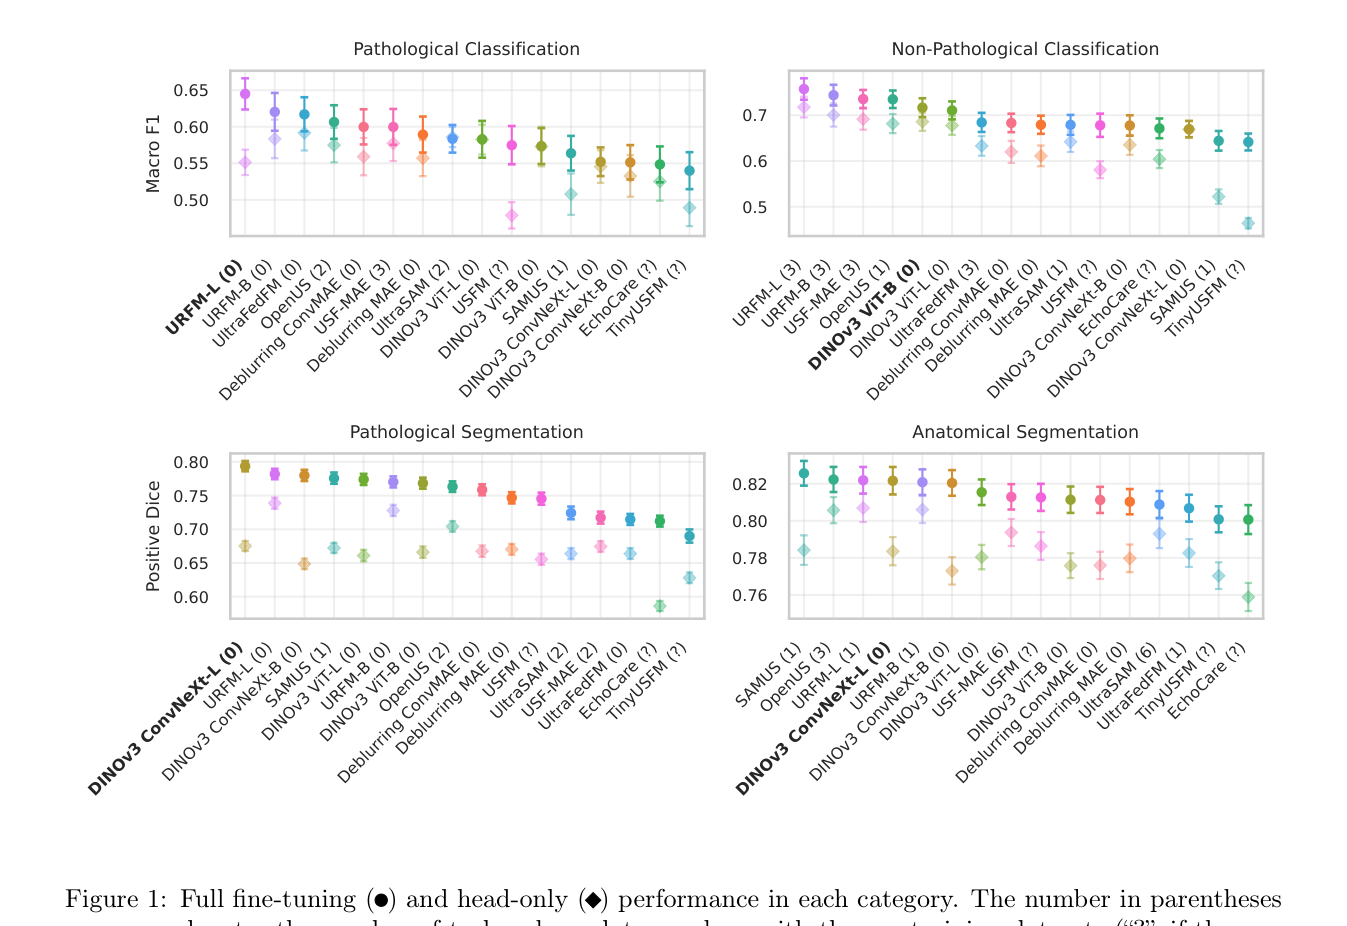
四宫格散点:病理/非病理分类用 Macro F1,病理/解剖分割用 Positive Dice。实心圆是全量微调,菱形是 head-only,括号数字是预训练与任务重叠数,“?”表示未披露。从左到右大致按全量微调成绩排序;病理分类 URFM-L/B 最高,病理分割 DINOv3 ConvNeXt-L 与 URFM 靠前,解剖分割 SAMUS、OpenUS、URFM 领先。用它看四类难度与微调设定差距,不要把误差条当临床置信区间。
实验如何设计?
- 主结果按四类汇总:病理分类、非病理分类、病理分割、解剖分割,同时画全量微调与 head-only(第7–8页,Figure 1)。
- 时间演化图把各模型按发布日期画在分类 mean F1 与分割 mean positive Dice 上,虚线标出当时最优前沿(第22页,Figure 4–5)。
- 分割任务样例图给出 AUL、BUS-BRA、MMOTU、TN3K、CAMUS、Open Kidney、PSFHS、STMUS 等掩码示例,帮助理解任务异质性(第21页,Figure 3)。
- 作者强调超参、增强与任务头未按模型逐一搜最优,结果应视为可比起点而非绝对天花板(第8页)。
关键结果与论文证据
- 病理分割显著难于解剖分割:最差模型的解剖 Dice(EchoCare,约 0.801)仍高于最优模型的病理 Dice(DINOv3 ConvNeXt-L,约 0.794);肾区分割上所有模型 Dice ≤0.487(第7页)。
- 病理分类同样系统性低于非病理分类;非病理最差约 0.641(TinyUSFM)已接近病理最优约 0.645(URFM-L)(第7页)。
- 通用 DINOv3 ConvNeXt-L 在病理分割登顶(约 0.794),解剖分割与 SAMUS(约 0.826)同档;分类上 URFM 仍领先,无重叠时 DINOv3 ViT-B 在非病理分类靠前(第7–8页,Figure 1)。
- 时间图显示新模型不总是超过旧模型:分类前沿约由 URFM-L 推向 mean F1≈0.67;分割前沿由 SAMUS 推进到 DINOv3 ConvNeXt-L 的 mean Dice≈0.81,而 EchoCare、TinyUSFM 等新发布点反而偏低(第22页,Figure 4–5)。
- 全量微调普遍高于 head-only;超声模型在冻结骨干时仍常保住分割优势,作者怀疑通用预训练与超声域偏移有关(第7–8页)。
阅读时需要注意
- 基准完全依赖公开数据,需要社区自觉在预训练中排除评测集,否则排行会失真;大规模私有外测仍难(第8页)。
- 统一超参与任务头未做逐模型优化,可能低估部分架构;也不能把榜分写成临床可用证据。
- 部分模型预训练数据未披露(图中标“?”),重叠计数不完整;宣称仓库制作时未找到,复现链路需后续核验。
- 本文评测的是离线视觉基础模型适配,不是床旁工作流、放射科审读或监管器械验证。
关联工作
- 相对第一代 UltraBench 与 UniUS-Bench,本稿强调下载接口、固定划分与排行榜,而不是再堆不可复现的任务列表(第2–3页)。
- DINOv3 代表通用自监督视觉模型;URFM 通过蒸馏 BiomedCLIP 等多域医学知识,在病理分类上拉开差距(第3、7页)。
- SAMUS 等超声分割模型仍是解剖分割强基线;知识蒸馏路线(URFM、DINOv3)整体表现稳健,TinyUSFM 除外(第7–8页)。