快速导读:STRAND 用子问题联合计分的 Faithful Accuracy 诊断视频 MLLM 的对象时空监测,并用轨迹记忆框架降低幻觉、提高时序一致性。
视频多模态大模型越来越能回答复杂问题,却仍常在动态场景里幻觉出错误身份、关系或事件顺序。NUS 与 VinUniversity 的预印本 STRAND(arXiv 2609.29607)认为,根因是对象中心的时空监测不足:模型没有把“谁在何时对谁做了什么”钉住。
STRAND 用人工核验的对象事实构造目标问题,再拆成子问题,并以 Faithful Accuracy 要求目标与全部前置子问题同时正确。作者还给出按 chunk 抽状态、时间聚合建轨迹、再检索作答的对象中心框架。公开独立代码入口未见,记为待核验;本稿按论文雷达深度概述值不值得细读。
英文题目:STRAND: Benchmarking and Improving Object-Centric Spatio-Temporal Monitoring in Video Large Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.29607
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视频基准多只看最终答案。对“1 号球员有没有盖掉 10 号的投篮”这类问题,模型可能靠局部外观或赛场先验蒙对,却说不清中间事实(第1–2页,Figure 1)。
幻觉与长视频基准已分别打物体、动作、时间漂移,但很少把支撑事实与最终答案联合计分,因此分不出“真看懂时间线”和“碰巧答对”(第3页)。
STRAND 把评测改成:先有对象中心事实,再生成目标与子问题,最后用无条件的联合指标卡忠实推理(第4–5页)。
核心创新
- 用对象中心事实与子问题分解,区分真时序理解与碰巧答对。
- 提出 Faithful Accuracy,避免只在答对子集上刷一致性。
- 给出 chunk 状态抽取加符号时间聚合的轨迹推理框架。
- 在匹配预算下对比端到端 MLLM,并外推到幻觉与长视频基准。
方法概览
人工核验对象事实后自动分解子问题,以 Afaith 无条件联合计分;推理侧把视频变成对象轨迹记忆再检索作答。
- 基准构造:标注员做时间锚定、实体登记、事实抽取与跨时身份链接,得到对象中心结构化记录;再自动生成目标问题与子问题,并经人工核验语言、充分性与视觉 grounding(第4页,Figure 2)。
- 规模:88 条视频,平均约 183 秒;977 个目标、2516 个子问题;50 名标注员,Cohen’s κ≈0.88。问题均为是否题。多数类 Afaith 仅 19.1%,无视频问答约 21.4%(第6页)。
- 主指标 Faithful Accuracy:目标与所有子问题全对才计 1;Atarget、Asub 为辅助,Acons 仅供参考,因分母依赖模型自身答对集合(第5页)。
- 改进框架:视频切成时间 chunk → 抽关系状态元组 → 符号式时间聚合建轨迹记忆 → 按问题检索相关轨迹 → 轨迹引导答题;1–5 步每视频一次,6–7 步每问题一次(第6–7页,Figure 3)。
- 默认 15 秒 chunk、每 chunk 60 帧、答题 64 帧;实现了 Gemini-3-Flash 与 Qwen3-VL-235B 两套实例(第7页)。
逐图理解论文
失败直觉
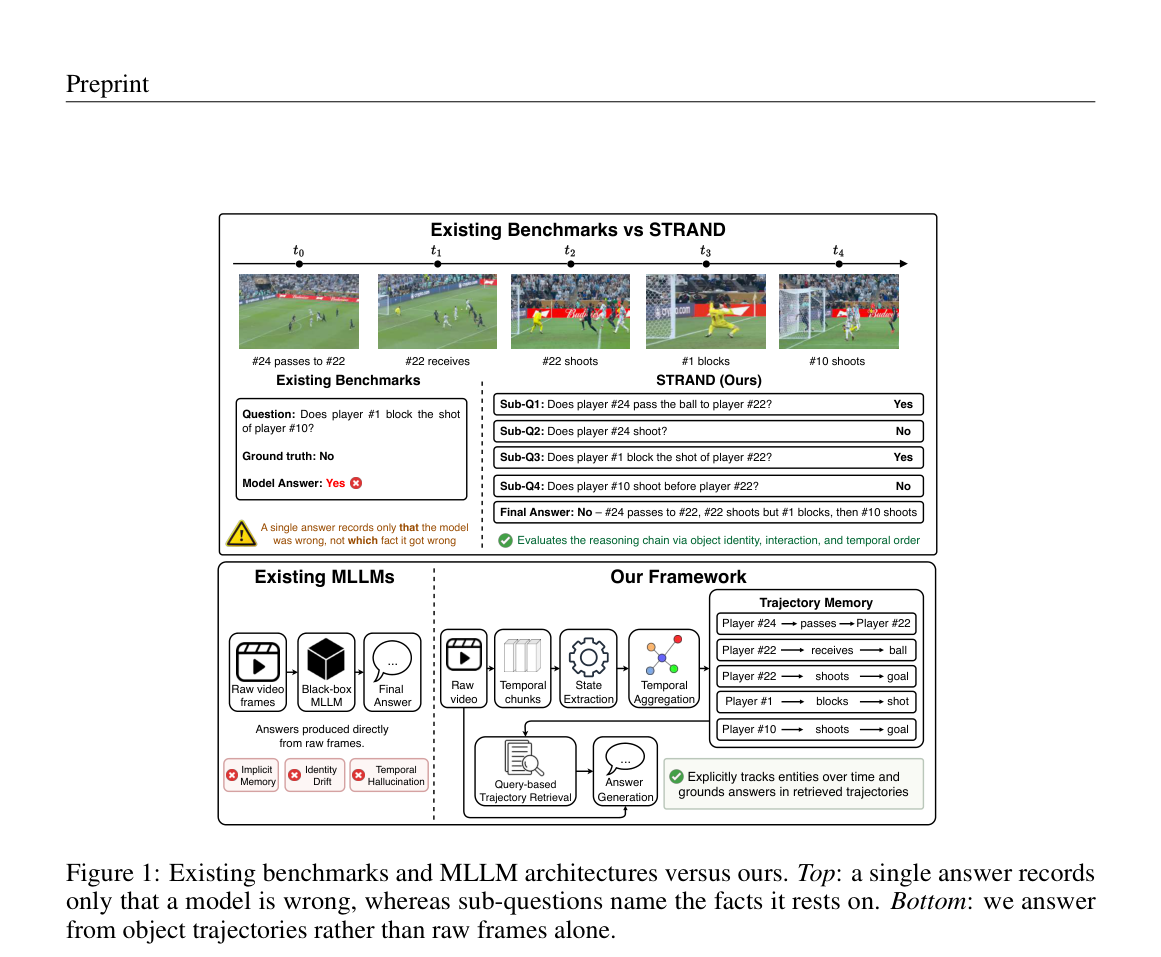
上半对比旧基准只看最终对错,与 STRAND 用子问题拆开传球、投篮、盖帽与时间顺序;下半对比黑盒端到端与“抽状态—聚轨迹—检索作答”框架。足球五帧示例把身份漂移和时序幻觉画得很直白。适合开篇建立问题直觉。
研究缺口
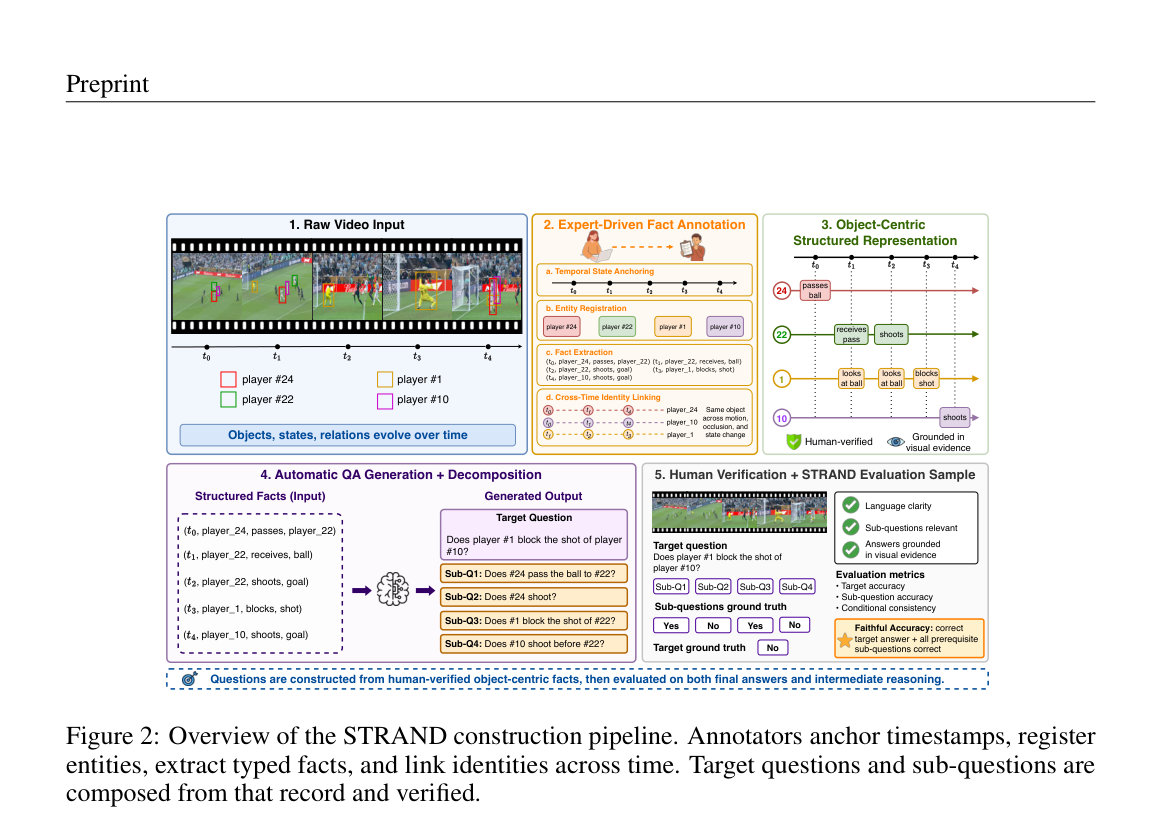
基准构造五段流水线:原始视频 → 专家事实标注(锚定、登记、抽事实、跨时链接)→ 对象中心表示 → 自动出题与分解 → 人工核验并计算 Target/Sub/Faithful 指标。这是数据集怎么来的总览,适合当特色图。
方法贡献
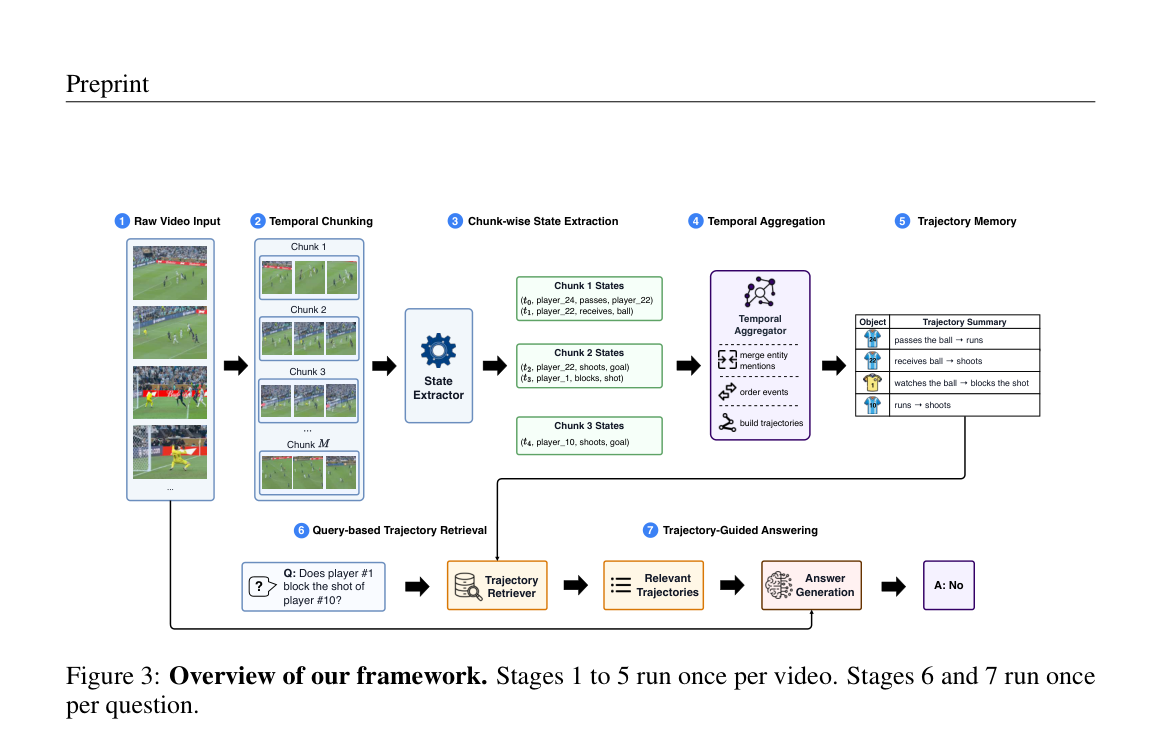
方法七段:原始视频与时间切块、chunk 状态抽取、时间聚合、轨迹记忆,再经问题检索与轨迹引导答题;注明 1–5 每视频一次、6–7 每问题一次。用来理解改进框架而不是基准标注流程。
实验如何设计?
- 主表在 STRAND 上对比端到端专有/开源 MLLM 与 VideoMind、TraveLER、SeViLA 等结构化管线(第8页,Table 1)。
- 外推到 VideoHallucer、Video-MME、EgoSchema(第8页,Table 2)。
- 消融覆盖检索过滤、聚合方式、帧预算,以及打乱轨迹时间顺序等控制(第9页,Table 3 与附录)。
关键结果与论文证据
- 端到端模型无一超过 68.4% Atarget;Gemini-3-Flash 实例达到 Afaith 59.4%、Atarget 77.1%,相对 Gemini-3.1-Pro 分别高 20.5 与 15.7 点(第7–8页)。
- 时间顺序仍是瓶颈:单事实子问题明显高于排序子问题;把同一表示的时间打乱后,Atarget 从 77.1 降到 65.3(另一骨干 74.0→54.1),说明增益依赖时间结构(第3、8页)。
- 外基准上 Gemini 实例 VideoHallucer 76.8、EgoSchema 78.4,对强基线仍有增益或持平;Video-MME 未全面领先(第8页)。
- 匹配帧数/调用/token 预算后,对象轨迹框架仍高于同骨干端到端,但更强骨干上部分模块增益变小,机制解释需保持克制(第9页)。
阅读时需要注意
- 预加工轨迹带来延迟,难言实时(附录限制)。
- 88 视频规模对分域结论偏弱;基准与方法都围绕轨迹,存在共设计偏好。
- 是否题易受先验影响;若干同骨干机制对照未跑完。
- 独立代码/项目页公开状态待核验,论文写有 nguyentthong.github.io/strand。
关联工作
- 相对 EgoSchema、LVBench、VideoInfer 等加难最终题的设定,STRAND 强调联合给分子问题(第3页)。
- VideoMind、TraveLER 等模块化视频管线是结构化对照;本文额外用 Faithful Accuracy 卡一致性(第8页)。
- VideoHallucer 等幻觉基准用于检验方法是否只在自建基准上讨巧(第8页)。