快速导读:SVGLM 用 SVG 双栖文本与图像,经 8K 对话微调让 VLM 在推理中调用可渲染矢量程序,增强几何 think-with-image。
现有视觉语言模型擅长看图与文字推理,却很难把「画出来的中间步骤」真正写进推理链;全模态生成模型又常把图像压成栅格或潜变量,不利于精确、可核验的数字域操作。UMass Amherst、Michigan、UIUC 与 Dolby 等团队提出 SVGLM(Multimodal Thinking with Renderable Programs,arXiv:2609.30130 ):用 SVG 同时充当图像描述与文本指令,让开放权重 VLM 在推理中生成可渲染程序。
作者构建约 8K 的高质量 SVG 图像编辑对话数据,经监督微调后以多轮 tool-calling 在画布上叠加辅线、标注与几何元素,再基于渲染结果继续思考。MathCanvas-Bench 平面/立体几何上,SVGLM 相对零样本与普通 SFT 有明显增益,并优于 GPT-4o 与若干 think-with-image 基线。本文是预印本,聚焦数字域可解释视觉推理,不是开放域文生图系统。
英文题目:Multimodal Thinking with Renderable Programs
论文出处:arXiv 每日论文精选 · arXiv:2609.30130
原始论文:PDF / 论文页面
这篇论文解决什么问题?
信息图、数学示意图把符号结构与定量约束压进少量标记与坐标,模型往往要先理解轴线、比例与布局规则,才能可靠推理;仅靠流畅文字理由,中间步骤常弱接地,结论容易被语言先验主导(第1–2页)。
Thinking with Images 把图像变成可操作工作区;既有系统或生成栅格/潜变量中间图,或生成依赖特定运行时的 Python 绘图代码,前者长程插图 token 昂贵,后者易受依赖与版本漂移影响。
SVG 是声明式、层次化、分辨率无关的文本,可直接操作 path/line 等原语,使每次视觉修改都可编辑、可核验,更适合几何辅线这类需要精确坐标的任务。
核心创新
- 提出以 SVG 为桥接的 SVGLM,把可渲染程序嵌进多模态思维。
- 发布约 8K、经 LLM 与人工校验的 SVG-as-image-editing 对话数据。
- 在多底座上验证 SVG 集成相对零样本/SFT/栅格编辑通路的收益。
- 展示 VLM 生成多样几何 SVG 原语的能力,服务可解释数字域智能体。
方法概览
构建 SVG 增强多轮 tool-calling;8K 几何辅线数据(过滤–Gemini 标注–校验);对开放 VLM 做 SFT 并在 MathCanvas 评测。
- SVGLM 采用标准多轮工具调用,但允许在 tool call 前生成普通文本:模型可用 <tool_call> 包裹 XML 编码的 SVG 与画布指定(原题图或空白),渲染后把叠加图回灌对话,再决定继续画或作答(Figure 1,第5页)。
- 数据来自 MathCanvas-Instruct 的平面/立体几何子集:先用 GPT-5 过滤「解图可在题图上只加标注与新图形得到」的样本;再用 Gemini-3.0-Thinking 识别题图与解图差异,并在 1000×1000 画布上标关键点坐标生成 SVG;渲染后由 GPT-5 视觉校验,仅保留通过样本(Figure 2)。
- 人工抽检把样本分为完美重建、轻微/显著平移误差与结构错误;Table 1 报告完美重建约 79.5%、结构错误仅约 1%。对话侧再由 GPT-5 生成无推理/简洁/完整三档推理密度,形成 8K 级 SVG 增强对话集。
- 训练:对 LLaVA-Next-Mistral-7B、Qwen2.5-VL-7B、InternVL3-8B 做 SFT(约 3 epoch、lr 1e-5、batch 8、8×H100,约 2 小时)。评测走交互式 tool-calling;对照含零样本、同规模普通 SFT、V-Thinker(Python)、GPT-4o+Qwen-Image-Edit 与 GPT-4o 零样本。
逐图理解论文
问题背景
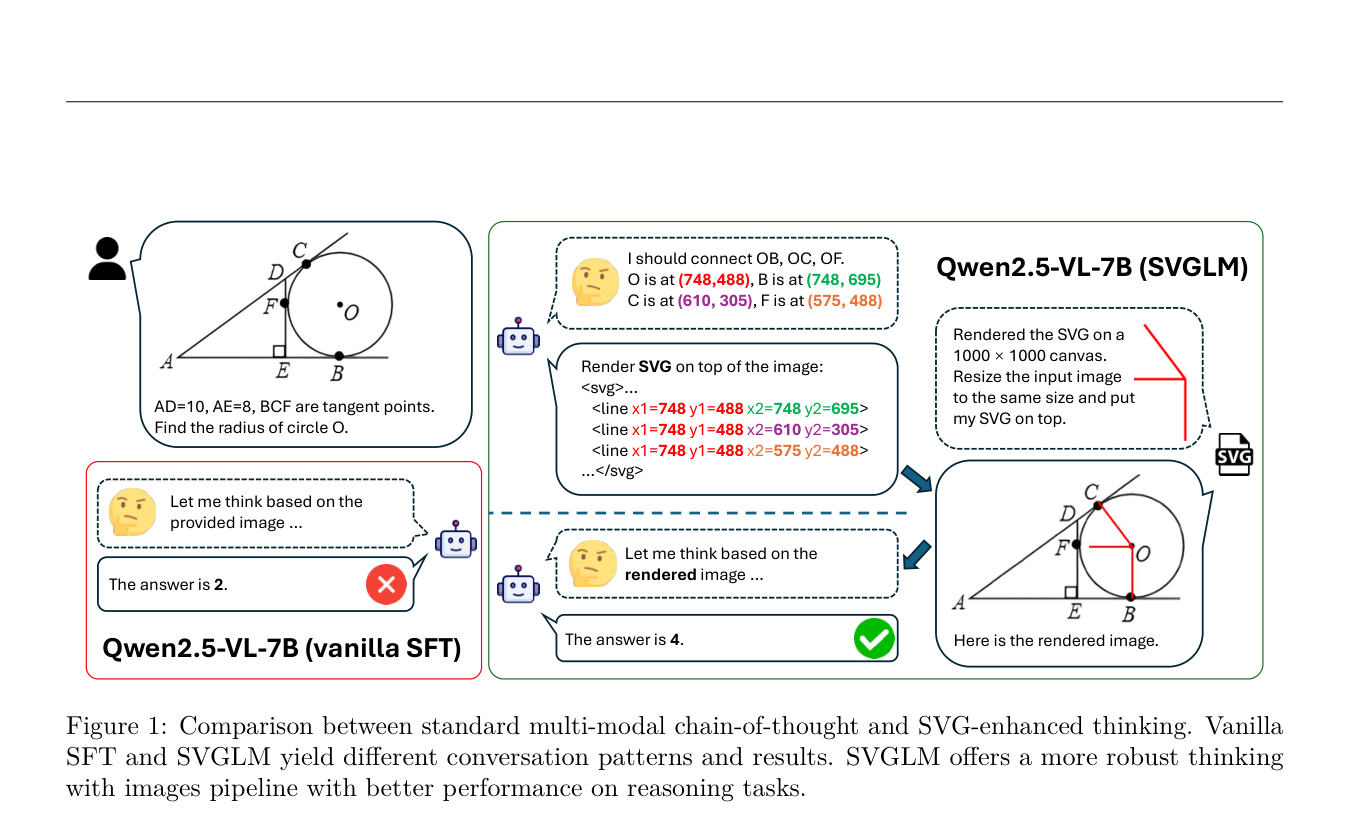
Fig.1 对比 vanilla SFT 与 SVGLM:同一几何题(求圆半径),vanilla 直接看原图答错;SVGLM 先定位 O/B/C/F 坐标、生成连半径的 SVG,渲染叠加后再推理得到正确答案。适合开场讲「把图画进思维链」。
方法总览
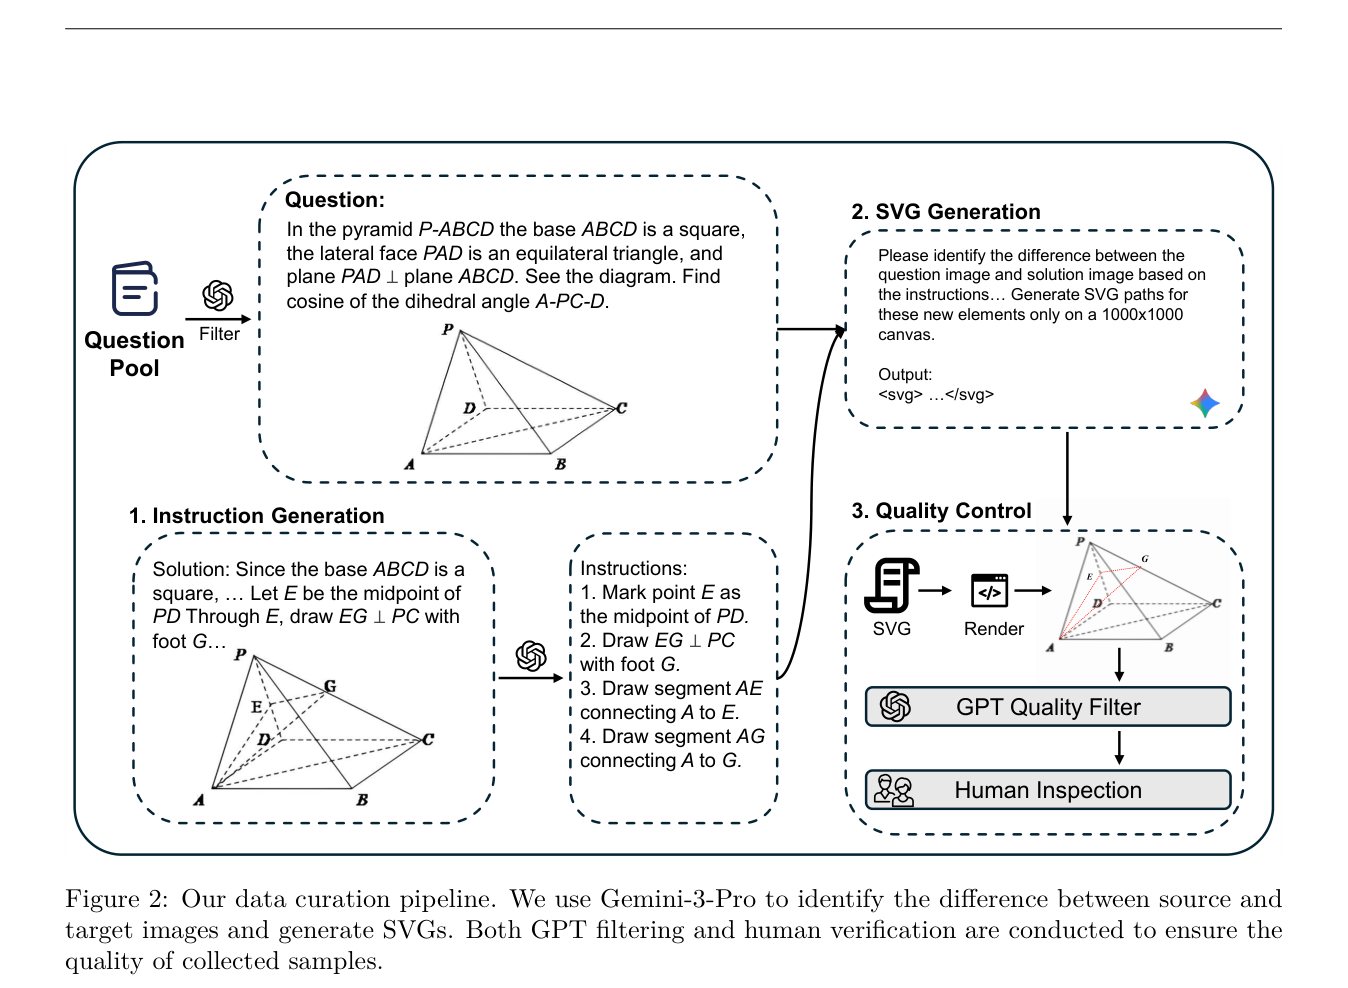
Fig.2 数据管线:题库过滤→由解图差生成指令→Gemini 在 1000×1000 画布生成 SVG→渲染后 GPT 质检与人工抽检。适合解释 8K 数据从何而来。
SVG 能力
Fig.3(页7裁切)展示微调后模型可生成连点、平行/垂线、交点字母与角标等多种 SVG 原语行为,说明 VLM 可作为基元矢量绘图器;与页8同图对照栅格编辑失败案例一起读。
实验如何设计?
- 基准:MathCanvas-Bench 平面几何 1092、立体几何 486;过滤至少含一图后约 1244 对(约 78.8%)。
- 指标:分科目准确率与加权总分(后一子题权重约高 30%)。
- 消融:有无 solution image 上界对照;定性比较 SVGLM 与 Nano Banana、Qwen-Image-Edit 同指令编辑。
- 另报 POPE 等地接推理相关评估(正文 Table 4)。
关键结果与论文证据
- 主表 Table 2:Qwen2.5-VL-7B 加权分零样本 19.5、SFT 21.8、SVGLM 30.9(平面 30.0 / 立体 33.0);InternVL3-8B:19.5→23.0→29.8;LLaVA-Next-Mistral-7B:14.6→13.2→23.1。
- GPT-4o 加权约 19.2;V-Thinker 约 20.5;GPT-4o+Qwen-Image-Edit 约 19.6,几乎不高于纯 GPT-4o,作者归因于编辑模型幻觉与域错位(第7–8页)。
- Table 3:给 Qwen2.5-VL-7B 直接看 solution image 可将加权分抬到约 34.0,说明「看见正确辅线」上限很高;SVGLM 的 30.9 接近该上界但仍低一截,显示自绘 SVG 仍有改进空间。
- 定性 Figure 3:同指令下 SVGLM 能较稳地连点、作垂线/平行线、标交点与角度;Nano Banana 与 Qwen-Image-Edit 常出现错位、丢原图细节或线型不符。
- 人工数据质检结构错误约 1%,支撑「高质 SVG 对话数据 + 轻量 SFT」路线的可行性。
阅读时需要注意
- 主评测集中在 MathCanvas 几何辅线场景,未声称覆盖开放域图像编辑。
- 数据管线依赖 GPT/Gemini 过滤与标注,成本与偏差需注意;预印本未经同行评审。
- 普通 SFT 在个别条目上相对零样本下降,提示对提示结构与 CoT 风格敏感。
- SVG 坐标误差(平移)仍存在;与 solution-image 上界仍有差距。
关联工作
- 相对 VIGA/RECODE 等可执行图形程序回路,SVGLM 强调 SVG 声明式原语与通用 VLM 微调。
- 相对 Visual Sketchpad、CodePlot-CoT、V-Thinker,介质从栅格/Python 转向可渲染矢量文本。
- 相对扩散式图像编辑作为中间推理介质,矢量路径更省 token、更易核验几何约束。