快速导读:在 13 个 MLLM 上用噪声视觉 token 证明标量视觉–文本对齐可与任务崩塌共存,并追溯到共享 MLP 权重诱导,提出 PA gap 作几何诊断。
很多人把 MLLM 层间视觉–文本相似度曲线上扬,直接读成「语言模型正在把视觉内容融进共享表示」。这一读法默认:标量对齐分数反映内容级跨模态交互。中国科学技术大学 Hong-Han Wang、Yuntao Wang、Hu Ding 的 NeurIPS 2026 论文 The Alignment Illusion in Multimodal Large Language Models(arXiv:2609.30210 )用受控干预检验该假设。
在五个家族、0.5B–72B 共 13 个 MLLM 上,把投影器输出视觉 token 换成高斯噪声后,任务准确率骤降,但 CKA、SVCCA、MIR 与领先主角度余弦四类标量指标,却无法稳定区分坏流与原流。作者称之为 alignment illusion,并把它追溯到共享语言模型通路里各向异性的 MLP 下投影;再提出 PA gap(前两大主角度余弦之差)作为几何诊断。本文是对齐诊断与可解释性研究,不是再刷一个 VQA 榜。
英文题目:The Alignment Illusion in Multimodal Large Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.30210
原始论文:PDF / 论文页面
这篇论文解决什么问题?
CKA、SVCCA、主角度相似度最初用来比较独立训练网络的表示;在 MLLM 里,视觉与文本 token 共享同一串 Transformer 块与同一套注意力/MLP 权重,独立性前提不成立(第2页)。
于是高相似度可以来自两类来源:内容级真正交互,或共享权重施加的 weight-induced alignment。标量分数把两者压成一个数,无法分辨「看起来对齐」与「真的用了视觉内容」。
标准基准上问题与相关图像总是成对出现,对齐分数自然与任务表现相关,两种解释分不开;只有在受控打断图像–问题关系时,它们才会脱钩。
核心创新
- 提出并对齐幻觉做跨家族规模验证:任务崩塌而标量对齐仍高。
- 把幻觉追溯到共享 LLM 通路,尤其是各向异性 MLP 下投影 Wout。
- 提出 PA gap,用前两大主角度余弦差区分单向架构对齐与多方向视觉结构。
- 在 α-mixing 与 IRR 设定下显示 PA gap 与任务信号的关系及几何–准确率脱钩情形。
方法概览
ORIG/NOISE/IRR 等干预 + 四类标量与机制旁路分析;定义 PA gap=σ1−σ2,并在分级退化与无关图像设定下对照准确率。
- 架构设定:研究 projector→LLM 路径。视觉编码器输出经投影得到 V^(0),与文本嵌入拼接后共同进入语言模型;对齐分数都在共享通路的隐状态上计算(第3页)。
- 干预设定 ORIG:保留问题附带图像的投影输出;NOISE:每个投影视觉 token 换成匹配范数的各向同性高斯向量,去掉视觉内容但保尺度。另用 IRR(结构化但不相关图像)与 SHUF(打乱 ORIG token 顺序)做对照(第4、7页)。
- 标量对照:逐层计算 σ1、CKA、SVCCA、MIR;用 separation score 衡量 ORIG 相对 NOISE 的排序能力。机制分析:旁路注意力 vs MLP、检查 Wout 的 s1/s2 奇异值比,并把主角度基投影到 Wout 主导左奇异子空间(Figure 3)。
- PA gap 定义:Δ_PA^(l)=σ1^(l)−σ2^(l),再对层取平均。作者论证:σ1 易被 Wout 的单方向主导;σ2 及以后更能反映输入特有的多方向结构。小 Δ_PA 意味对齐跨多个共享方向,大 Δ_PA 意味主要落在架构方向上(第6页)。
- 分级退化:V_α=α V_ORIG+(1−α)Z,α 从 0 到 1;比较各标量与准确率的 Pearson |r|。IRR 设定进一步检验「有结构但无关」时内部几何与任务准确率是否仍一致。
逐图理解论文
问题背景
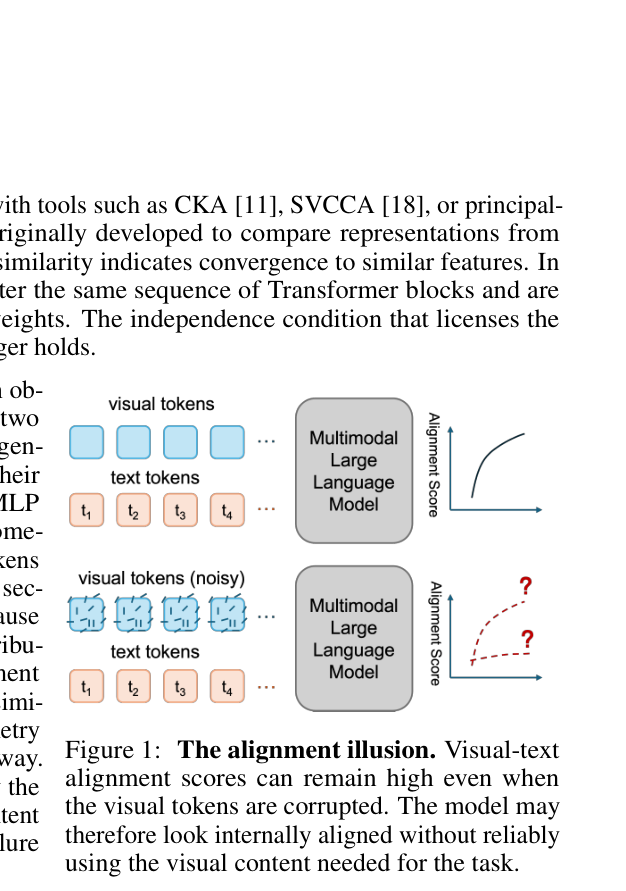
Fig.1 teaser:上排干净视觉 token 与文本 token 进入 MLLM,对齐分数上扬;下排噪声视觉 token 同样进入模型,虚线对齐曲线既可能很低也可能仍很高并打问号。直观说明「看起来对齐」与「真用了视觉内容」可以脱钩,适合开场。
对齐幻觉
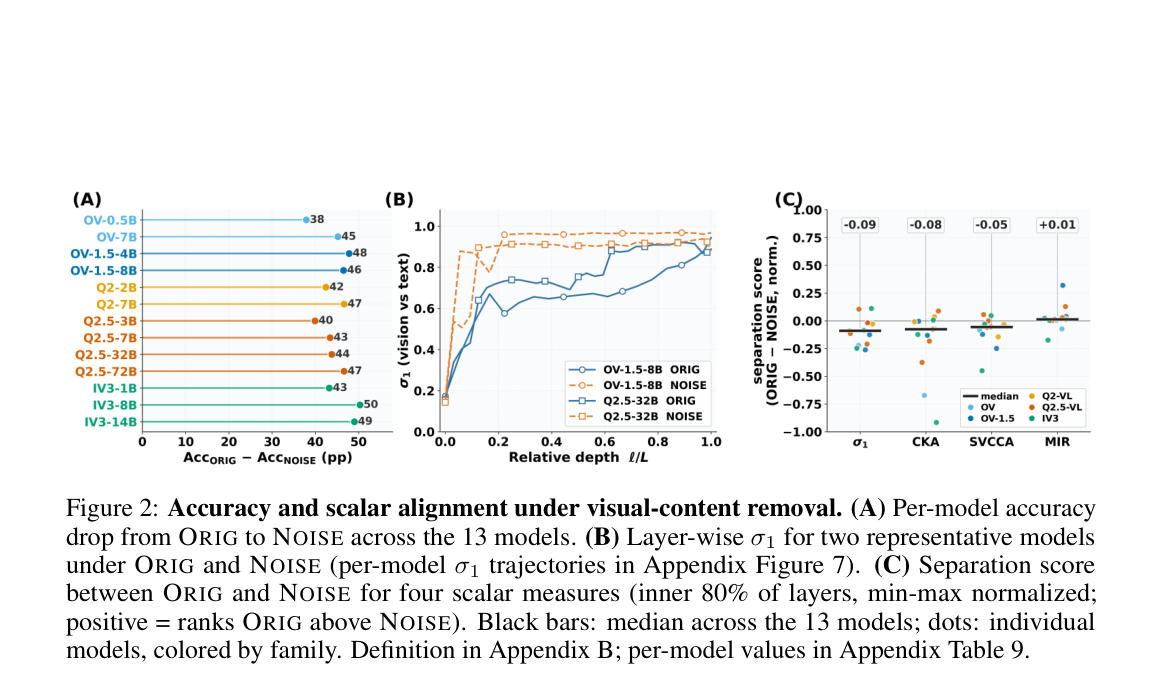
Fig.2 三面板主证据:(A) 13 模型 ORIG→NOISE 准确率掉 38–50 pp;(B) 代表模型层间 σ1 在 NOISE 下可更高;(C) 四类标量 separation 中位接近零或为负。适合作为结果主图与特色图。
机制与 PA gap
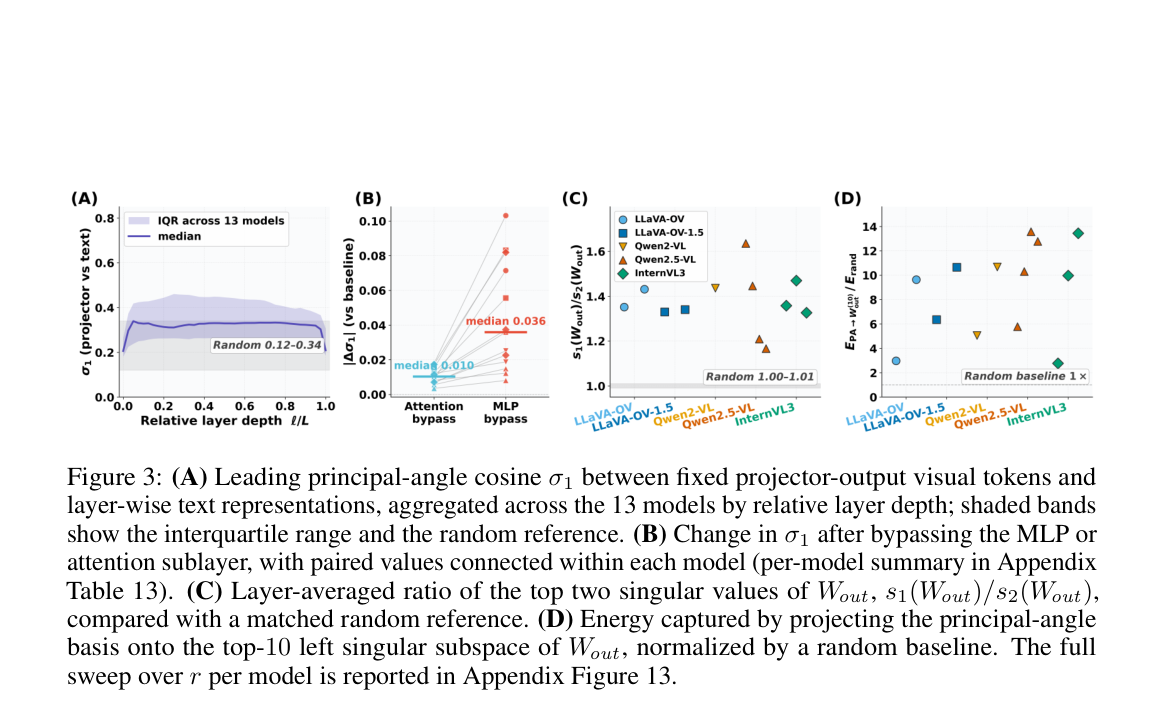
Fig.3 机制四步:固定投影视觉相对层间文本的 σ1 中位曲线;(B) MLP 旁路效应大于注意力;(C) Wout 的 s1/s2 各向异性;(D) 主角度基能量落在 Wout 主导奇异子空间。把幻觉追溯到共享 LLM 通路。
实验如何设计?
- 模型:LLaVA-OV、LLaVA-OV-1.5、Qwen2-VL、Qwen2.5-VL、InternVL3 五家族共 13 个,规模 0.5B–72B。
- 任务:MMBench 准确率;比较 ORIG vs NOISE 的准确率落差与层间对齐曲线。
- 机制:MLP/注意力旁路、Wout 各向异性与主角度能量重叠。
- PA gap:ORIG/NOISE 全谱对比、跨模型排序、α-mixing 相关;IRR/TEXT/SHUF 准确率与几何排序。
关键结果与论文证据
- NOISE 下准确率相对 ORIG 下降约 38–50 个百分点(Figure 2A);全体中位 NOISE−ORIG 约 −45.2 pp(Table 2)。
- σ1 在 NOISE 下可接近甚至超过 ORIG;Figure 2C 中 σ1/CKA/SVCCA 的 separation 中位分别为约 −0.09/−0.08/−0.05,MIR 约 +0.01,标量几乎分不开坏流(Figure 2)。
- 旁路 MLP 对 σ1 的层均变化中位约 0.036,约为旁路注意力(约 0.010)的 3.5 倍;Wout 的 s1/s2 在 1.2–1.6,高于随机参考;主角度基在 Wout top-10 子空间捕获能量约为随机基线的 2.8×–13.6×(Figure 3)。
- PA gap 是 Figure 4C 里唯一在全部 13 个模型上把 ORIG 排在 NOISE 之上的度量;α-mixing 下 Δ_PA 的 mean/median/min |r| 为 0.894/0.917/0.655,|r|>0.80 达 12/13,符号一致 13/13(Table 1)。
- IRR 相对 TEXT 仍掉准确率(全体中位约 −5.0 pp),且常比 NOISE 更差;SHUF 相对 ORIG 仅约 −0.8 pp,说明惩罚来自「处理了不相关结构」而非任意扰动(Table 2)。
阅读时需要注意
- 主实验围绕 projector-vLLM 设计与 MMBench;换架构或任务协议需再校准。
- PA gap 是几何诊断,不是直接因果证明「内容融合」;IRR 还显示内部几何与任务准确率可脱钩。
- 标量失败不等于所有表示分析方法无效,而是提醒不要把单一相似度当内容级证据。
- 公开稿未附独立代码/项目页时,复现依赖附录协议与模型清单。
关联工作
- 相对把层间相似度直接当作融合证据的诊断惯例,本文强调共享权重下的可检验解读。
- 与 Transformer 各向异性 / rogue dimensions 研究呼应:少数主导方向可扭曲相似度。
- 与 MIR、CKA、SVCCA、主角度谱等工具同场对照,指出何时需要多方向谱而非单一标量。