快速导读:WanPE 用视频锚定反向 SFT 与 SC-GRPO,把用户请求规划成跨镜头电影级文本条件,显著提升长时长文生视频的人类偏好。
文生视频越做越长:当代系统已经能到大约三十秒,并更忠实地跟随复杂文本条件。此时提示增强不再只是“把短句写漂亮”,而要在像素渲染前先写好整部短片的电影级脚本——动作、运镜、灯光、对白与声音如何跨镜头连贯展开。阿里 Wan Team 与南大等合作的 WanPE(arXiv:2609.30221)正是把提示增强重定义为可扩展的电影级规划架构。
WanPE 最大规模变体约 397B 参数,在约 105 万真实世界视频上学习;核心是视频锚定的反向监督构造,再用 Semantic-Consistency GRPO(SC-GRPO)在九个语义维度上保住用户约束。配套评测 WanPEval 含 249 条人工请求与约 1.1 万次盲测成对比较。项目页 https://wan-pe.github.io/ 。本文讨论的是提示增强与评测,不是替换视频生成骨干本身。
英文题目:WanPE: Towards Cinematic Prompt Enhancement for Modern Text-to-Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.30221
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现代 T2V 系统通常由提示增强器 πθ 与视频生成器 Gϕ 串联:用户请求 x 先变成文本条件 y,再渲染成视频。生成器训练目标多来自真实视频配对的视频锚定字幕分布 pvg;若增强器只做前向扩写,输出会落在合成改写分布上,与生成器条件分布错位(第1–2页,Fig.1 右 t-SNE)。
早期视频模型上下文短、跟指令弱时,增强多半是可选的外观润色;当生成器能吃长上下文并执行复杂指令时,增强器要负责整条制作链路的时间编排。难点有二:学习相互依赖的电影元素如何跨镜头组织;以及在长程计划中不丢、不改、不错绑用户指定主体、动作、对白、镜头与事件顺序(第2–3页)。
因此需要同时满足语义可行集合 Ysem(x) 与视频锚定分布对齐,而不是只堆描述性形容词。
核心创新
- 把提示增强重定义为可扩展的电影级规划架构。
- 视频锚定反向构造:先有真实电影结构,再学请求→计划映射。
- SC-GRPO 用九维奖励压制长程语义漂移。
- 提出覆盖 5–30 秒与多粒度意图的 WanPEval,并验证 4B–397B 一致有效。
方法概览
先从约 105 万真实视频字幕得到电影级条件并反推用户请求做 SFT;再用九维语义一致性奖励的 SC-GRPO 强化跨镜头保真;以 WanPEval 做文本与专家视频评测。
- 形式化上,理想目标是限制在语义有效输出上的视频锚定条件分布 p*;学习目标可写成对用户请求分布上的 KL 匹配(式3–4,第3页)。WanPE 把增强器输出做成层级电影条件:视频级概述 + 带时间戳的分镜计划,覆盖构图、主体、动作、灯光、运镜、转场、对白、音乐与音效。
- Video-grounded reverse SFT:先收集并过滤约 105 万、最长约三十秒、覆盖十类内容的真实片段;多模态字幕器按类别指令产出电影级目标 yi;再用 LLM 结合约两千条人工请求 few-shot 反推自然用户请求 xi,保证 yi∈Ysem(xi);最后对 (xi,yi) 做负对数似然 SFT(Fig.2 左,第4–5页)。
- SC-GRPO:在约 1.5 万条覆盖广与难例混合的请求上,对同一 x 采样一组条件,用九维语义一致性奖励 rsem(风格、主体、动作、对白、声音、镜头、灯光、空间关系、场景)做组相对优势更新,并加相对 SFT 参考的 KL 惩罚,专门压制遗漏、改写、错绑与跨镜头冲突(Fig.2 右,第5页)。
- WanPEval:249 条人工请求,覆盖 5/10/15/30 秒、意图/场景/分镜粒度与七类内容;文本侧用同一 rsem,视频侧由约六十位影视相关专家做匿名成对偏好,报告下/上界与综合偏好分 S 以及 Bradley–Terry 分(第5–6页)。
- 规模上从 Qwen3.5 初始化 4B/9B/35B/397B 四档;主实验默认把增强结果交给 Wan3.0 视频生成器。经格式适配后也可迁移到其他生成器原生增强接口(第6、8页)。
逐图理解论文
问题背景
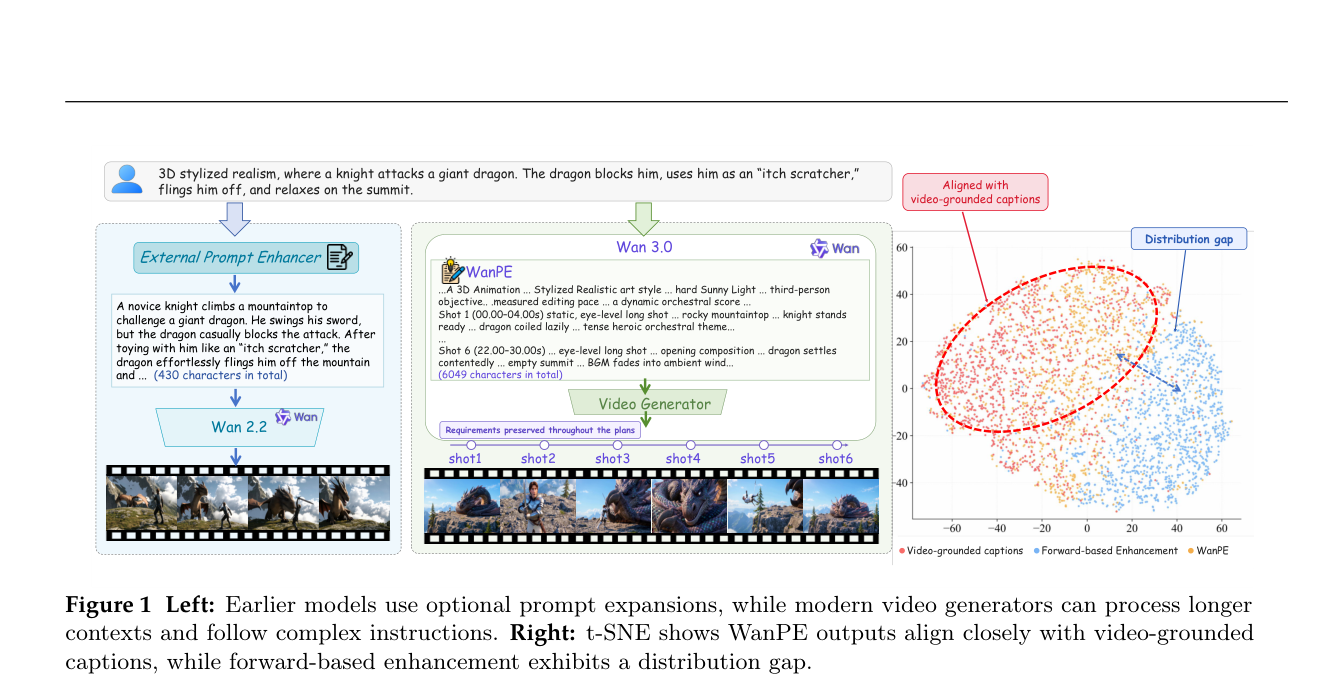
Fig.1 左:同一骑士打龙请求,早期外挂增强只扩到约 430 字并喂给 Wan2.2 短片;WanPE+Wan3.0 产出约 6049 字分镜计划并保住跨镜头需求。右:t-SNE 显示 WanPE 与视频锚定字幕重叠,前向增强另成一簇。适合开篇建立“电影级规划 vs 润色”印象。
方法总览
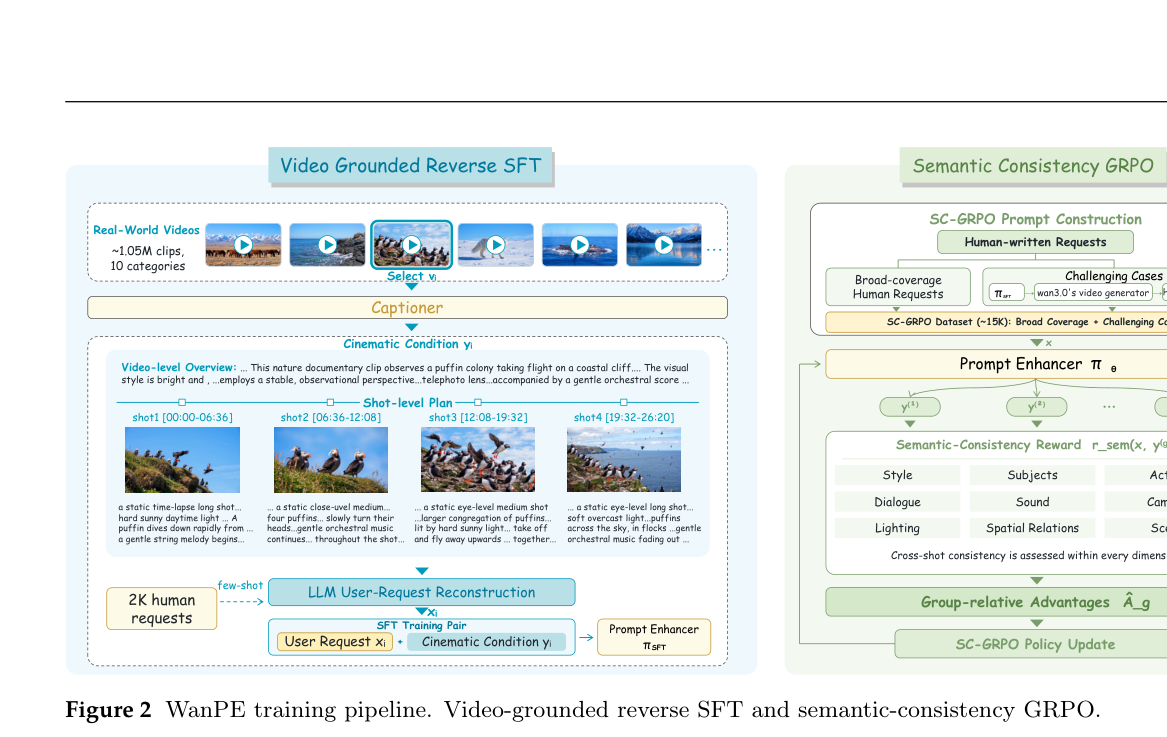
Fig.2 训练总图:左支真实视频→字幕器→电影条件→LLM 反推用户请求→reverse SFT;右支约 15K 请求上多样本采样,九维语义奖励驱动 SC-GRPO。适合作为方法主图与特色图。
关键证据
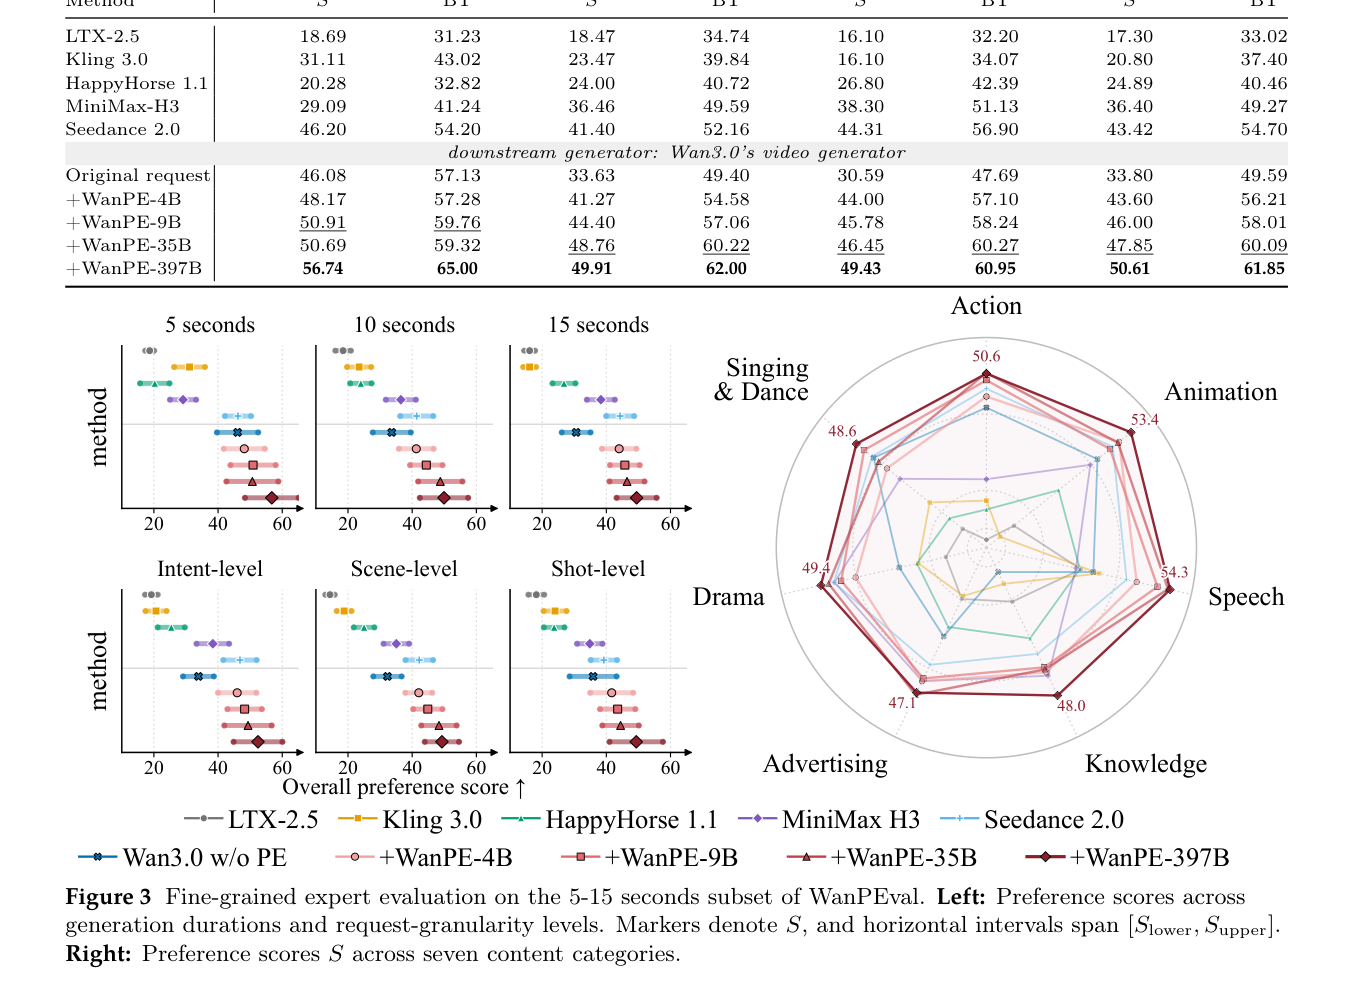
Fig.3/Table1 细粒度专家评测:时长与意图粒度点线图、七类内容雷达图均显示 +WanPE-397B 偏好最高;配合表中总体 S 50.61、BT 61.85 阅读规模与增益。
实验如何设计?
- 主对比:WanPEval 5–15 秒子集上对比 LTX-2.5、Kling 3.0、HappyHorse 1.1、MiniMax-H3、Seedance 2.0、无增强原请求,以及四档 WanPE;30 秒子集主要对比 Seedance 2.5(Table 1–2,第7–8页)。
- 监督消融:Forward Rewriting、Forward-target SFT 对比 reverse 的 WanPE-397B-SFT(Table 2 Exp2)。
- 跨生成器:在 LTX-2.5-Base 与 MiniMax-H3-Base 上,把格式适配后的 WanPE-397B 与各自原生增强器对打(Table 2 Exp3)。
- 训练分析:不同规模上 SC-GRPO 对语义一致性的增益,以及奖励曲线等(第8–9页)。
关键结果与论文证据
- 同后端 Wan3.0 下,WanPE-397B 相对原请求在 5/10/15 秒分别提升偏好分约 10.66、16.28、18.84 点;30 秒上把 S 从 9.38 拉到 60.24,增益约 50.86 点,说明时长远了增强更关键(第7页)。
- 5–15 秒总体:WanPE-397B 录得 S 50.61、BT 61.85,各时长均列第一,相对 Seedance 2.0 的 S 高出约 7.19 点;意图/场景/分镜粒度上相对无增强分别约 +18.55/+16.97/+13.45(Table 1、Fig.3)。
- 30 秒:总体 S 60.24,与 Seedance 2.5 的 59.76 接近;动画与演讲子类分别到 81.25 与 73.68(Table 2)。
- 反向监督明显强于前向:WanPE-397B-SFT 总体 S 49.86,高于 Forward Rewriting 39.49 与 Forward-target SFT 35.17(Table 2)。
- 跨生成器:LTX 上 WanPE 35.56 vs 原生 PE 21.11;MiniMax 上 41.09 vs H3-Context-IR 35.92。摘要还报告 SC-GRPO 跨尺度把语义一致性抬高约 18.6–23.3 点(第3、8页)。
阅读时需要注意
- 主视频评测依赖专家成对偏好,成本高,且不等于单一自动指标可完全复现。
- 大量结果绑定 Wan3.0 后端;跨生成器需格式适配,不同 API 能力上限仍会封顶增益。
- 反向字幕与请求重建依赖多模态字幕器与 LLM,噪声会进入 SFT 目标。
- 397B 与大规模训练资源门槛高;文中不声称开源全量权重或实时交互改写时延。
关联工作
- 相对传统前向提示扩写与多步 LLM 精炼,WanPE 强调与视频锚定字幕分布对齐的电影级规划。
- Seedance、Kling、MiniMax、LTX 等构成商业/公开系统对照;Wan2.2 代表早期“可选润色”范式。
- GRPO 提供组相对策略优化骨架;WanPEval 面向时长与意图粒度的专门评测。