快速导读:LIRSeg 用少量可学习潜空间令牌完全替代显式 CoT,经空间对齐与 GRPO,并配合 EAS/DES/LDA,在推理分割上提点同时把推理令牌压到约十六分之一。
推理分割要求模型读懂隐式自然语言查询,并给出细粒度掩码,服务人机交互与具身智能。主流做法是先让多模态大模型写出显式思维链,再去定位目标;直觉上像“先想清楚再动手”,但冗长文本令牌会挤占感知注意力,并把视觉令牌推得更远。
LIRSeg(Skip the Talk, Re-Focus on Vision,arXiv:2609.30783 ,国防科技大学)主张少说话、重回视觉:用 K=4 个可学习潜空间令牌完全替代显式 CoT,先做空间对齐,再用分割奖励的 GRPO 优化,并配上极端优势采样、解耦探索-稳定更新与潜空间多样性放大。
英文题目:Skip the Talk, Re-Focus on Vision: Latent Reasoning for Reasoning Segmentation in Multimodal Large Language Models
论文出处:arXiv 每日论文精选 · arXiv:2609.30783
原始论文:PDF / 论文页面
这篇论文解决什么问题?
显式 CoT 在推理分割里会产生两类干扰:文本令牌与感知令牌竞争注意力,以及有效距离拉大后更难把查询对齐到图像证据。结果是注意落在推理文本提到的干扰物上,掩码漂离真正目标。
强化学习可以靠感知奖励改善泛化,却也可能鼓励更长、更散的思维痕迹。已有工作试图用难度估计截断长度,或拆成两趟短描述,但仍停留在“压缩口头推理”。
LIRSeg 的关键判断是:分割最终需要的是紧凑、与视觉对齐的内部状态,而不是可读长文;因此把推理留在连续潜空间,解码侧直接产出描述与框给 SAM。
核心创新
- 用少量潜空间令牌完全替代显式 CoT,削减推理文本干扰并缩短视觉-感知路径。
- 两阶段:潜空间空间对齐 SFT + 分割奖励 GRPO。
- 信息视角三件套:EAS、DES、LDA,专治紧凑令牌信号弱、梯度冲突与坍缩。
- 同骨干下相对 VisionReasoner 在 ReasonSeg/MUSE/MMR 提点,推理令牌约 16× 压缩。
方法概览
推理时 MLLM 生成 K=4 个潜空间令牌做隐式推理,再输出目标描述与框,交给 SAM 得掩码。训练两阶段:Stage-1 用 T2M/M2T 空间损失把潜令牌对齐到目标相关视觉证据;Stage-2 用分割奖励的 GRPO 优化。为提升紧凑令牌信息量,引入极端优势采样(提高优势方差)、解耦探索-稳定更新(冲突时正交化稳定梯度)、潜空间多样性放大(抑制表征坍缩)。
- 推理流程:图像与问题进入 MLLM,生成 <LAT1>…<LAT4>,经潜空间推理得到 target_desc 与 bbox,再交 SAM 输出掩码。默认骨干 Qwen2.5-VL-7B,分割器 SAM3。
- Stage-1 潜空间空间对齐:在最后一层与 LAT 嵌入上做 SFT。T2M 用 BCE+Dice 对齐任务到掩码;M2T 用高斯平滑后的掩码监督令牌级语义;总损失 L_spatial = L_T2M + L_M2T,给 RL 一个非随机初始化。
- Stage-2:旧策略采样 n=16 条 rollout,用分割奖励算优势,再更新策略。为让只有 4 个令牌仍够用,引入三机制:EAS 只取极端高/低优势样本抬高 Var[A];DES 在探索与稳定梯度冲突时把稳定项正交化;LDA 用软加余弦惩罚抑制令牌同质化。
- 信息视角下,三机制分别针对“优势信号塌缩”“探索-稳定互相抵消”“潜表征熵远低于容量上限”三类瓶颈,消融显示去掉任一组件都会掉点。
逐图理解论文
注意干扰
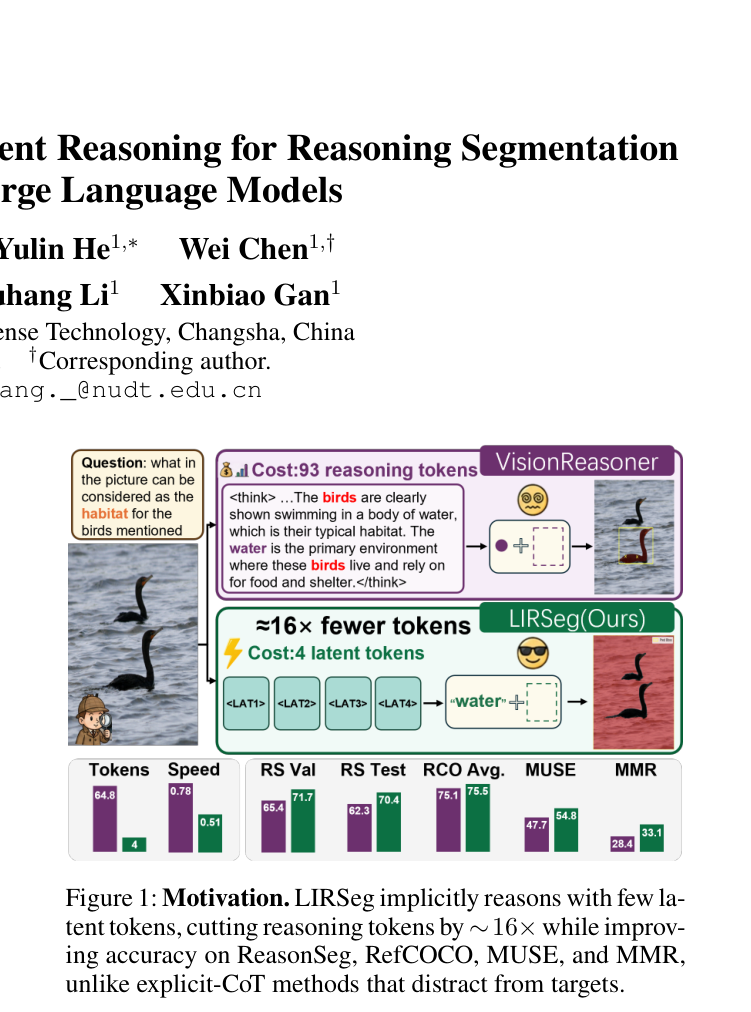
图1动机图:同一观鸟栖息地问题,VisionReasoner 用约 93 令牌显式思考且易分心,LIRSeg 仅 4 个潜令牌;下方条形图显示令牌约 64.8→4.0,ReasonSeg/MUSE/MMR 精度上升。
潜空间框架
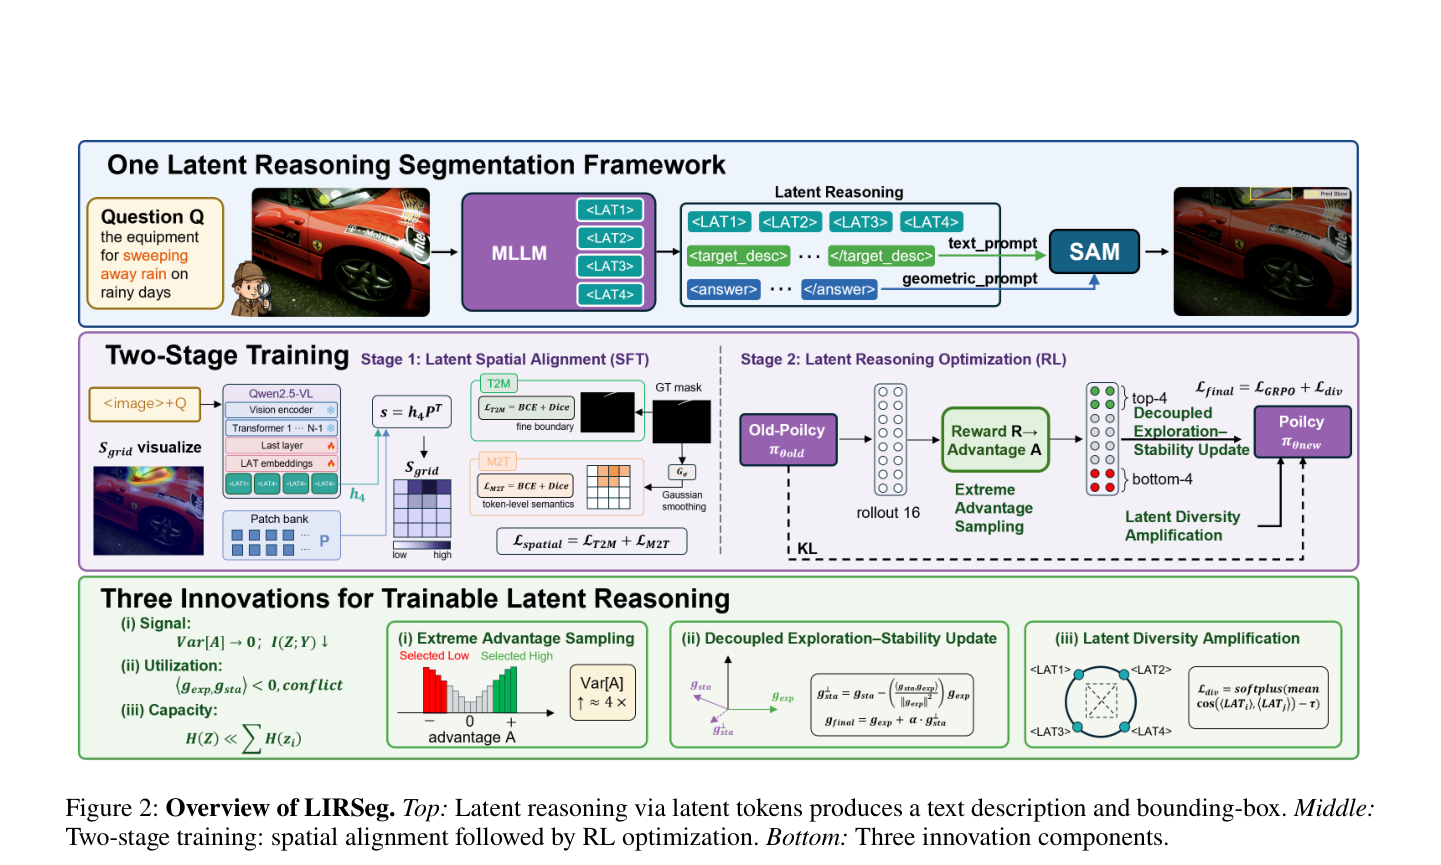
图2总览:上为潜令牌→描述/框→SAM;中为空间对齐 SFT 与 GRPO;下为 EAS、DES、LDA 三创新。适合方法主图与特色图。
关键证据
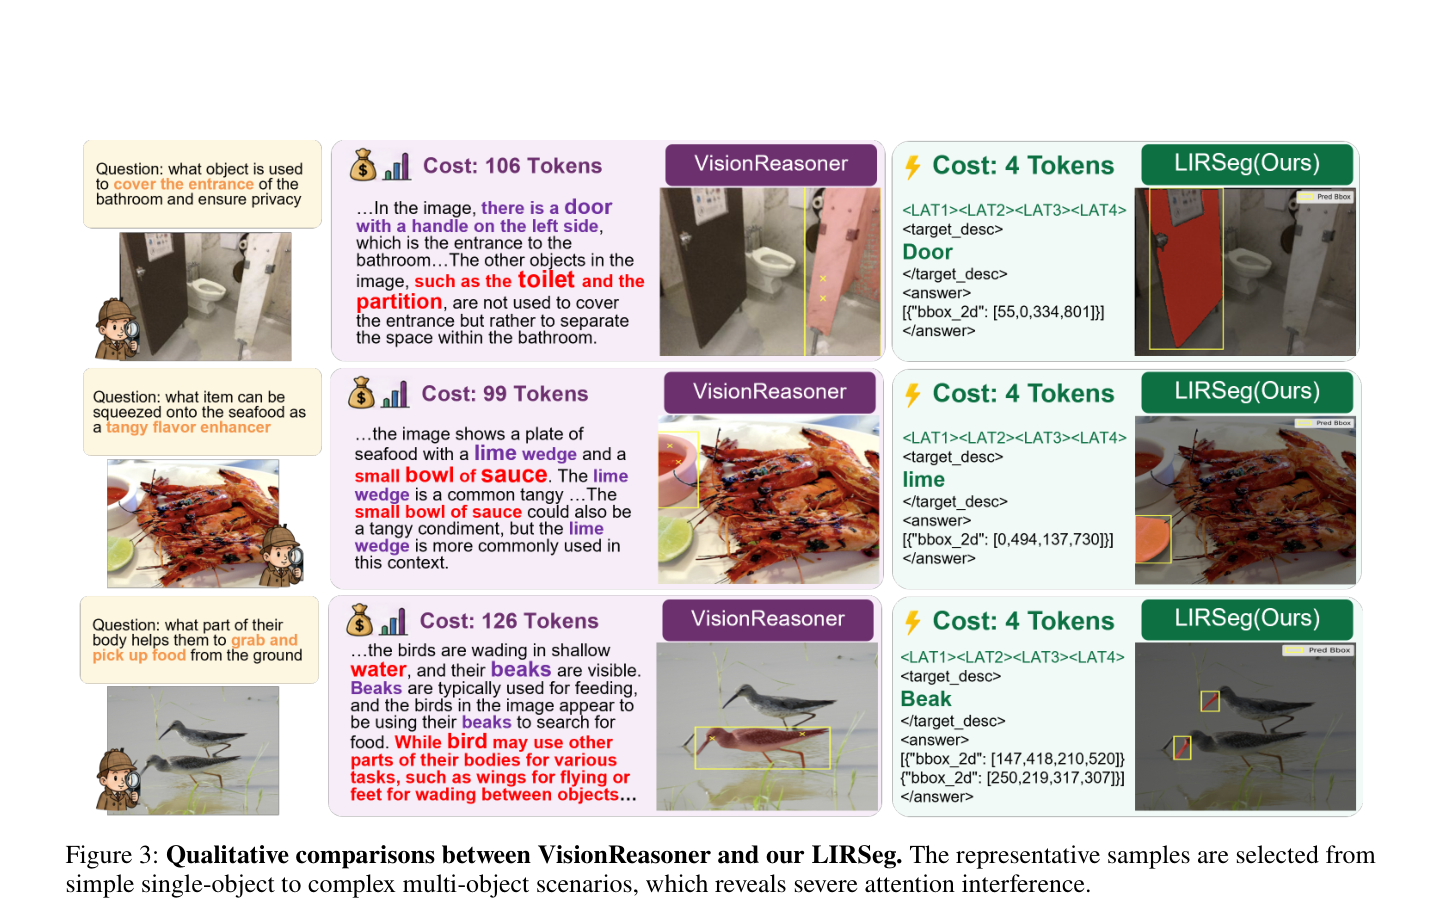
图3定性对照三例(浴室门、柠檬、鸟喙):显式 CoT 高令牌且注意干扰,LIRSeg 固定 4 令牌并给出更准的目标描述与框。
实验如何设计?
- 训练:ReasonSeg 训练数据,或仅 VisionReasoner 数据的零样本迁移设定(表中 *)。Stage-1 约 500 step SFT;Stage-2 RL 5 epoch,Kh=Kl=4。
- 主评测:ReasonSeg val/test 的 gIoU/cIoU 与平均推理令牌;MUSE、MMR;RefCOCO/+/g。
- 诊断:组件消融、K∈{2,4,8}、按显式基线 think-token 中位数划分难易、跨 MLLM/分割器组合。
- 定性:同图对比 VisionReasoner 长 CoT 注意涣散与 LIRSeg 四点潜令牌聚焦。
关键结果与论文证据
- ReasonSeg 上 LIRSeg 录得 val 71.7/67.7、test 70.4/63.8 gIoU/cIoU,相对同骨干 VisionReasoner 约 +5.9/+6.2 与 +4.9/+4.6,同时令牌从约 64.8 降到 4(约 16×,页5,图1)。
- MUSE val/test gIoU 相对 VisionReasoner 约 +5.3/+7.1;MMR test 约 +4.7;RefCOCO 系列 78.7/75.0/72.7,说明潜空间推理未牺牲常规指代能力(页6)。
- 图3 显示从单目标到细粒度部位:显式 CoT 常 99–126 令牌且注意散到干扰物,LIRSeg 固定 4 令牌并给出更贴目标的框/掩码。
- 难样本 ΔgIoU 约 +8.9,高于易样本约 +3.1,说明收益主要来自抑制过思干扰;K=4 最优,K=2 容量不足、K=8 冗余掉点(页7)。
- 去 EAS/DES/LDA 各掉约 2–3 点,去 LDA 到约 68.2 gIoU 最伤;换骨干/分割器仍相对显式对照保持优势,显示框架可迁移(页7)。
阅读时需要注意
- 潜令牌缺乏人类可读中间步骤,调试可解释性弱于显式 CoT。
- K 需要折中,过大过小都会伤精度。
- 不同数据配比与带 * 设定会影响横向对比,阅读表格需看清训练协议。
关联工作
- VisionReasoner、Seg-Zero 代表显式推理 + RL 分割主线。
- PixelThink、DR2Seg 从长度控制角度缓解过思。
- LISA 等指代分割模型构成 RefCOCO 对照坐标。