快速导读:GazeME 提出 Target Saliency Boosting:用 <focus>/<unfocus> 可学习标记把相对显著性意图写进提示,经 SPMA 与显著性语义数据只训标记嵌入,在无视觉先验下抬高指定物体显著性。
文生图已经很会按提示摆放物体,却很少直接回答另一个设计问题:画面里谁该先抓住观众的目光。广告要产品出挑,插画要主角压过配角;这不只是“有没有生成出来”,而是物体间相对显著性怎么分配。
论文 Amplify What You Gaze At(arXiv:2609.30733 ,同济大学、上海创智学院与复旦)提出 Target Saliency Boosting,并用轻量框架 GazeME:在提示里插入可学习的 <focus>/<unfocus> 标记,无需用户绘制显著性图,也能抬高指定目标的视觉显著性,同时尽量保住语义对齐与画质。
英文题目:Amplify What You Gaze At: Target Saliency Boosting in Text-to-Image Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.30733
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视觉注意力纠缠低层对比、全局构图与高层语义,传统控制容易偏到放大、居中、提亮等粗糙手段,精度不足。
显著性是相对的:抬高目标往往会牵动其他物体,可能破坏场景协调;只改写提示或事后编辑,又常把背景糊掉、把目标撑大,像走捷径而非真正重分配注意。
更缺的是语言接地、带物体级显著性分数的监督数据,使模型难以学会“强调谁、抑制谁”的双向意图。
核心创新
- 提出 Target Saliency Boosting:无需显著性图视觉先验,仅用自然语言指定要抬高显著性的物体。
- 显著性标记提示:可学习 <focus>/<unfocus> 成对标记编码相对强调/抑制意图,只训嵌入、轻量保泛化。
- SPMA 按物体级显著性做随机激活与有序截断,逼标记学相对关系而非背固定模式。
- 自动建显著性语义数据集,并把标记引导生成接到 LLM 构图的推理流程。
方法概览
GazeME 三阶段:(1) 用基座模型合成多物体图,SAM3 分割,AAM 估显著性图,再按改造 NSS 得到物体级分数,建成语言接地的显著性语义数据;(2) 冻结 FLUX.1-dev,只优化四个标记嵌入;SPMA 按分数高低分组、随机激活并做有序截断,构成双向训练样本,用 flow matching 损失;(3) 推理时 LLM 识别竞争物体,给目标包 <focus>、给其他包 <unfocus>,再生成。训练约 2000 步、batch 2、AdamW 3e-4,单卡 H20。
- 交互形式是显著性标记提示:用 <focus>…</focus> 包住要抬高的物体描述,用 <unfocus>…</unfocus> 包住要压低的物体;未标记物体保持中性。图1用狗/猫与女人/男人/小孩两组例子说明语义不变、只改相对强调。
- 数据管线先合成多物体图,再经 SAM3 分割与过滤,用 AAM 估像素显著性图,并按改造 NSS 聚合为物体级分数 si,得到图像—提示—物体显著性列表。
- 训练冻结 FLUX.1-dev,只优化四个标记嵌入。SPMA 先按阈值 γ 分高低显著性组,再按与阈值距离随机激活,最后按显著性排序截断,避免矛盾激活;损失为 flow matching,约 2000 步、batch 2、AdamW 学习率 3×10⁻⁴。
- 推理时输入源提示与目标物体,LLM 找出其余物体,构造目标增强标记提示:目标加 focus、竞争物体加 unfocus,再交给带学会标记的生成模型输出。
逐图理解论文
GazeME 框架
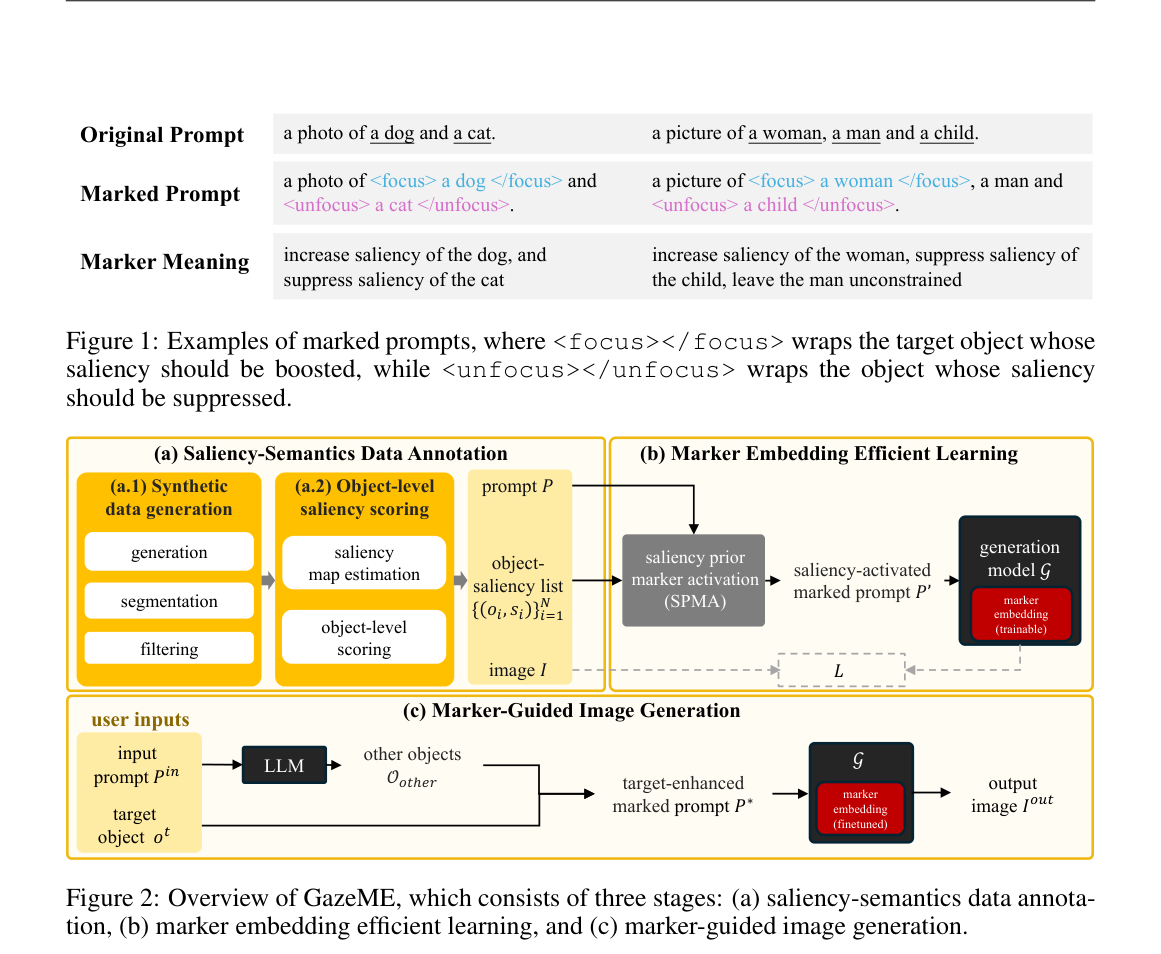
图2是 GazeME 总览:上半(a)合成—分割—过滤与物体级打分建库;(b) SPMA 激活标记提示并只训标记嵌入;(c) 推理时 LLM 构图目标增强提示再生成。适合做方法主图与特色图。
关键证据
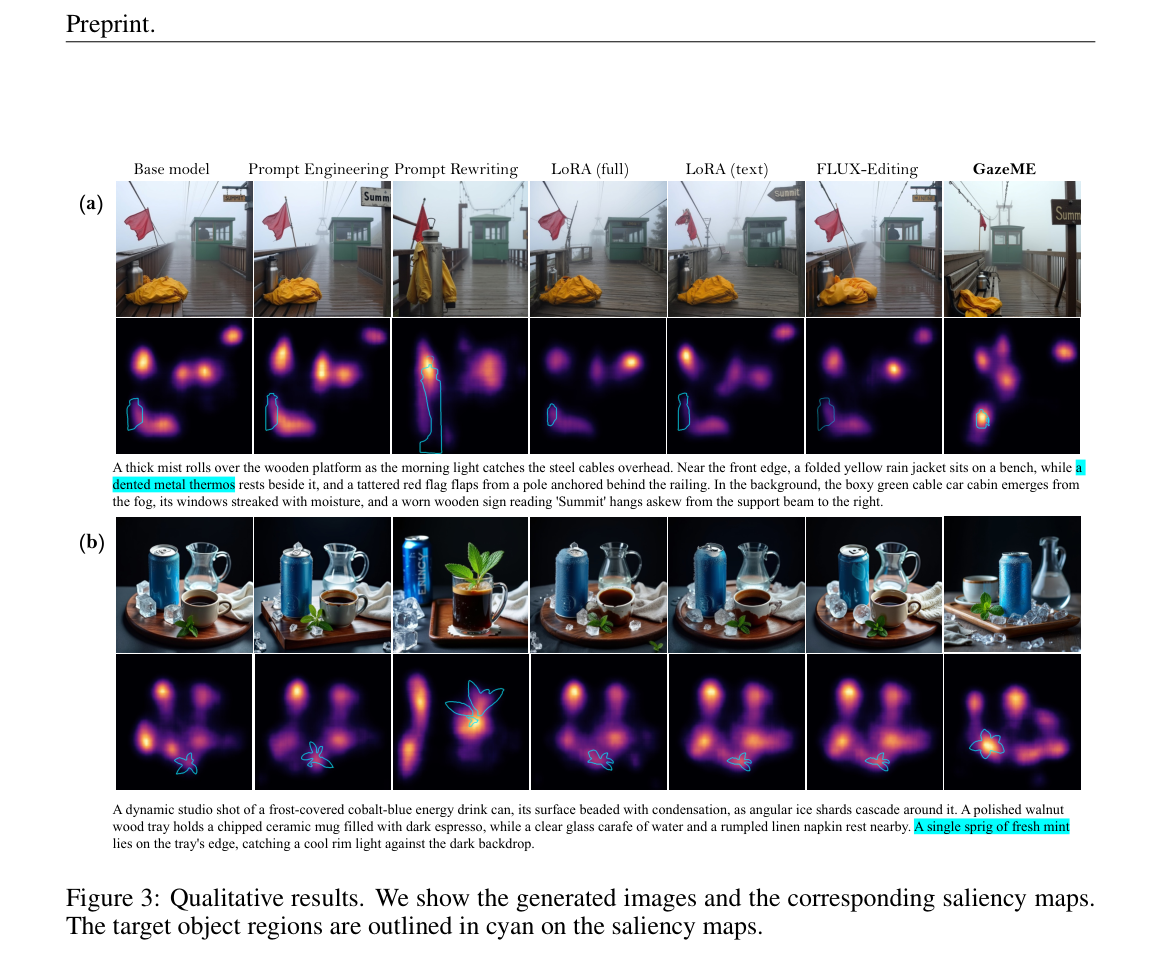
图3对比 Base、提示工程/改写、两类 LoRA、FLUX-Editing 与 GazeME:上方生成图、下方显著性图并用青色勾目标。GazeME 更常把保温杯、薄荷枝等目标推到显著峰。
结论与局限
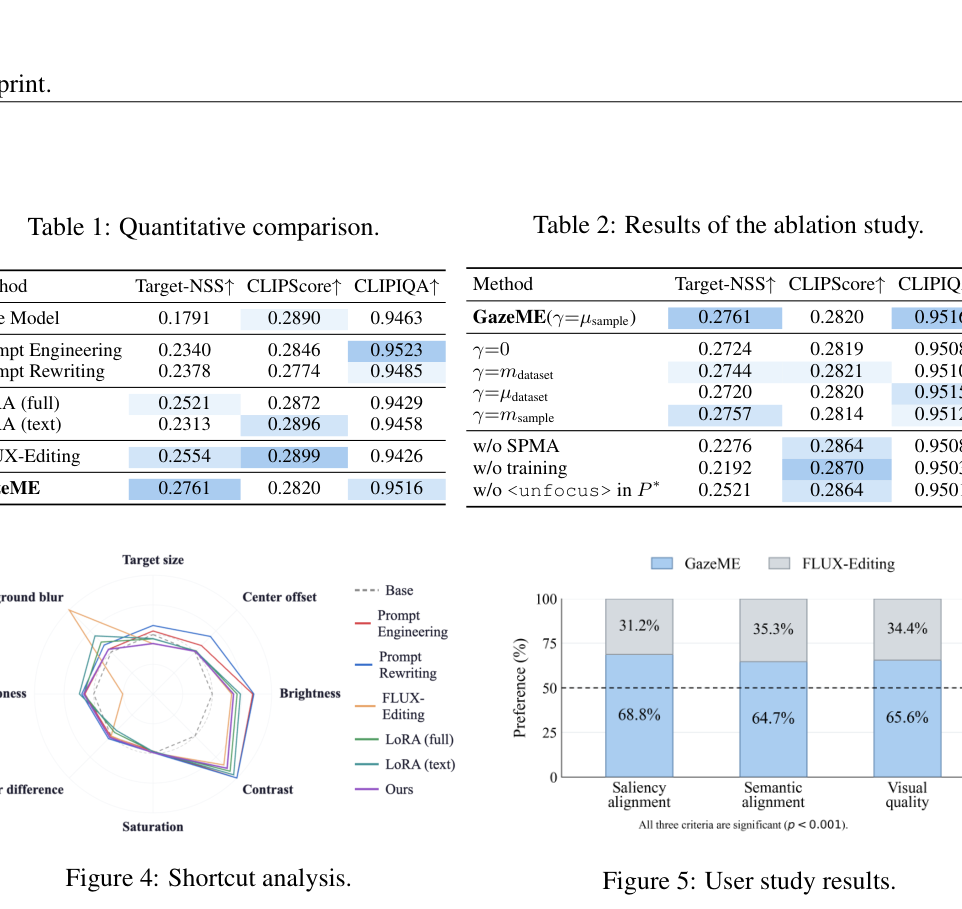
该资源含定量表、捷径雷达与用户研究:GazeME Target-NSS 最高且低层捷径更克制;相对 FLUX-Editing 在显著性/语义/画质三项人气均过六成。
实验如何设计?
- 自建 432 项测试:先用冻结基座生成,再选其显著性分布下半的物体作目标,专门考“默认不突出”的难例。
- 基线含 Prompt Engineering、Prompt Rewriting、LoRA(full)、LoRA(text)、FLUX-Editing。
- 主指标 Target-NSS(越高目标越显著),辅以 CLIPScore 与 CLIPIQA;另做八维低层因子捷径分析、消融与 26 人用户研究。
关键结果与论文证据
- Table 1:GazeME Target-NSS 达 0.2761,高于 Base 0.1791、FLUX-Editing 0.2554 与 LoRA(full) 0.2521;CLIPScore 0.2820、CLIPIQA 0.9516,说明抬显著性并非靠砸语义或画质换分(页8)。
- 图3定性显示,雾中平台上的瘪金属保温杯、托盘边缘薄荷枝等小目标,GazeME 更常成为显著性图主峰,而提示工程与编辑基线易旁溢到其他物体或引入不自然伪影。
- 捷径雷达图上,FLUX-Editing 偏背景模糊,提示类方法偏放大/居中/提亮提对比;GazeME 相对基座偏离更均匀、幅度更小,更像注意力重分配(页8)。
- 消融:去掉 SPMA 落到 0.2276,去掉训练 0.2192,推理去掉 <unfocus> 仍到 0.2521,说明双向标记与 SPMA 都关键;γ 取样本均值最稳(页8–9)。
- 用户研究相对 FLUX-Editing:显著性对齐 68.8%、语义 64.7%、画质 65.6%,三项二项检验均 p<10⁻³(页9)。
阅读时需要注意
- 自动显著性与分割标注会带噪;遮挡与空间交互未显式建模。
- 当前只覆盖静态图;视频需要跨帧一致的标记策略。
- 预印本阶段,公开代码/项目页在摘要中未给出,复现需等待作者释放测试集与权重。
关联工作
- GazeFusion 代表“先给显著性图再生成”的路线;本文把条件改成自然语言标记。
- GLIGEN、SpaText、AnyControl 等强调空间布局控制,与“相对显著性”正交互补。
- AAM、SAM3 与 FLUX.1-dev 构成标注与生成底座;LoRA 与指令编辑是同任务的训练/后处理对照。