快速导读:在 Qwen2.5-VL-3B 与 PMC-VQA 上,用正确/无图/打乱图干预与配对转移,审计 SFT 与 GRPO 后训练如何改写个体图像收益,而非只看平均准确率;本文是研究审计,不是临床产品。
医学视觉语言模型做对一道题,未必真正用了图像:它也可能吃题面措辞或答案先验。后训练若只盯平均准确率,可能在“总分差不多”的同时,悄悄改写哪些题仍依赖正确图像、哪些题已变成语言捷径。
Wang Jingxin(中科院神经所)的受控审计(arXiv:2609.31450 )在 Qwen2.5-VL-3B 与 PMC-VQA 上,用 Correct / NoImage / Shuffled 干预与同一题的配对追踪,比较语言 LoRA SFT、更广多模态适配与答案-only GRPO,并审计证据目标的 token 计量路径。务必强调:这是方法与评测审计,不是面向临床的诊断产品,也不构成医疗建议。
英文题目:From Reward Signal to Visual Utility: A Controlled Audit of Medical VLM Post-Training
论文出处:arXiv 每日论文精选 · arXiv:2609.31450
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Beyond Accuracy 一类工作已表明:正确图与打乱图的准确率差,可以拆成视觉收益(VBR)与视觉伤害(VHR)。但检查点级对比仍难回答:后训练具体让哪些题获得或失去视觉收益?
MedVLThinker 等结果显示,文本侧可验证奖励强化学习也能冲高分,进一步提示“准确率≠图像条件决策质量”。
若优化信号、参数更新与 held-out 视觉行为脱节,研发者可能误把训练活跃或训练集证据分数上升,当成更可靠的医学多模态推理。
核心创新
- 把干预定义的视觉效用扩展到后训练阶段的配对问题追踪,区分获得/失去的视觉收益事件。
- 在同一 clean-test 上比较语言/多模态适配范围与答案-only GRPO 的准确率—视觉收益权衡。
- 审计选项打分的 token 路径:规范前缀与贪心生成路径不一致时,证据目标的解释会翻转;再做等剂量迁移检验。
方法概览
骨干为 Qwen2.5-VL-3B-Instruct。SFT 用 1 万题一回合,VALID 1,500 题选点,冻结 clean-test 2,000 题(1,440 图像哈希,与训练无重叠)。在 Correct/NoImage/Shuffled 下定义 Task、VBR、VHR、IS、VDS(100)、LSR(111)。比较语言 LoRA(M1-L)、加 merger(ML)、再加视觉 LoRA(VML);标准答案-only GRPO;以及沿生成路径计量的反事实证据目标(M4)与等剂量 GRPO(M2)对照。另在 SLAKE 做原生答案诊断。
- 共同骨干为 Qwen2.5-VL-3B-Instruct。SFT:1 万训练题、一回合;1,500 VALID 选点;冻结 clean-test 2,000 题、1,440 图像哈希,训练与测试经图像内容与图文比对确认无重叠。
- 三条件评估:Correct(匹配图)、NoImage(去图)、Shuffled(替换图)。Task=mean(C);VBR=P(C=1,S=0);VHR=P(C=0,S=1);IS 衡量答案是否随图像条件翻转;三位码 C/N/S 进一步区分 VDS(100) 与 LSR(111) 等模式。
- 适配范围:语言注意力 LoRA(约 7.37M 可训练参数)为 M1-L;再开 multimodal merger;再加视觉 LoRA。标准 GRPO 用组内相对奖励(G=4),审计混合奖励组比例与适配器是否真更新。
- 证据目标:在正确图与改写图条件上比较金标答案分支分数;关键发现是规范选项前缀与自然语言生成分支可不一致,必须沿贪心生成路径计量。等剂量对照比较 M4(证据项)与 M2(标准 GRPO)。
- SLAKE 原生答案实验用于观察:答案内容似被学会,但终止与可用完整回复仍可能失败。
逐图理解论文
配对审计
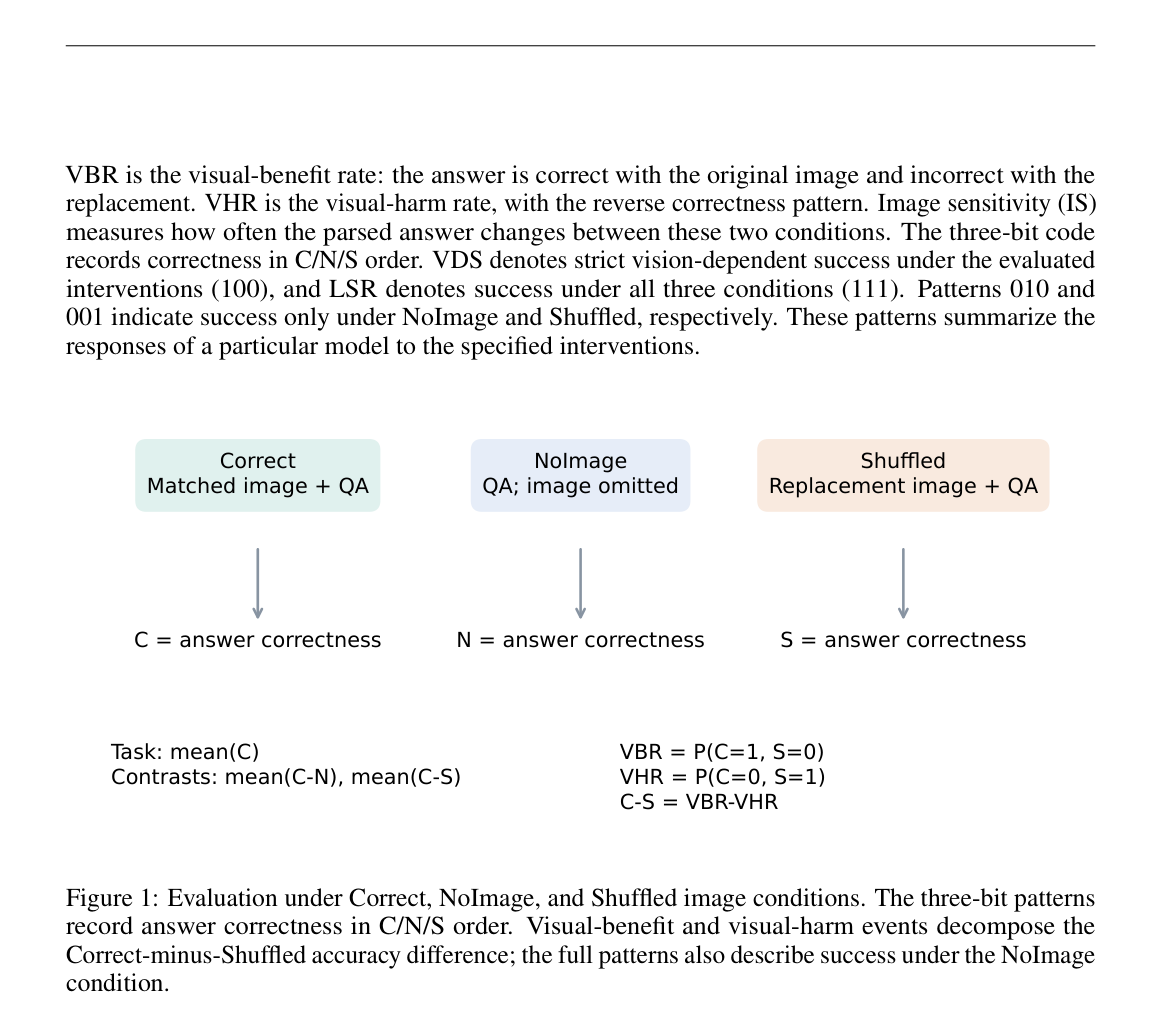
图1定义 Correct / NoImage / Shuffled 三条件与 VBR、VHR、C-S 分解,以及三位码模式。是全文审计语言的入口图,适合做特色图。
SFT与范围
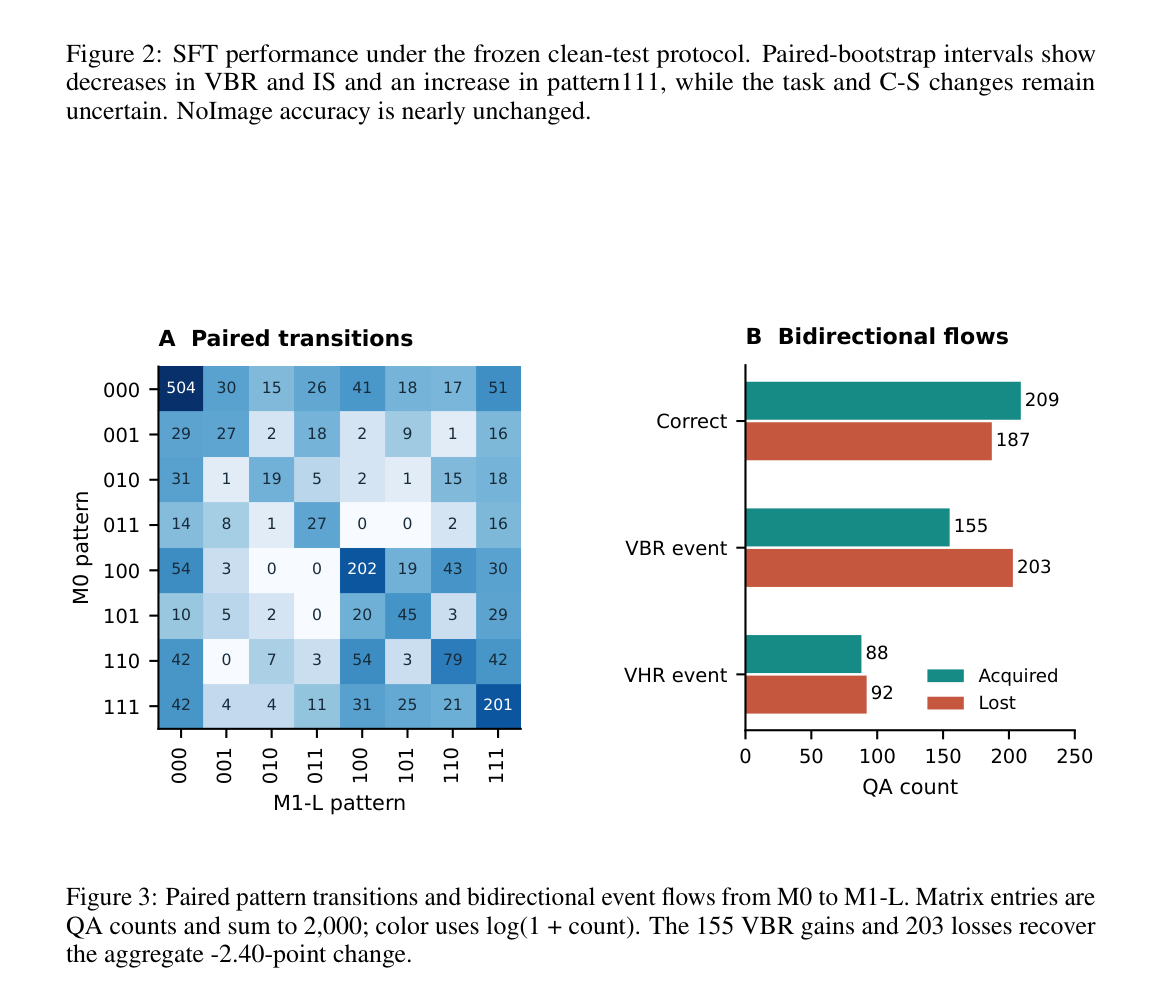
图3给出 M0→M1-L 的 8×8 配对模式转移与 Correct/VBR/VHR 双向流量:155 获、203 失的视觉收益事件,把“小净变化”拆成大规模个体翻转。
证据目标
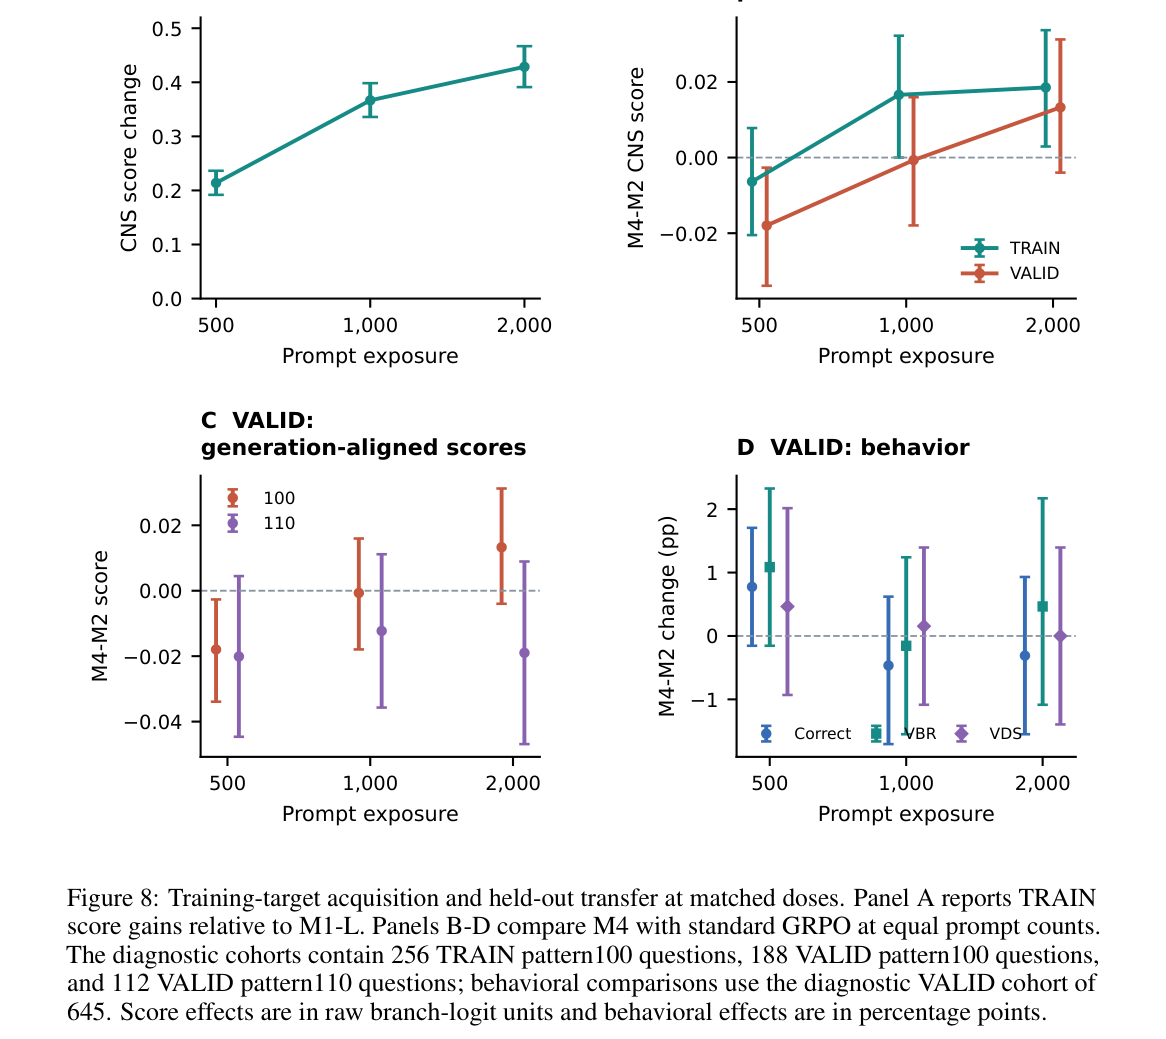
图8展示证据目标在 TRAIN 上随剂量抬升,但与标准 GRPO 等剂量对照时 VALID 分数与 Correct/VBR/VDS 行为优势并不稳定,支撑“优化活动≠held-out 视觉行为”的结论。
实验如何设计?
- 主结果在冻结 PMC-VQA clean-test 上报告配对变化与 bootstrap 区间。
- SFT 与适配范围比较使用 VALID 选点后的同一 clean-test 队列。
- GRPO 报告训练信号(非零奖励方差组比例)、检查点审计与相对 SFT 初始化的 clean-test 差分。
- 证据目标报告 TRAIN 目标增益,以及 500/1,000/2,000 prompts 等剂量下的 VALID 分数与行为指标。
- 生成路径审计覆盖 13,500 条轨迹、94,500 生成步,并做逐步回放一致性检查。
关键结果与论文证据
- 语言 LoRA SFT 使 correct-image 准确率变化 +1.10 pp(CI 跨零:-0.85 到 +3.05),同时视觉收益事件下降 2.40 pp、图像敏感度下降 5.60 pp(页1、摘要)。
- 配对转移显示 155 次获得与 203 次失去视觉收益事件,解释了“平均几乎不动、个体大量换血”(图3,页6)。
- 更广多模态适配相对语言 LoRA 降低 correct-image 准确率;扩大可训练范围并不自动换来更好的图像条件决策(图5,页9)。
- 标准 GRPO 可观察到混合奖励组与参数更新,但 clean-test 准确率变化仍不确定,说明优化活跃≠可靠提升(图6,页10)。
- 规范打分与生成答案在 Correct VALID 上可有 60.4% 不一致;沿生成路径后,证据目标的“改进叙事”会改写。TRAIN 上目标分数随剂量上升,但等剂量相对 GRPO 的 VALID 迁移不稳定(页11–13,图8)。
阅读时需要注意
- 单骨干、单主基准,不能直接外推到更大模型或其他医学数据集。
- 跨条件原始 logit 目标对任意条件常数敏感;生成对齐解决计量分支,不消除该结构性问题。
- SLAKE 分支强调终止监督可能关键,但仍是诊断而非完整解决方案。
- 读者不应把任何准确率数字理解为临床可用性能;本稿只讨论研究评测。
关联工作
- Beyond Accuracy、CORAL 提供干预与反事实 grounding 坐标。
- MedVLThinker 与医学 RL 文献提示数据、初始化与奖励设计的重要性。
- PAPO、Ground-R1、感知一致性奖励等工作描述 grounding 导向目标族;本文强调计量路径与剂量对照。