快速导读:CoVLM-Bench在同一批车路协同真实成对场景上对齐CDQA与协同规划目标,并给出统一VLM基线CoVLM-Drive。
自动驾驶里的视觉语言模型已经能在自车视角上做场景问答、链式推理与轨迹规划;但路侧摄像头看到的遮挡外目标,传统协同管线多半先变成框、轨迹再交给下游,很少让VLM直接读成对图像。
CoVLM-Bench(arXiv:2609.35823 ,中国人民大学)把协同驾驶问答(CDQA)与协同规划(CP)挂在同一批真实车—基础设施成对场景上,并给出统一基线CoVLM-Drive。项目页 https://sidiangongyuan.github.io/CoVLM-Bench/ ;代码 https://github.com/sidiangongyuan/CoVLM-Bench 。
英文题目:CoVLM-Bench: A Real-World Benchmark for Cooperative Driving Question Answering and Planning
论文出处:arXiv 每日论文精选 · arXiv:2609.35823
原始论文:PDF / 论文页面
这篇论文解决什么问题?
若只评自车视角,模型可能用语言常识答对却看不见被公交车遮挡的行人;若只评几何V2X规划,又缺少可检验的自然语言理解指标。
V2X-QA、D2-V2X等补了协同或遮挡QA,V2X-Seq与UniV2X等提供成对观测与规划,但“同一真实成对帧上同时考问答与规划”仍缺位。
CoVLM-Bench的目标是:让理解监督与决策目标可在对应场景上对照,并检验路侧视图是否真被模型用到。
核心创新
- 在真实车—基础设施成对场景上同时对齐CDQA、三部制rationale与协同规划目标。
- 提出CoVLM-Drive统一VLM基线,直接使用成对视图完成理解与结构化轨迹规划。
- 系统评估任务适配、监督来源、骨干选择与路侧输入条件对问答与规划的影响。
方法概览
基于V2X-Seq-SPD同步车路图像、协同目标记录与自车运动日志构建CoVLM-Bench:CDQA提供场景 grounding 答案与三部制rationale辅助监督;CP把未来3秒自车运动采成6个航点并派生指令。标注经模型辅助起草、记录计算与人工核验。再提出CoVLM-Drive:单VLM骨干直接吃成对视图,语言头做CDQA/rationale,结构化头预测指令与航点。
- 数据源自V2X-Seq-SPD同步车路图像、协同目标记录与自车运动。基准含2,196成对帧与35,136条CDQA标注;规划把未来3秒自车位姿变到当前自车坐标,按0.5秒采6个航点,并由运动规则派生六类指令。
- 标注分层:L1目标证据与来源视图,L2场景描述,L3问答,L4三部制rationale(场景概览、V2X关键目标、决策推理)。答案尽量由记录重算,文本经模型起草后人工核验。
- CoVLM-Drive把自车图、路侧图与提示送入同一Qwen3-VL骨干(LoRA适配)。语言解码器输出CDQA或三部制理由;对提示token做掩码均值池化后,指令头与航点MLP分别预测命令与六航点。
- 训练上CDQA用自回归交叉熵;CP联合rationale、命令、航点Smooth L1与终点项。可选先从CDQA适配初始化规划;推理时结构化头直接出规划,语言头仍可生成理由。
逐图理解论文
评测缺口
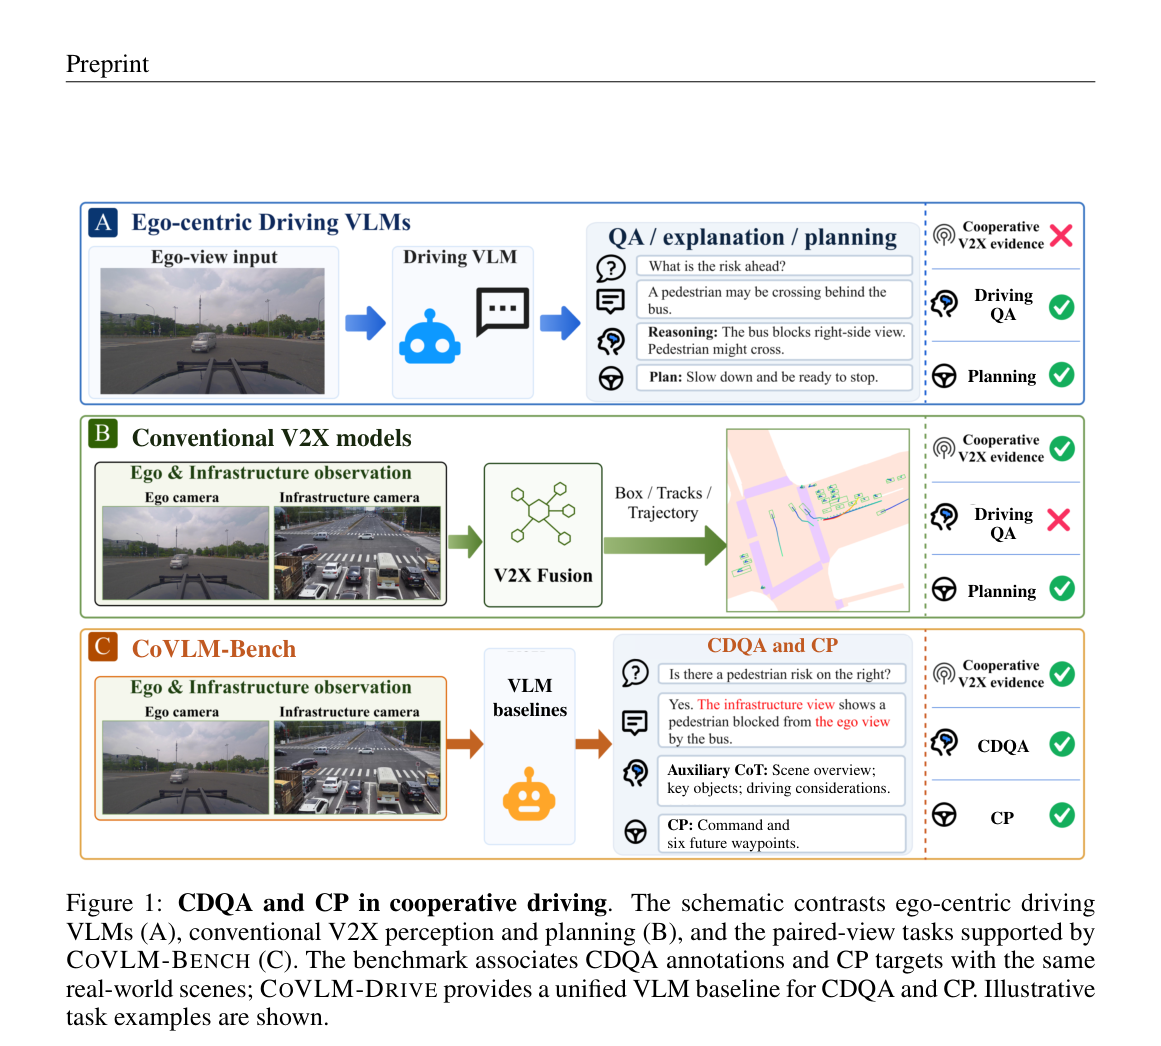
图1对比三类范式:A仅自车VLM有QA/规划但无协同证据;B传统V2X融合有几何规划却缺自然语言QA;C CoVLM-Bench在成对视图上同时支持CDQA与CP。宜作特色图。
基准设计
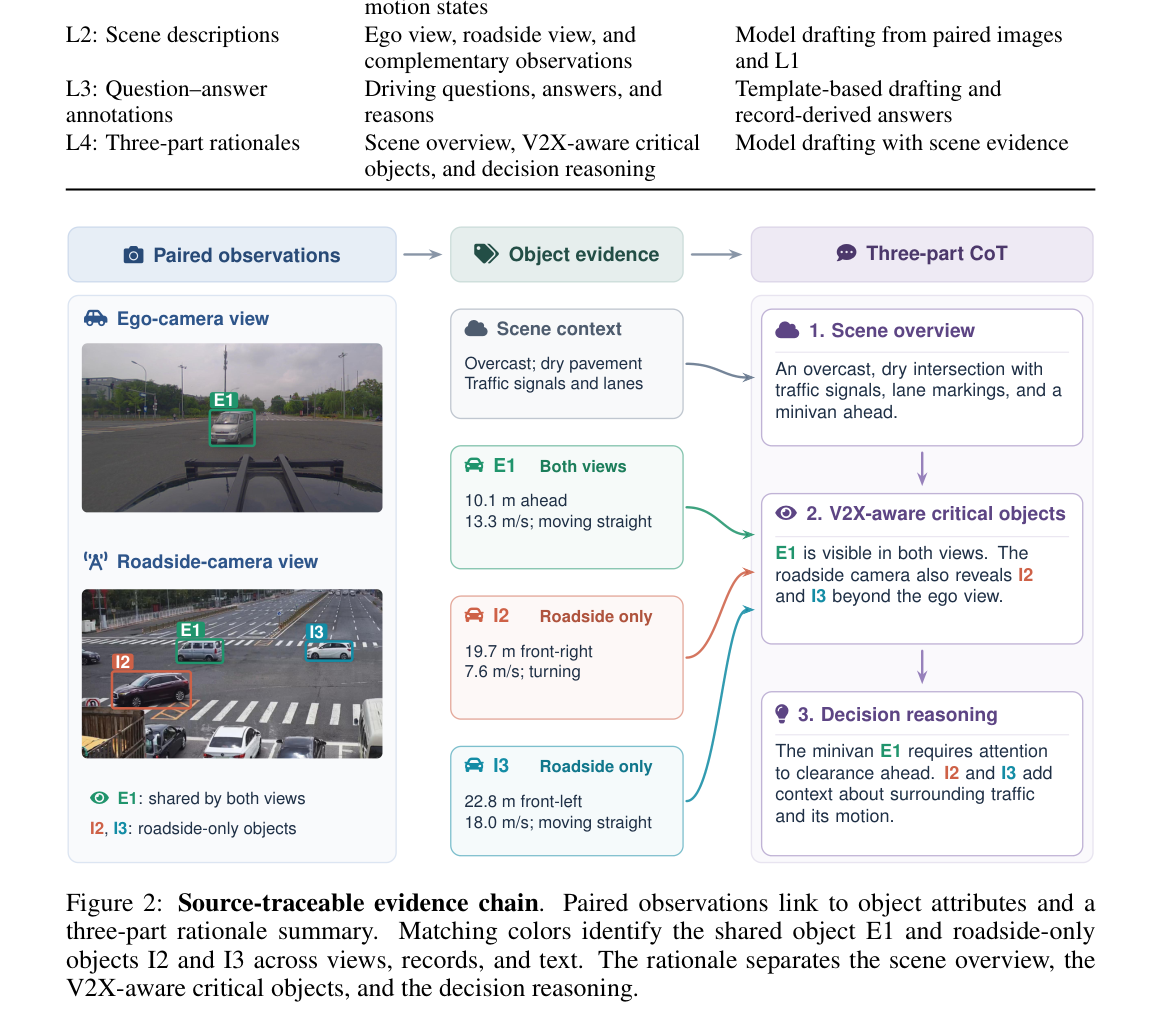
图2展示可追溯证据链:自车与路侧成对观测→目标属性与来源(共视E1、仅路侧I2/I3)→三部制CoT,说明答案与理由如何落到记录而非纯生成。
统一基线
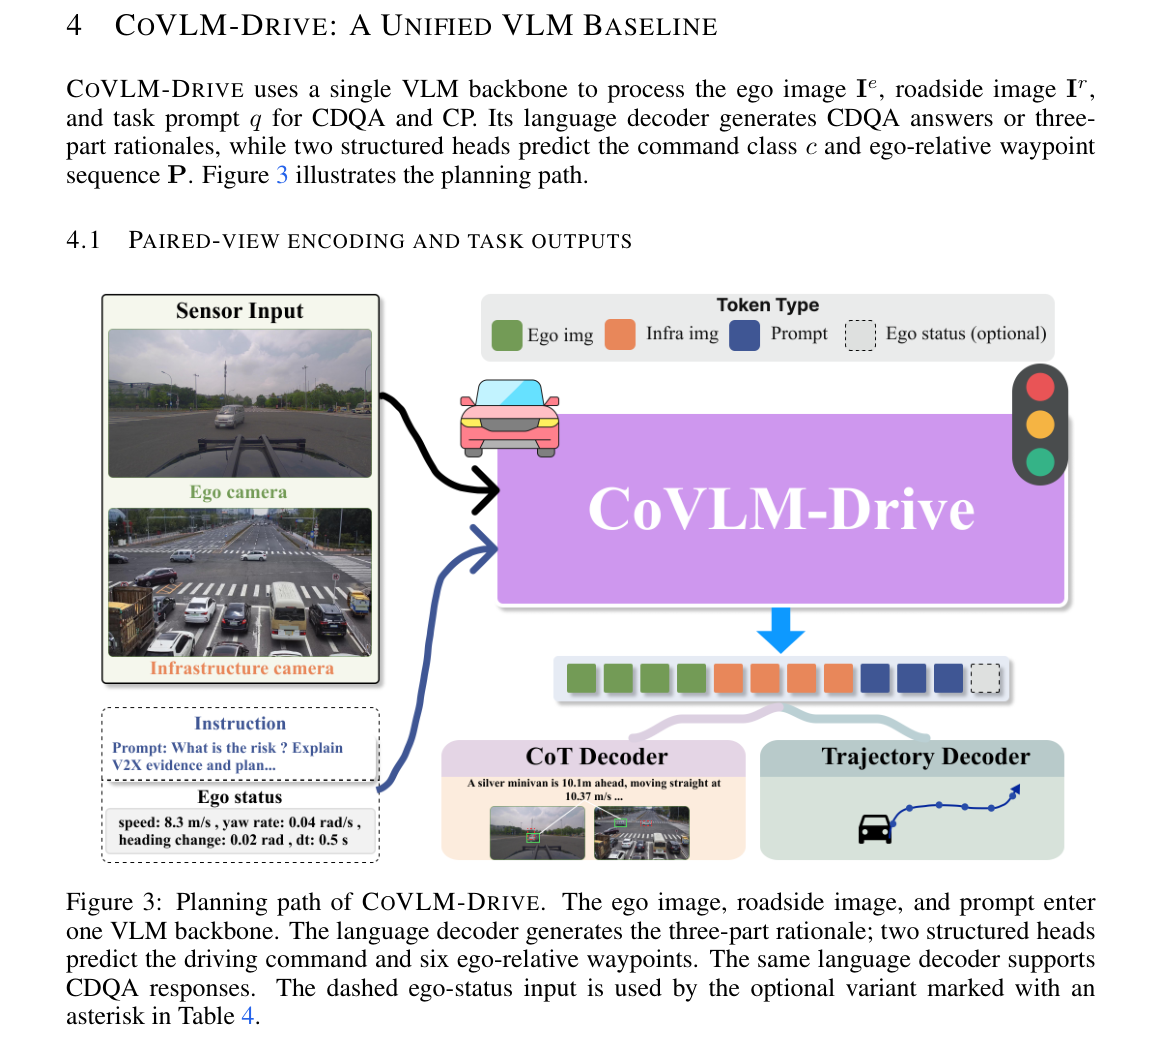
图3是CoVLM-Drive规划路径:成对图像与提示进入统一骨干,语言头产三部制理由,结构化头输出指令与六航点;虚线ego-status为可选变体。
实验如何设计?
- 场景不相交划分;规划统一在654例上报告各时域L2与3.0秒FDE,并报命令准确率。
- CDQA比较八个零样本VLM与CP-adapted / CDQA-adapted检查点,并设ego-only、blank、shuffled路侧对照。
- CP对照UniV2X、复现的UniMM-V2X与MAP,以及零样本提示规划VLM。
- 另做QA初始化与rationale监督因子实验,以及路侧输入控制。
关键结果与论文证据
- CDQA适配把Valid准确率提到39.6%,相对最佳缺路侧对照拉开+25.3个百分点,说明配对路侧对理解任务可被学到(Table 3)。
- 标准CP配置FDE 4.911 m,低于MAP的5.240 m与UniMM-V2X的5.357 m,吞吐约4.48 FPS(Table 4)。
- 相对纯规划监督的5.197 m,rationale监督降到4.911 m,QA初始化降到5.083 m(Table 5)。
- 去掉路侧FDE升至5.776 m;打乱路侧使预测航点平均移动0.73 m,且95.3%样本位移超过0.1 m,表明规划条件化了路侧内容(Table 6)。
阅读时需要注意
- 开环位移与命令指标不能替代闭环安全评测或实车验证。
- 场景来自特定协同数据集,天气、路口拓扑与标定误差分布有限。
- 模型辅助标注与模板化问题类型可能带来风格偏差,尽管有记录接地与人工复核。
关联工作
- V2X-QA、D2-V2X关注协同/遮挡问答。
- UniV2X、MAP、UniMM-V2X代表几何协同规划基线。
- 自车视角驾驶VLM则提供QA与规划能力对照。