快速导读:ThinkV2V 先让 MLLM 对源视频与隐式指令做显式思考,再经可学习查询连接器注入 DiT,配合渐进课程训练与推理时思考扩展,完成复杂指令视频编辑。
指令引导视频编辑已经能做风格迁移、增删改对象这类“直接说目标”的操作,但真实用户指令常常更绕:不点名物体,却要求根据因果或语义关系推断该改什么。现有方法多把多模态大模型当成更强的语义编码器,联合编码提示与源视频后直接喂给扩散骨干,于是容易抓住表面关键词、错过真正意图。
ThinkV2V(arXiv:2609.38541 ,港中文 / 浙大 / 字节跳动 / 俄亥俄州立大学)提出推理驱动框架:先让 Qwen3-VL-Thinking-8B 对源视频与指令显式思考并精炼提示,再经可学习查询连接器把回答侧隐状态注入 Wan-2.1-5B DiT,同时保留源视频 VAE 特征与原始指令嵌入。配套渐进课程训练、推理时思考扩展,以及 ThinkV2V-150K / ThinkV2V-Bench。项目页 https://correr-zhou.github.io/ThinkV2V 。
英文题目:ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
论文出处:arXiv 每日论文精选 · arXiv:2609.38541
原始论文:PDF / 论文页面
这篇论文解决什么问题?
组合困难不只来自画质,而来自认知缺口:隐式指令需要先理解“谁/什么该变、为什么变”,再落到可执行编辑方案。单次前馈编辑缺少可检查的中间推理,失败时往往表现为改错对象、半吊子风格或破坏未编辑区域。
相关工作一边改进语义特征如何注入视频生成器,一边在图像布局规划或视频物理一致性里试探推理信号;但系统化的“先想后改”视频编辑仍稀缺,数据与基准也偏基础编辑能力。
因此需要同时解决三件事:如何把 MLLM 思考稳定转成 DiT 条件、如何用训练/推理配方激发推理、如何用数据与评测覆盖隐式意图与因果场景。
核心创新
- 把 MLLM 从静态编码器升级为显式思考器,并经可学习查询连接器把思考特征稳定注入 DiT。
- 提出渐进课程训练:沿分辨率与指令复杂度两轴,从基础对齐走到推理密集微调。
- 引入推理时思考扩展:串行精炼候选提示后由 MLLM 自选最可靠方案再编辑。
- 构建面向隐式意图与因果推理的 ThinkV2V-150K 与 ThinkV2V-Bench。
方法概览
ThinkV2V 采用 Qwen3-VL-Thinking-8B → 可学习查询连接器 → Wan-2.1-5B 的 MLLM-to-DiT 架构:MLLM 对源视频与指令做 CoT 思考并输出精炼提示,取 </think> 后回答 token 隐状态经连接器压缩为固定长度条件;DiT 同时接收连接器特征、原始指令文本嵌入与源视频 VAE 特征。训练上分三阶段渐进课程(480p 简单→720p 简单→720p 复杂);推理时做串行精炼加 Best-of-N(N=8)选择。配套 ThinkV2V-150K 与 ThinkV2V-Bench。
- 架构上,MLLM 在系统提示约束下输出思考内容与精炼指令,仅把 </think> 之后回答 token 的末层隐状态交给连接器;连接器用可学习查询做交叉注意力,得到固定长度条件序列。DiT 侧按多条件去噪:连接器特征与原始指令文本嵌入沿 token 维拼接做交叉注意力,源视频 VAE 特征与噪声潜变量沿通道维拼接,减轻压缩瓶颈并保住细节。
- 训练配方分三阶段:Stage1 在 OpenVE-HQ-1M 上 480p 学基础对齐;Stage2 升到 720p 巩固画质;Stage3 换到 ThinkV2V-150K 做推理密集微调。全程主要优化连接器与 DiT,冻结 MLLM。推理时先串行把精炼提示再喂回 MLLM 生成多候选,再 Best-of-N(N=8)让 MLLM 选出最贴合原意图者,用其缓存隐状态驱动编辑。
- 数据侧从 OpenVE-3M 筛五类可推理编辑,经质量过滤得到 OpenVE-HQ-1M,再改写成约 15 万复杂指令;基准则把 OpenVE-Bench 同五类样本改写成 308 对,专门测隐式意图能否落地为正确编辑。
逐图理解论文
编码器局限
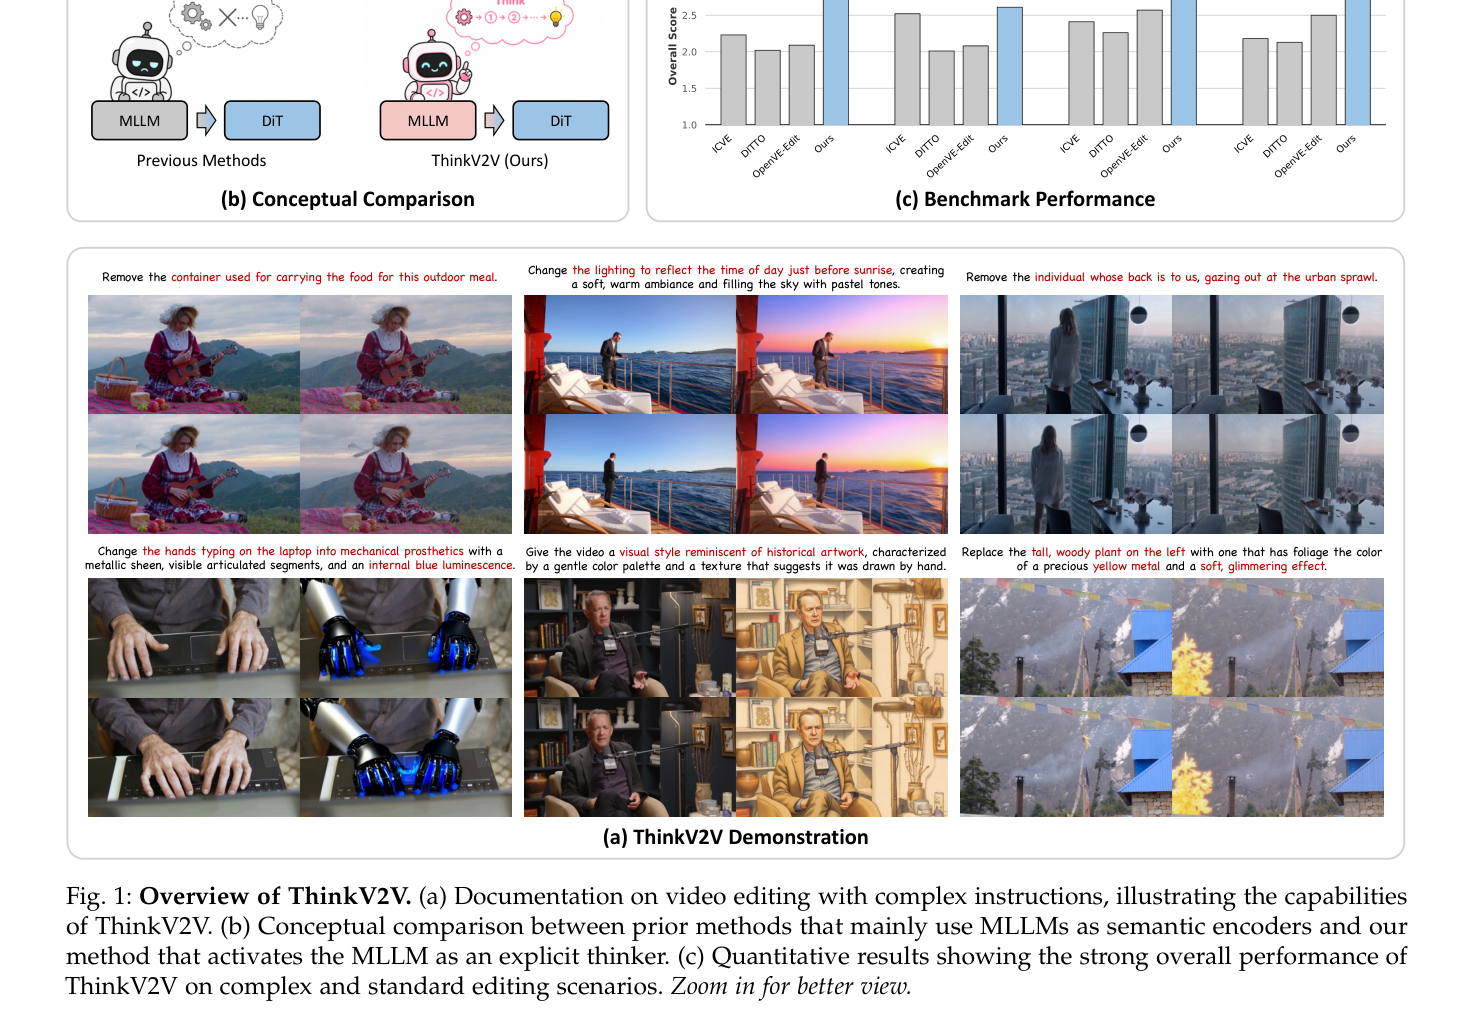
图1总览:上半展示隐式复杂指令下的删除、氛围、换手、风格与替换等编辑样例;中部对比“MLLM 当静态编码器”与“MLLM 当显式思考器”;右侧柱状图显示 ThinkV2V 在复杂与标准编辑场景整体分领先。宜作特色图。
先想后改架构
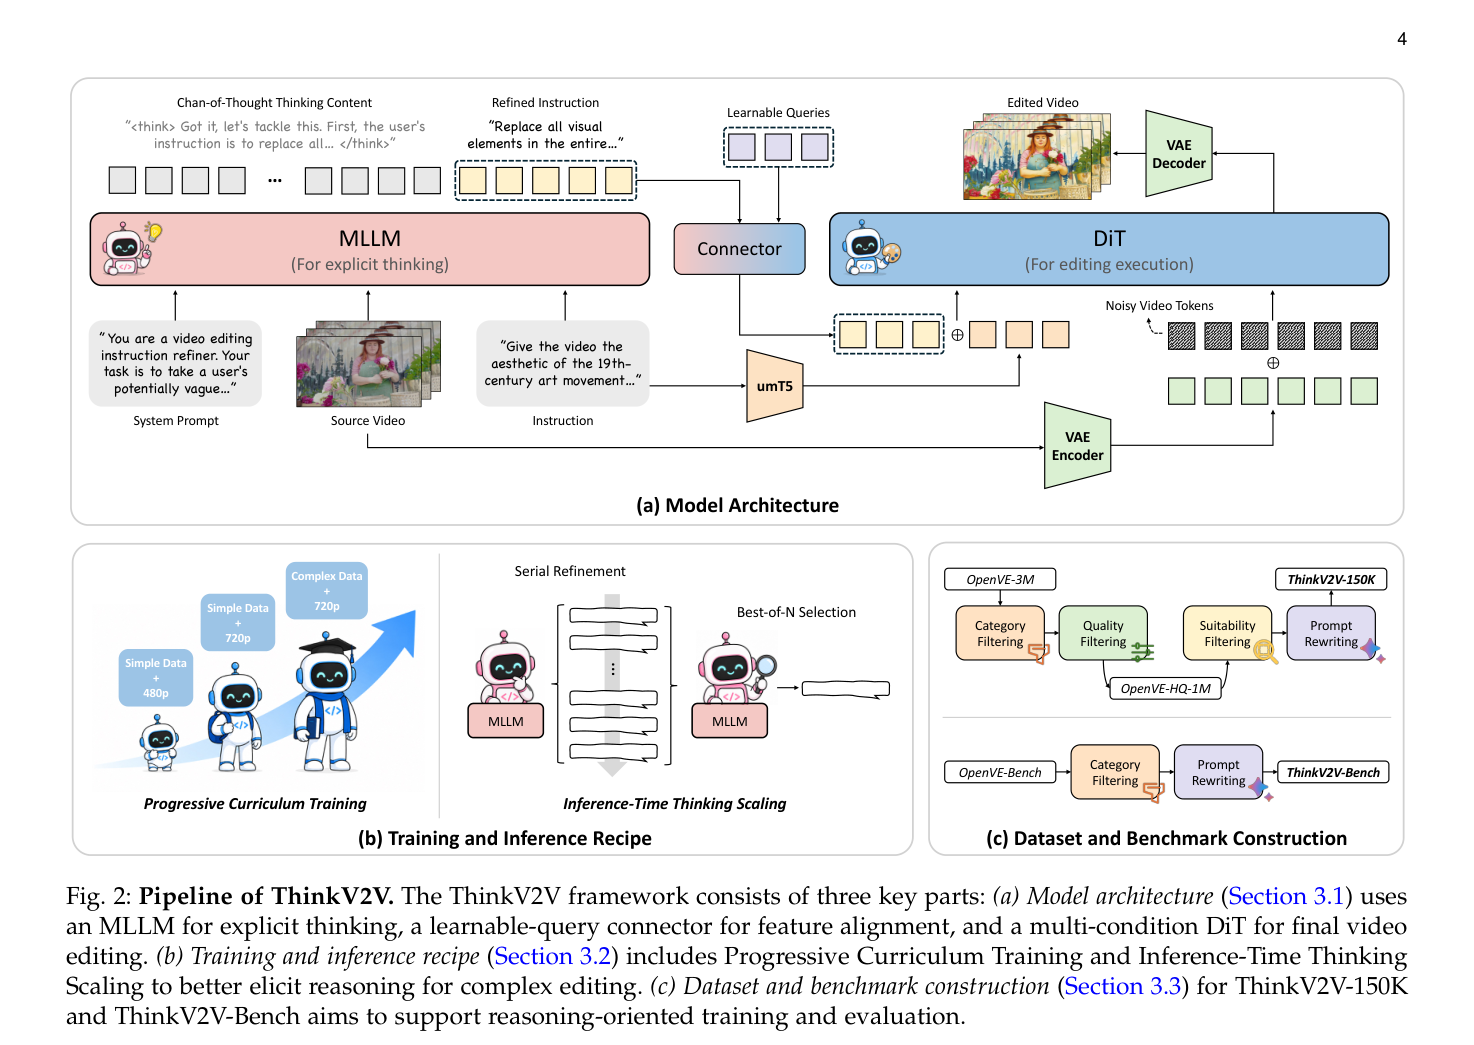
图2是方法管线:左为 MLLM 思考→可学习查询连接器→多条件 DiT;中为渐进课程与推理时串行精炼+Best-of-N;右为 ThinkV2V-150K / ThinkV2V-Bench 的过滤与改写流程。
结论与局限
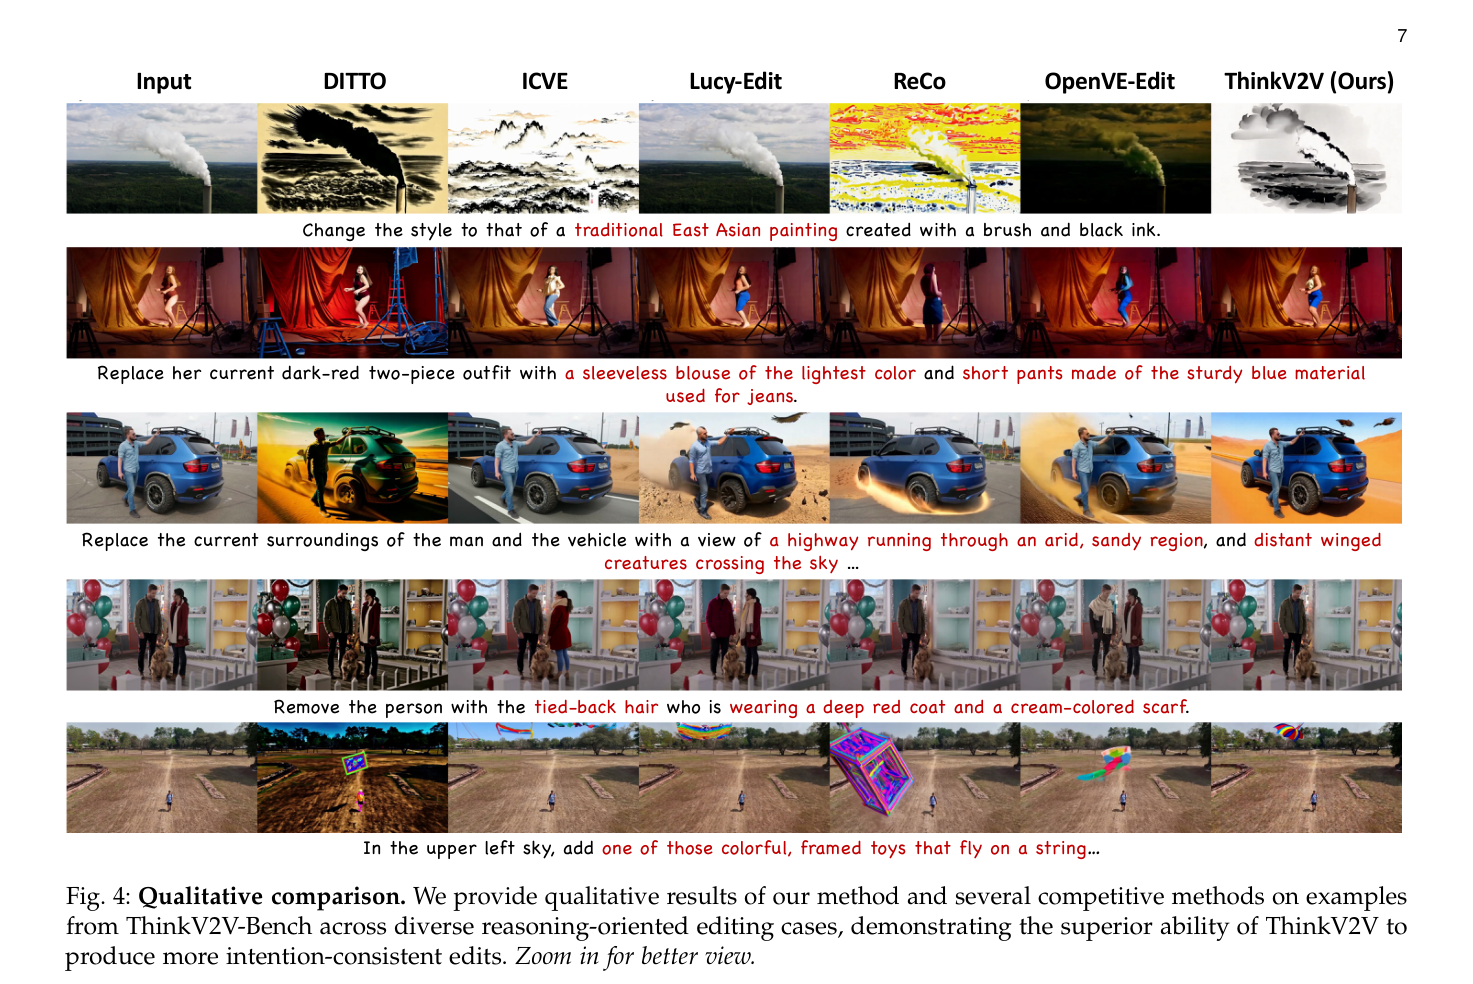
图4定性对比:同一复杂指令下对照 DITTO、ICVE、Lucy-Edit、ReCo、OpenVE-Edit 与 ThinkV2V,覆盖水墨风格、换装、沙漠背景、定点删除与添加风筝,突出意图一致性差异。
实验如何设计?
- 骨干为 Qwen3-VL-Thinking-8B + Wan-2.1-5B(自 Lucy-Edit 初始化),可学习查询长度 512,32 卡训练。主表在 ThinkV2V-Bench 与 OpenVE-Bench 上用 Seed-1.6-VL、Gemini-2.5-Pro 打分。
- 对照覆盖 VACE、OmniVideo、ReCo、InsVIE、Lucy-Edit、ICVE、DITTO、OpenVE-Edit;单卡 80GB 推理,尽量取各方法可跑的最佳分辨率/帧数配置。
- 消融分别扫显式思考开关与特征选择、课程顺序、以及推理时串行精炼与选择;定性展示跨方法对比与思考开关前后差异。
关键结果与论文证据
- 表1显示:在 ThinkV2V-Bench 上,5B DiT 的 ThinkV2V 以 Seed Overall 2.72、Gemini Overall 2.61 取得最优整体表现,并在 OpenVE-Bench 上继续以 2.93 / 2.72 领先,说明收益不只局限在复杂基准(页6)。
- 相对 13B–14B 级 ICVE、VACE、DITTO,更小的 DiT 仍能靠显式思考与配方拉开整体分,作者将其归因于“复杂语言理解 → 可执行编辑条件”的桥接(页6–7)。
- 图4定性对比中,对照常出现风格只改色、衣服改错、误删目标或添加位置漂移;ThinkV2V 在水墨风格、换装、换背景、定点删除与放风筝等案例上更贴整句意图(页7)。
- 消融:打开思考并把 Answer Features 注入可将 Overall 从 2.51 提到 2.68;Simple-to-Complex 课程优于 Complex Only(2.10)与反序;仅串行精炼不稳(2.67),加上选择到 2.72(页8)。
阅读时需要注意
- 串行思考与 Best-of-N 拉长墙钟延迟,部署成本高于单次前馈编辑器。
- MLLM 冻结后,上游思考失误只能靠推理选择部分纠正,难彻底消除。
- 合成复杂指令与裁判模型可能带来分布偏差;极难多约束案例仍会失败。
关联工作
- Lucy-Edit / OpenVE-Edit 代表强感知、弱显式推理的通道拼接编辑范式。
- OmniVideo / ICVE 等侧重语义特征注入路径,而非中间思考闭环。
- RPG、VChain 等把推理引入生成规划,ThinkV2V 把同类思想落到视频编辑全栈。