快速导读:PixelUMM 用单层线性投影把图像 patch 与视频 tubelet 直接送入 Mixture-of-Transformers,在像素空间联合做理解与流匹配生成。
统一多模态模型想同时“看懂”和“画出/生成”视觉内容,常见做法是理解走 ViT、生成走 VAE:能力齐了,但同一张条件图要付两套视觉 token,上下文近似翻倍,也和多数视觉语言预训练的单视觉流习惯不合。最近像素空间生成证明可以扔掉预训练潜变量自编码器,可一旦从图像扩到视频,理解与生成对时序如何切块又各自为政。
PixelUMM(arXiv:2609.38597 ,NVIDIA / 滑铁卢大学)给出无编码器方案:图像用空间 patch、视频用时空 tubelet,经单层线性投影接入 Mixture-of-Transformers;理解专家吃干净像素,生成专家吃噪声像素,共享多模态注意力并联合文本预测与像素流匹配。项目页 https://nv-tlabs.github.io/PixelUMM/ 。
英文题目:PixelUMM: Encoder-Free Unified Image and Video Understanding and Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.38597
原始论文:PDF / 论文页面
这篇论文解决什么问题?
双视觉接口的负担在长对话、多图多视频场景尤其刺眼:视觉 token 随轮次累积,注意力与显存成本上升;若还要改预训练数据管线去塞 VAE token,统一就更不划算。
图像侧已有 JiT、PixelDiT、SenseNova-U1 等像素统一探索;视频生成却常依赖因果 3D VAE,视频理解又常按帧独立编码,二者并不自然共享同一视觉接口。
因此关键问题变成:能否用一套像素级 patch/tubelet 接口,同时支撑图像与视频的理解与生成,并弄清 patch 尺寸与解码头会怎样影响伪影与训练动态。
核心创新
- 为图像与视频设计统一的无编码器像素接口:空间 patch 与时空 tubelet + 单层线性投影。
- Mixture-of-Transformers 在共享注意力下分离理解/生成参数,并扩展干净像素预测到视频生成。
- 联合 ChatML 序列建模四种任务,配合广义因果注意力与三轴 Native RoPE。
- 系统消融图像/视频 patch 尺寸与视频输出头,给出像素统一模型的设计经验。
方法概览
PixelUMM 以图像 16×16 patch、视频 4×16×16 tubelet 经单层线性投影接入从 Qwen3 初始化的 MoT:理解专家处理文本与干净视觉,生成专家处理噪声视觉,块内共享多模态自注意力但归一化/投影/FFN 分专家。目标联合自回归文本交叉熵与像素速度空间流匹配;省略显式 timestep 嵌入。训练分联合/生成/理解多阶段,逐步纳入更高分辨率与视频任务。
- 视觉接口对图像做 16×16 二维切块,对视频做 4×16×16 三维 tubelet;理解与生成各有一套单层线性投影,输出侧用 RMSNorm+线性头再 unpatchify 回像素,无 VE/VAE/离散视觉词表。生成路径省略显式 timestep 嵌入,让网络从噪声像素本身推断腐败程度。
- 骨干是从 Qwen3 初始化的 Mixture-of-Transformers:文本与干净视觉走理解路由,噪声视觉走生成路由;每块内专家分参的 Norm/QKV/FFN,但所有 token 共享同一次多模态自注意力。四种任务以 ChatML 打包,注意力在文本内因果、视觉块内双向,并采用时间-高-宽三轴 Native RoPE。
- 目标上,助手文本做交叉熵;像素侧按 JiT 式流匹配在速度空间算 MSE,总损失按阶段加权文本/图像/视频项。训练按联合、纯生成、纯理解等多阶段推进,分辨率从 256 逐步升到更高,并纳入视频任务。
逐图理解论文
像素统一接口
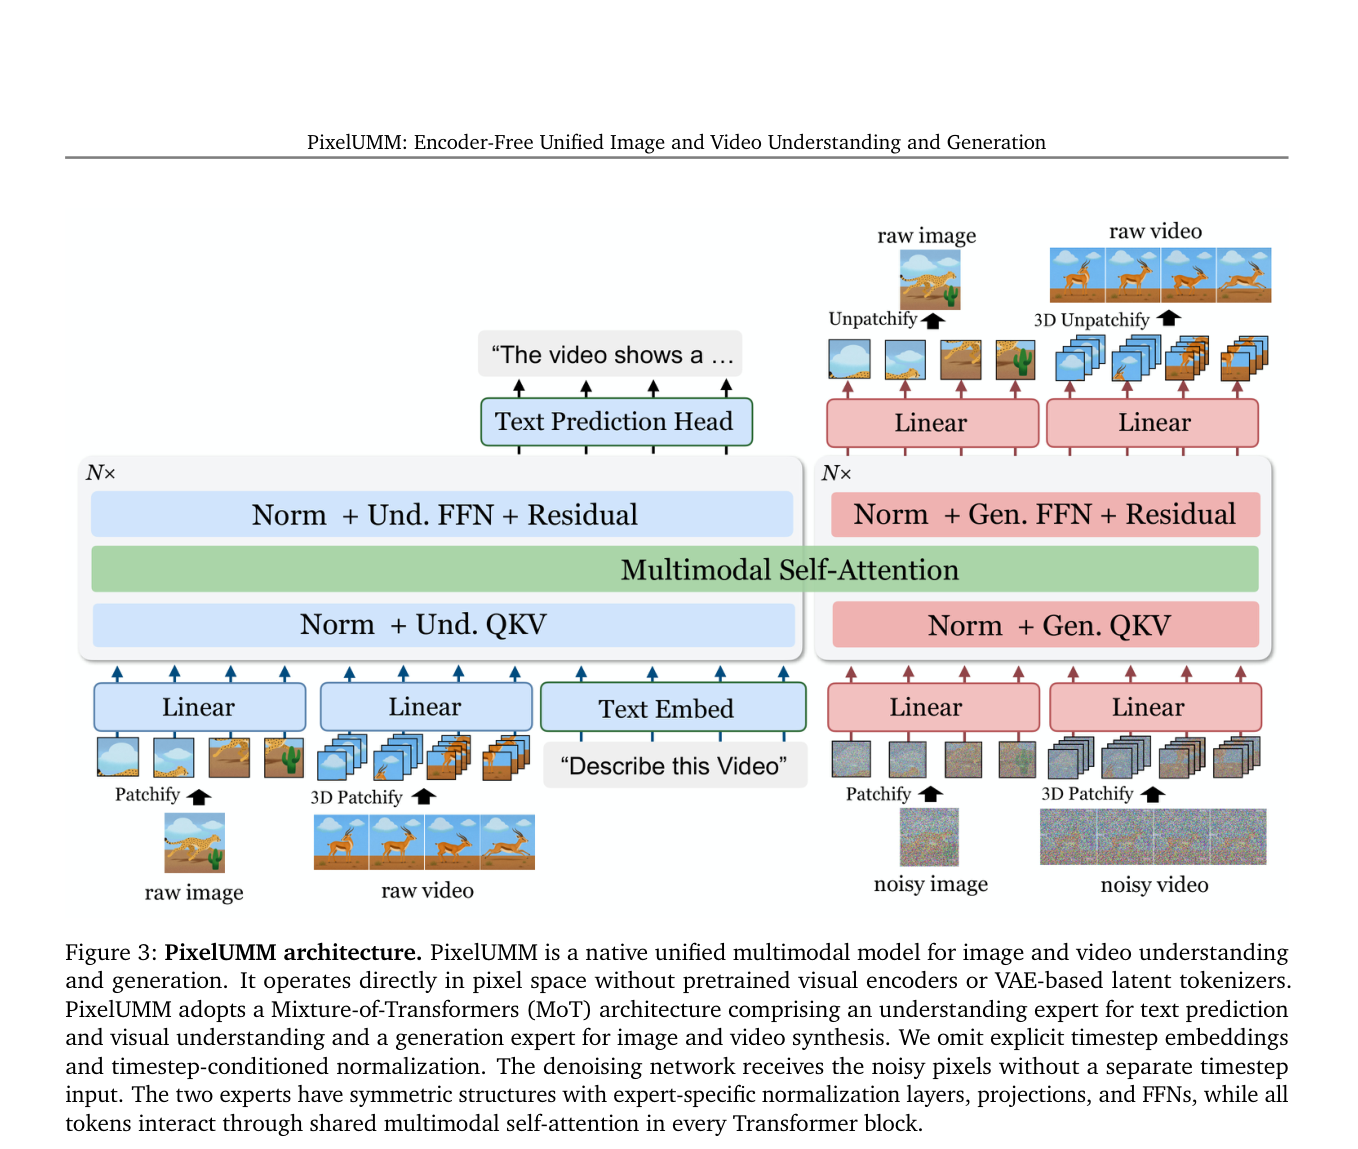
图3是架构主图:左理解专家处理干净图像/视频 patch,右生成专家处理噪声像素,中间共享多模态自注意力;无预训练视觉编码器或 VAE,仅线性投影连接像素与骨干。
关键证据
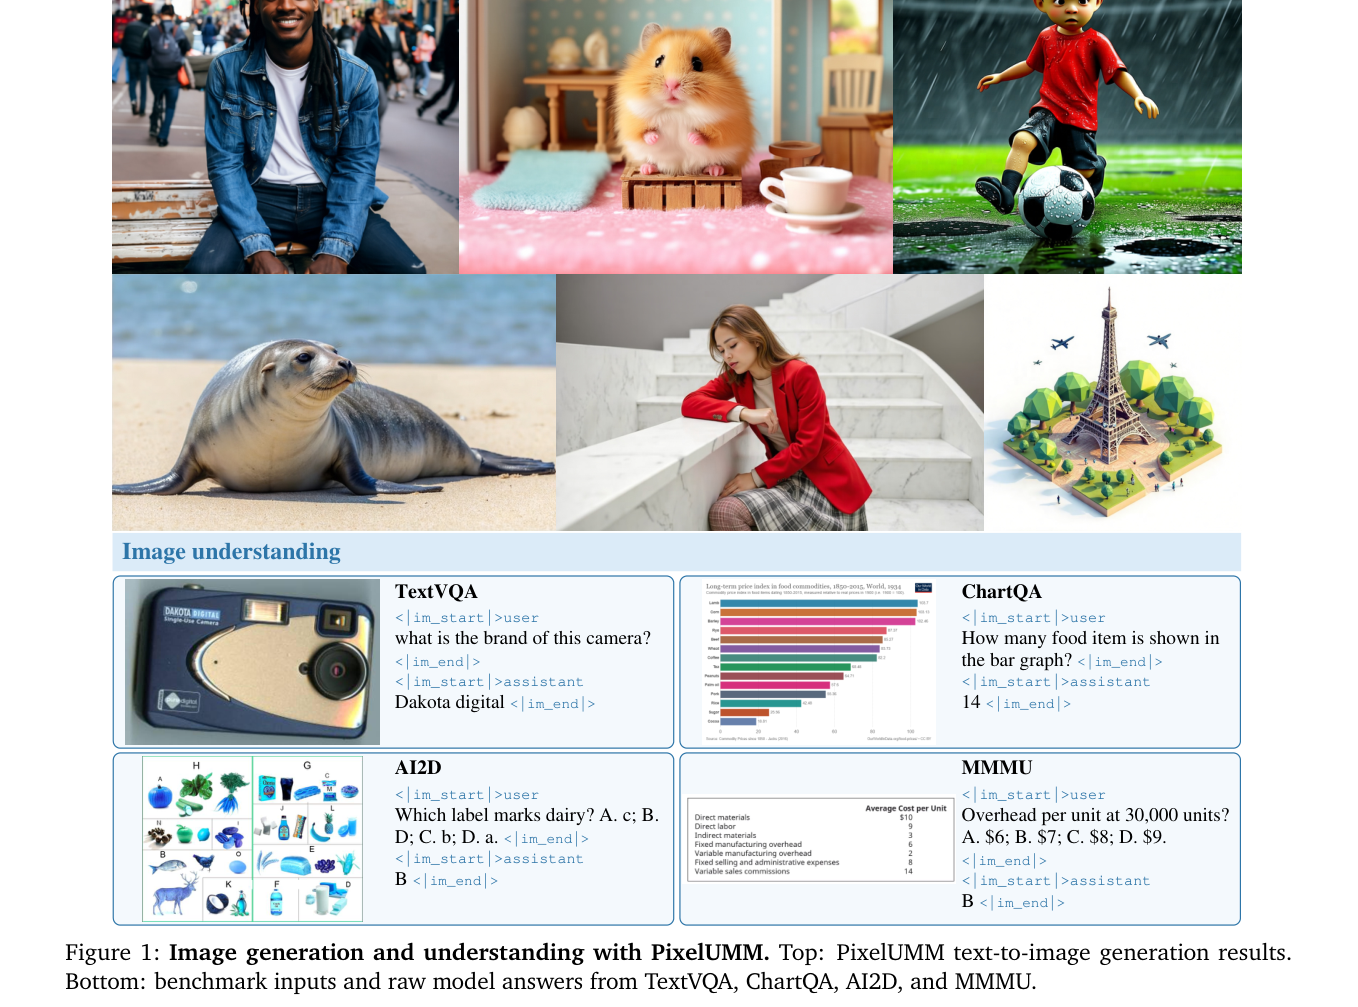
图1展示图像能力:上方为多样文生图样例,下方给出 TextVQA、ChartQA、AI2D、MMMU 的原始问答截图,说明同一像素接口同时服务生成与理解。宜作特色图。
结论与局限
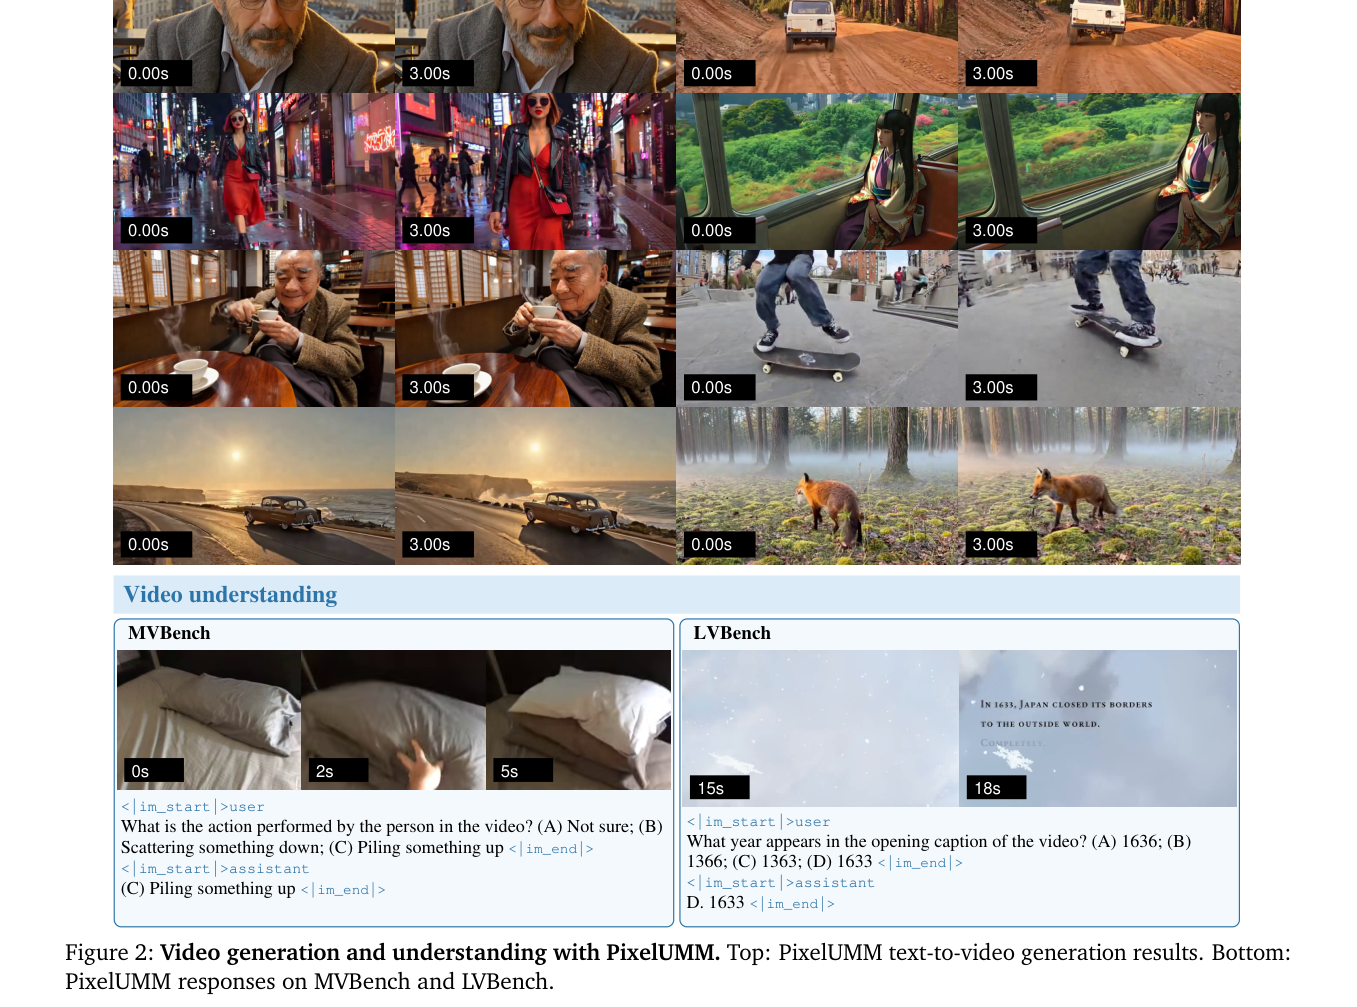
图2对应视频侧:上方文生视频时间轴帧,下方 MVBench / LVBench 问答示例,强调管状时空表示也能支撑视频理解与生成。
实验如何设计?
- 主结果报告 Joint Stage 2 后的图像理解(Table 5)、视频理解(Table 6)、图像生成 GenEval/DPG(Table 7)与视频生成 VBench(Table 8–9),对照 BAGEL、TUNA 系列、Qwen-VL、LLaVA-OV 及若干生成系统。
- 经验研究系统扫描图像 patch 16 vs 32、视频 p/t 配置、多种像素视频输出头,并对比像素空间与 VAE 空间早期训练动态、以及 1.7B/8B 与分布式算力缩放。
- 另检查干净视觉条件如何经理解专家路由、以及 dense/sparse 视频理解模式在不同采样率下的差异。
关键结果与论文证据
- 表5–6显示:8B PixelUMM 在 ChartQA 82.96、TextVQA 78.76、MVBench 70.53 等指标上达到统一模型竞争区间,同时仍落后部分强理解专用或更大系统(如部分 MMMU 结果)(页21)。
- 表7:GenEval 上 orig. overall 约 0.77,使用提示重写后约 0.83;DPG-Bench 多项与 BAGEL 等同台可比(页22)。
- 表8–9:在 VBench 上与统一/专用文生视频系统报告同台分数,表明像素流匹配可支撑短视频生成而不依赖视频 VAE(页23)。
- 经验研究强调 patch 尺寸与输出头会显著改变拼块伪影与损失曲线;像素接口可工作,但解码设计与分辨率课程对质量至关重要(页9–14)。
阅读时需要注意
- 线性像素头仍可能留下可见拼块痕迹,尤其在视频时空边界。
- 部分高阶多学科理解基准相对最强专用 VLM 仍有差距。
- 多阶段训练与高分辨率联合优化成本高,工程复现不轻松。
关联工作
- BAGEL 代表双编码器统一路线;PixelUMM 用单一像素流替代。
- JiT / SenseNova-U1 把像素生成推进到图像统一;本文补齐视频接口。
- Qwen3 提供文本与 Transformer 初始化底座,MoT 则分离理解与生成专家参数。