快速导读:GRC-Pose 把无CAD先验的六维跟踪写成生成几何与场景重建的对应求解,用 GeoCorr-Matcher 与 FGH-Solver 在 HOT3D 上刷新 Average Recall 与运动保持。
未见物体的六维位姿跟踪若依赖专用 CAD、位姿参考图或大规模合成监督,很难落到野外抓取与 AR 场景;自我中心手物视频里,大幅运动、手遮挡与模糊又会让单帧估计迅速漂移。几何基础模型看似给出两条捷径:VGGT 类重建给出场景与相机,SAM 3D 类生成给出局部完整物体几何,但二者坐标系、尺度与表面覆盖并不对齐,直接拼接并不稳定。
GRC-Pose(arXiv:2609.39116 ,北京理工大学 / 中关村学院等)把问题写成 generation-reconstruction correspondence:用 GeoCorr-Matcher 估计带不确定性的物体-场景对应,再用 FGH-Solver 做分解几何求解与序列后验滤波,配合后验门控记忆稳住长序列。作者报告在 HOT3D 上达到 SOTA Average Recall,并把运动保持相对既有方法提升约 58%。
英文题目:GRC-Pose: Generation-Reconstruction Correspondence for Prior-Free 6D Object Pose Tracking
论文出处:arXiv 每日论文精选 · arXiv:2609.39116
原始论文:PDF / 论文页面
这篇论文解决什么问题?
可靠六维跟踪对操作、AR/VR 与机器人交互很关键,但 egocentric 手物交互特别难:帧间运动大、遮挡严重、可见性间歇,帧级独立估计容易丢跟。
既有未见物体方法通常要物体 CAD 或带位姿参考;学习式方法又常依赖合成监督。单视角估计还受对称与遮挡造成的多峰歧义困扰。序列级跟踪本可把问题改写为跨帧几何重建与位姿优化,但如何把“生成的完整物体几何”与“重建的稀疏场景”接到同一度量世界,仍缺一套对应驱动的共识机制。
因此需要一种先验无关框架:既能利用生成几何的完整性,又能用场景重建锚定尺度与相机,并在遮挡与快速运动下维持多模态位姿分布而不是贪心单峰。
核心创新
- 把先验无关六维跟踪写成跨域几何共识:生成物体几何对齐多视角场景重建。
- GeoCorr-Matcher 做位姿条件、不确定性感知的物体-场景对应,抑制遮挡噪声。
- FGH-Solver 分解 2D–3D/3D–3D 候选并用后验滤波与门控记忆稳时间一致性。
- 在 HOT3D 上相对先验方法大幅提升运动保持,并在经典基准保持竞争力。
方法概览
GRC-Pose 将跟踪表述为 generation-reconstruction correspondence。GeoCorr-Matcher 对每个位姿候选估计加权物体-场景对应与匹配不确定性;FGH-Solver 用加权 PnP/Procrustes 与联合局部求解生成分解候选,再做序列级后验滤波与信任域旋转精炼;后验门控记忆只保留内点支持的观测,并做序列自适应。
- 输入单目 RGB 序列后,系统一面用 VGGT-Ω 重建稀疏场景与相机运动,一面用 SAM/SAM3D 生成物体网格与掩码。GeoCorr-Matcher 在位姿候选条件下做几何交叉注意力,输出互匹配矩阵、点级可匹配性与空间方差,并合成对应权重。
- FGH-Solver 基于这些软期望二维投影与三维点,分别跑加权 PnP(2D–3D)、加权 Procrustes(3D–3D)与联合局部求解,保留分支假设再做 Top-K 合并;随后用发射分数与相对运动约束做贝叶斯时间滤波,并对 MAP 估计做信任域旋转精炼。
- 后验门控记忆把证据锚定到规范表面坐标,只在门控通过时写入;序列自适应则在无真值标注下校准后验,使匹配置信与几何不确定性更贴合当前录像。
逐图理解论文
跨域错位
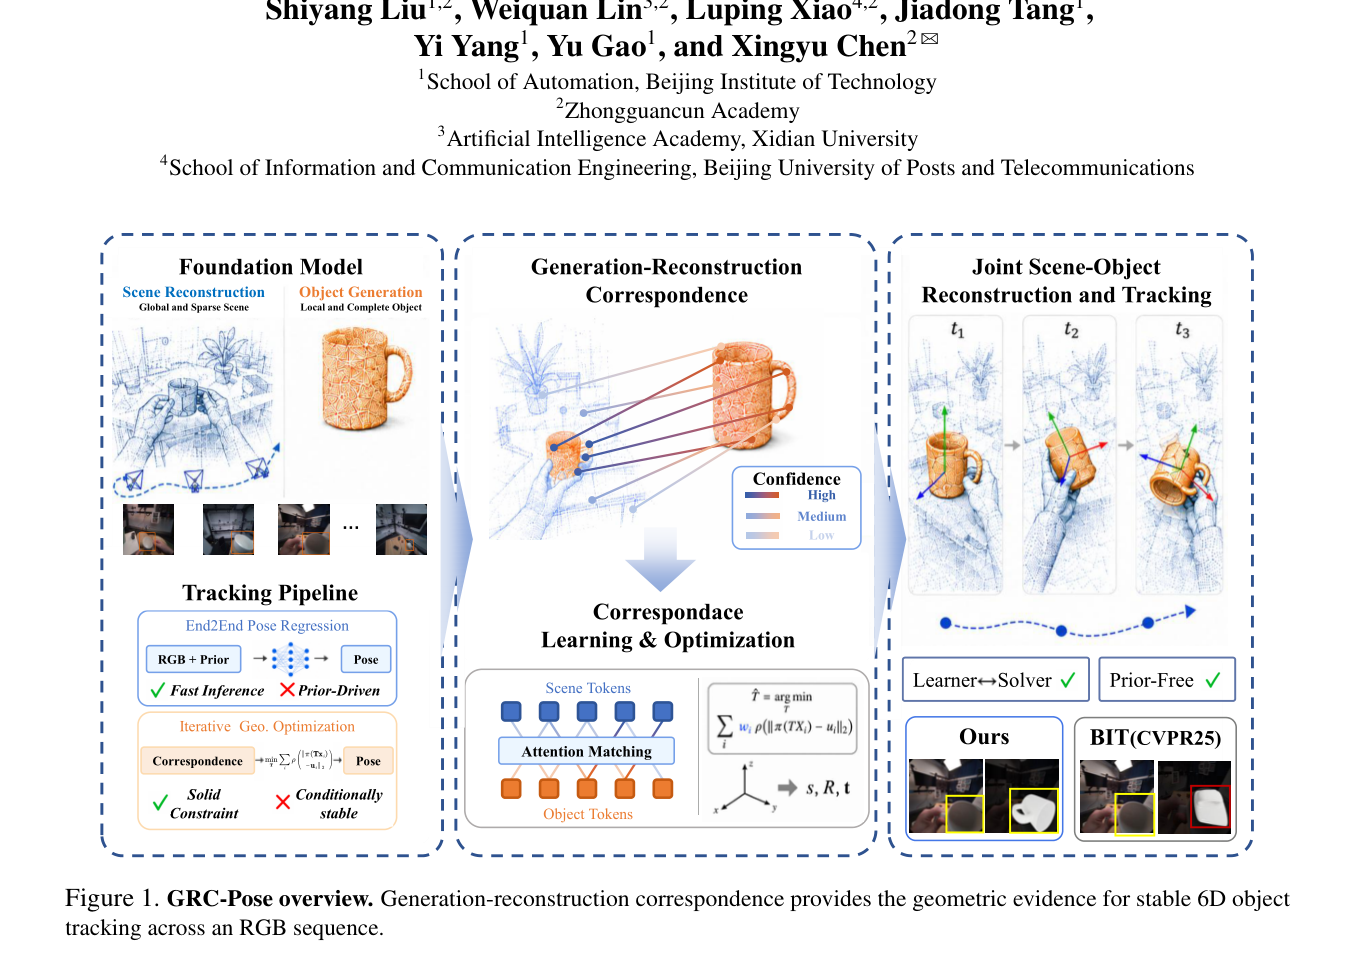
图1总览:左侧对比端到端回归与迭代几何优化;中部展示生成物体与稀疏场景的置信对应;右侧给出 learner↔solver 与先验无关属性,并以相对 BIT 的跟踪示例收束。宜作特色图。
对应匹配
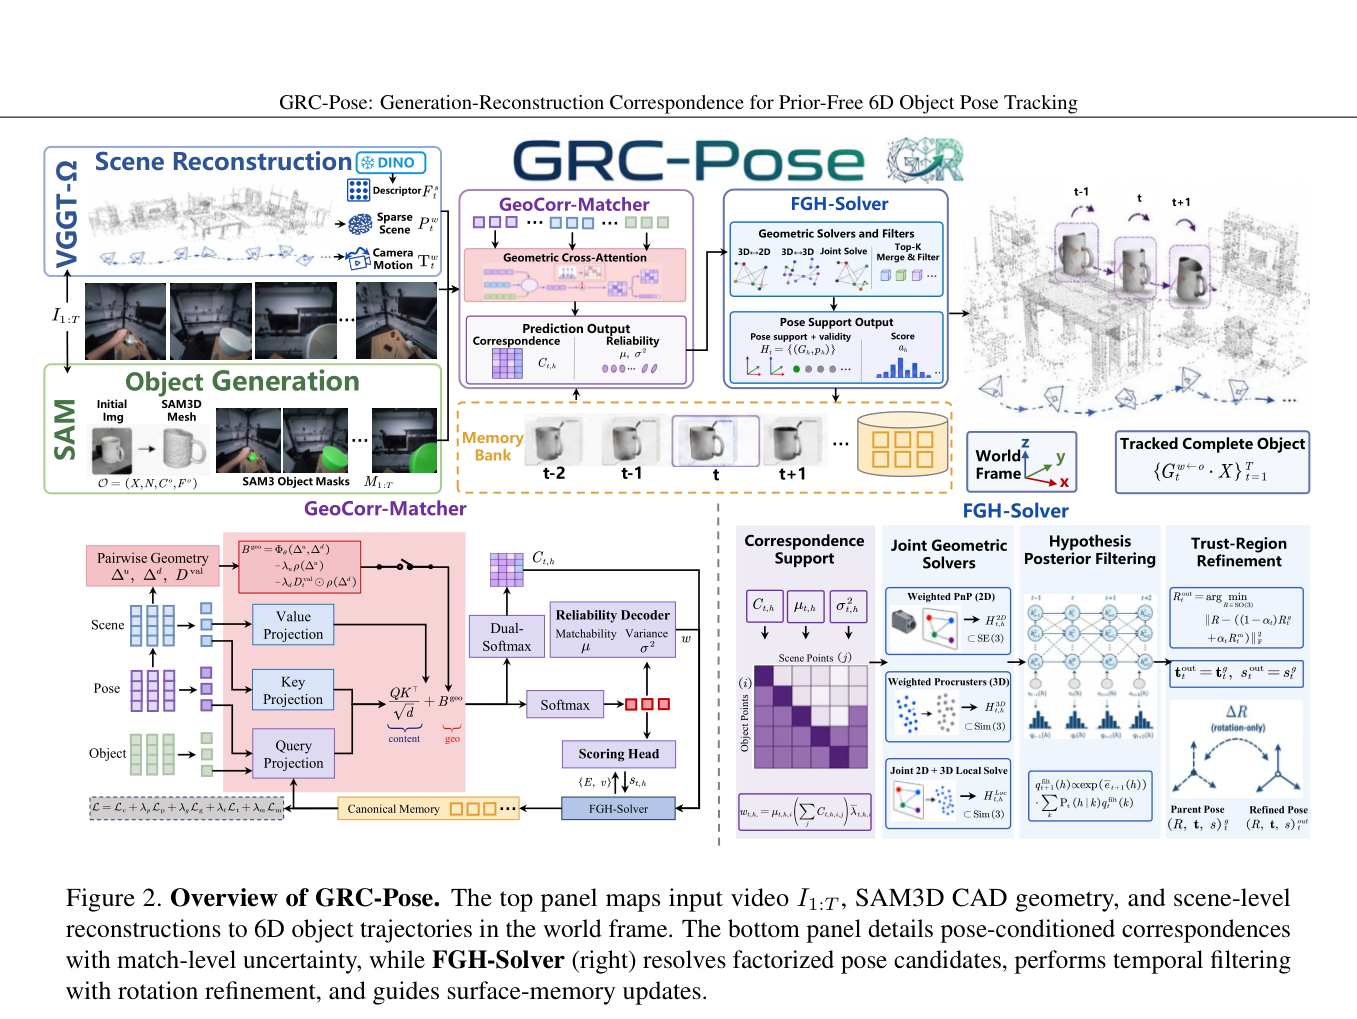
图2是系统架构:上半把视频、SAM3D 与 VGGT 场景接到世界系轨迹;下半展开 GeoCorr-Matcher 的几何交叉注意力与不确定性头,以及 FGH-Solver 的分解求解、后验滤波与信任域精炼。
关键证据
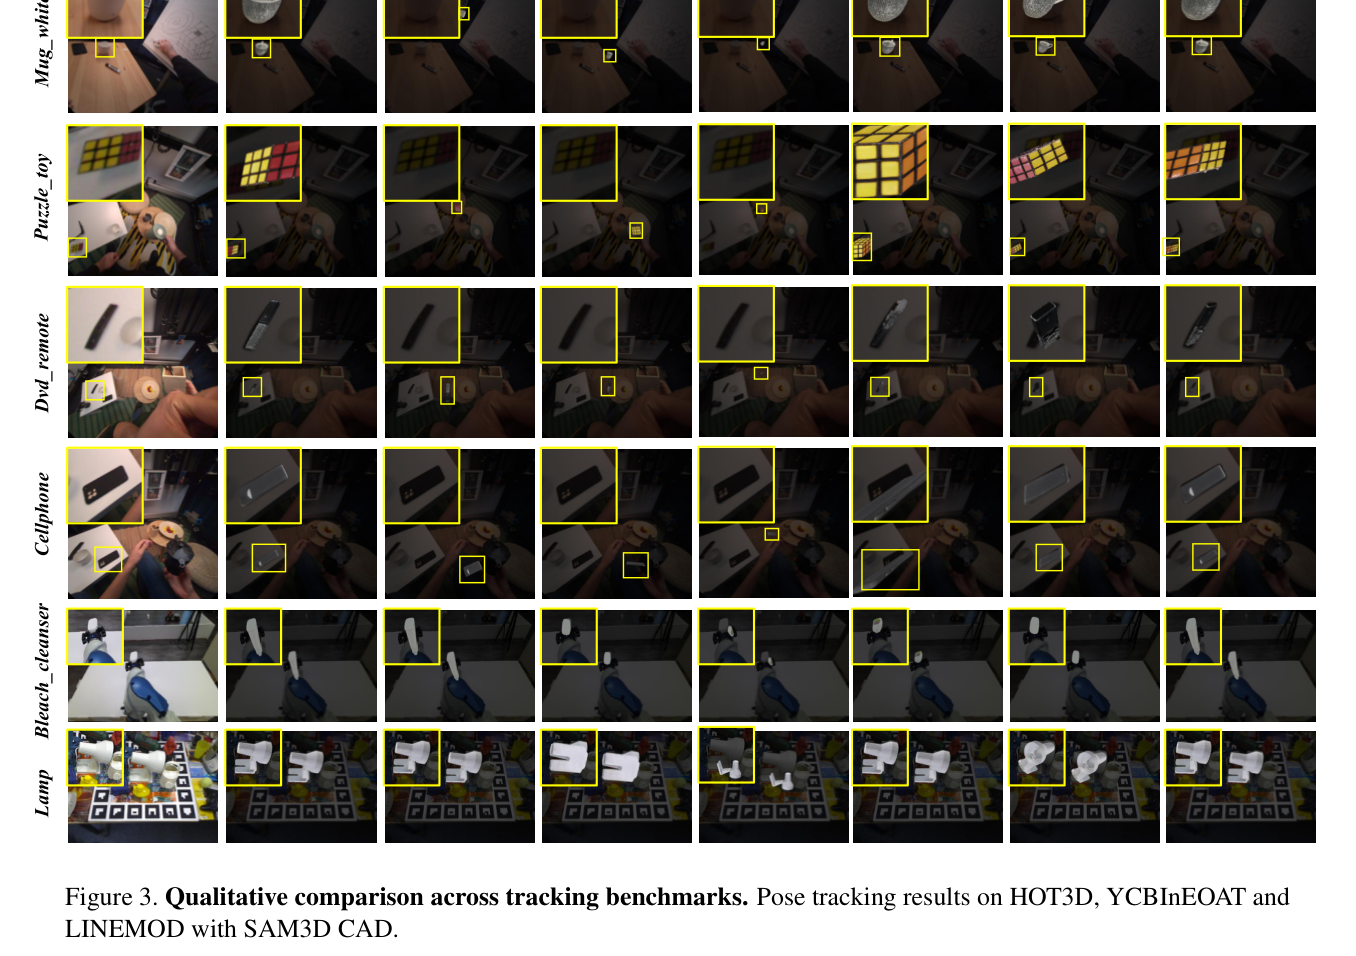
图3跨 HOT3D、YCBInEOAT、LINEMOD 的定性对比:黄框与 CAD 叠加显示杯子、积木、遥控器等多类物体在遮挡与视角变化下仍可连续跟踪。
实验如何设计?
- 基准覆盖 HOT3D(自我中心手物)、YCBInEOAT 与 LINEMOD(物体中心)。协议共享观测序列、相机标定、SAM3 掩码与对应的 Metric/SAM3D CAD 条件;依赖初始化的基线使用共享非真值首帧位姿种子。
- 主对照含 FoundationPose、RGBTrack、GigaPose、FreePose、Dynhor、BIT 等。HOT3D 报告 Avg. AR、ARMSPD 与 Motion;经典基准报告 ADD/ADD-S AUC。
- 消融固定匹配器与特征,单独开闭位姿条件与对比损失,并比较 2D–3D/3D–3D 分支、直接平均与延迟联合。
关键结果与论文证据
- Table 1:SAM3D 条件下 Ours 在 HOT3D 取得 Avg. AR 34.0%、ARMSPD 79.0%、Motion 26.9%,高于 Dynhor(31.9/76.8/17.0)与 GigaPose(31.4/69.2/11.9);相对 Dynhor 的 Motion 提升约 58%。BIT 仅 1.6% Avg. AR,说明初始重建难以撑住长 egocentric 流(页7–9)。
- 经典基准上,宏观 ADD-S 平均 79.8%,LINEMOD ADD-S AUC 86.1%,YCBInEOAT ADD/ADD-S 为 41.2%/67.0%,整体保持竞争力(页8–9)。
- 消融显示位姿条件把 Inlier@0.1d 从 13.94% 提到 19.35%,对比损失后到 20.34%;延迟联合每帧保留约 86.1 个假设,后验约一半选 3D–3D、一半选 2D–3D,避免直接平均产生的中间错误位姿(页9–10)。
- 定性上,图3跨基准跟踪更稳,图5显示位姿条件显著减少橙色外点、提高蓝色内点密度(页7、10)。
阅读时需要注意
- 生成几何或场景重建失败会直接污染对应与求解。
- 多假设滤波与在线自适应带来额外算力,相对纯回归更重。
- 对称物体、长时间完全遮挡等极端情况仍可能保留多峰歧义。
关联工作
- BIT 代表先验无关单目联合生成与优化。
- BundleTrack/BundleSDF 代表 RGB-D 联合重建跟踪。
- FoundationPose / Dynhor / GigaPose 分别代表渲染比对与强跟踪基线。