快速导读:DeCoPrune 免训练,用中间干净预测与最终去噪结果的差异衡量 token 长期价值,在高修剪比下接近 FullKV 的上下文一致性并加速续写。
自回归视频扩散按块生成,天然适合流式与交互控制,但历史 KV 会随 rollout 持续膨胀:全留太贵,猛砍又会丢掉之后复现物体或回访场景所需的视觉证据。固定窗口只看近期,局部相似度也难判断“相对已保留上下文,当前块还值不值得再存一份”。
DeCoPrune(arXiv:2609.39096 ,南洋理工大学 / 清华大学 / 普林斯顿)把缓存压缩写成去噪一致性问题:比较同轨迹上探测步干净预测与最终去噪结果,保留差异大的 token、剪掉差异小的 token,并物理缩短后续注意力可见的历史。项目页 https://decoprune.github.io 。作者在自建 CMBench 上报告约 85% 历史 KV 削减、4.14× 续写加速,同时 DINO 接近 FullKV。
英文题目:DeCoPrune: Efficient KV-Cache Pruning for Autoregressive Video Diffusion via Denoising Consistency
论文出处:arXiv 每日论文精选 · arXiv:2609.39096
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长视频生成要在记忆与一致性之间折中。丢掉过旧 token 省算力,却可能在一分钟后的“再拿起同一个杯子/转回同一角落”任务上失忆;只比邻帧变化,又会漏掉远距离重复出现的物体与场景。
相关路线包括窗口流式、头特化缓存、内容感知选择与低秩/量化。多数不直接度量:当前块相对整段已保留上下文是否仍携带不可预测的新证据。
评测侧也有缺口:VBench 类质量维可能仍高,但历史回忆已坏。需要把 Reappear/Revisit 续写与可控 KV 压缩绑在同一协议里。
核心创新
- 发现去噪难度可代理长期保留价值:步到最终差异大的 token 更值得进长期缓存。
- 免训练在线修剪:复用生成轨迹预测,无需额外前向或显著性模型。
- 提出 CMBench:约一分钟上下文上的 Reappear/Revisit 续写回忆任务。
- 在可比修剪比下显著优于 TempDiff 等压缩基线,并接近 FullKV。
方法概览
DeCoPrune 把缓存压缩写成去噪一致性问题:对当前块比较探测步干净预测与最终去噪值,按 token 均方差阈值生成保留掩码,物理压缩历史 KV;观测上下文则再加噪后同样打分。辅以近期窗口、RoPE 重索引与可选头特化变体,并发布 CMBench 评测长程回忆。
- 核心假设:相关上下文会减小中间干净预测与最终输出的差距;若某 token 的探测预测已接近最终值,其 KV 更可能冗余。于是对当前块计算 token 级均方差,阈值成保留掩码,并在层间共享该掩码以物理 gather 历史 KV。
- 在线打分复用正常生成轨迹,无需额外模型评估。对已观测视频上下文,则把各块再加噪到探测步,在原时间位置做条件干净预测,再与观测块比较。工程上辅以近期窗口、前缀修剪与 RoPE 时间重索引,避免远距 key 难检索。
- 可选 DeCoPrune-HS:动态头走一致性选择,静态头走 Streaming,以进一步提高修剪比。作者同时发布 CMBench:58 个约一分钟上下文与 116 个再现/回访任务,用检测+分割+DINO 相似度打分。
逐图理解论文
缓存膨胀
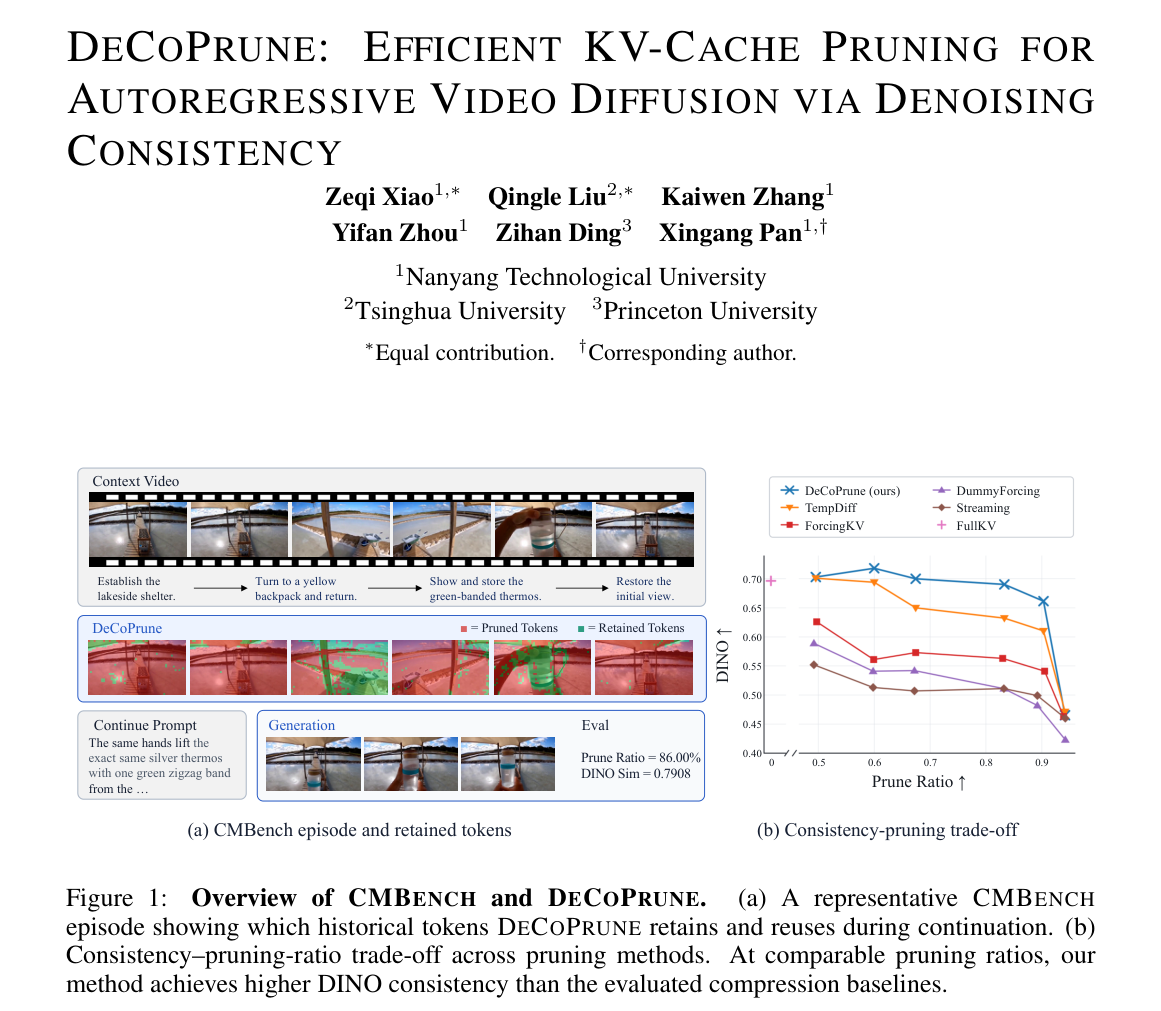
图1:(a) 展示 CMBench 片段上 DeCoPrune 保留的绿色 token 多落在手、背包、保温杯等关键区域,并给出续写与 DINO;(b) 一致性-修剪比曲线中 DeCoPrune 全程高于 TempDiff 等基线。宜作特色图。
去噪一致性
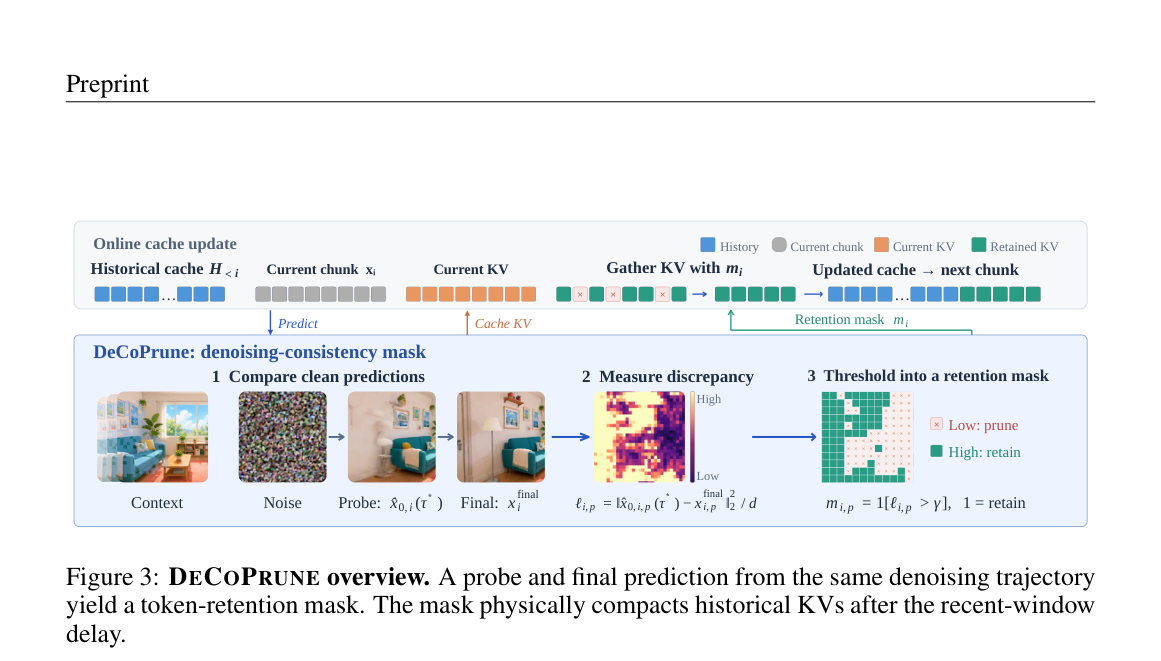
图3方法示意:同轨迹探测预测与最终结果比差异,阈值成保留掩码,再物理压缩历史 KV;强调不是只改注意力权重,而是缩短后续可见缓存。
记忆评测
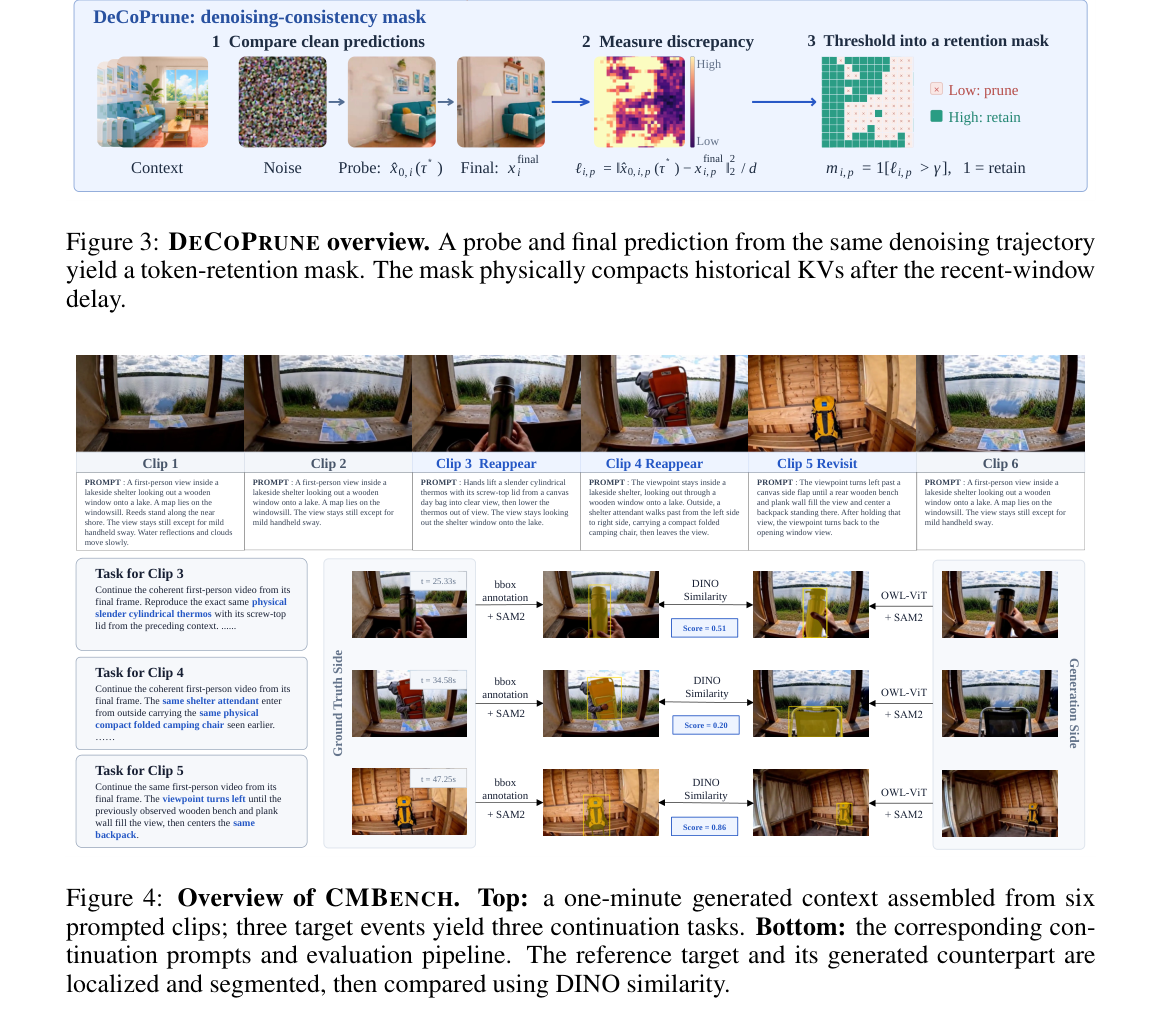
图4解释 CMBench:约一分钟上下文由多段提示拼接,引出再现/回访续写;评测用框选+分割后算 DINO 相似度。
结论与局限
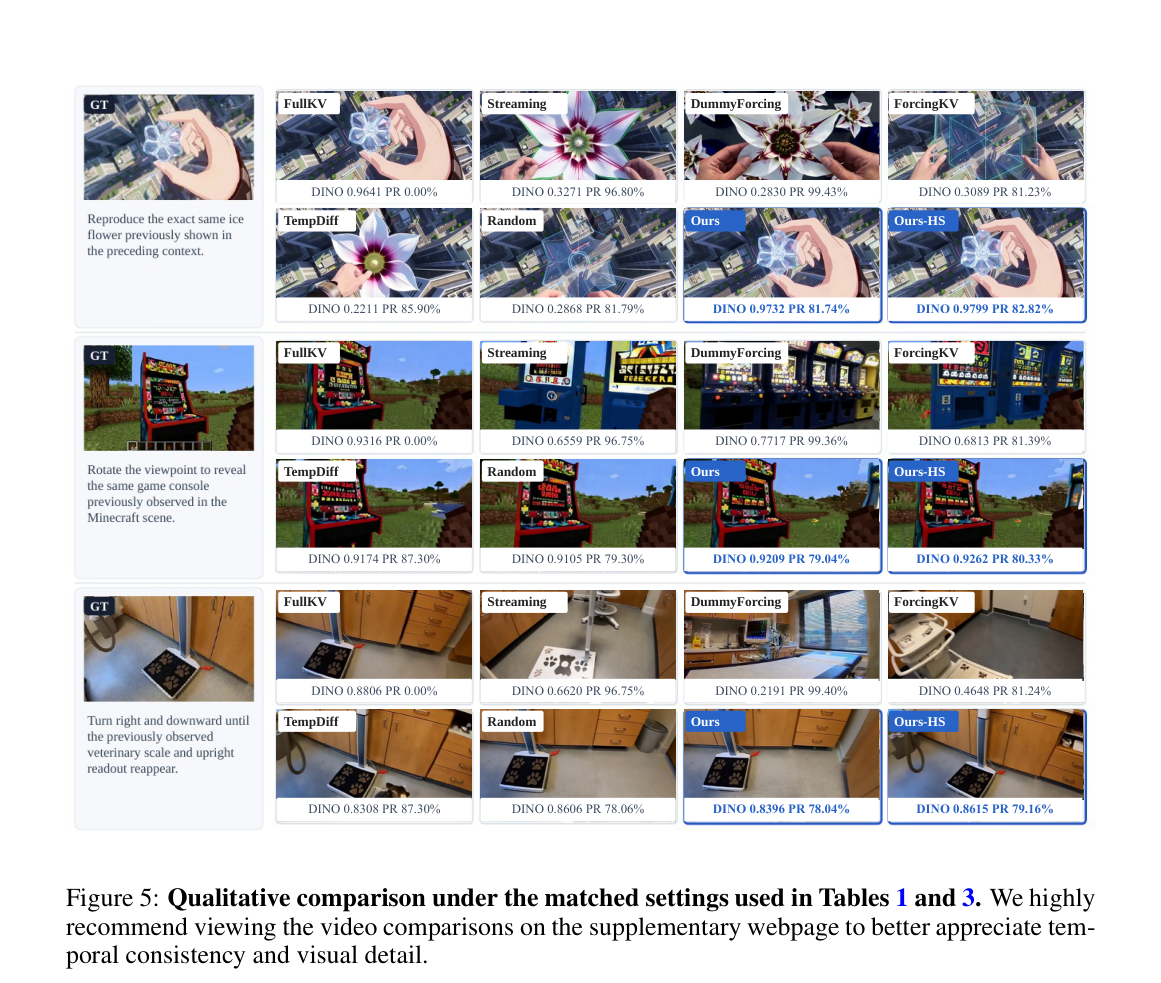
图5在匹配设置下对比 FullKV 与多种压缩:Ours/Ours-HS 在物体再现与场景回访上更接近真值,多项基线换错实例或视角。
实验如何设计?
- 主骨干 LingBot World v2,四卡 H200;噪声日程四步,探测索引 2(τ*=899),γ=0.10;默认 832×480、16 FPS、每块四潜帧。
- 压缩方法共享 sink 与近期窗口;对照含 FullKV、Streaming、DummyForcing、ForcingKV、TempDiff、Random。主指标为 CMBench DINO、PR、续写 FPS/加速,并报告 VBench 质量维。
- 消融扫探测步与阈值、RoPE 重索引增益,以及反向保留低差异 token 的对照。
关键结果与论文证据
- Table 1:DeCoPrune 取得 DINO 0.6701、PR 85.43%、4.14× 续写加速;HS 变体 0.6783 / 86.19%,距 FullKV 的 0.6803 仅差 0.0020。同设置下 TempDiff 为 0.6229,差距约 0.0472(页7–8)。
- Streaming 与 DummyForcing 更快但 DINO 明显更低,属于更激进的丢历史权衡,不宜当作严格同预算替代品(页7–8)。
- 图5定性显示:在冰花再现、Minecraft 机柜回看、兽医秤回访等任务上,Ours/Ours-HS 更接近 GT 与 FullKV,而多项基线换错物体或走错视角(页8)。
- 消融表明宽范围探测步都可用,但过激压缩会伤 CMBench;VBench 主/背景一致性近饱和时,CMBench DINO 仍随丢失上下文下降,说明需要专门回忆基准(页8–9)。
阅读时需要注意
- 结论主要来自 LingBot World v2;跨骨干泛化看附录设定。
- 阈值与探测步仍是超参,极端 PR 会牺牲回忆。
- PR 描述累计历史 token 可见度削减,不等于峰值显存或端到端墙钟。
关联工作
- Streaming 代表窗口丢历史。
- TempDiff 代表局部时差启发式。
- ForcingKV / DummyForcing 代表头级缓存策略;VBench 代表通用质量评测。