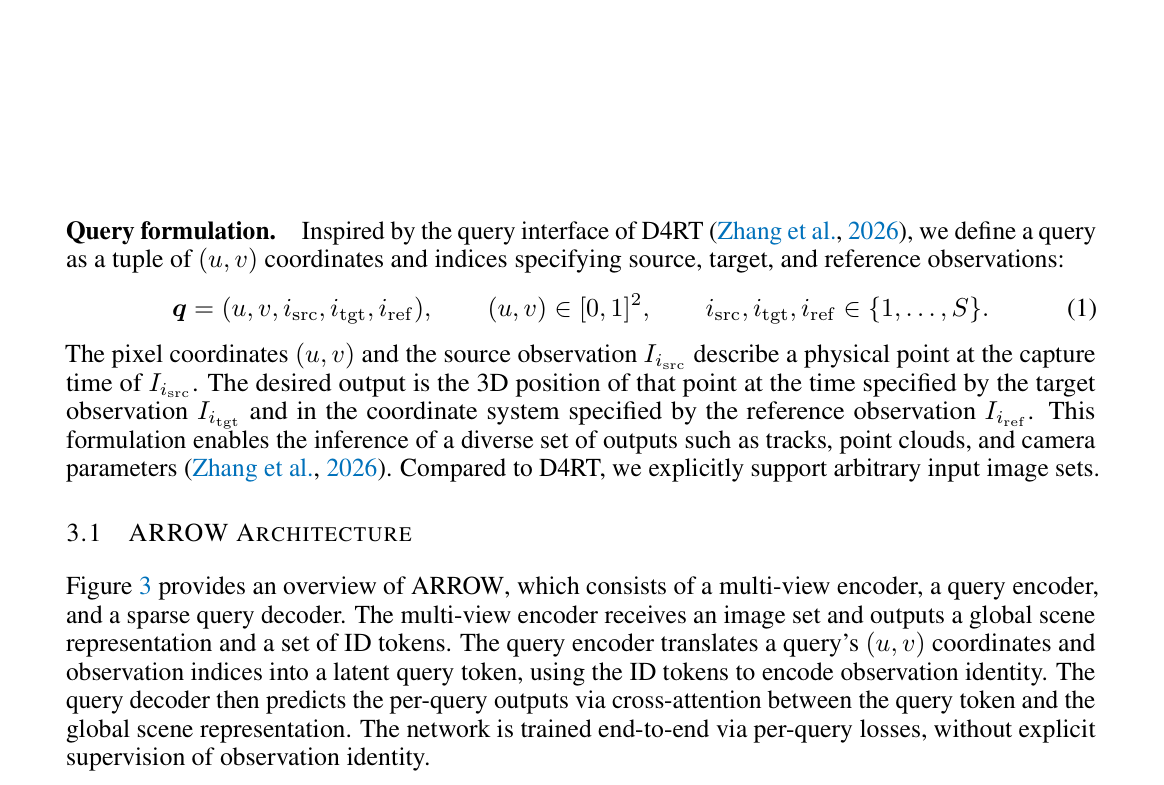
快速导读:ARROW 用内容派生的身份 token 做与顺序无关的查询,把静态图集、动态视频与多视图流统一到同一前馈四维重建与点追踪模型。
动态场景可能来自运动相机、多路视频,或不同时刻拍下的静态照片。这些观测互补,但要把几何与运动放进同一表示,必须在视点、拍摄时刻和遮挡变化之间建立对应。现有追踪默认单视频时序,重建虽能吃无序图集,统一模型却仍用位置编码把查询绑到帧序号上。
ARROW(arXiv:2610.01314;RWTH Aachen)是一个前馈模型:用内容派生的身份 token 做与顺序无关的查询,在任意 RGB 图像集合上同时做三维重建与三维点追踪。作者报告 WorldTrack 与 TAPVid-3D 新高,改编的仅 RGB 多视图追踪也超过专用方法,重建与位姿保持可比。项目页 https://vision.rwth-aachen.de/arrow。
英文题目:ARROW: Arbitrary Reconstruction and Tracking of 4D Observations in the Wild
论文出处:arXiv 每日论文精选 · arXiv:2610.01314
原始论文:PDF / 论文页面
这篇论文解决什么问题?
D4RT 已经证明:视频编码一次,再按源像素、目标时刻、参考相机独立查询,就能让重建与追踪共享表示。但它的训练仍偏连续短视频,架构用可学习时间嵌入给全局上下文强加顺序。多相机可能共享同一时刻,静态图集更没有固有顺序,这种绑定会变成错误先验。
若把编码器换成 DA3 这类无序图集骨干,位置线索消失,查询与特征会对不上。加回位置编码等于把顺序依赖请回来。需要的是从图像内容长出来的身份,而不是帧号。
同时,训练如果只见局部时序,模型很难遇到跨相机、跨长时间的难对应。作者希望同一接口覆盖静态图集、动态视频与多视图流,并用更宽的采样把监督多样化。
核心创新
- 提出与顺序无关的查询:用内容派生 ID token 替换可学习时间嵌入,对齐查询与全局上下文。
- 单一前馈模型接受静态图集、动态视频与多视图流,稀疏或稠密解码共用一次编码。
- 非连续、跨相机采样加宽训练分布,消融显示对多视图追踪增益最大。
方法概览
ARROW 以 DA3 初始化多视图编码器,交替帧内与全局注意力,输出共享全局上下文 F 以及每帧 ID token(复用相机 token,不解释为位姿)。查询由源像素 (u,v)、源/目标/参考观测索引构成;查询编码器融合源点 RGB 裁剪、傅里叶坐标与三个 ID token,得到 zq。每个查询独立对 F 做交叉注意力,预测参考系下的三维位置、置信度、目标像素、可见性、法向与位移。训练混合静态图集、动态视频与多视图,对有效监督项加权;位姿由预测三维点恢复,无专用位姿头。
- 查询定义为归一化像素 (u,v) 加上源、目标、参考观测索引。输出是该物理点在目标时刻、参考坐标系下的三维位置,顺带像素、可见性、法向与位移,从而能解码轨迹、点云与相机。
- 多视图编码器由 DA3 初始化,帧内注意力与全局注意力交替,得到共享上下文 F 和每帧一个 ID token。ID 来自原相机 token,但不当作位姿,也不参与后续位姿恢复;编码器不加时间编码。查询编码器把源点小裁剪、傅里叶坐标和三个 ID token 加起来得到 zq。解码器对每个查询独立交叉注意 F,查询之间无自注意力,因此一次编码可服务任意多个稀疏或稠密查询。
- 训练 20 万步,骨干 DA3-Giant。静态场景用固定三维点提供跨视对应;有轨迹的动态数据在至多十倍时间窗内采样,并混入多相机;无轨迹动态数据只监督同时刻几何,避免错误运动标签。损失以尺度不变、置信度加权的三维 L1 为主,辅以置信度、像素、可见性、法向与位移项。位姿由跨坐标系对齐稀疏三维点得到。
逐图理解论文
顺序依赖的瓶颈
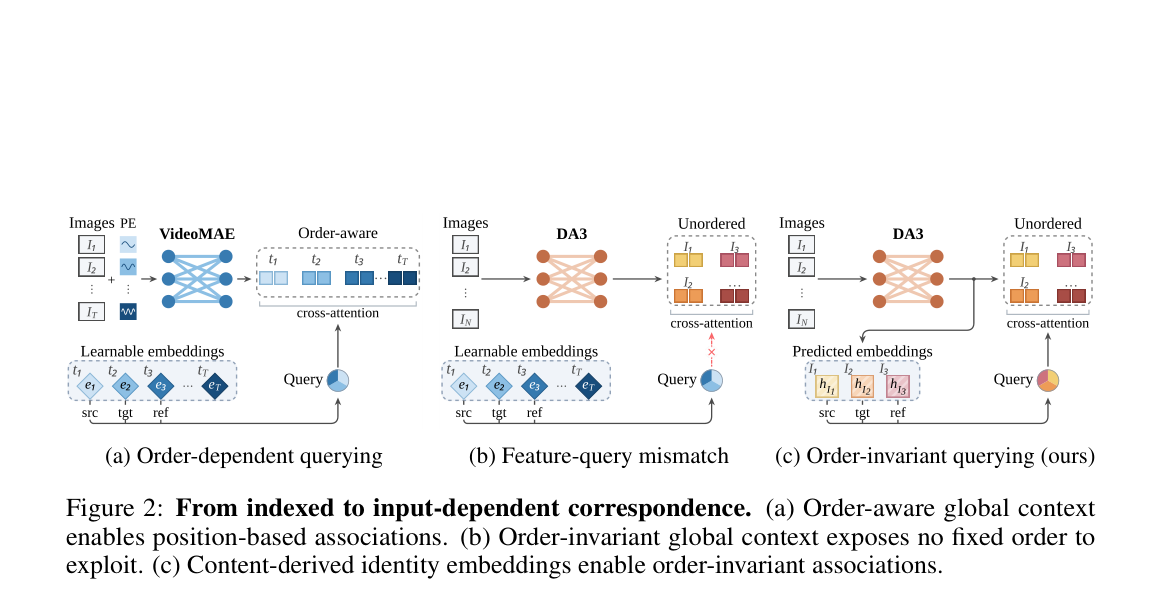
图2从有序查询到内容身份:左 VideoMAE 加位置编码用可学习时间嵌入;中把编码器换成无序 DA3 后查询对不上;右用预测的每帧嵌入做与顺序无关的关联。
Figure 3: ARROW architecture
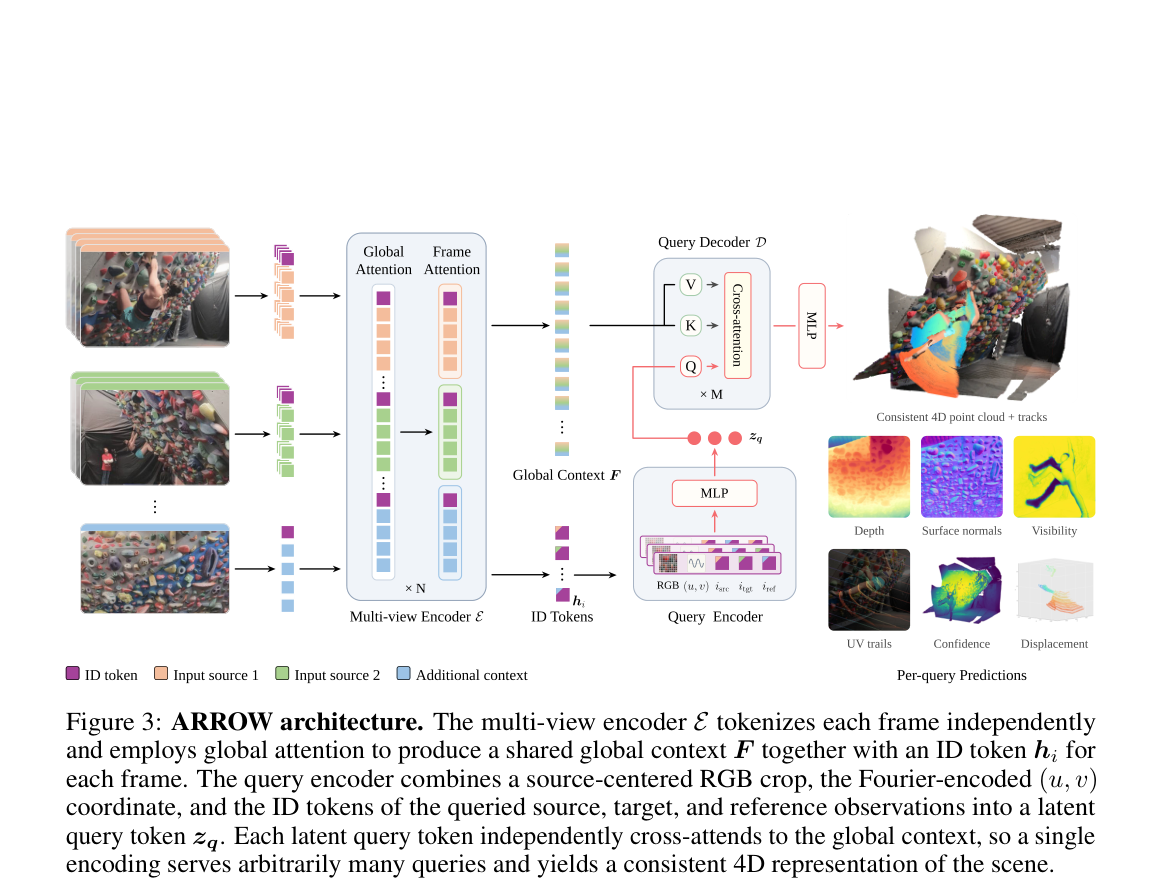
图3架构:多源攀岩图像经帧内/全局注意力得到全局上下文与 ID token;查询编码器融合 RGB 裁剪、傅里叶坐标与源/目标/参考 ID;稀疏解码器交叉注意后输出一致四维点云与深度、法向、可见性等。
Figure 1: ARROW reconstructs 4D scenes over arbitrary sets of input images
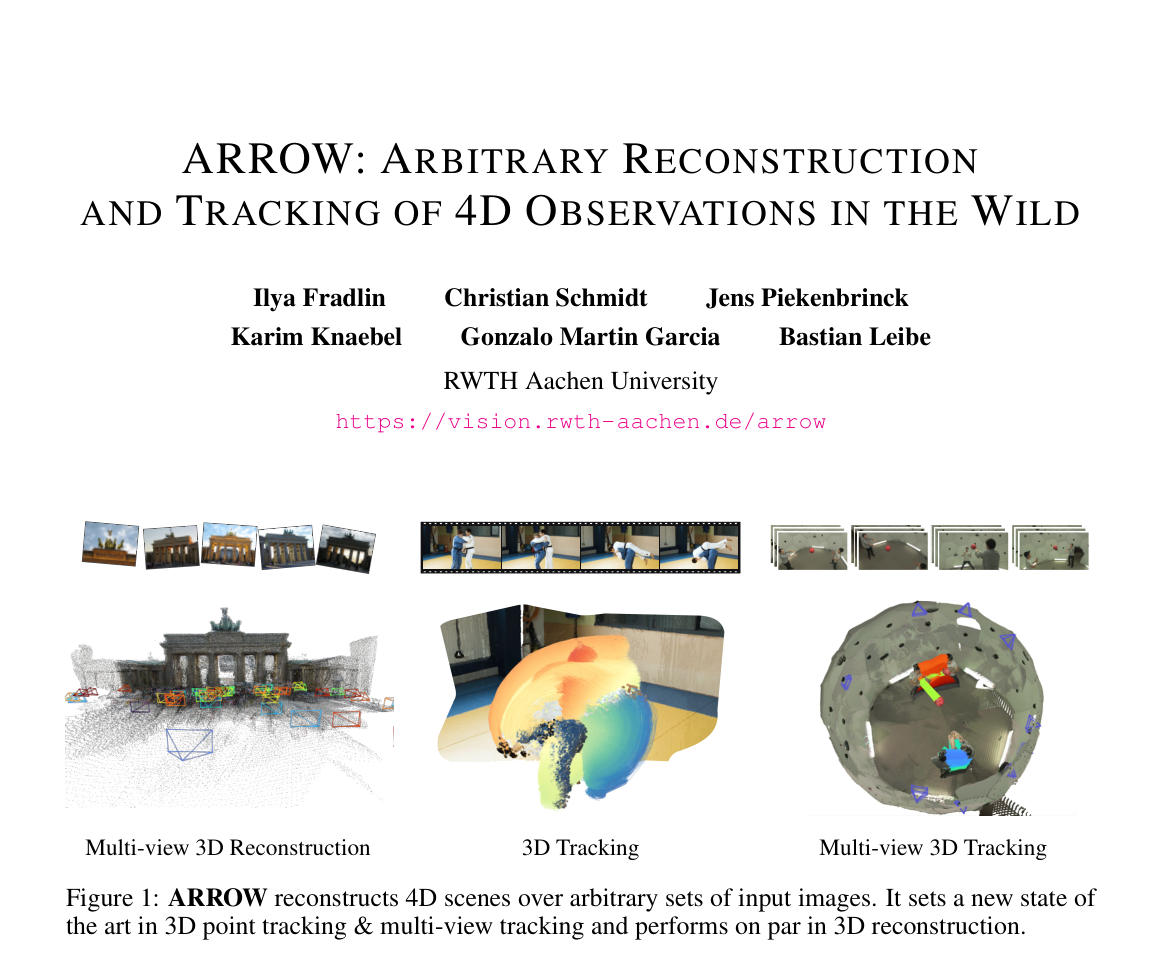
图1三列能力展示:左为勃兰登堡门多视图点云与相机锥体;中为室内人物彩色长程三维轨迹;右为多相机室内场景的多视图三维追踪。宜作特色图。
实验如何设计?
- WorldTrack 在 64 帧序列上从首帧查询,轨迹表达在第一相机坐标系并做全局中位尺度对齐。TAPVid-3D 在最长 300 帧、任意查询帧上评测,无真值内参;ARROW 对整段编码后逐目标查询,不做滑窗拼接。
- 多视图把 MVTracker 改成四路静止相机、24 个同步时刻、仅 RGB 与二维查询。位姿评测 Bonn、Sintel、动态多相机 Panoptic Studio;重建评测 NRGBD 与 7-Scenes;深度评测 Bonn、KITTI、7-Scenes。
- 消融用 10 万步 DA3-Large。S1 接近有序视频 D4RT 配方,S2 改 ID 条件,S3 去掉编码器时间编码,S4 引入跨视与非连续采样,S5 加入四个静态多视图数据集。
关键结果与论文证据
- 表1:WorldTrack 四个数据集上,ARROW 的全体与动态 APD/EPE 均为最优,例如 ADT 全体 APD 93.55、EPE 0.0818,Dynamic Replica 动态 APD 91.47(页7)。
- 表2:TAPVid-3D 相机系平均 AJ 0.248、APD 0.341,高于 D4RT 的 0.212/0.283;世界系平均 APD 0.385、L1 0.041。遮挡准确率 0.863 略低于部分基线,作者认为宽高比变化下像素定位还需要更长优化(页7)。
- 表3:仅 RGB 多视图平均 APD 61.0、AJ 49.2,明显高于 OmniX 的 48.0 APD 以及外挂 VGGT/DA3 的 MVTracker。12 个数据集–指标组合中仅 DexYCB EPE 落后,作者将其部分归因于 DA3 预训练分布(页8)。
- 表4–5:Sintel ATE 0.0613,Panoptic 位姿三项领先;NRGBD Chamfer 0.0263。Bonn 深度 AbsRel 0.041。图4在 DAVIS 公交、人群、海滩、街道上轨迹更连贯、几何更干净。表6显示非连续采样给多视图 APD 带来约 28.85 个百分点的最大跳变(页8–9)。
阅读时需要注意
- 没有显式时间编码,输出时刻必须对应输入观测,不能在时刻之间插值或外推到未观测的未来。
- 稠密解码代价高;查询互不交谈,远距或低置信区域可能变弱。
- 分布内视角与自我中心等分布外输入混合时多视图性能会掉;局部位姿与像素精度仍敏感。
关联工作
- D4RT 提供可独立查询的解码接口,但输入侧仍是视频顺序思维。
- DA3、VGGT 等几何 Transformer 提供无序图集先验,ARROW 把相机 token 改造成查询身份。
- OmniX、4RC、V-DPM 走稠密四维预测;ARROW 用同一编码服务稀疏控制与稠密几何,且不依赖外挂深度。