快速导读:ATI-VLA 先用共享码本把观测与动作对齐到可行动离散潜空间,再以轻量旁路把预测潜变量按层间隔注入动作解码,只优化动作损失。
预测式视觉语言动作模型想靠未来观测或世界动态给机器人前瞻,但不少方法把预测当辅助损失硬加到动作目标上,结果训练变慢、模态对不齐,整体还不如只出动作的模型。
ATI-VLA(arXiv:2610.01741,NeurIPS 2026;哈工深 / 大湾区大学等)给出 Align-Then-Inject:先用共享码本把观测与动作对齐到可行动离散潜空间,再以轻量旁路把预测潜变量按层间隔注入动作解码,第二阶段只优化动作损失。仿真与真机上报告更高成功率与更快收敛。项目页 https://jiutian-vl.github.io/ATI-VLA-page。
英文题目:ATI-VLA: Action-Centric Predictive Vision–Language–Action Models via Actionable Alignment Then Adaptive Injection
论文出处:arXiv 每日论文精选 · arXiv:2610.01741
原始论文:PDF / 论文页面
这篇论文解决什么问题?
一般 VLA 把图像、指令直接映射到低层动作;预测式 VLA 额外预报未来帧或世界知识,希望动作更有前瞻。作者发现这条路经常跑偏:观测预测与动作生成落在不同潜分布,预测信号很难真正服务控制。
更麻烦的是联合优化。把预测损失与动作损失直接相加,梯度互相抢,训练动态不稳、收敛慢,DreamVLA 一类方法甚至出现塌缩。于是预测信息不但帮不上忙,还会把学习带离动作中心目标。
要解决的问题因此很具体:怎样让预测表示可被动作解码使用,又怎样在单一动作目标下注入它们,而不是再开一条互相打架的辅助任务。
核心创新
- 提出 Align-Then-Inject:先对齐再注入,把预测式 VLA 拉回动作中心学习。
- 用共享码本与联合解码把观测与动作映射到同一离散潜空间,缓解模态鸿沟。
- 轻量自适应旁路按层间隔注入预测先验,第二阶段只训练动作目标,避免联合优化冲突。
方法概览
ATI-VLA 基于 OpenVLA-OFT / OpenVLA-7B,分两阶段。阶段一:当前观测与动作经模态编码器后用同一码本量化,统一注意力解码器联合预测未来观测与未来动作,使预测潜变量落到动作空间。阶段二冻结对齐模块,编码观测得到的预测潜变量经 FFN 旁路按层间隔 s 交叉注意力注入动作查询,残差权重 β_l 可学习;该阶段只优化动作损失。推理时不显式生成未来帧,直接用对齐潜变量引导动作块。
- 实现基于 OpenVLA-OFT,骨干为 OpenVLA-7B。阶段一做可行动表示对齐:当前观测经补丁嵌入与空间 Transformer,当前动作经 MLP 铺成空间对齐网格,两者用同一码本量化;统一解码器先对当前观测–动作做自注意力,再对拼接离散潜变量做交叉注意力,两个投影头分别预测未来观测与未来动作。对齐损失同时监督两者,促使离散码成为跨模态、有因果一致性的动作原型。
- 阶段二冻结对齐模块。大模型接收当前观测、语言指令与可学习动作查询,输出 n 步动作块。预测潜变量只来自对当前观测的对齐编码,经 FFN 旁路按层更新,在 l mod s = 0 的层用交叉注意力调制动作查询,残差强度 β_l 可学习。该阶段只有动作损失,推理也不显式生成未来帧。
- 注入不宜过密:理论与表6显示逐层注入会过约束后期精细控制。作者取 s=8,大约是骨干深度的三分之一到四分之一;Llama-2-7B、Qwen2.5 系列上最佳间隔也落在这个比例附近。
逐图理解论文
模态鸿沟与优化冲突
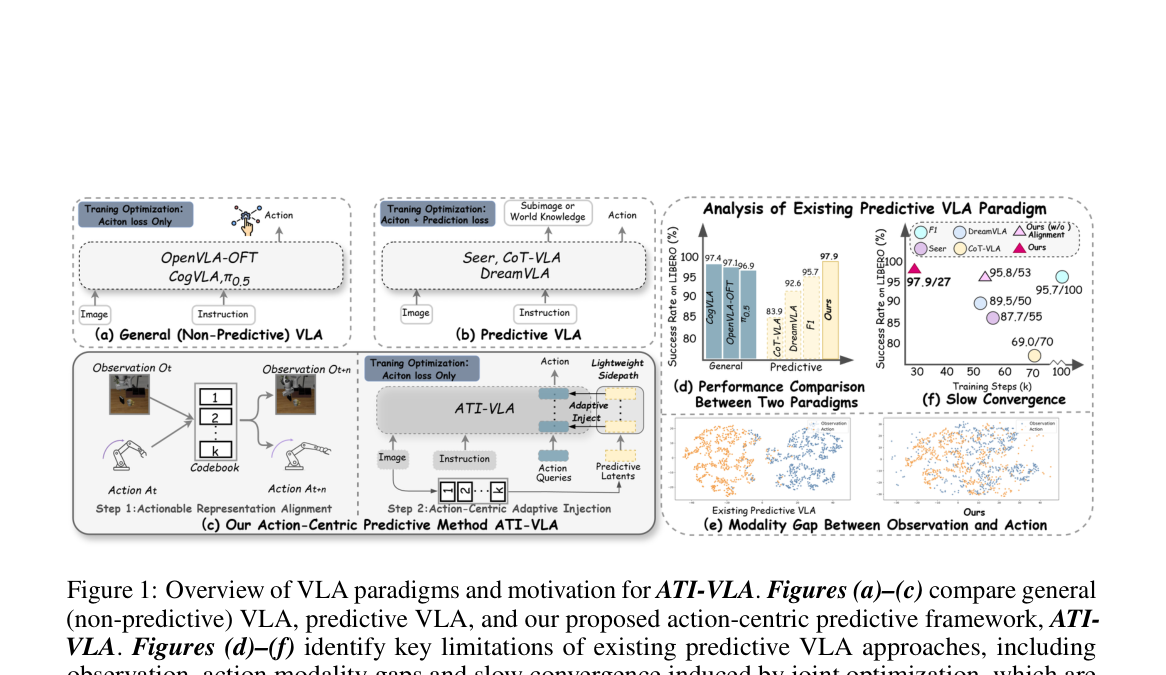
图1总览:左上一般 VLA 只优化动作损失;右上预测式 VLA 把动作与预测损失相加;左下 ATI-VLA 先共享码本对齐再自适应注入且仍只优化动作。右侧柱状图 LIBERO 上 Ours 97.9 居首,t-SNE 对比模态鸿沟,散点图显示约 27k 步即到 97.9。宜作特色图。
共享码本对齐
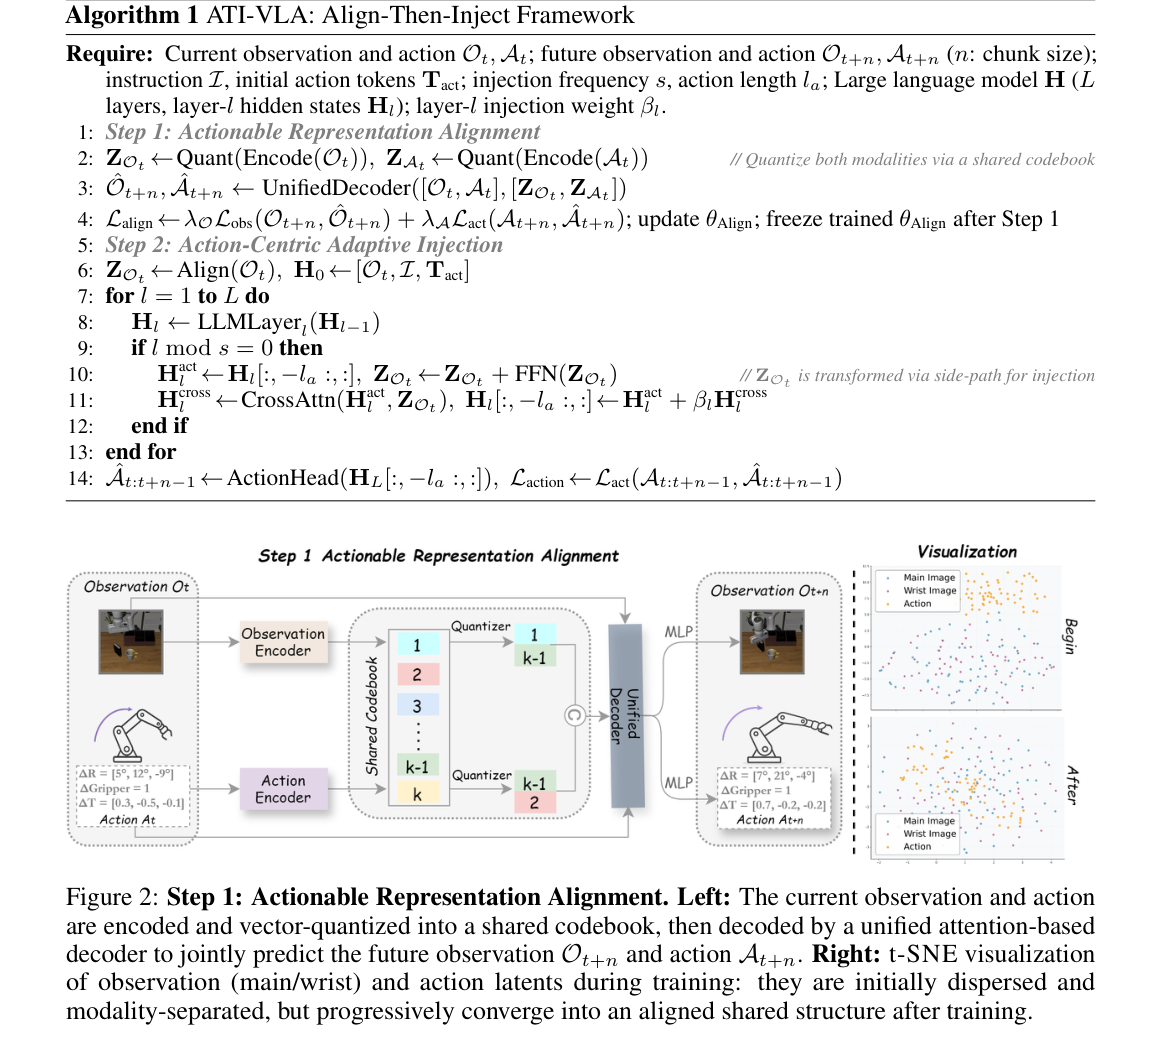
图2阶段一:观测与动作编码器进入共享码本,统一注意力解码器联合预测未来观测与未来动作;右侧 t-SNE 从 Begin 的模态分离变为 After 的交错混合。资产上部还带 Align-Then-Inject 伪代码。
自适应注入
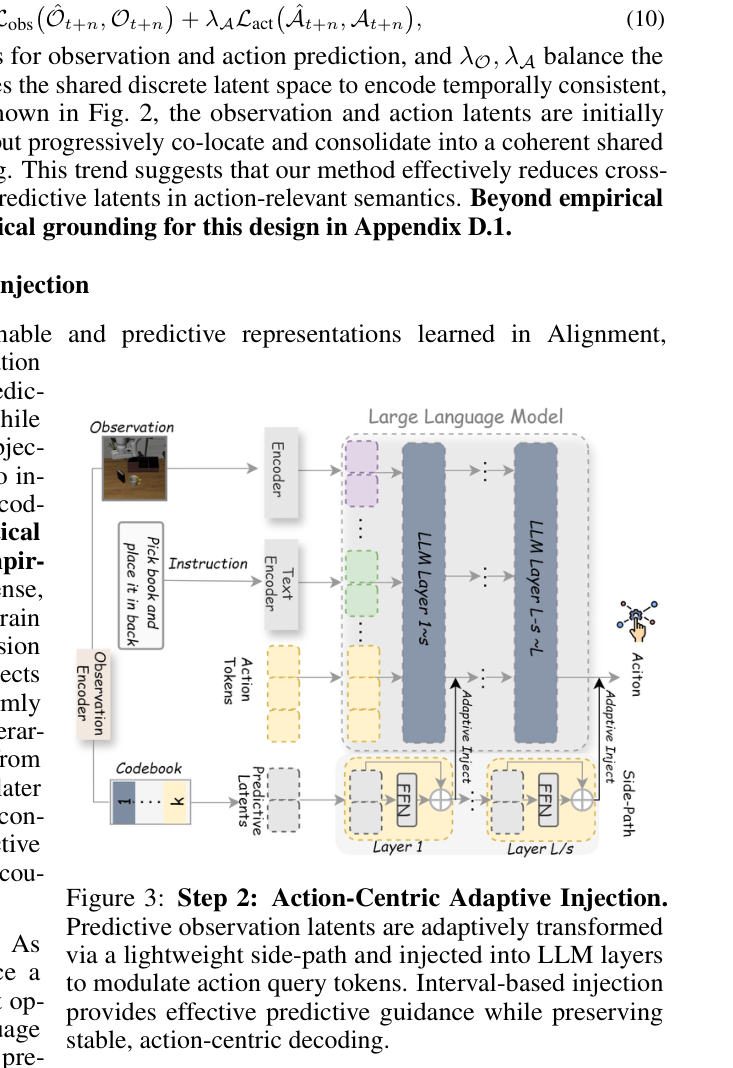
图3阶段二:观测、指令与动作查询走大模型主干部;码本预测潜变量经 FFN 旁路,在 Layer 1 与 Layer L/s 等间隔层自适应注入动作查询,最后输出动作块。
结论与局限
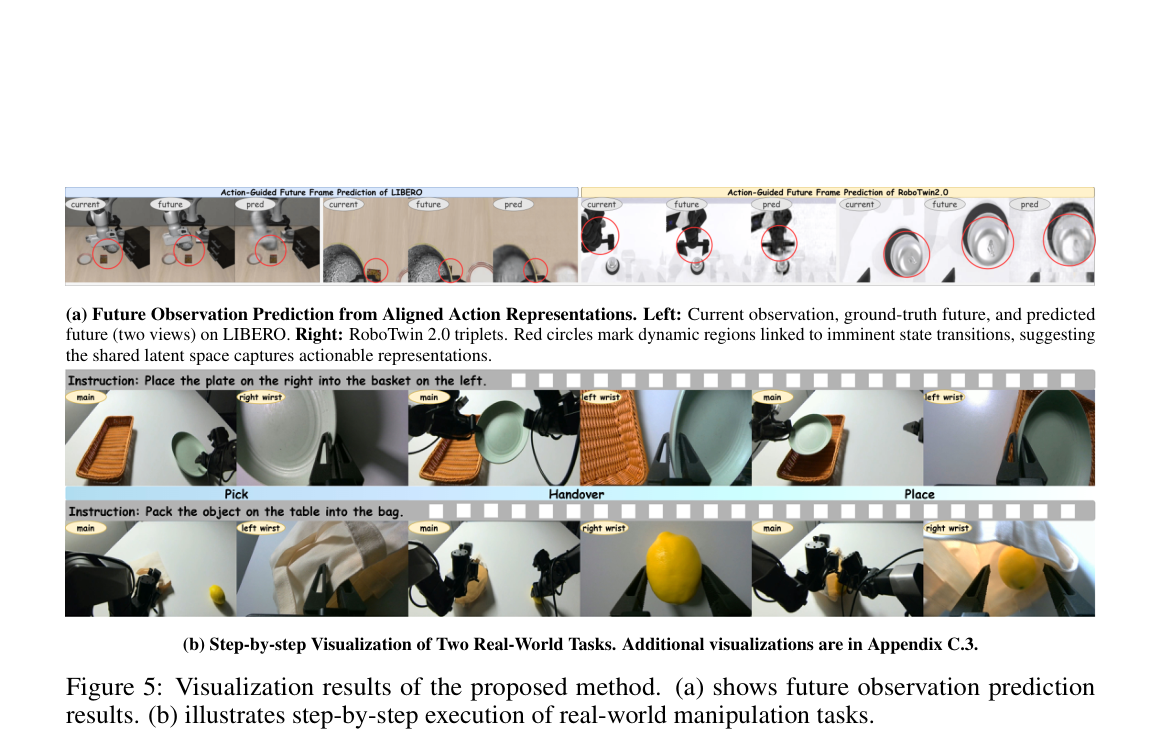
图5定性:上排 LIBERO 与 RoboTwin 由对齐动作表示预测未来帧,红圈标动态区域;下排真机把盘子放入篮筐、把柠檬装袋,分拣、交接、放置三阶段。
实验如何设计?
- 训练用 8 张 H100 80GB,真机推理在单张 RTX 5090 32GB。仿真评测 LIBERO 四分套件与 RoboTwin 2.0;对照含 OpenVLA-OFT、π0 等一般 VLA,以及 ATM、DreamVLA、CoT-VLA、F1、UniVLA 等预测式方法。
- 真机部署 Galaxea R1 Lite 与 AgileX Cobot Magic,任务覆盖装箱、收集马克笔、传递盘子、叠 T 恤及其 OOD 变体;每任务 50 条人类遥操作示范,表4按阶段统计成功率,平均对应整段完成率。
- 消融覆盖注入随机噪声潜变量、去掉显式对齐、三种对齐结构的 t-SNE、注入频率,以及固定骨干与数据后的设计拆解。
关键结果与论文证据
- 表1:LIBERO 上 ATI-VLA 平均成功率 97.9%,四分项 98.6/99.4/97.2/96.2,整体排名第一,高于 OpenVLA-OFT 的 97.1% 与 F1 的 95.7%;长程套件 96.2% 明显强于多数预测式基线(页6)。
- 表2:RoboTwin 2.0 平均 72.3%,Click Bell 91%、Open Laptop 87%、Place Container Plate 90%,高于 π0 的 60.0% 与复现 OpenVLA-OFT 的 58.8%(页7)。
- 表4:Galaxea 长程平均 70%,AgileX 72%,分别高于同设定复现的 F1(57%)与 OpenVLA-OFT(55%/54%);OOD 叠衣约 60%。表3训练 16.2 小时,约为 OpenVLA-OFT 的一半,延迟 0.107 秒、吞吐 74.8Hz,旁路几乎不增加开销(页7)。
- 对齐后跨模态相似度从 0.31 升到 0.83,CKNNA 从 0.2 升到 0.7;只有共享码本加联合解码能把主摄、腕部与动作潜变量混在一起。同骨干下完整方法 97.9%,去掉对齐的注入掉到 93.4%。s=8 最优,s=1 伤害长程(页8–9)。图5显示共享潜空间能标出即将发生的状态变化,真机盘子交接与装袋过程可分段完成。
阅读时需要注意
- 数据与场景仍偏任务专用遥操作示范,尚未覆盖开放世界的物体、场景、本体与交互多样性。
- 更强策略若直接部署到无约束环境,预测误差或指令接地错误可能带来非预期动作,需要约束、人工监督与失效检测。
- LIBERO 接近饱和,跨基准、跨本体的绝对领先不能直接外推。
关联工作
- OpenVLA-OFT 与 π 系列代表只优化动作的一般 VLA;本文以其为骨架,说明预测信号要用对齐之后才能加分。
- DreamVLA、CoT-VLA、F1 把未来预测写进同一目标,容易出现模态鸿沟与优化冲突。
- VITA 也用共享码本,但走分离重建与联合损失;ATI-VLA 强调联合预测未来并在注入阶段冻结对齐、只训动作。