快速导读:Soundwich 在冻结的联合音视频模型上生成共享视频与多条可独立编辑的同步音轨,并控制每条音源的内容和时间。
联合音视频模型已经能一次生成口型对上的画面和声音,但音频几乎总是一条混在一起的单轨。这和真实后期相反:对白、音乐、拟音、环境声本来就是分开的层,要能单独改时间、静音或替换。把预训练模型的音频轨迹在 batch 维展开成多条源轨迹、共用一条视频轨迹,听起来直接,却会让共享视频变成串音通道,钢琴和提琴被当成同一件事写进两条轨。
Soundwich(arXiv:2610.00691,西蒙菲莎大学 / 塞浦路斯大学 / CYENS / 特拉维夫大学)是一个免训练框架,把冻结的联合音视频流匹配模型变成:一条共享视频加 N 条可独立编辑的音轨。Stem Formation 用逐轨 CFG 和缓存载波规定每条音源是什么、何时响;内部 scene stem 先收集再广播场景上下文,避免音轨直接互听。Scene Integration 再按可见实体的时空掩码路由交叉注意力,把声音绑回对应的人、动物或物体。代码见https://github.com/CodyNing/Soundwich,演示见https://soundwich.avdemo.workers.dev/。
英文题目:Soundwich: Video Generation with Layered and Controllable Audio
论文出处:arXiv 每日论文精选 · arXiv:2610.00691
原始论文:PDF / 论文页面
这篇论文解决什么问题?
目标场景很具体:两个人对着背景乐说话,应得到两条人声轨和一条音乐轨,全部对齐同一段生成视频;时间窗可选,完全重叠时仍要能分开。SyncFlow、Ovi、UniAVGen、LTX-2、MiniMax H3 这类联合系统输出的是混音;MusicGen-Stem、MGE-LDM 等能做多轨,但停在纯音频、而且偏音乐。Step-by-Step V2A 给固定视频补互补音轨,不能同时生成视频。
共享视频既是让对话处在同一空间里的必要条件,也是泄漏路径。只靠正提示不够:模型会把并发乐器合成一个事件。时间控制同样不能只写在文本里,否则声音会堆到片段末尾互相重叠。还要把每条轨接到正确的可见实体,否则说话的是甲、嘴动的是乙。
因此方法必须同时做三件事:在冻结模型上展开多层音频、用可回放的时间信号而不是再训练控制器、让共享上下文走内部缓冲而不是音轨互听,并用掩码把交叉模态注意力限到对得上的实体。
核心创新
- 免训练地把预训练联合生成器变成共享视频加多层可编辑音轨。
- 用缓存载波回放在指定区间激活声音、在窗外兑向安静特征。
- 用不对称收集-广播场景轨加实体路由,既保场景一致又限制串音和错绑。
- 在时间遵守、源分配、自然度与可编辑应用上系统评测分层生成。
方法概览
冻结联合流匹配变换器,把音频潜变量展开成 N 条源轨迹加一条内部场景轨,视频保持共享。Stem Formation 用逐轨 CFG 分离内容,用发声/安静参考的自注意力载波按时间窗回放。Scene Integration 经场景轨收集-广播共享上下文,并用实体时空掩码限制 A2V/V2A,使每条轨只与对应可见源交互。
- 骨干是参数冻结的联合音视频流匹配变换器。音频潜变量 batch 展开成 N 条源轨迹,视频潜变量保持一条。每条源有正提示、负提示、可选活动区间,以及可见实体的文本描述用来取分割掩码;纯音乐或噪声可以没有实体。另加一条内部 scene stem 专门收上下文,生成结束后丢掉。
- Stem Formation 里对每条轨独立做 CFG:正提示拉向目标音,负提示点名要排开的竞争源。时间则来自模型自己的参考生成:一条含目标声,一条静音。对每个去噪步和每个块,从发声参考里平均高幅度自注意力向量得到激活载波,从静音参考里平均低幅度向量得到抑制载波。回放到目标时,活动窗内把激活载波加到当前自注意力输出;窗外衰减并兑向安静载波。活动门在边界约零点二秒线性收束。激活强度先在前百分之十去噪用 0.40 再降到 0.08。
- Scene Integration 把 Stem Formation 的视频、音轨和场景潜变量再加噪,在实体路由下联合去噪。场景轨在形成阶段对活跃源的加权和做注意力以收集时序; refinement 时每条源只在自己的活动窗内读场景轨。可见实体从形成阶段视频分割出时空掩码:A2V 里掩码内的视频查询读完整匹配音轨(含窗外静音,用来管口型休息);V2A 里音轨只读掩码内视觉特征,再用时间门把残差乘掉,让窗外的人声不再推动画面。最后解码成一条视频和 N 条可静音、改时序、替换或重混的音轨。
逐图理解论文
混音困境
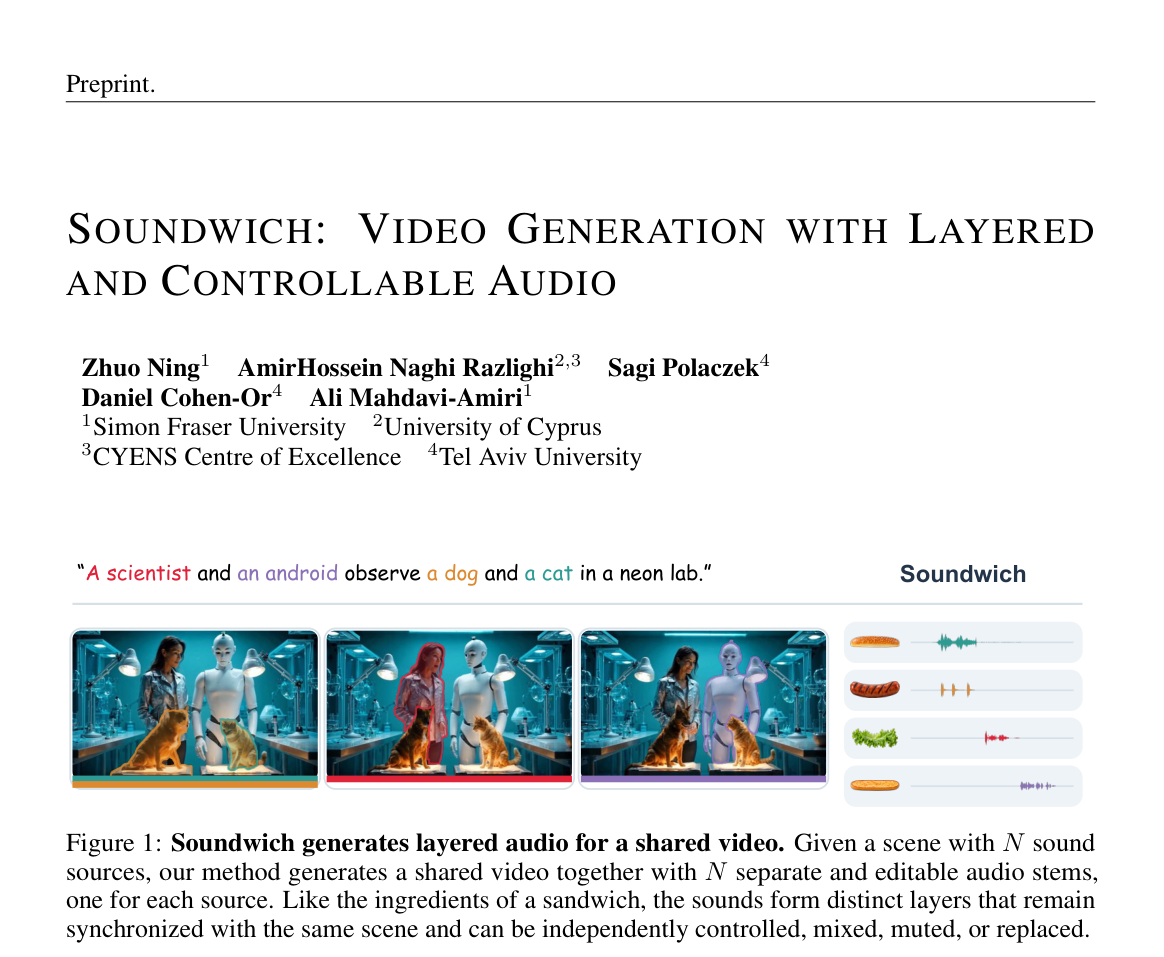
图1用三明治比喻分层音频。霓虹实验室里科学家、安卓、狗和猫,提示里四个名词用红、紫、橙、青绿上色。三帧画面底边是对应颜色的细条。右侧四层像面包、香肠、生菜、面包,各跟一条波形,表示每条音源单独成层、可混合静音或替换。
分轨形成
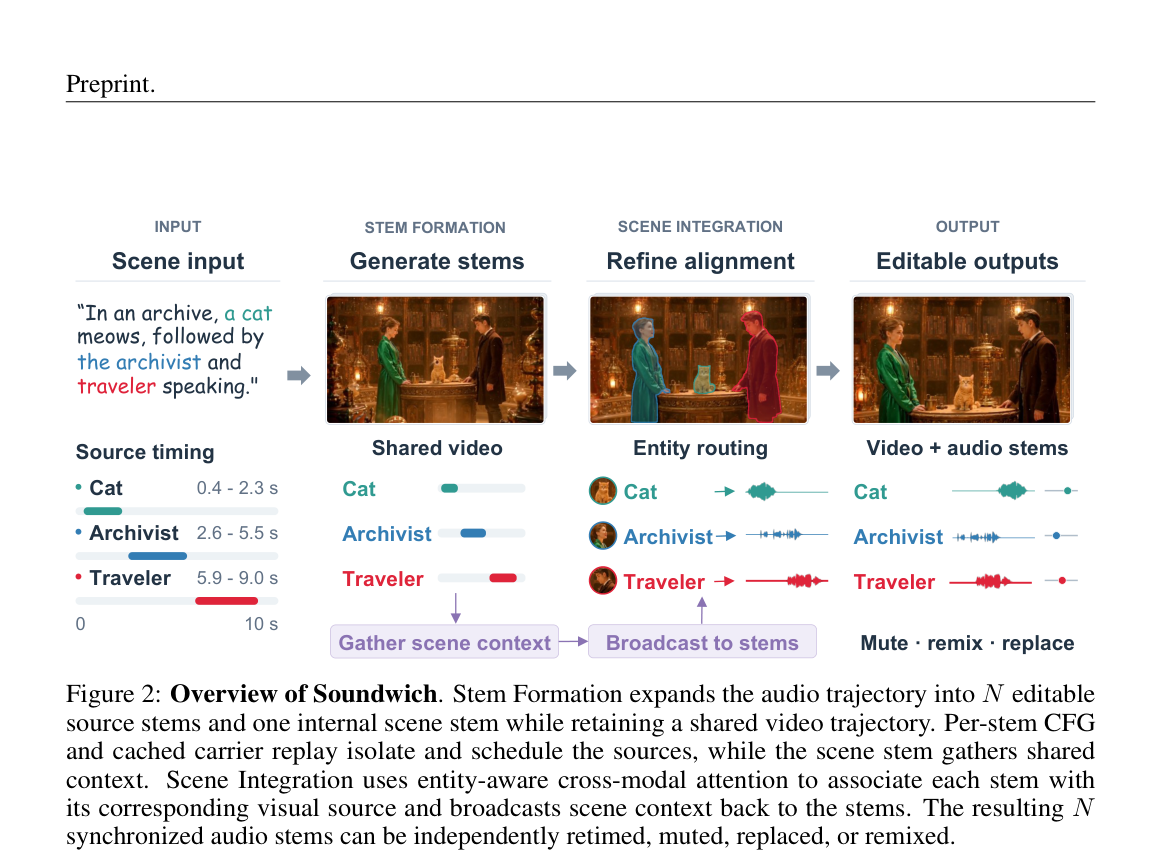
图2是流程总览,宜作特色图。四列依次是 INPUT、STEM FORMATION、SCENE INTEGRATION、OUTPUT。左侧场景是档案室,提示里猫、档案员、旅人用蓝绿红标出,时间轴为猫 0.4–2.3 秒、档案员 2.6–5.5 秒、旅人 5.9–9.0 秒。中间两列共用同一段烛光室内视频,分别生成分轨并做实体路由;底栏紫色条写 Gather scene context 与 Broadcast to stems。右列输出视频加三条波形,并标明 Mute · remix · replace。
场景整合
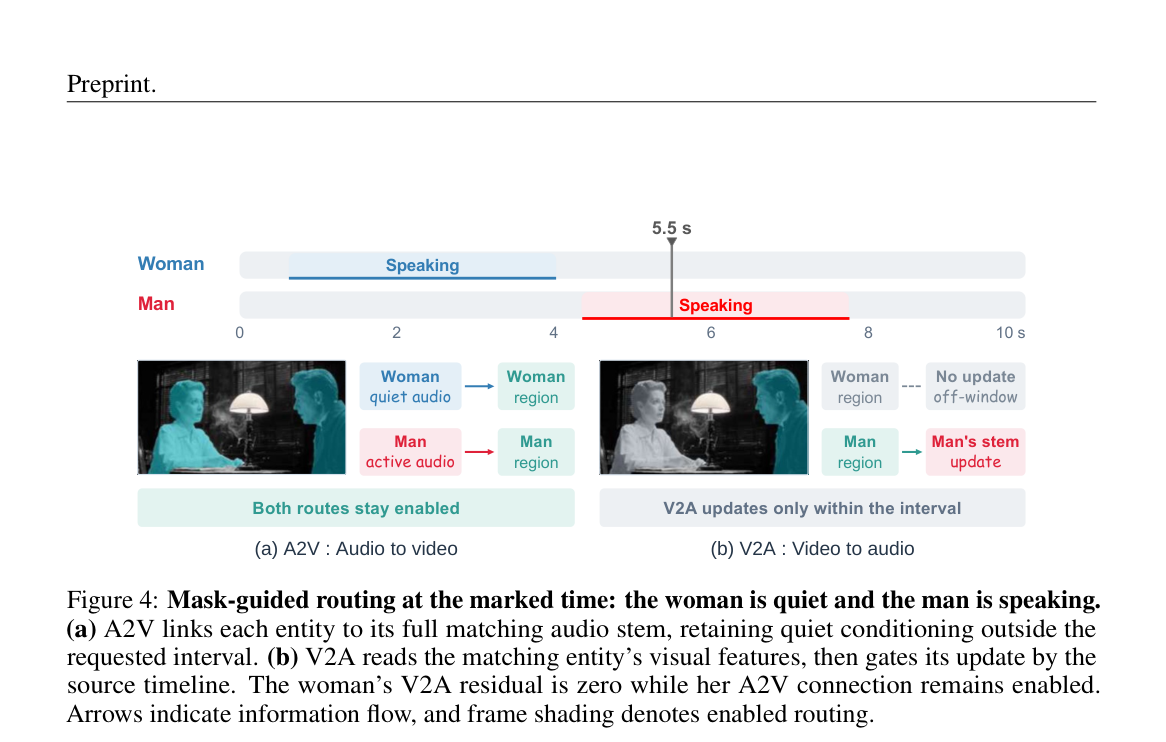
图4是五点五秒时刻的掩码路由:女声已结束、男声正在说。顶轴女声蓝条约在零到四秒,男声红条约在四秒半到八秒。左栏 A2V:两人区域都保持连接,女人走 quiet audio,男人走 active audio。右栏 V2A:女人区域标 No update off-window,只有男人区域把视觉特征写入男声音轨。画面是桌边对话的黑白剧照,着色块标出启用的路由。
实验如何设计?
- 对照包括标准 LTX-2.5 单轨混音、同样冻结模型上的朴素 batch 展开、Ovi、MiniMax H3 和 Gemini Omni。评测十五个场景四十个音源,覆盖对话、音乐、动物和物体交互;LTX-2.5、朴素展开、Ovi、MiniMax 与本文各三粒种子,Omni 每场景一个输出,先场景内再跨场景平均。
- 时间指标:窗内词错误率、窗口成功率(最多允许百分之五活动落在窗外)、无时间约束时的全片段声音成功率、顺序准确率、窗外活动比例。内容指标:分轨方法的源分配准确率,以及目标 CLAP 与最强竞争 CLAP。单轨方法用后处理分离:语音走 ASR 与词级对齐,非语音走 SAM Audio;作者发现后处理既不能强制时间线,也去不掉混音干扰。
- 消融分别关掉载波回放、逐轨引导、场景广播和实体路由。人工评测比较自然度与时间线名次,以及分离偏好;实体路由另有所有权与目标激活问题。应用展示包括把档案室猫叫与对白对调时间、替换侦探台词、对调自我介绍顺序,以及动画静帧图生视频后的分层编辑。
关键结果与论文证据
- Hospital Farewell 里女声应在 1.0 到 3.8 秒、男声 5.0 到 8.2 秒。朴素展开把两人都拖到片尾重叠,本文落在窗内。十五场景上窗口成功率 93.1%,朴素展开 15.0%,Omni 85.0%;窗外活动从 69.7% 降到 1.7%,窗内 WER 0.060。无时间约束的全片段声音成功率 100%,顺序准确率 100%(表1,页7–8)。
- 源分配从朴素展开的 82.2% 升到 90.0%。听众在平分平局后有 74.4% 更偏好本文的分离。自然度 87.0% 的判断把本文排第一,均次 1.16,标准 LTX-2.5 为 2.22,朴素展开 2.62。完全重叠、不给时间窗的六场景里,逐轨引导把分配准确率从 61.1% 拉到 95.8%,竞争 CLAP 从 0.262 降到 0.115(表2–3,页8–9)。
- 载波回放把窗口成功率从 15.6% 拉到 93.3%,顺序从 73.3% 到 100%,窗外活动从 63.06% 降到 1.23%;用零向量替换安静载波会让先验继续在窗外出声。场景广播把情境自然度第一名从 17.3% 升到 76.7%,质量分从 6.51 到 8.19。实体路由把正确所有权从 34.7% 升到 95.3%,目标激活从 40.7% 升到 96.0%(页9)。
阅读时需要注意
- 复杂、多源或含糊场景里层间干扰会加重,方法也继承底层预训练模型的偏差与能力上限。
- 音源集合和时间结构仍需用户指定;作者把自动发现层及其时序列为后续工作。
- 更长视频需要动态层,因为音源会进出场景;当前设定是固定的一组预先定义音轨。Gemini Omni 每场景只跑一次且未记录后端版本,该对照不易精确复现。
关联工作
- 联合生成一条线用双流或单流变换器出混音,另一条线在推理时对齐两个独立生成器;它们都不给出可单独改时序的分轨。纯音频多轨工作证明了 stem 建模的价值,但没有共享视频约束。
- 时间控制可写成时间戳、脚本或可学习控制器,FreeAudio 用注意力和潜窗口做免训练时间控制。Soundwich 必须让多条隔离音源与一条共同演化的视频对齐,并保留每条作为可编辑输出。
- 视觉到音频的 DualDub、SelVA、SAGANet 在固定输入视频上选源或分解码器;本文要在视频本身还在生成时就把音轨绑到对应实体。共享注意力常见于图像风格或外观一致性,这里改成不对称的收集-广播拓扑。