快速导读:4Director 把每件物体建成一次完整网格,用每帧一个刚体变换与相机同框,再经 Motion Adapter 把深度脚手架生成视频。
专业拍片时,导演先规定机位和每个角色怎么走,走路姿态、光影则交给现场。现有视频世界模型多半只能给文本、动作或相机令牌,物体控制要么停在图像平面上的拖拽路径、框和点,深度与朝向含糊;要么把可见外壳抬成点轨迹或高斯斑,转身或新视角露出来的那一面只能逐帧乱编。
4Director(arXiv:2610.02160,Stability AI / 伊利诺伊大学香槟分校)把这件事改成显式四维场景:每件被点选的物体用 Pixal3D 建成一次完整规范网格,背景抬成点云,相机与物体共享同一坐标系;用户在三维视窗里画轨迹,每帧只用一个刚体变换整体移动物体,再把场景渲成深度视频。可训练的 Motion Adapter 把这条几何脚手架注入冻结的 Wan2.1-VACE-14B,由生成器补外观、光照、肢体非刚性动态,以及机位带出来的新背景。项目见https://stability-ai.github.io/4director/。
英文题目:4Director: Controlling Video World Models with Rigid 3D Geometry
论文出处:arXiv 每日论文精选 · arXiv:2610.02160
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图2用骆驼原地转身一百八十度把缺口说死:二维框只能标出投影位置,缩框分不清物体远离还是变小;三维点轨迹和高斯斑只能覆盖输入图看见的那一层壳,背面没有几何,生成结果也就转不彻底。MotionCtrl 有相机但物体只走二维路径;Perception-as-Control 用部位球体;SymphoMotion 与 VerseCrafter 把跟踪点或单高斯渲到点云上,朝向最多算部分支持,完整几何和新物体插入都不支持。
几何感知世界模型如 DeepVerse、Voyager、Yume、Aether 能用重建结构做探索,控制仍是文本、动作或相机令牌,无法规定单个物体怎么走。4Director 把世界模型定义为输出服从可编辑场景状态的生成器:网格、每帧刚体变换和相机在生成之前就已经固定。
因此方法必须同时解决三件事:去掉图像平面的深度朝向歧义、给未看见的那一面提供可渲染几何、让用户用一条轨迹移动整件物体而不是逐点刷轨迹。
核心创新
- 提出完整物体几何加每帧刚体变换的显式四维场景,相机与物体共享坐标系。
- 用 Motion Adapter 把刚性深度渲染注入预训练视频生成器,几何锁定运动、生成器补动态。
- 自动标注 RealCOD-Rigid,并引入仅在身份保留帧计分的 Identity-Gated IoU。
- 在画质、相机误差与物体控制上系统对比四种公开联合控制方法。
方法概览
从单图用 MoGe-2 与 SAM 2 抬背景点云,用 Pixal3D 为每件物体建完整规范网格,在同一坐标系里用关键帧规定相机与刚体轨迹,渲成深度视频。Motion Adapter 作为约三十亿参数的 VACE 式上下文分支,把深度视频和首帧注入冻结的 Wan2.1-VACE-14B,用流匹配学习补外观、光照、非刚性残差和新背景。训练数据 RealCOD-Rigid 由自动管线从 RealCOD-25K 恢复两万零七百七十四段刚性场景。
- 给定一张图、文本提示、相机轨迹以及用户点出的每件物体的刚体轨迹,目标是合成从该图出发、跟相机、保身份、并带合理非刚性动态的视频。MoGe-2 估深度与内参,SAM 2 把点击变成掩码。掩码外的背景反投影成静态点云;每件物体由 Pixal3D 建成带背面的规范网格并对齐到掩码与深度。参考帧相机取单位阵,物体第一帧变换也是单位阵。新物体可从另一张参考图重建网格,把带纹理网格渲进输入图作为首帧。
- 用户在同一坐标系用关键帧规定轨迹。第 t 帧物体是旋转加平移后的网格,相机走世界到相机矩阵。整段场景只携带刚体运动。背景点云与放置后的网格按该帧相机投影成深度图,最近表面写入像素,没有几何的位置留空,得到深度控制视频。它只编码视点、每件物体的刚体变换和遮挡,不包含外观、光照、走路时的肢体残差,以及原图没看见的背景。
- Motion Adapter 约三十亿参数,按 VACE 的上下文分支设计:VAE 把深度视频和输入图编成上下文流,八个上下文块每隔五个 DiT 块做一次交叉注意力注入,骨干的 VAE、umT5 与 DiT 全部冻结。训练用流匹配:控制视频来自从原片恢复的刚性场景,目标是原片本身。表面点写成刚体项加非刚性残差,只有刚体项进入控制,适配器必须跟上几何并让生成器补残差。推理时用户导演的场景与恢复场景被一视同仁,新轨迹和插入物体不需要再训练。
逐图理解论文
控制缺口
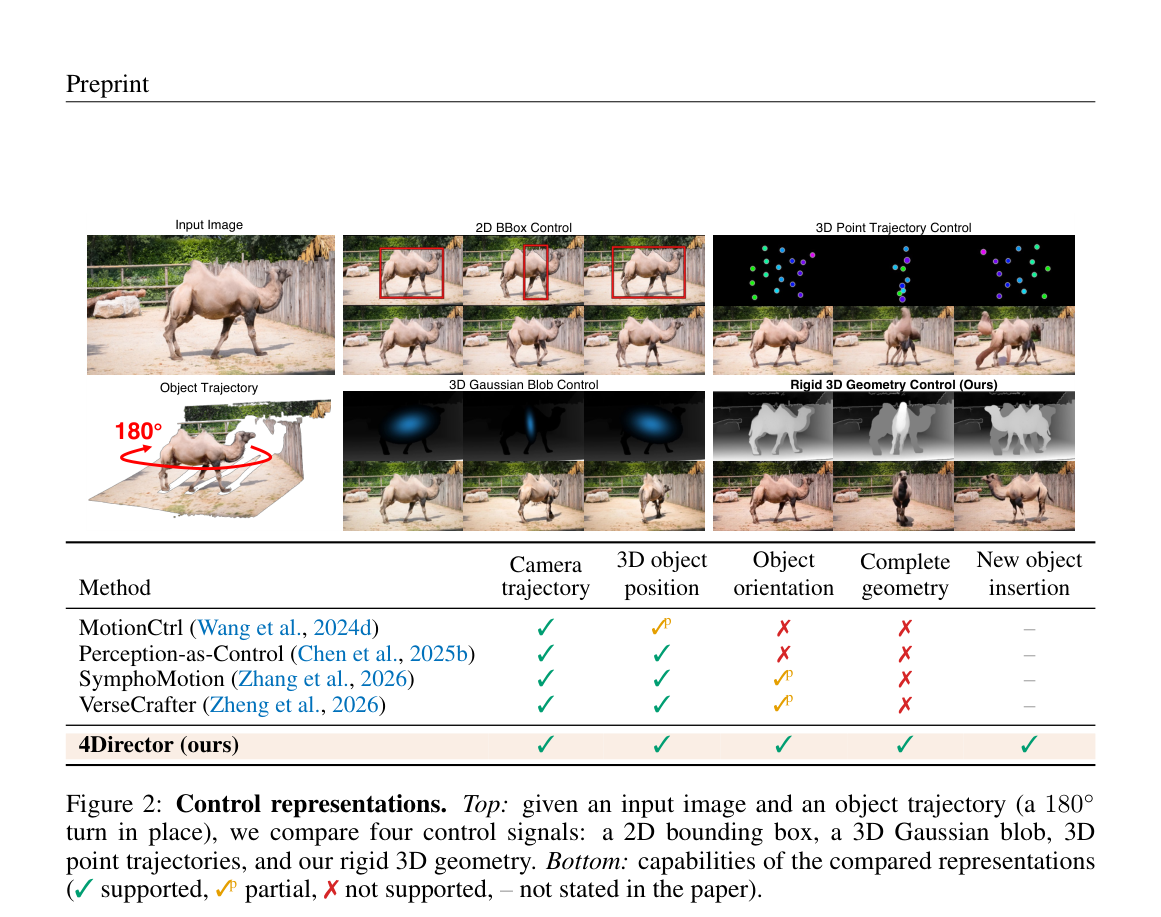
图2比较四种控制。左上动物园骆驼,左下三维示意图标 180° 原地转身。二维框只是红框平移,生成骆驼几乎不转;三维点轨迹是黑底彩点,转身不完整;高斯斑是蓝色椭球,只能看到可见壳;右下刚性几何给出带背面的灰色完整骆驼,生成结果转到另一侧。底表显示只有 4Director 同时勾上相机轨迹、三维位置、朝向、完整几何和新物体插入。
刚性几何
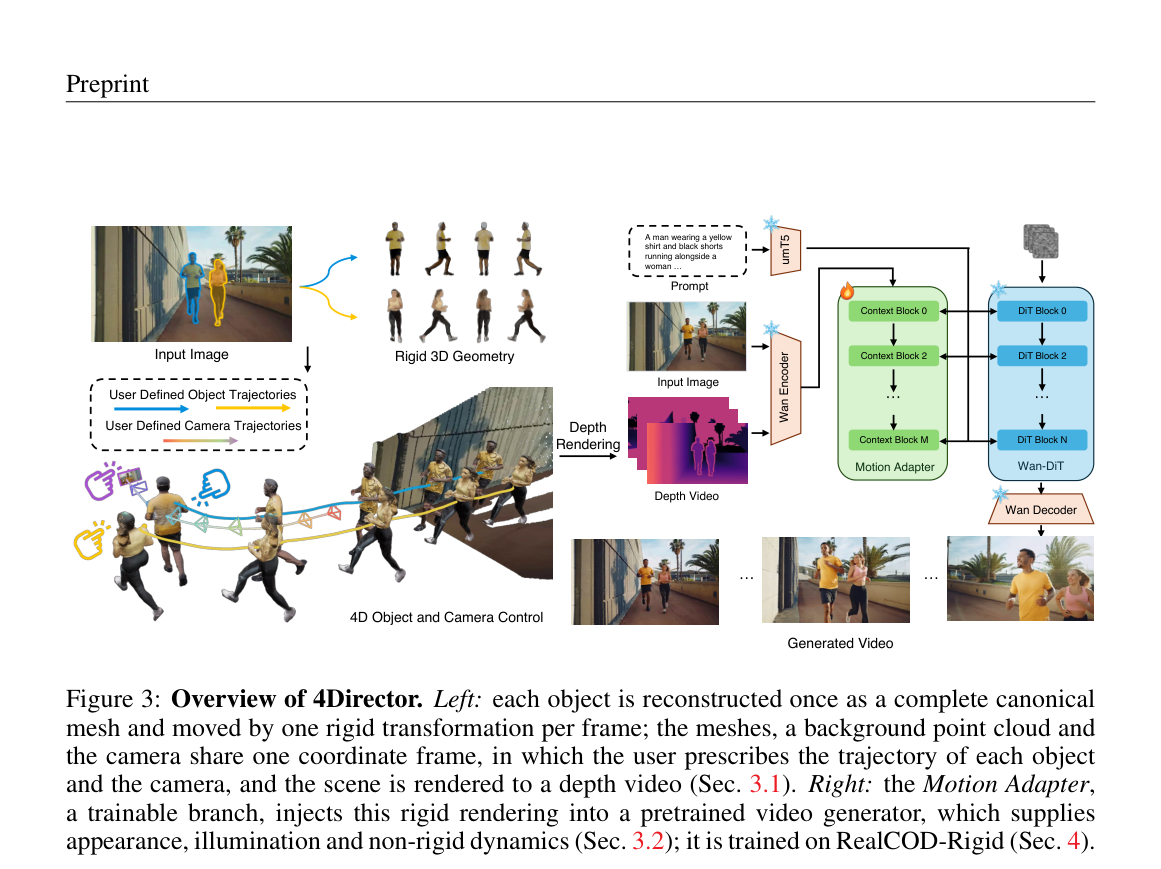
图3是方法总览,宜作特色图。左上输入图是棕榈树下的走廊,一蓝一黄两个跑步者;用户轨迹画成蓝、黄物体曲线和彩色相机锥。中间把两人建成完整网格,沿轨迹刚体摆放成 4D Object and Camera Control。Depth Rendering 得到粉紫深度视频。右侧 Motion Adapter 的绿色 Context Block 注入蓝色 Wan-DiT,顶上 umT5 吃跑步提示,Wan Decoder 输出两人沿走廊跑步的视频。
关键证据
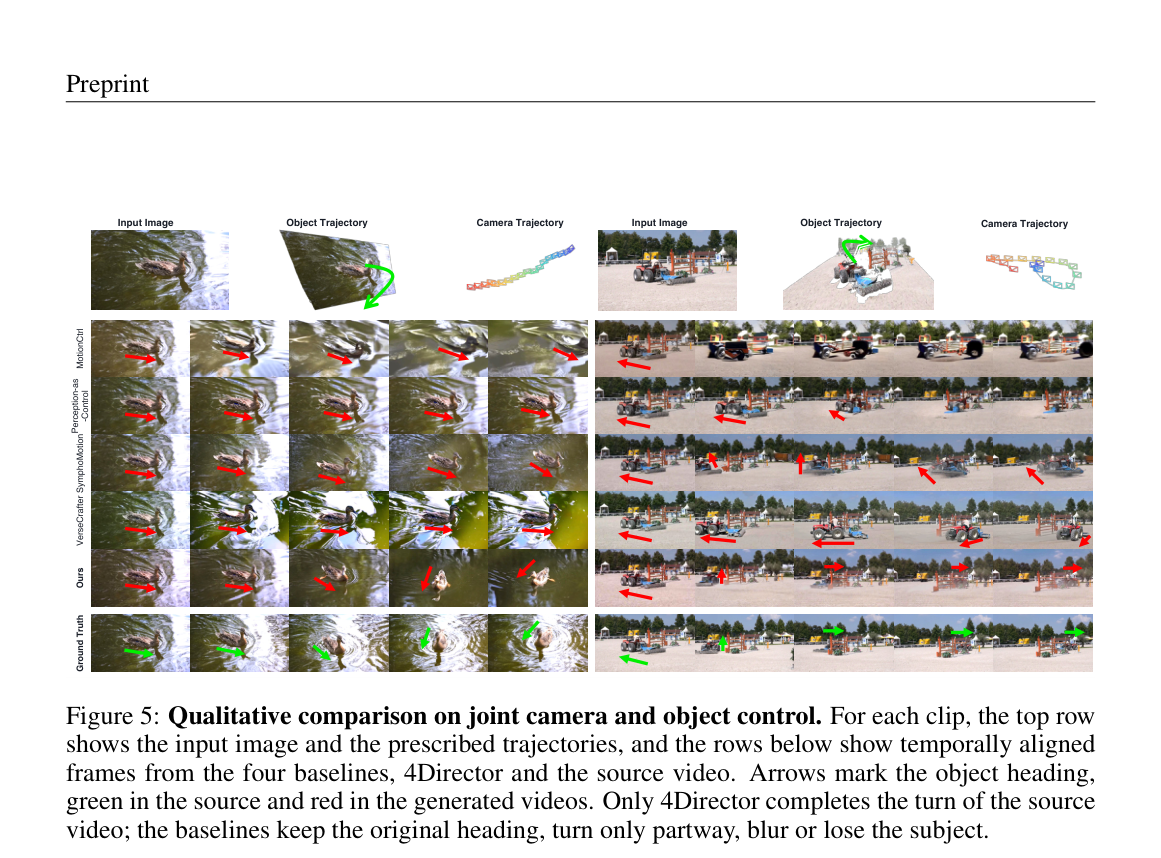
图5是联合相机与物体控制的定性对比。左列池塘鸭子,右列游乐场拖拉机,顶行给出输入图、物体轨迹和相机轨迹。下行依次为 MotionCtrl、Perception-as-Control、SymphoMotion、VerseCrafter、本文与真值;红箭头标生成朝向,绿箭头标真值。只有本文一行转到与真值相近的朝向;对照保持原朝向、转到一半、发糊或丢主体。
实验如何设计?
- 训练数据 RealCOD-Rigid 从 RealCOD-25K 自动恢复:MegaSaM 加 MoGe-2 与 UniDepthV2 估每帧深度、内参和相机;Pixal3D 从首帧重建网格并用稳健相似变换放到场景里;TAPIP3D 跟踪物体上的三维点,交替稳健拟合与内点选择找出稳定核,只在核上求每帧刚体变换,避免肢体摆动带偏整件物体。通过全部阶段且不用于评测的两万零七百七十四段构成训练集。
- 适配器从公开 VACE 分支初始化,扰动注意力与前馈矩阵后在 832×480、八十一帧上训练三轮,二十四块 GPU、全局 batch 二十四。推理二十步、CFG 为五。对照为 MotionCtrl、Perception-as-Control、SymphoMotion、VerseCrafter,各用官方权重;评测一百段训练外片段,把同一段恢复运动转成各方法需要的二维轨迹、点或高斯。
- 指标分四组:FID、FVD 与 VBench-I2V 八维看画质;CLIP-SIM 看文图对齐;按 CameraCtrl 协议用恢复管线重估生成视频的旋转误差与相对平移误差;物体控制用 Identity-Gated IoU:在物体可见区间均匀取十六帧,Qwen3-VL 判断身份是否仍是同一物体,通过才计入掩码 IoU,失败帧记零但仍留在分母。二十名被试对九个案例按画质、控制精度、一致性打一到五分。
关键结果与论文证据
- 表1上 4Director 全指标最优。相对次优的 SymphoMotion,FID 从 45.8 降到 44.1,FVD 从 405.4 降到 370.4;旋转误差从 3.89 度降到 3.65 度,平移误差再降约百分之七点六。物体控制差距最大:IG-IoU 从 VerseCrafter 的 54.8 升到 60.4,识别率几乎并列(94.9 对 94.8),说明赢在放置与朝向而不是更常被认出。MotionCtrl 识别率只有 32.6,IG-IoU 掉到 18.8(页7–8)。
- 图5两段都是物体转身加相机运动。鸭子一例里 Perception-as-Control 与 VerseCrafter 几乎不转头,MotionCtrl 与 SymphoMotion 只转一点;拖拉机一例里后两者只转到一半,前两者丢主体或发糊。只有 4Director 转到与源视频相当的朝向,并能让拖拉机从篱笆后穿过。出画再入画时,网格在视野外就不渲染、回来仍是同一件网格;对照方法要么骆驼一直赖在画面里,要么回来后形状崩掉(页8–9)。
- 用户研究里三项均值都在 4.6 到 4.8,次优最高约 3.9,控制精度 4.82 对 2.39。消融去掉表面或去掉旋转,IG-IoU 分别掉到 50.3 与 53.0,识别率仍在 91.9 到 95.0,损失主要在放置。二维框既无深度也无朝向,IG-IoU 最低 48.5;摩托示例里只有刚性完整网格跟着规定转身,不旋转的网格会正对相机(页9–10)。
阅读时需要注意
- 表示只在刚体层级控制运动。关节或变形物体被当成一个整体,跑步、跳跃、肢体摆动无法由用户规定,只能交给生成器,附录甚至给出霹雳舞手倒立被平移后整段保持首帧姿势的失败例。
- 完整网格依赖单图重建质量;遮挡严重或细长结构可能几何不准,后续深度控制会把错误轮廓锁进视频。
- 训练绑定 832×480 与八十一帧,适配器全参数可训练,算力门槛不低;更长镜头与多物体复杂交互仍待扩展。
关联工作
- 相机控制一条线用 Plücker 射线或对极注意力只管视点不管新视野里该有什么;另一条线沿目标路径渲染抬升几何,但可见外壳补不出转身背面。4Director 用完整网格让新看见的那一面先被渲染再交给生成器补外观。
- 物体控制从拖拽路径、二维框到 6-DoF 位姿和三维框,近邻方法 Perception-as-Control、SymphoMotion、Diffusion as Shader、VerseCrafter 都把代理从源图抬起来再渲染。作者强调代理缺表面或缺朝向时,转身必然失败。
- VerseCrafter 同样把世界模型说成服从可编辑场景状态的生成器;4Director 把可编辑状态从高斯斑升级成完整刚性网格加统一坐标系。