快速导读:对公开脑瘤MRI分类基准做三层污染审计,发现去重几乎不改分数,无解剖文件头即可接近肿瘤/无肿瘤分类,榜上高分尚不能当作肿瘤识别证据。
公开脑瘤MRI分类是医学影像深度学习里发文极密的任务,Kaggle 镜像上报超过百分之九十八准确率已成常态。作者指出,这些数字几乎都钉在官方训练/测试划分上,却没有人系统测量测试是否在图像、患者和采集来源三个层面独立于训练。分数虚高和数据集污染不是一回事:泄漏会不会抬分,取决于模型有没有把单张训练图记住;一个充满捷径的基准可以稳住排行榜,却仍无法证明任何一分来自肿瘤外观。
Scores That Hold, Benchmarks That Leak(arXiv:2610.00421,密苏里大学电气工程与计算机科学系等)对 Nickparvar、SARTAJ、Navoneel 三套公开脑MRI语料做三层污染审计,并以 Kermany 儿科胸片为负对照。本文是评测完整性研究,属非临床产品,不提供诊断或分诊功能,结果不得外推为临床可用。预印本见https://arxiv.org/abs/2610.00421
英文题目:Scores That Hold, Benchmarks That Leak: Measuring Dataset Contamination in Public Brain-Tumor MRI Classification
论文出处:arXiv 每日论文精选 · arXiv:2610.00421
原始论文:PDF / 论文页面
这篇论文解决什么问题?
C1(Nickparvar)含 7023 张 T1,四类为 glioma、meningioma、pituitary 与 notumor,官方划分 5600/1600,文档写明由 Cheng 的 figshare、SARTAJ 与 Br35H 拼成。C2 本是 C1 的组成之一,却常被当成“第二个数据集”;C3 仅 253 张,常被用作所谓外部验证。作者一开始想做跨数据集泛化,一对是否不相交的检查就发现:C2 的大部分物理上就在 C1 里面。
现有评价几乎只报官方划分准确率。感知哈希在这类近姿态灰度扫描上会把真正干净的胸片对照标出百分之九十三“泄漏”,所以不能当默认去重器。作者要的是与分类器无关的测量:重复层、患者层、来源层各用一种原语,再用受控再评问污染在分数里值多少。
关键主张不是某篇论文造假。污染是数据集属性,不专门测就看不见,谁用官方划分都会继承。因此完整性必须直接量,而不能从“去重后分数没掉”反推基准是好的。
核心创新
- 把医学影像基准污染拆成重复、患者、来源三层,各用与分类器无关的原语直接测量,而不是从排行榜反推。
- 用胸片负对照校准重复检测,并证明廉价的无解剖文件头探针就能暴露来源—标签混杂。
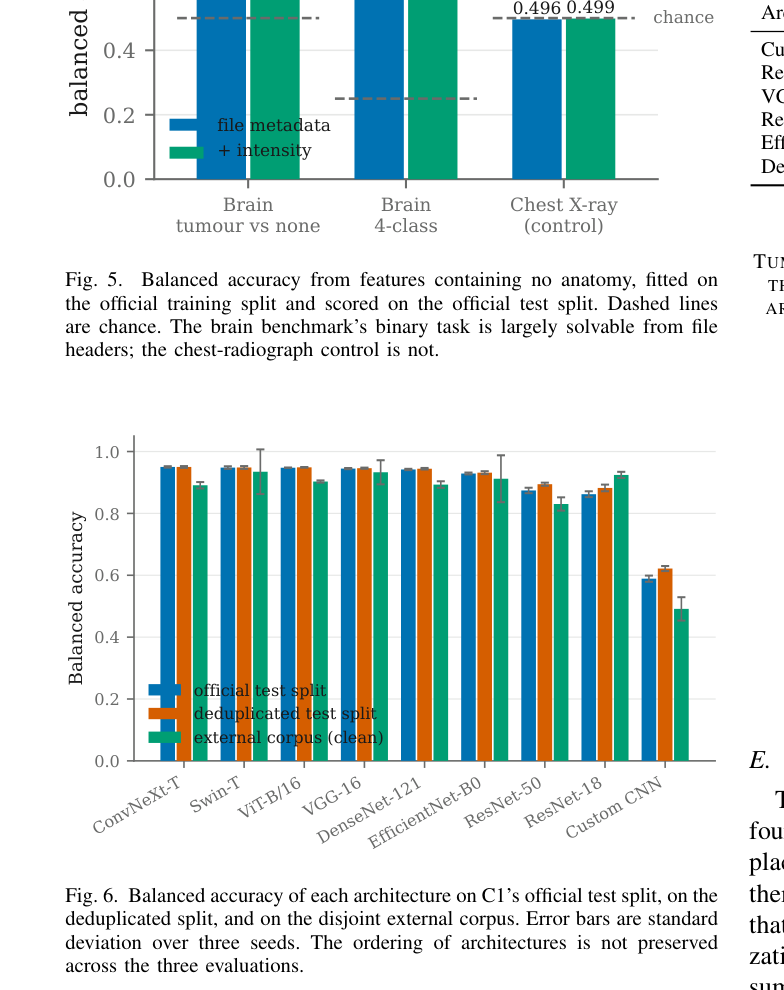
- 用九架构、三评价条件量化去重敏感度,表明严重污染可以与稳定分数并存,去重修数却修不好基准。
方法概览
提出按可见性排序的三层污染模型:L1 重复泄漏、L2 患者泄漏、L3 来源—标签混杂。重复层把图缩到 64×64 灰度、去均值并单位化,用零均值归一化互相关 ρ,在 τ=0.98 判近重复,并报告 0.90–0.995 全扫描与 MD5 下界;感知哈希在干净胸片对照上会误报百分之九十三,故弃用。患者层把 Kaggle 图按同一相关准则匹配回 figshare 的 cjdata.PID。来源层用梯度提升树只读像素尺寸、宽高比、文件大小、每像素字节、图像模式和 JPEG 量化表。再评协议在 C1 官方训练上训九种骨干(手写 CNN、ResNet-18/50、VGG-16、EfficientNet-B0、DenseNet-121、ConvNeXt-T、ViT-B/16、Swin-T),12 epoch、AdamW、单周期、三类种子共 52 次运行,并在官方测试、去掉 460 张泄漏图的去重测试、以及去掉与 C1 重叠后的干净 C2 上打分。
- 重复层把每张图缩到 64×64 灰度、去均值并除以 L2 范数,穷举内积得到 ρ。τ=0.98 为操作点,并给出 0.90 到 0.995 的全扫描;计数从 0.98 到 0.995 几乎走平,说明抓到的是真重复而不是阈值幻觉。MD5 字节相同作为不可争议下界。跨语料用同一准则测包含关系。
- 患者层针对 Kaggle 镜像不带 PID 的问题:用同一相关准则把切片匹配回 figshare 的 cjdata.PID。figshare 数组是列主序,不转置会匹配数为零,作者把它标成可复现的静默失败。λ(2) 定义为可追溯测试图中与训练共享患者的比例,因 SARTAJ/Br35H 无标识,这是条件估计。
- 来源层故意不看解剖。梯度提升树只读像素尺寸、宽高比、文件大小、每像素字节、图像模式和 JPEG 量化表,可选加全局强度统计。后续网络只看缩放到 224×224 的解码像素,从不读这些头,因此探针量的是来源与标签能有多混杂,而不是网络作弊通道本身。
- 再评在 C1 官方训练上 stratified 留出百分之十五验证,九种骨干覆盖手写 CNN 到 ViT/Swin,12 epoch、AdamW、单周期、类别加权交叉熵,三类种子共 52 次运行。每个模型打三个条件:Eoff 官方 1600;Ededup 去掉 460 张重复层图;Eext 去掉与 C1 重叠后的干净 C2。Δ=bacc(Eoff)−bacc(Ededup)。全部数字从存盘的逐例 logits 程序化生成。
逐图理解论文
三层污染
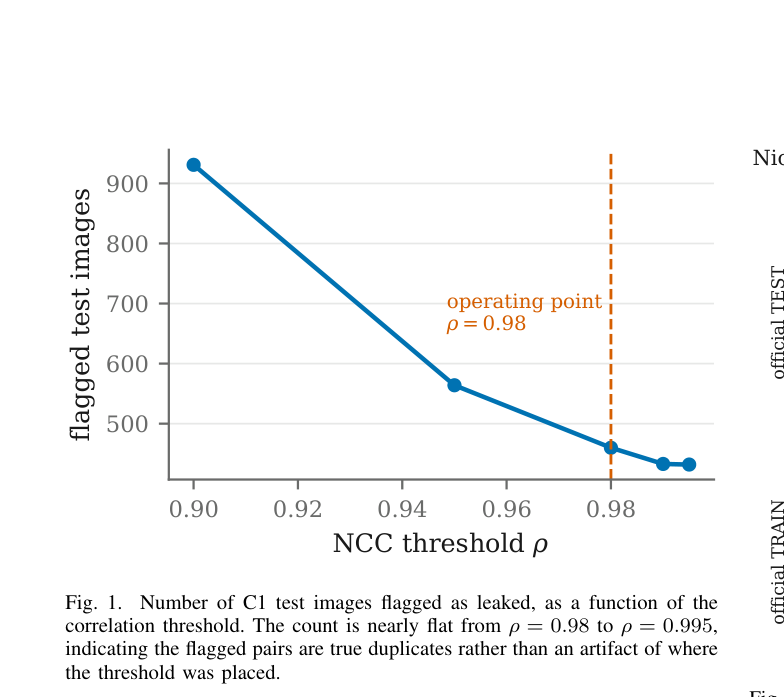
图1是 C1 被标为泄漏的测试图数量随 NCC 阈值 ρ 的变化,宜作方法图。纵轴 flagged test images,横轴 0.90–1.0。蓝线从约 0.90 的九百余张降到 0.95 附近约五百七十,在橙色虚线 operating point ρ=0.98 处落到约四百六十,之后到 0.99–0.995 几乎走平。平台说明抓住的是真重复。裁切右侧带有邻图 Fig.2 的 official TEST/TRAIN 残字,读图时忽略。
重复与患者
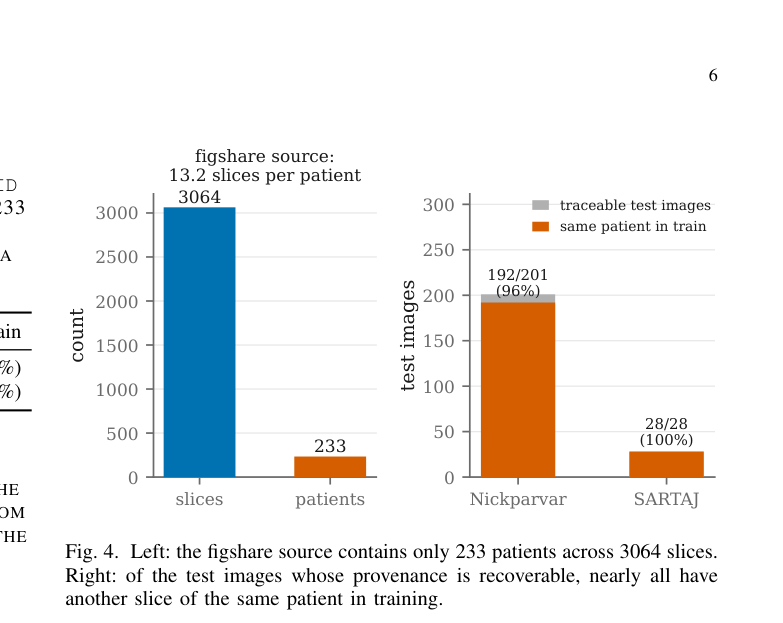
图4左柱:figshare 源 3064 切片对 233 患者,标注 13.2 slices per patient。右柱:可追溯测试中 Nickparvar 192/201(96%,灰帽为全部可追溯、橙为与训练同患者),SARTAJ 28/28(100%)。说明按图随机划分几乎不可能患者不相交。左侧残留表文字,读图时忽略。
文件头捷径
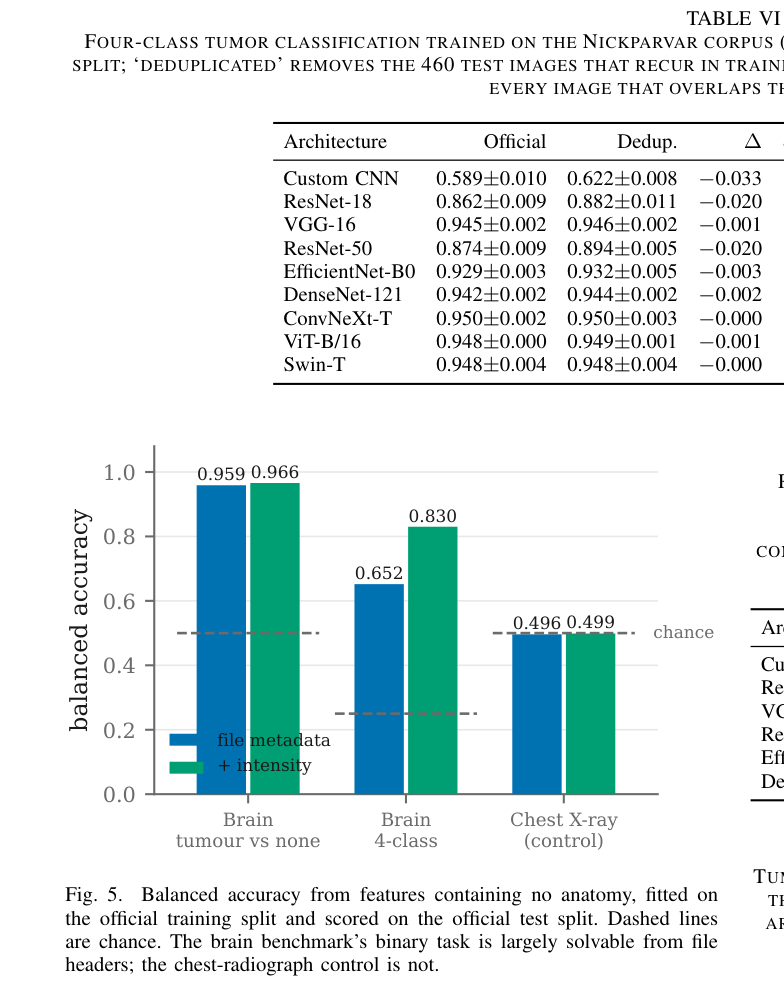
图5是无解剖特征探针的平衡准确率,宜作特色图。三组柱:Brain tumour vs none 蓝 0.959 / 绿 0.966;Brain 4-class 0.652 / 0.830;Chest X-ray 对照 0.496 / 0.499,虚线为随机。蓝为 file metadata,绿为加 intensity。脑MRI二分类几乎可被文件头解开,胸片官方测试则不能。本裁切上方带入 Table VI 的官方/去重分数,属邻表文字,不是本图内容。
去重不改分
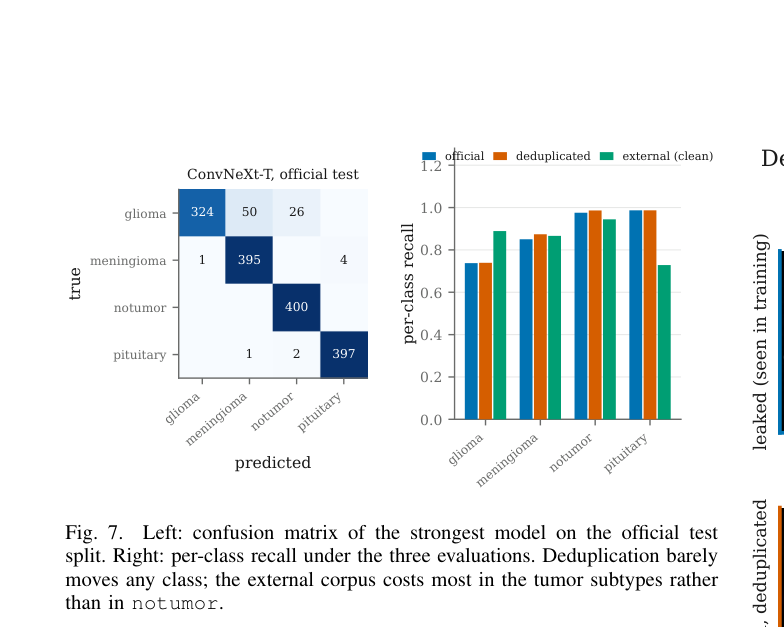
图7左为最强模型 ConvNeXt-T 在官方测试上的混淆矩阵:glioma 行 324/50/26,meningioma 1/395/4,notumor 400 全对,pituitary 1/2/397。右为三类评价的逐类召回:蓝官方、橙去重、绿干净外部。去重几乎不移动任何类;外部主要掉肿瘤亚型而不是 notumor。右侧残留 Grad-CAM 图注,读图时忽略。这些MRI只用于说明评测污染,不是临床病例。
实验如何设计?
- 污染流行率:官方划分内 λ(1)、MD5 下界、语料两两包含,对照胸片零重复。患者层报告可追溯子集的 λ(2) 与按类匹配(notumor 必须为零,因为它来自 Br35H)。
- 文件头探针在 C1 官方测试上打肿瘤/无肿瘤与四类,并在胸片对照的官方测试与训练内五折上对照。再评报告四类平衡准确率、Δ、域内/域外 ECE,以及四类头投影到二分类后与文件头基线并排。
- 机制上,Grad-CAM 与 SHAP 把脑掩膜外的绝对归因质量当作“非解剖证据”代理;另用 BiomedCLIP 与 CLIP ViT-B/16 试图做泄漏免疫的差分,但两对照符号相反,作者当作识别失败而不是挑选有利对照。
关键结果与论文证据
- C1 有 28.8% 官方测试图在训练里有 ρ≥0.98 的近孪生;C2 有 22.3% 测试图字节相同、65.7% 近重复。胸片对照两项都是 0.0%。跨库上,C2 的 82.9% 在 C1 里(81.8% 字节相同),C3 的 48.6% 在 C1 里。在 C1 或 C2 的官方划分上训练再测试,等于大量分数打在模型已经见过的图上(页5,Table I–II)。
- figshare 源只有 233 名患者、3064 切片,人均 13.2 张,随机按图划分几乎不可能患者不相交。可追溯测试中,C1 的 192/201(95.5%)、C2 的 28/28(100%)与训练共享患者。notumor 零匹配,说明匹配器没有乱配(页6,Fig.4,Table III–IV)。
- 无解剖文件头把肿瘤/无肿瘤做到 0.959,加强度到 0.966;四类为 0.652/0.830。同一探针在胸片官方测试上约 0.50,但在其训练池内五折可到 0.992:捷径两边都有,只是 C1 的捷径能转移到官方测试(页7,Fig.5)。
- 意外结果:去掉全部泄漏测试图后,九架构 Δ 均值是 -0.009,分数还略升;ConvNeXt-T 官方与去重都是 0.950,强模型变化小于 0.003。迁到干净外部平均掉 0.030,架构排序也不保。二分类上最强网络 0.989,文件头 0.959,已与微调 ResNet-18/50 持平。泄漏图与干净图的脑外归因几乎一样(约百分之二十八到二十九),说明驱动分数的是采集签名而不是逐图记忆(页7–8,Table VI、VIII,Fig.7)。
阅读时需要注意
- 这属非临床产品,也不是脑瘤诊断模型。公开基准上的高分不能外推为临床可用,也不能替代患者级独立验证、前瞻试验或监管评价。
- 患者泄漏只在可追溯子集上成立,是污染下界;SARTAJ 与 Br35H 无 PID。重复检测不覆盖相邻切片。固定训练预算不能代表每篇已发表论文的搜参结果。
- 作者明确不重评单篇文献,只审计它们共用的评价底板;去重划分也不是修好的新基准。零样本差分对照因符号相反而未采用。
关联工作
- CIFAR 近重复大约百分之三点三且去重会重排模型;这里污染大一个数量级,去重却几乎不动分,标准修补因此什么也证明不了。
- COVID 影像综述与医疗算法审计强调泄漏和重组公开集;Zech、DeGrave 等说明分类器会键入医院采集签名。文件头探针把“有没有解剖信号”变成审稿人可要求的基线。
- 作者建议把重复扫描、语料独立性核验、文件头基线、平衡准确率与校准、以及精确文件清单写进 CLAIM 与 TRIPOD+AI 一类清单,并认为在这套数据上文件头基线比单纯去重更有诊断力。