快速导读:Artemis 从多智能体观测重建共享三维地图,把分解后的几何控制图注入视频扩散模型,并渐进更新记忆以生成视角一致的未来驾驶视频。
多智能体驾驶不只是各拍各的未来视频:同一路口、同一辆对向车,必须在所有视角里对得上。现有多人视频世界模型多用交叉注意力做隐式通信,缺少统一三维状态,跨视角容易漂,出视野的车辆也难再找回。Artemis(arXiv:2610.07031,剑桥、牛津、特温特、新加坡国立与巴斯大学)主张先从多智能体观测重建共享三维地图,再把分解后的几何控制图注入扩散 Transformer,并在 rollout 中渐进更新记忆。项目页为 https://liujiuming123.github.io/Artemis/ 。
作者为此采集 MA-CARLA:11,283 条 CARLA 同步序列,覆盖对向、同向与转弯穿越等交互。主表上 Artemis 的 PSNR 为 17.743、SSIM 为 0.566、LPIPS 为 0.309,高于微调后的 Solaris(16.015 / 0.522 / 0.414)。方法还能同时维护二维视频与三维点图、扩展到两个以上智能体,并在单相机与四视图之间切换。预印本尚未同行评审。
英文题目:Artemis: Geometry-Grounded Multi-Agent Driving World Models with Shared 3D State and Progressive Memory Update
论文出处:arXiv 每日论文精选 · arXiv:2610.07031
原始论文:PDF / 论文页面
这篇论文解决什么问题?
真实交通是多方同时行动的。单智能体世界模型看不到对向来车如何进入自己的画面,也难以保证后视与前视描述同一几何。要把世界模型做成可交互的驾驶仿真,需要跨智能体共享同一份演变中的三维状态。
Solaris 引入共享自注意力,MultiWorld 用动作重加权与 VGGT 先验,Prisma-World 把相对位姿写入 DiT,但关联仍偏隐式。缺少显式几何时,长时程预测会出现结构错位;历史帧若不能跨智能体复用,重访同一地点也会丢记忆。多数方法还默认背景静止,行人与骑行者这类非可控动态被忽略。评测又常落在简化游戏场景,遮挡、出视野与复杂天气都不够。
核心创新
- 用显式共享三维点云地图约束多智能体生成,替代仅靠隐式交叉注意力的关联。
- GeoAdapter 注入分解后的前景-背景控制图,并用历史缓冲给非可控动态提供运动线索。
- 混合几何-位姿记忆:关键帧渐进更新世界地图,相对位姿可见性检测可初始化突然入画的车辆。
方法概览
作者在 CARLA 上构建 MA-CARLA:11,283 条同步序列来自 2,478 条轨迹、八座城镇与 17 种天气,含双智能体静态 6,020、双智能体动态 3,382、三智能体静态 1,881。每车四路相机(前、前左、前右、后)800×600,每序列 256 帧。预处理用 LingBot-Map 估计深度、内参与位姿,Grounded-SAM2 分割可控与非可控动态,渲染 24 通道控制张量。推理时先把各智能体首帧子图配准成共享静态地图 P0;动作给出局部 SE(3) 变换后插值轨迹,分别渲染静态背景 RGB/深度、可控高斯代理 RGB/深度、非可控历史 RGB/深度与年龄掩码。GeoAdapter 把这些控制经 VAE 编码后残差注入 Wan2.2 5B 的选定层,另加跨智能体交叉注意力。每个推理块后选低重叠关键帧更新静态地图,非可控缓冲按 FIFO 更新,位姿记忆在目标即将入画时初始化保守车形高斯。训练分三阶段:双向几何教师、Diffusion-Forcing 因果学生、Self-Forcing 蒸馏。
- 数据方面,MA-CARLA 在 CARLA 中按规则模板生成对向、跟随与超车轨迹,通过碰撞、间距、可见性与运动平滑筛选后,在不同天气下重放并保持同步。数据集含 2,478 条独特轨迹、八座城镇、17 种天气;双智能体静态 6,020、动态 3,382、三智能体静态 1,881。每序列 256 个同步时刻,每车四路 800×600 相机。图2环形图按 17,790 次组分配计:同向 40.3%、转弯与穿越 35.6%、对向 24.1%,外环再按 2/3 智能体划分。
- 预处理用 LingBot-Map 在一致局部坐标系里估计稠密深度、内参与位姿,供点云提升、代理拟合与控制渲染共用,以保持非米制尺度自洽。Grounded-SAM2 结合 CARLA 元数据区分可控智能体与非可控演员,二者都不进入静态地图融合。可控目标拟合成全协方差三维高斯代理;非可控目标存成带时间戳的观测,而不是指定未来轨迹。
- 图4给出总流程。各智能体首帧重建子图,按相对位姿并成全局静态地图 P0,天空与低置信几何一并剔除。动作是相对当前相机到世界位姿的 SE(3) 增量,平移线性插值、旋转在 SO(3) 上插值,得到块内 K 个中间位姿。对每个未来位姿分别渲染:静态背景退化 RGB/深度与空洞掩码,可控代理 RGB/深度与前景掩码,以及由历史三维缓冲重投影得到的非可控 RGB/深度与年龄覆盖图。合成掩码标出需要生成的新暴露区域与动态前景。多相机时再提供与 token 对齐的射线图。
- GeoAdapter 把 RGB、深度与年龄控制经 VAE 编码,可见性掩码最近邻下采样,再残差注入选定 DiT 层;显式几何决定代理应出现的位置,预训练 Wan2.2 5B 负责外观。潜空间另有跨智能体交叉注意力。生成后,选出揭示未见区域或与历史重叠低的关键帧,用 LingBot-Map 重建子图并入静态地图;非可控缓冲先进先出;若当前帧没有代理但规划位姿显示目标将进入视野,则用位姿记忆初始化保守车形高斯。干净潜变量还写入每智能体 KV-Cache,供在线自回归使用。
逐图理解论文
MA-CARLA
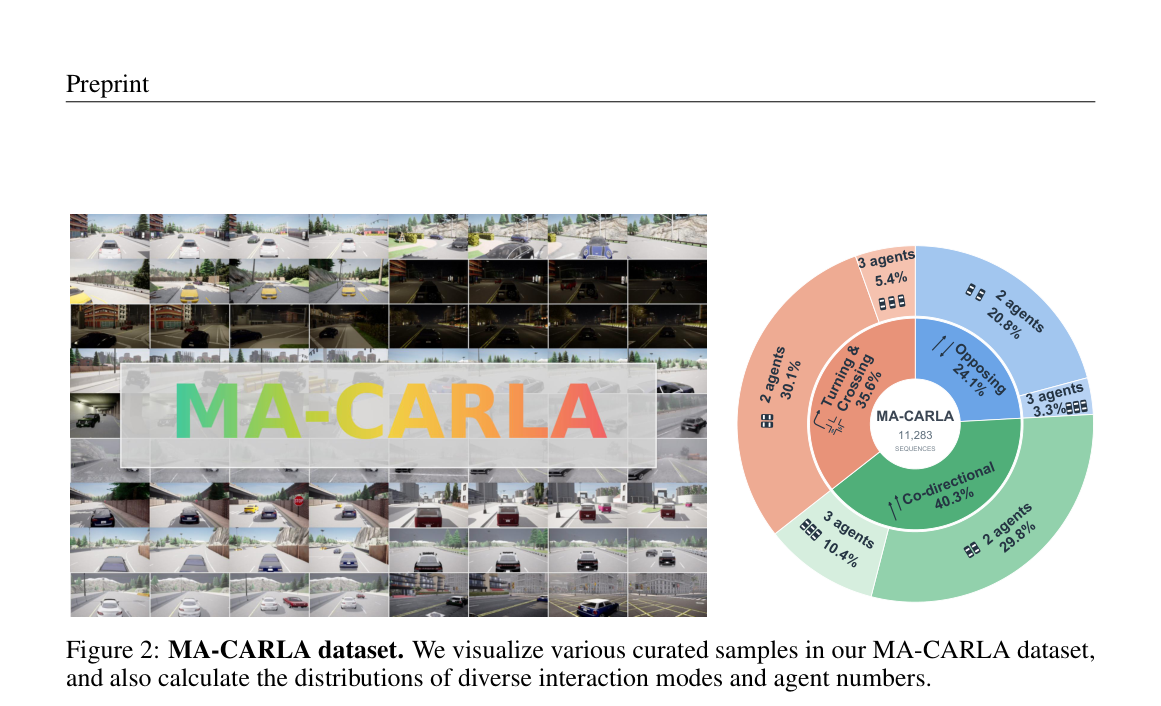
图2左侧是 MA-CARLA 样本拼贴,覆盖白天、夜晚、雨雾、隧道与城市街道,中央半透明标题写 MA-CARLA。右侧双环图中心为 11,283 SEQUENCES。内环三类运动:绿色 Co-directional 40.3%(外环 2 agents 29.8%、3 agents 10.4%),蓝色 Opposing 24.1%(20.8% / 3.3%),橙色 Turning & Crossing 35.6%(2 agents 30.1%、3 agents 5.4%)。百分母是 17,790 次组分配,一组场景可落入多类。顶部有 Preprint 页眉,来自页面裁切。
几何注入
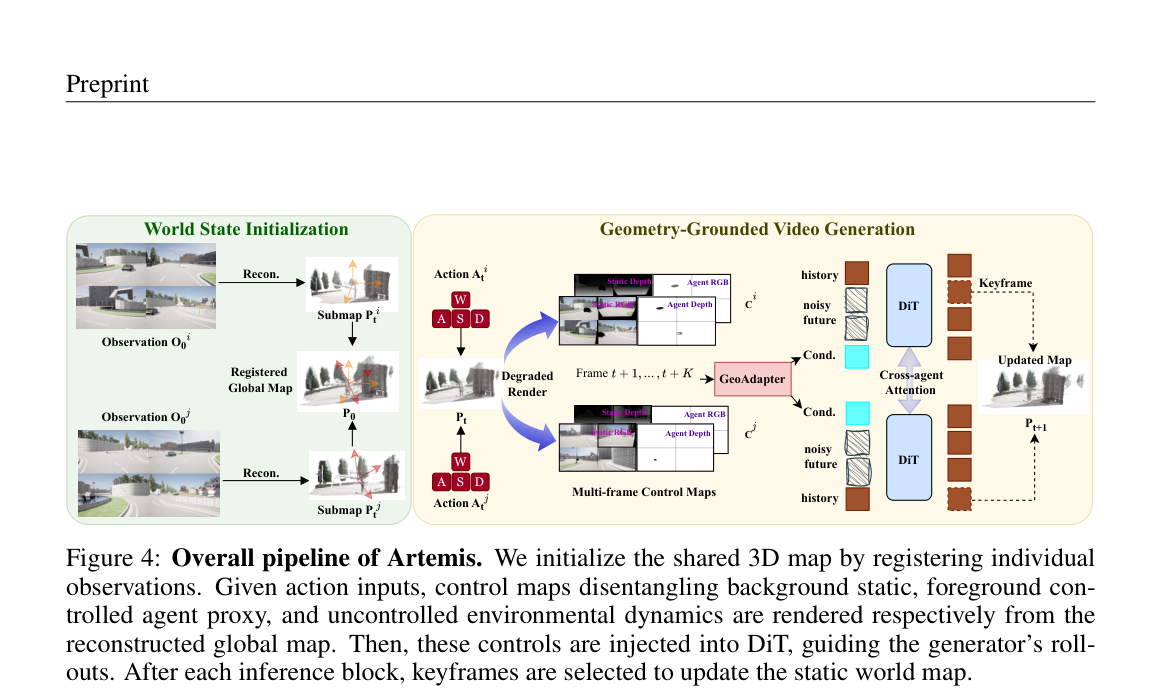
图4是方法总览。左栏 World State Initialization:Observation O0^i 与 O0^j 经 Recon. 得到 Submap P_t^i、P_t^j,配准成 Registered Global Map P0。中栏 Geometry-Grounded Video Generation:各智能体 Action 经 A/S/D 与当前地图做 Degraded Render,得到 Multi-frame Control Maps,格子标注 Static Depth、Static RGB、Agent RGB、Agent Depth。控制经 GeoAdapter 与棕色 history、斜线 noisy future 一起进入蓝色 DiT,经 Cross-agent Attention 同步,输出关键帧后更新地图到 P_{t+1}。顶部有 Preprint 页眉。
关键证据
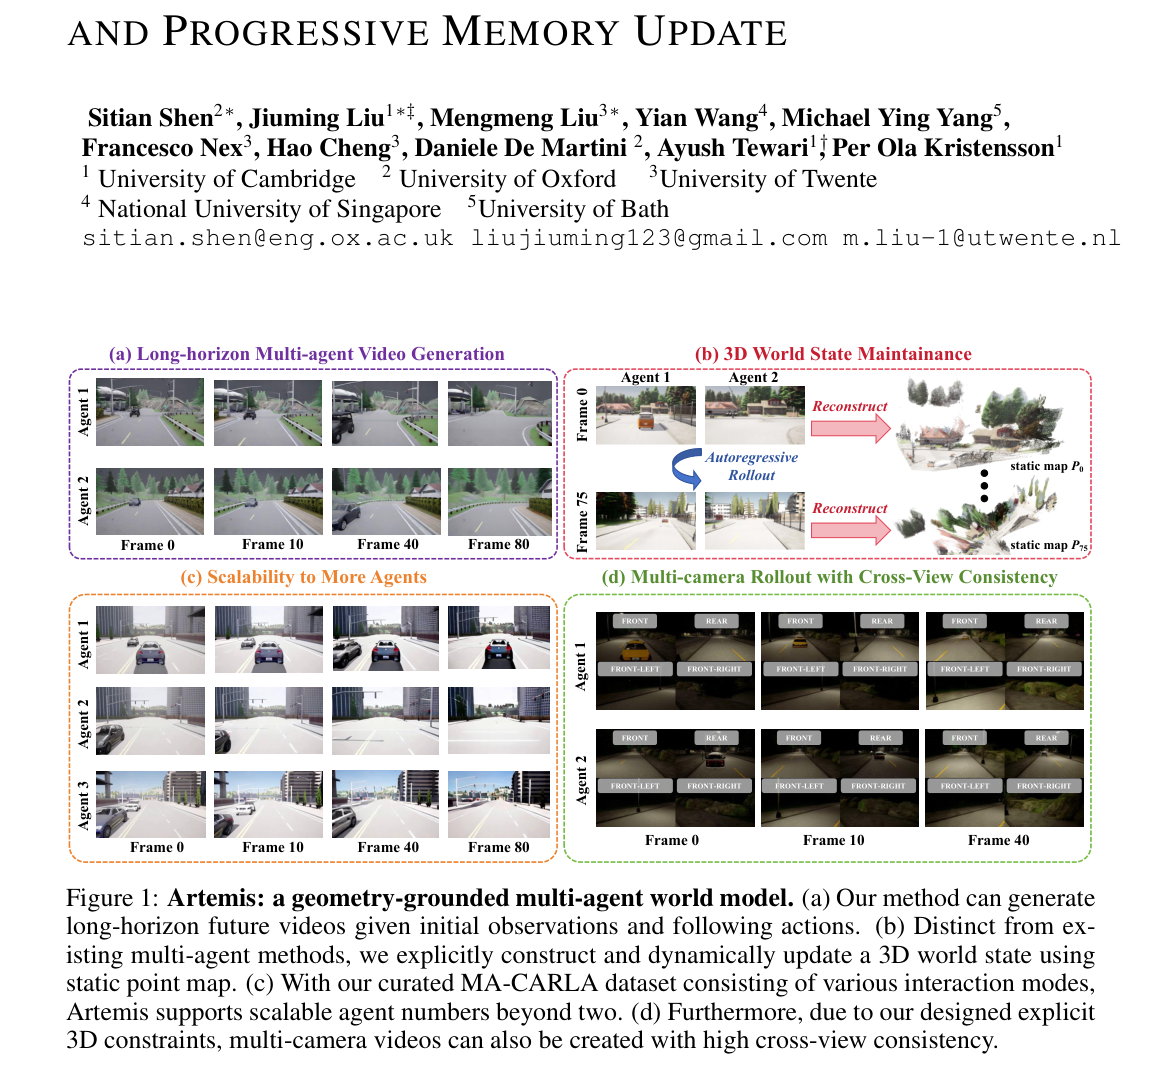
图1是首页总览,宜作特色图。裁切含标题残留 AND PROGRESSIVE MEMORY UPDATE 与作者单位,讲图时忽略。(a) Long-horizon Multi-agent Video Generation:Agent 1、Agent 2 两行,Frame 0/10/40/80,对向车辆随动作沿道路接近。(b) 3D World State Maintainance:Frame 0 的 Agent 1/2 经 Reconstruct 得到 static map P0,Autoregressive Rollout 后 Frame 75 再重建 static map P75,点云逐渐补全路边树木与建筑。(c) Scalability to More Agents:三行 Agent 1–3,同样四帧,第三辆车进入视野。(d) Multi-camera Rollout:每位智能体在 Frame 0/10/40 给出 FRONT、REAR、FRONT-LEFT、FRONT-RIGHT 四宫格,夜间路灯下跨相机仍能看到同一对向车灯。
实验如何设计?
- 骨干为 Wan2.2-TI2V-5B。三阶段训练针对多智能体在线 rollout:Stage 1 在成对 CARLA 视频与 15 通道几何控制上训练双向教师,AdamW 初学习率 4×10⁻⁵,200 warmup,余弦衰减,32 块 H20;Stage 2 改为 Diffusion-Forcing 因果掩码,学习率 2×10⁻⁵、400 warmup。两阶段都用 81 帧、256×416、flow matching、1000 训练步、flow shift 5.0。在线推理按块生成 81 帧,5 帧去噪块、33 帧历史窗、50 步 Euler、guidance 1.0。Stage 3 用 DMD 风格蒸馏把去噪收到 2 步。
- 对照为 OASIS 式通道拼接、原始 Solaris 与在 MA-CARLA 上微调的 Solaris。外观指标是生成视频相对真值的 PSNR、SSIM、LPIPS;一致性用 DA3 估计深度、内参与位姿后计算 Subject/Background Consistency,并报告 Aesthetic 与 Imaging Quality。附录 Table 4:静态单相机 4,816 / 602 / 602,四视图 4,813 / 600 / 601,动态背景 2,706 / 338 / 338。三智能体池不计入该主表。多相机实验使用相机流完整的静态场景。
关键结果与论文证据
- Table 1 中 Artemis 全面高于 OASIS 与未微调 Solaris,并在多数外观指标上超过微调 Solaris:PSNR 17.743 对 16.015,SSIM 0.566 对 0.522,LPIPS 0.309 对 0.414,Subject Consistency 0.902 对 0.896,Aesthetic 0.536 对 0.502。微调 Solaris 的 Background Consistency 为 0.953、Imaging Quality 为 0.581,略高于本文的 0.949 与 0.568,文中不宜写成七项全胜。图6里 OASIS 未来几乎全糊,Solaris 约 10 帧后出现伪影,Artemis 在 Frame 40 与 80 仍能保持车道与对向车辆结构。
- 图8展示四视图(FRONT、FRONT-LEFT、FRONT-RIGHT、REAR)与三智能体 rollout:显式三维状态使跨相机内容保持对应。图7中两名非刚性骑行者的运动被历史缓冲约束,而不是被当成静止背景。图5对照有无位姿记忆:没有记忆时,暂时出画的车辆在后续帧难以正确再现。
- Table 2:去掉代理 RGB 后 PSNR 降至 17.3938、SSIM 0.5555;去掉代理深度为 17.5823 / 0.5613;去掉 ray-map 为 17.5284 / 0.5601。截断 KV-Cache 后 Subject Consistency 从 0.9021 降到 0.8926。关闭静态地图更新时 PSNR 与完整模型同为 17.7429,但 Subject/Background Consistency 略降,说明在线更新对长时程外观稳定性更敏感。身份匹配在三智能体时用投影轨迹、代理跟踪、深度一致性与图像距离完成。
阅读时需要注意
- 主实验在 CARLA 渲染数据上,物理合理不等于真实传感器噪声、标定误差与长尾交通。三智能体定量池与 Table 4 划分分开,可扩展性目前以定性为主。
- 共享地图依赖 LingBot-Map 的局部尺度,动作、代理尺寸与新帧重建都要先变到该参考系;文中没有独立的绝对米制评测。闭源多智能体模型未进入对照,结论相对于 Solaris/OASIS 更稳妥。
- 训练分辨率 256×416,控制图是退化渲染而非照片级几何。预印本未同行评审。项目与演示见 https://liujiuming123.github.io/Artemis/ 。
关联工作
- 交互式视频世界模型从 Genie、Wan 系列扩散骨干发展而来,重点逐渐转到长时程记忆与实时 rollout,但多数仍是单智能体。MultiVerse 直接拼接各玩家视频与动作 token;Solaris 加共享自注意力;Gamma-World 用等距旋转嵌入降低计算。
- 为加强视图一致,MultiWorld 引入 VGGT 三维先验,Prisma-World 注入相对相机位姿。Artemis 更进一步:维护可更新的显式点云地图,并把静态、可控代理与非可控历史分成控制通道。驾驶设定还要求处理遮挡、出视野与背景活动物体,这与 Minecraft 或双人游戏测试床不同。
- 几何条件视频生成把深度、点图或射线图写入 DiT 已有先例。Artemis 的差别是这些控制来自跨智能体配准的共享世界,并在每个推理块后用新关键帧回写,而不是一次性的位姿条件。