快速导读:STRIKE 把物理交互写成带时间的视觉状态转移,再把预测状态当作软条件驱动稠密视频生成。
物理世界建模真正难的不是画面连不连贯,而是交互有没有改写场景:夹爪有没有先咬住方块,杯子落地会不会碎,网球有没有把鸭子撞开。STRIKE(arXiv:2610.09514,Applied Intuition、南加州大学与加州大学伯克利分校)把这件事拆开:先学视觉状态转移,再把带时间戳的预测状态当作软条件,驱动稠密视频生成。项目页为 https://strike-applied.github.io/ 。
作者用 VLM 辅助标注从观测视频抽出事件对齐状态对,微调 Qwen-Image-Edit 作为共享转移模型;推理时预训练视觉语言规划器只看初始图与任务,给出局部事件和结果时刻,递归生成未来状态。动力学模型分别接在 CogVideoX-5B-I2V 与 Wan2.2-5B-TI2V 上。Physics-IQ Verified 上 CogVideoX 变体总分从骨干的 30.5 升到 41.9,PhyGenBench 平均 76.91,Pisa 落体 L2 降约 19.6%,RoboTwin2 val500 的 Wan 变体 EWMScore-15 到 62.53。预印本尚未同行评审。
英文题目:STRIKE: Learning Visual State Transitions for Physical World Modeling
论文出处:arXiv 每日论文精选 · arXiv:2610.09514
原始论文:PDF / 论文页面
这篇论文解决什么问题?
成功的抓取要先建立附着,举起才会改变支撑。作者把视觉状态定义为表达这类交互结果的场景配置图像,包括接触、支撑、附着等可观察关系。只保住物体外观不够:生成场景还必须建立起让交互在物理上成立的关系转移。直接图生视频常见的失败是方块还没接触就升起、附着来得太晚,或整段一起抬但中间关系是错的。
现有大规模视频模型提供了视觉世界建模骨干,物理感知条件、仿真后训练、关系对齐和潜运动先验则主要在视频级生成或控制上发力。关键帧与事件引导方法能给出稀疏锚点,但较少把“当前图像、一步交互说明、经过时间”做成可共享、可递归复用的转移接口。STRIKE 要问的是:显式学习状态转移,能不能改善交互结果及其后续物理后果的预测。
核心创新
- 把视觉状态转移写成事件与时间条件的显式学习任务,用 VLM 辅助管线从观测视频构造事件对齐监督。
- 用定时事件规划加共享转移模型递归预测未来状态,把状态与时刻作为软条件交给独立训练的视频动力学模型。
- 在 Physics-IQ Verified、PhyGenBench、Pisa-Experiments 与 RoboTwin2.0 上相对对应视频骨干提升物理一致性与操作视频保真度。
方法概览
STRIKE 拆成两段生成。标注时把训练视频做成带时间故事板:GPT-5.5 选状态帧并写相邻转移,Qwen3-VL 状态裁判核验图文一致,得到事件对齐对 (s−, u, Δτ, s+);状态图来自真实视频帧而非合成。转移模型用 Qwen-Image-Edit 微调,输入当前图、局部转移说明和相对时间(经 RoPE 时间坐标,无额外参数),目标图监督交互后的配置;训练加入首帧 sink 保持身份与几何。推理时预训练视觉语言规划器只看初始图与任务,预测局部事件 uk 与结果时刻 τk,共享转移模型按 Δτk 递归生成 ŝ1…ŝK。动力学模型在 CogVideoX-5B-I2V 与 Wan2.2-5B-TI2V 上扩展多状态条件:各预测状态经 VAE 成空间记忆 token,时间戳映射到视频时间格,作为软条件与噪声视频 token 联合去噪,整窗一起生成。
- 标注与规划共用同一套转移接口。训练视频先采样候选帧做成带时间故事板。第一轮 VLM(GPT-5.5)识别实体、可见事件与时间结构;第二轮选出信息量大的状态帧并描述相邻转移,优先接触、形变或落稳后的配置,而不是泛泛的开头、中间、结尾。Qwen3-VL 状态裁判检查图文是否一致。选中的状态图从训练视频抽取,不由标注器合成。相邻状态构成转移对 (s−, u, Δτ, s+),其中 u 写局部变化,Δτ 由时间轴帧差得到。
- 开域推理时,规划器只接收初始图 x0 与任务 c,联合预测局部事件 uk 和结果时刻 τk,看不到未来参照帧。规划转成转移模型指令后校验时间顺序与视界,计算 Δτk=τk−τk−1。相对间隔条件化状态预测,绝对时间戳把状态放到视频时间格上。VLM 组件不与两个生成器联合优化。
- 转移模型以 Qwen-Image-Edit 实例化,在 (s−, u, Δτ, s+) 上微调。相对时间通过图像 token 的 RoPE 时间坐标编码:源、目标分别放在时间位置 0 与 d,规划帧差按训练帧率换算,不增加可训练参数。源图保持未加噪,损失只加在目标;另加首帧 sink,把 x0 的潜变量当作持久视觉参照,减轻递归曝光偏差。推理时共享参数按 ŝk∼qϕ(ŝk | ŝk−1, ŝ0, uk, Δτk) 逐步展开。
- 动力学模型生成完整视频 X∼qθ(X | x0, c, {(ŝk, τk)})。各预测状态用视频骨干 VAE 编码并投影成空间记忆 token,τk 映射到骨干时间格。CogVideoX 走联合记忆/视频 token 流,Wan 把固定状态记忆插入各块自注意力并保留文本交叉注意力。状态是软条件而不是对应输出帧的硬约束,整段窗口联合去噪,让两状态之间的运动可以依赖更宽的结果序列。
逐图理解论文
失败模式
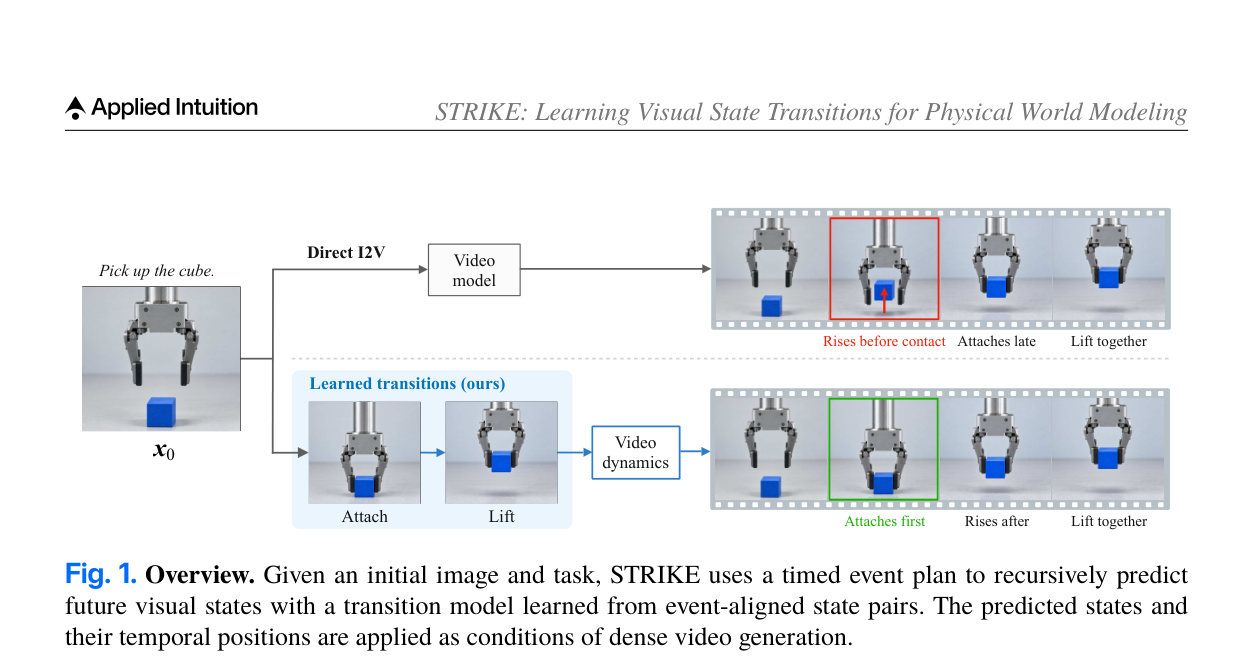
图1是方法直觉总览,宜作特色图。左侧初始图 x0:金属夹爪悬在蓝色方块上方,任务 Pick up the cube。上支 Direct I2V 经 Video model 得到四帧:方块未接触已升起(红框 Rises before contact)、附着偏晚、最后才 Lift together。下支 Learned transitions (ours) 先预测 Attach(夹爪闭合咬住方块)再 Lift,经 Video dynamics 得到绿框 Attaches first、Rises after、Lift together。页眉有 Applied Intuition 与论文标题。
标注与规划
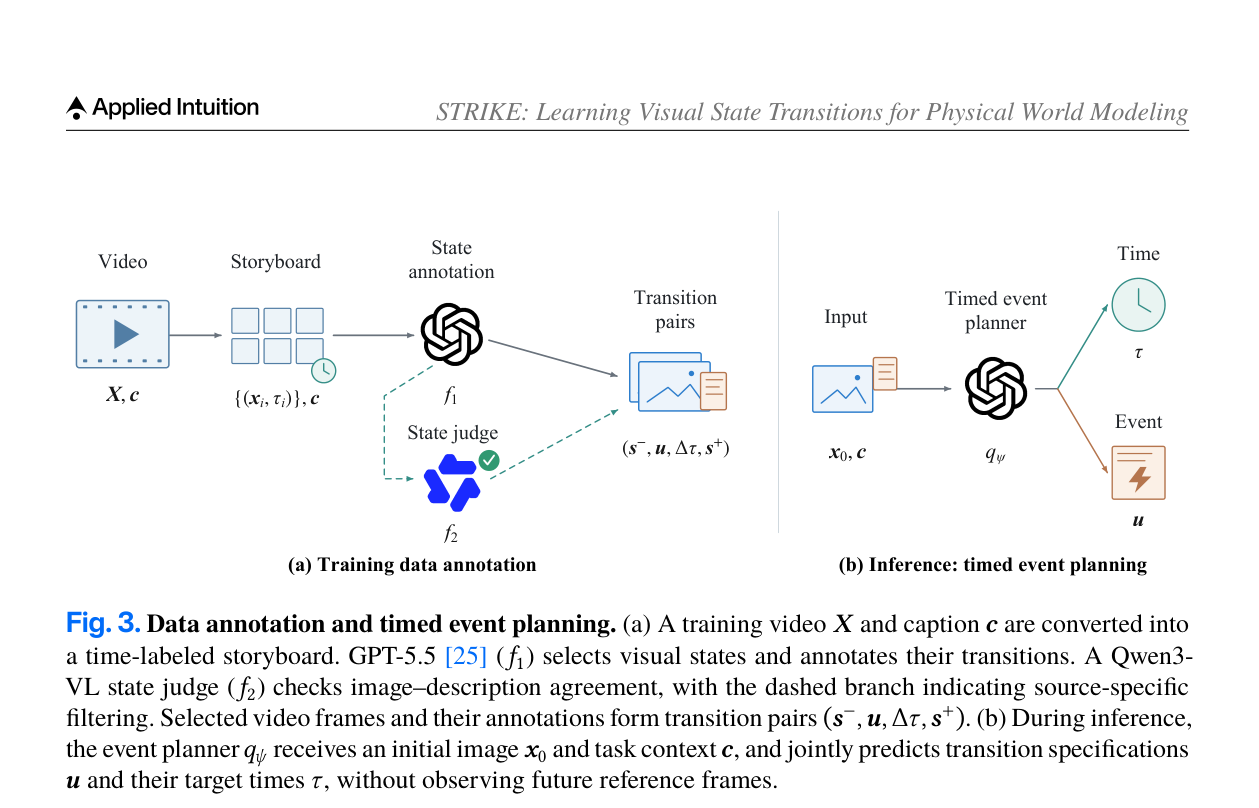
图3分训练标注与推理规划。(a) Training data annotation:Video X,c 做成 Storyboard {(xi, τi)},c,经 f1(GPT-5.5 花形图标)做 State annotation,虚线经 f2 Qwen3-VL State judge 打勾后得到 Transition pairs (s−, u, Δτ, s+)。(b) Inference: timed event planning:Input x0,c 进 Timed event planner qψ,分出 Time τ 与 Event u,强调看不到未来参照帧。
模型结构
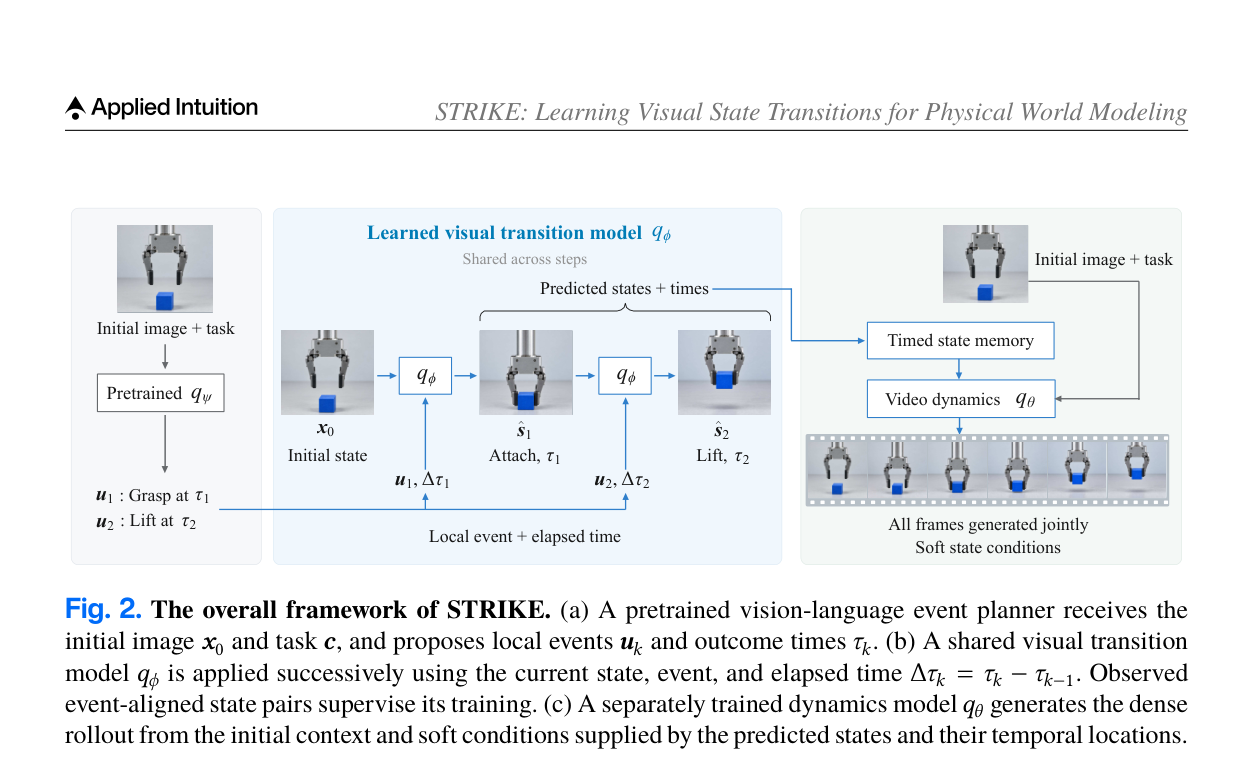
图2是 STRIKE 总框架三块。(a) 左栏 Initial image + task 进入 Pretrained qψ,输出 u1: Grasp at τ1、u2: Lift at τ2。(b) 中栏 Learned visual transition model qϕ Shared across steps:x0 → qϕ → ŝ1 Attach, τ1 → qϕ → ŝ2 Lift, τ2,下方标注 Local event + elapsed time。(c) 右栏 Predicted states + times 进入 Timed state memory,再与 Initial image + task 一起交给 Video dynamics qθ,胶片条写 All frames generated jointly、Soft state conditions。
关键证据
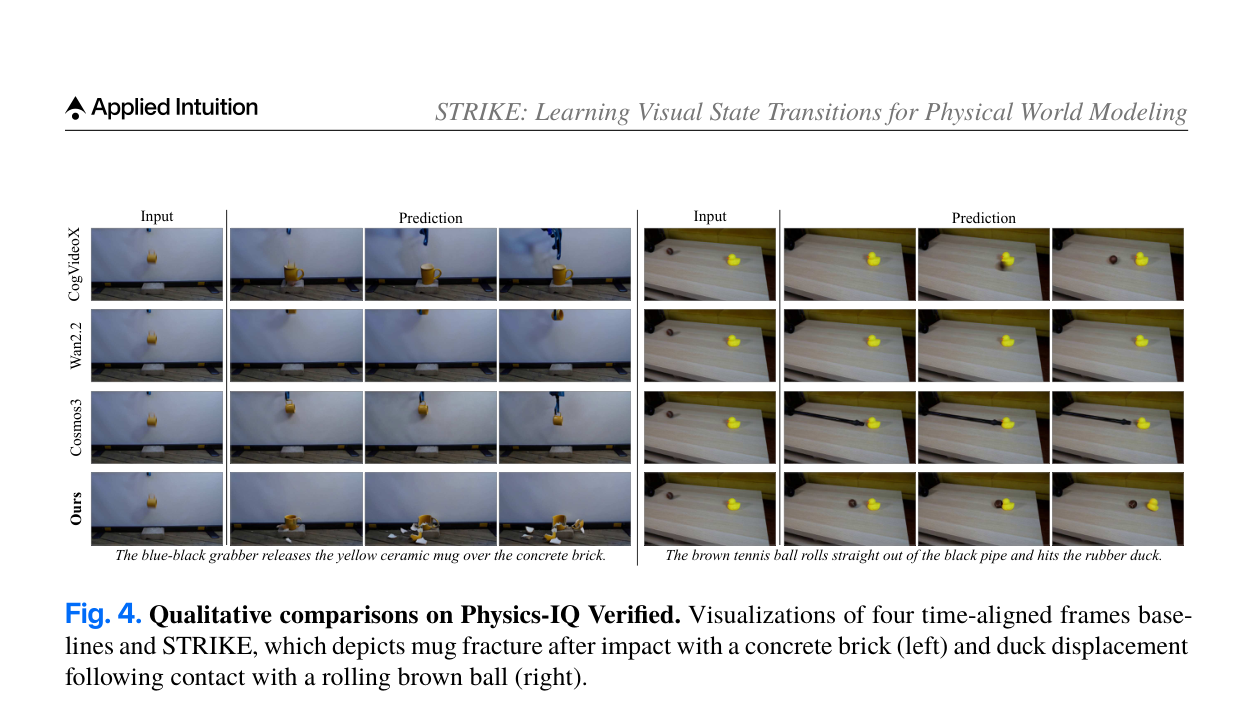
图4是 Physics-IQ Verified 定性对比。左列 Input 为夹爪悬着黄陶瓷杯对水泥砖;右列 Input 为木板上黄鸭子与黑管口棕网球。行顺序 CogVideoX、Wan2.2、Cosmos3、Ours。左例基线杯子完好或悬空,Ours 撞击后碎裂;右例基线球轨迹乱、管道变形或鸭子不动,Ours 球滚出、接触并推移鸭子。字幕分别为 The blue-black grabber releases the yellow ceramic mug over the concrete brick 与 The brown tennis ball rolls straight out of the black pipe and hits the rubber duck。
实验如何设计?
- Physics-IQ Verified 评重力、碰撞、流体、材料、光照、磁性等现象是否物理上合理。PhyGenBench 覆盖 27 条力学、光学、热学、材料常识,看关键事件、时间顺序与自然度。Pisa-Experiments 聚合 421 条真实与仿真落体视频,报告 L2、Chamfer Distance 与 IoU。RoboTwin2.0 用 episode/seed 分组的 val500:50 任务、五本体、500 条 held-out 随机化回合,指标为改编自 WorldArena 的 EWMScore-15。
- 对照包含 Wan2.2-14B、Cosmos-Predict-2.5、CogVideoX、Cosmos3、CoECT、CausalMotion、Open-Sora-v2、LTX-Video 等视频模型,以及 PhyGenBench 上的 VideoREPA、LaMo、PhysVid。关键对照是同一 5B 骨干加与不加 STRIKE 状态条件。转移监督来自 WISA 59,298 集、NVIDIA PhysicalAI 39,873 集、PhyCo/Kubric 31,109 集,合计 130,280 集、353,840 对;PICA-100K 另提供 105,085 条不计时间的编辑对。视频动力学在 WISA 与 OpenVid-1M 上各约 3.4 万集。RoboTwin2.0 训练 112,185、验证 12,465 集。
关键结果与论文证据
- Table 1 上,Ours (CogVideoX-5B) Physics-IQ 总分 41.9、ST-IoU 53.5、WS-IoU 36.0,相对 CogVideoX 的 30.5 提升 11.4 分;Wan 变体 39.7,相对 Wan2.2-5B 的 19.4 提升 20.3 分。两者在已报告分项的模型里 ST-IoU 与 WS-IoU 最好。Wan2.2-14B 仍有最高 S-IoU 50.3;Cosmos3-Super 总分 42.7 略高但未给分项。作者据此认为 5B 骨干加 20B 辅助模型,可以成为单纯放大视频生成器的竞争性替代。
- PhyGenBench 上 CogVideoX / Wan 变体平均 76.91 / 75.62,相对骨干 +22.12 / +24.79,并超过最强基线 CausalMotion 的 70.21。CogVideoX 变体在光学与材料最高,Wan 变体在热学最高;CausalMotion 力学分 73.33 仍领先。Pisa 上 CogVideoX 变体 L2 0.0949、CD 0.2495、IoU 0.1753,L2/CD 相对骨干降 19.6% / 17.3%,421 条视频上距离误差最低。
- RoboTwin2 val500 上两变体各项展示指标均超过基线。Wan 变体 EWMScore-15 62.53、轨迹 0.3368,相对骨干 EWMScore +3.37、轨迹 +42.0%,交互与指令跟随分别 +18.2% 与 +31.8%。图4 里 STRIKE 能画出杯子砸砖碎裂、网球撞开鸭子;基线则杯子悬空或管道凭空变形。图5 里色块排列与订书机放置更接近真值。Table 6 显示学成转移相对未训练 Qwen-Image-Edit:PSNR 17.90→24.88,Physics-IQ 32.60→41.93。去掉首帧 sink 或合成数据都会掉点,其中去合成数据 Physics-IQ 降至 37.91。
阅读时需要注意
- 结论节写明:框架仍是学成的视觉预测器,不是显式物理模拟器;看起来合理的状态不保证轨迹、接触动力学或守恒律正确。训练使用观测状态,推理条件化递归预测状态,长时域误差可能累积。管线还引入额外规划与图像生成代价,并依赖模型辅助标注质量。
- VLM 规划器与生成器不联合训练;开域规划看不到未来参照。RoboTwin2 val500 测的是已知任务的未见回合,不是留出任务类别。Table 5 提醒训练混合与预算不同,消融不宜当作严格因果归因。
- 预印本未同行评审。版权页标注 © 2026 Applied Intuition。
关联工作
- 物理感知生成世界模型多在视频级运动或控制上工作,例如 IRASim 对齐动作轨迹、Unified World Models 联合视频与动作扩散。STRIKE 把单个交互的结果预测做成中间表示。
- KeyWorld、SKIP、DCARL、RoboEnvision、CausalMotion、CoECT 用关键帧、稀疏 rollout 或无需再训练的事件规划引导视频。STRIKE 的差异是:在事件对齐状态对上直接监督共享转移模型,条件是当前视觉状态、一步交互和经过时间。
- SuSIE 用图像编辑扩散提语言条件子目标,MPI 用交互帧预测做表征。STRIKE 不把这些状态交给底层策略,而是交给独立训练的视频动力学,在物理视频与操作视频上一起评测。