快速导读:Tetris3D 按物理依赖顺序自回归生成物体,把邻域几何与关系类型注入体素网格,使单图场景在遮挡下仍能咬合、承重。
单张照片里的盒子装着东西、吉他靠着箱子、书本塞进格架:这些接触面恰恰最容易被挡住。现有单图三维方法常把物体各自生成,再拼进同一场景,结果不是悬空就是互相穿插。Tetris3D(arXiv:2610.10539,KAIST AI)按物理依赖顺序自回归生成物体,并把邻域几何与关系类型写进与生成网格对齐的体素条件。项目页为 https://cvlab-kaist.github.io/Tetris3D/ 。
作者在 TRELLIS.2 上加入按 token 注入的深度、图像回投与交互条件,以及可见到不可见交叉注意力;同时发布仿真数据集 ComOb,含 120 万物理稳定组合场景与 340 万标注样本。Toys4K 上场景级 Chamfer Distance 降至 3.68,穿透深度 0.0036;MessyKitchens 与 Picasso 上在估计深度与 VLM 关系推理下仍保持更高的重建质量与仿真稳定性。预印本尚未同行评审。
英文题目:Tetris3D: 3D Scene Generation With Objects That Fit Together
论文出处:arXiv 每日论文精选 · arXiv:2610.10539
原始论文:PDF / 论文页面
这篇论文解决什么问题?
把观察变成可仿真、可操作的三维资产,需要每个物体完整,也需要支撑、容纳、倚靠在几何上咬合。邻域物体却经常挡住交互区域,只凭可见像素很难恢复接触面。独立生成再装配缺少局部空间约束;隐式特征聚合又给不出明确的关系类型。
作者的直觉是:看场景时我们会用周围几何判断物体还能占哪块空间,用物理关系判断它该搁在、靠在还是装进邻居。Tetris3D 把这两类线索做成显式条件,让后生成的物体在已有网格上长出来,而不是在规范物体空间里另估一次位姿。
核心创新
- 在与生成网格对齐的体素上注入邻域几何与物理关系,使每个物体的形状和位姿相对邻居可兼容。
- 用可见到不可见交叉注意力,把可见 token 的信息聚合到被遮挡区域。
- 发布仿真数据集 ComOb:120 万物理稳定组合场景,带逐物体网格与成对关系标注。
方法概览
骨架基于 TRELLIS.2 的两阶段扩散:先在粗网格生成稀疏占用结构 SS,再在激活体素上生成结构化潜变量 SLAT。物体直接在相机场景坐标系生成:由深度与物体掩码反投影得到局部点云,包围成立体网格 G;可见表面体素写入可学习深度嵌入 cdepth,DINOv3 特征沿相机射线回投为 cimg,从而不必另估位姿。交互条件 cint 由截断无符号距离、指向最近邻表面的方向与法向,加上 stack/lean/contain/touch/none 的关系嵌入组成,只在距离小于截断半径的体素生效。cdepth、cimg、cint 与生成网格对齐,在每个 DiT 层经 MLP 注入,λ 门控从零初始化。V2I 交叉注意力让不可见 token 查询可见 token,补全被其他物体挡住的区域。推理用 VLM 推断有向物理依赖图并拓扑排序,先生成承重物体再生成依赖物体。训练数据 ComOb 用物理引擎把物体按 stack、lean、contain、pile、touch 与几何基元摆稳,共 120 万场景、340 万标注样本。
- 生成直接发生在输入相机的场景坐标系。由深度图(传感器或估计)与目标掩码把像素抬成局部点云,再加边距围成物体网格 G。可见表面体素写入可学习占用嵌入 cdepth;DINOv3 特征沿相机射线回投为 cimg。两者共同固定网格里的位置与朝向,从而省掉单独的位姿估计或事后对齐。
- 交互条件分空间上下文与关系类型。空间上下文用截断无符号距离场,加上指向最近邻表面的方向与该点法向,适应非水密网格。关系类型来自集合 {stack, lean, contain, touch, none},由输入提供或由 VLM 与依赖推理一并给出。cint 只在距离小于截断半径的体素上生效,距离越近权重越大。cdepth、cimg、cint 与生成网格对齐,在稀疏结构与 SLAT 两个 DiT 的每一层经 MLP 加到对应 token;门控从零初始化,微调初期不打断原图像条件。
- 被其他物体挡住的像素沿相机射线标为不可见 token。V2I 交叉注意力让这些 token 作为 query、可见 token 作为 key/value,在两阶段每个 DiT 层更新遮挡区,门控同样从零起。推理时 VLM 先画出有向物理依赖图:边表示支撑或稳定依赖,并带关系标签;拓扑排序后先生成桌子再生成杯子,使交互所需几何逐步可用。
- ComOb 针对现有室内或桌面数据交互覆盖不足的问题。场景按 stack、lean、contain、pile、touch 围绕圆柱、圆锥等基元摆放,再经 MuJoCo 类物理引擎落稳。目标物体来自 TRELLIS-500K,共 120 万场景、340 万样本,含 RGB、物体掩码、深度、网格与成对关系。
逐图理解论文
问题设定
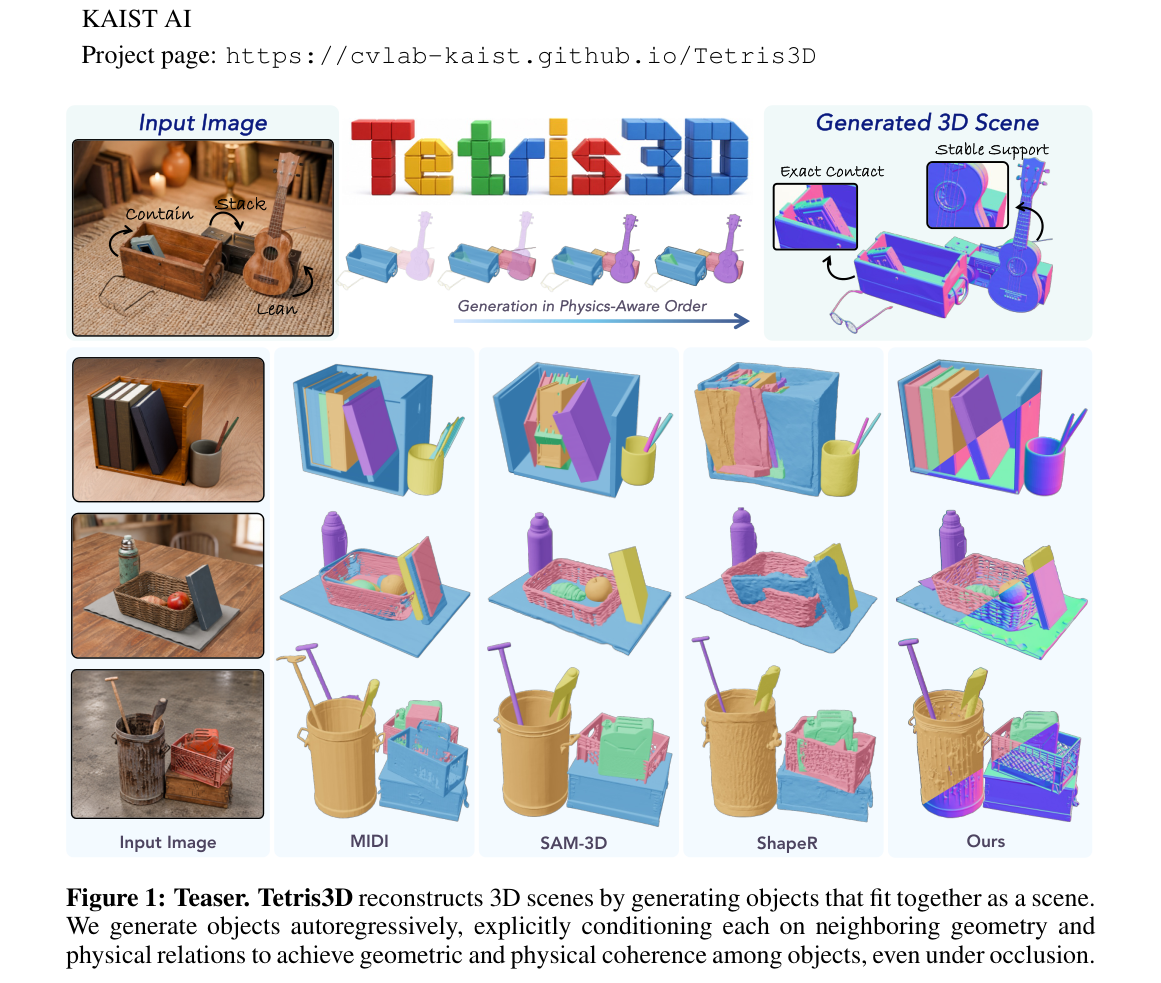
图1是首页 teaser,宜作特色图。左上 Input Image:木箱 Contain 眼镜、箱上 Stack 尤克里里、琴身 Lean 靠箱。中部 Tetris3D 积木字标下 Generation in Physics-Aware Order,半透明到实体的四步:先箱、再琴、再眼镜。右上 Generated 3D Scene 特写 Exact Contact(眼镜与箱壁)与 Stable Support(琴与箱侧面)。下方三行真实照片对照 MIDI、SAM-3D、ShapeR、Ours:书架、筐里苹果与平板、锈桶与红筐;Ours 接触更贴、穿插更少。页眉写 KAIST AI 与项目页。
生成顺序
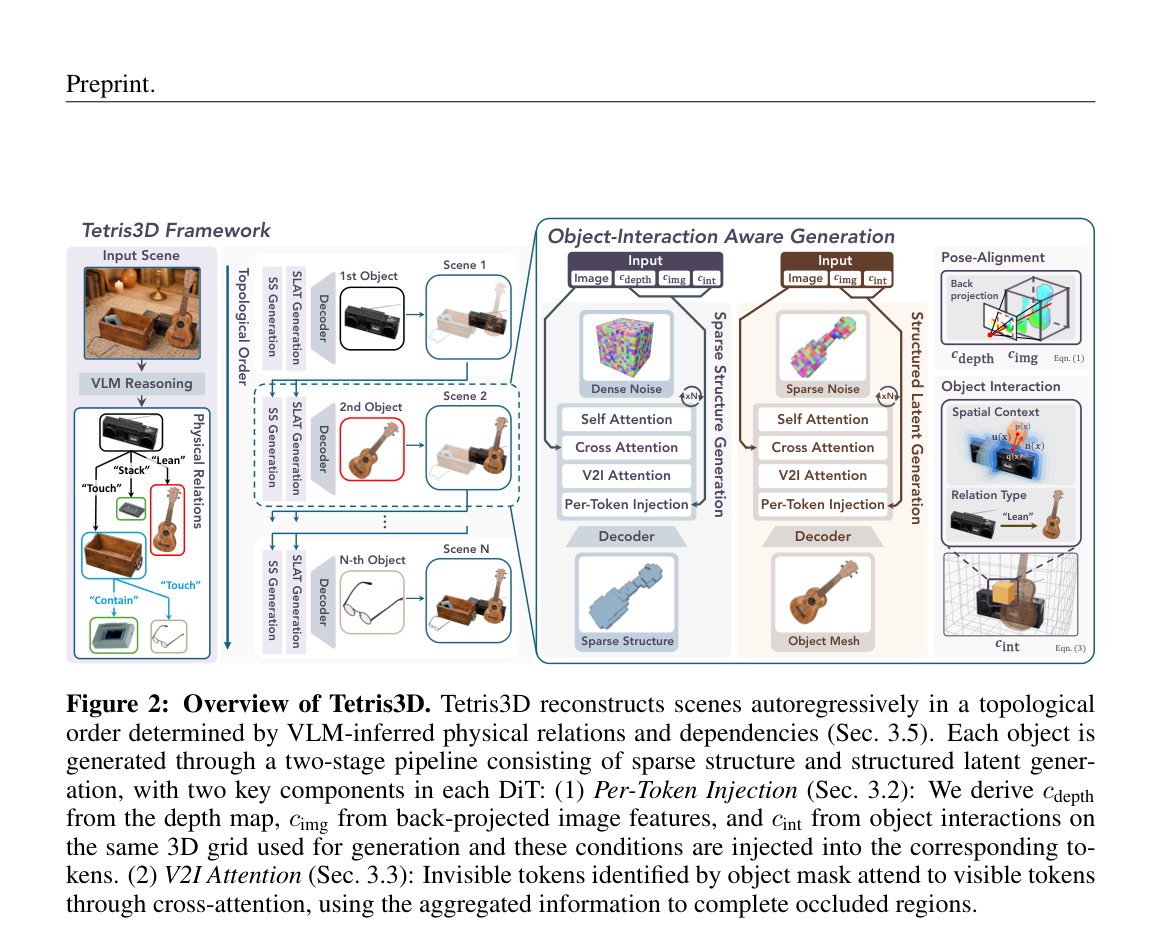
图2是方法总览。左栏 Tetris3D Framework:输入箱琴场景,VLM Reasoning 画出 Plane 到箱的 Contain、箱到琴的 Lean/Stack、箱到眼镜的 Touch,再按 Topological Order 依次 SS/SLAT 生成第 1、2、N 个物体。右栏 Object-Interaction Aware Generation 分 Sparse Structure 与 Structured Latent 两列 DiT,均含 Self/Cross/V2I Attention 与 Per-Token Injection;更右侧 Pose-Alignment 示意 Back-projection 得到 cdepth、cimg,Object Interaction 示意空间向量 u、n 与关系 Lean 合成 cint。
关键证据
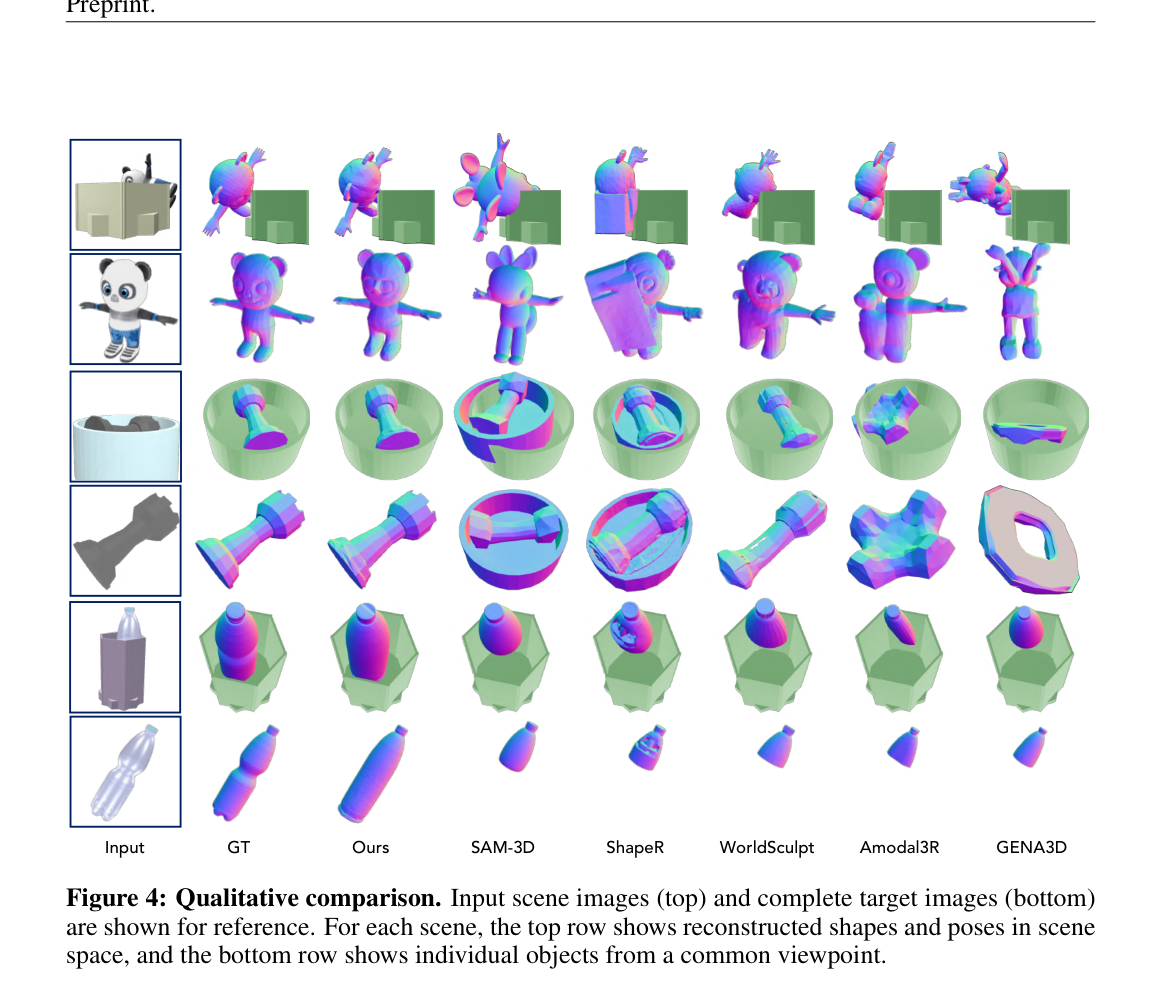
图4是 Toys4K 定性对比。左列每组两张:上为带基元的 Input 场景,下为完整目标参考。列顺序 GT、Ours、SAM-3D、ShapeR、WorldSculpt、Amodal3R、GENA3D。三组分别是熊猫探出绿箱、哑铃卧在碗中、瓶子插在六棱容器。上排看场景空间接触,下排把目标物体转到同一视角。Ours 更接近 GT 的姿态与被挡几何;基线出现倒伏、摊扁、与容器分离或拓扑破坏。
实验如何设计?
- Toys4K 物体来源与训练不相交;评测场景用 ComOb 生成器把基元围在每个目标周围,主表提供真值深度,附录另报 MoGe3 估计深度。MessyKitchens 与 Picasso 为真实、接触密集场景,使用估计深度与 VLM 关系,走完整自回归推理。
- 对照分两类:场景生成方法 SAM-3D、ShapeR、WorldSculpt、MIDI、SceneGen、SceneMaker;非模态生成加位姿的 Amodal3R 与 GENA3D,后者用 FoundationPose 放入场景(表中标 †)。指标分三块:场景级 CD-S、F1-S、IoU-B、ICP-Rot;物体级 CD-O、F1-O 及 MMD、COV、P-FID、Uni3D、ULIP;物理稳定性用穿透深度 PD、仿真后平均位移 Dmean 与峰值动能 Epeak。CD 以 ×10^2 报告。
关键结果与论文证据
- Table 1 上 Tetris3D 在 Toys4K 的重建、生成质量与物理稳定性全面高于对照。场景级 CD-S 3.68、F1-S 0.8407、IoU-B 0.7918、ICP-Rot 5.29,对照里较强的 ShapeR 为 5.72 / 0.6480 / 0.6408 / 10.65。穿透深度 0.0036、Dmean 38.91,远低于 ShapeR 的 0.8862 / 115.1 与 SAM-3D 的 1.354 / 192.4。COV 83.11%、P-FID 1.599 也说明物体分布更接近真值。
- Table 2 显示真实场景同样领先。MessyKitchens 上 CD-S 0.11、F1-S 0.9620、PD 0.0011、Dmean 102.0;Picasso 上 CD-S 0.27、F1-S 0.9053、PD 0.0016、Dmean 434.4。MIDI、SceneGen 在这两套数据上穿透与位移明显更大。图4 中熊猫探出箱子、哑铃卧在碗里、瓶子插在容器中,Ours 保持接触且补全被挡部分;基线出现翻转、摊扁或与容器分离。图5 厨房杂物在仿真后,Ours 仍大致保持初始摆放,若干基线勺、瓶倾倒。
- Table 3 消融(完整模型 CD-S 3.90、PD 0.0192)中,去掉交互条件后 CD-S 升到 8.56、PD 升到 0.4980,穿插明显加重。去掉 V2I 后 CD-S 4.46;换成 Amodal3R 遮挡注意力为 4.29,仍低于完整设计。作者据此认为邻域条件主要管物理兼容,V2I 主要管遮挡补全。注意 Table 3 与 Table 1 的完整模型数字并不相同,消融应读作相对比较。
阅读时需要注意
- 正文没有独立 Limitation 节,但方法依赖可见。推理顺序与关系来自 VLM,清单或拓扑错了会传到后续物体。物体网格由深度定义,Toys4K 主结果用真值深度,真实基准用 MoGe3,深度误差会变成网格误差。
- 自回归会累积前序形状误差。ComOb 大量使用几何基元作为交互伙伴,不能直接等同任意室内布局。方法输出更稳的接触几何,但运行时并不是在线物理求解器;稳定性数字来自事后把重建场景放进物理引擎。
- 预印本未同行评审。AI 使用声明写明生成式工具只用于润色文字与整理可视化,不用于选题、模型与实验设计。
关联工作
- TRELLIS.2 提供稀疏占用加 SLAT 的两阶段体素扩散;Tetris3D 冻结其图像编码器设定,把场景空间条件与 V2I 接到同一网格。Pixal3D 启发了沿射线回投图像特征。
- SAM-3D、ShapeR、WorldSculpt、MIDI 代表独立或弱耦合的场景生成;SceneGen、SceneMaker 更偏隐式多实例。Amodal3R、GENA3D 先补全再估位姿。Tetris3D 把形状生成直接放在场景坐标系,并用显式邻域条件代替事后对齐。
- 3D-FRONT 等室内数据交互类型有限,桌面数据集环境更窄。ComOb 用仿真把通用物体按多种接触类型摆稳,专门给交互条件提供监督。