快速导读:S2Tok 把可扩展的持久空间 token 当作场景状态,把新观测的更新与选择性扩容分开,再解码成无需缓存旧图的可渲染三维高斯。
流式三维重建要在图像陆续到达时就给出可用场景,而不是等整段视频收齐。对交互采集和具身建图来说,观测尚未结束时就需要判断覆盖、决定下一视点。S2Tok(arXiv:2610.08978,Applied Intuition / UIUC / Purdue / UC Berkeley)把这件事写成维护场景状态:一份能吸收新证据、随时可渲染的表示。项目页为 https://s2tok.github.io/ 。
方法的核心是可扩展的持久空间 token。Stream-Spatial Transformer 把新帧写进已有场景记忆;学习到的准入模块只接纳可能带来新内容的 token,避免把每次观测都当成扩容。层次解码器与高斯头再把当前状态读成非像素对齐的三维高斯。四个基准上,它在前馈流式方法里拿到有竞争力的 PSNR,并以更少的高斯完成重建。预印本尚未同行评审。
英文题目:S2Tok: Streaming 3D Gaussian Reconstruction with Persistent Spatial Tokens
论文出处:arXiv 每日论文精选 · arXiv:2610.08978
原始论文:PDF / 论文页面
这篇论文解决什么问题?
新观测可能揭示未见结构,也可能只是给已见表面补充几何或外观证据。前者需要增加表示容量,后者应更新已有 token。把所有新 token 都留下会在重叠视点上堆冗余;把状态锁成固定集合,又会在场景展开后遇到容量瓶颈。没有已知相机参数时,模型还必须自己推断新观测与累积场景的对应。
现有工作各覆盖一段。ZipSplat、TokenGS、GlobalSplat 用场景 token 解码高斯,但针对一次性给定的图像集合。CUT3R、Point3R 等循环方法在线更新记忆,标准管线却用记忆预测每视点点图再累积。S2Tok 要连接这两类能力:一份在线更新的自适应场景 token,并在每一步联合解码成累积高斯场景。
核心创新
- 用可扩展的持久空间 token 作为场景状态,每步从当前状态联合解码累积高斯场景,推理不保留过去图像。
- 把观测整合与状态扩容解耦:空间知情的循环更新加上先蒸馏几何 oracle、再用 SCST 按重建质量优化的准入策略。
- 在四个基准上同时评中间与最终重建,以前馈流式设定给出紧凑高斯与有竞争力的渲染。
方法概览
S2Tok 对未标定图像流逐步处理。第 i 步用 ViT 把新帧 Ii 编成帧 token fi;已有空间 token S_{i-1} 与 fi 进入 Stream-Spatial Transformer。每个 block 含三层共享结构、不同设定的注意力:无位置编码的全局注意力 A_global 让尺度 token s、S_{i-1} 与 fi 互相看见;场景局部注意力 A_scene 只更新 s 与 S_{i-1},并对空间 token 施加 RoPE3D(坐标取上一时刻各 token 高斯中心的不透明度加权几何中位数);帧局部注意力 A_frame 用二维 RoPE 只更新 fi。可学习尺度 token 把各步预测约束到归一化空间。准入模块以更新后的帧 token 为 query、场景 token 为 key/value,预测准入 logit,概率超过阈值 τ 的帧 token 才拼进 S_i 并带到下一步。离散选择无法直接反传,故先用基于深度的几何新颖性 oracle 做加权 BCE 蒸馏,再用 SCST 比较随机准入与确定性准入的重建误差,用策略梯度按重建效果调整准入。层次解码器取 SS-Transformer 三层 token(各层均为空间 token 与已准入帧 token 的拼接),经自注意力与残差融合后由高斯头预测非像素对齐的 3DGS(每个 token 对应 h 个高斯,共 23 维属性)。损失含 RGB L1、LPIPS、深度 L1、未渲染高斯的单向 Chamfer、尺度回归、准入 BCE 与 SCST。推理不缓存历史 KV 或旧图,每步从当前状态重新解码累积场景。
- 每一步先用 ViT 把未标定新帧 Ii 编成帧 token fi。已有空间 token S_{i-1} 与 fi 进入 Stream-Spatial Transformer。进入前会拼接一个可学习归一化尺度 token s,因为观测范围随步数增大,各步预测需要落在归一化空间里,避免尺度外推。
- 每个 SS-Transformer block 有三层注意力,结构相同、作用范围不同。全局注意力不加位置编码,让 s、空间 token 与帧 token 互相看见,从而把已有场景适配到新观测,并把新帧隐式对齐到空间 token 的参考系。场景局部注意力只更新 s 与空间 token,并用 RoPE3D 编码空间关系,三维坐标取上一时刻各 token 预测高斯中心的不透明度加权几何中位数。帧局部注意力只用二维 RoPE 更新帧 token。
- 准入模块由交叉注意力与自注意力组成,以更新后的帧 token 为 query、场景 token 为 key/value,输出准入 logit。概率超过阈值的帧 token 才拼进 S_i 并带到下一步,使下一帧能与累积场景交互,而不保存历史 KV 缓存。离散选择无法用普通渲染损失反传。训练分两段:先用基于深度的几何新颖性 oracle 做类别加权 BCE 蒸馏,再做 SCST——同参数下跑确定性准入与伯努利采样准入,用两者重建误差之差作为优势,给准入策略提供重建驱动的梯度,并用对 oracle 分布的 KL 项稳住早期优化。
- 层次解码器取 SS-Transformer 三层 token SI、SII、SIII(即当前 S_i),每层都是空间 token 与已准入帧 token 的拼接。各层先各自自注意力,再以 SIII 为解码流起点做残差融合,高斯头预测每个 token 对应的 h 个高斯,属性含均值、尺度、四元数、不透明度与一阶球谐,共 23 维。渲染损失在归一化空间里同时监督新见与已见视图,含 RGB L1、LPIPS 与深度 L1,并对过大尺度、过低不透明度与越界中心做正则;另有单独的逐帧渲染通路保留帧级梯度。从未被监督视点渲染到的高斯,用单向 Chamfer 拉向由伪真值相机与深度反投影的点云。尺度头从 s' 回归对数归一化尺度。
逐图理解论文
更新与准入
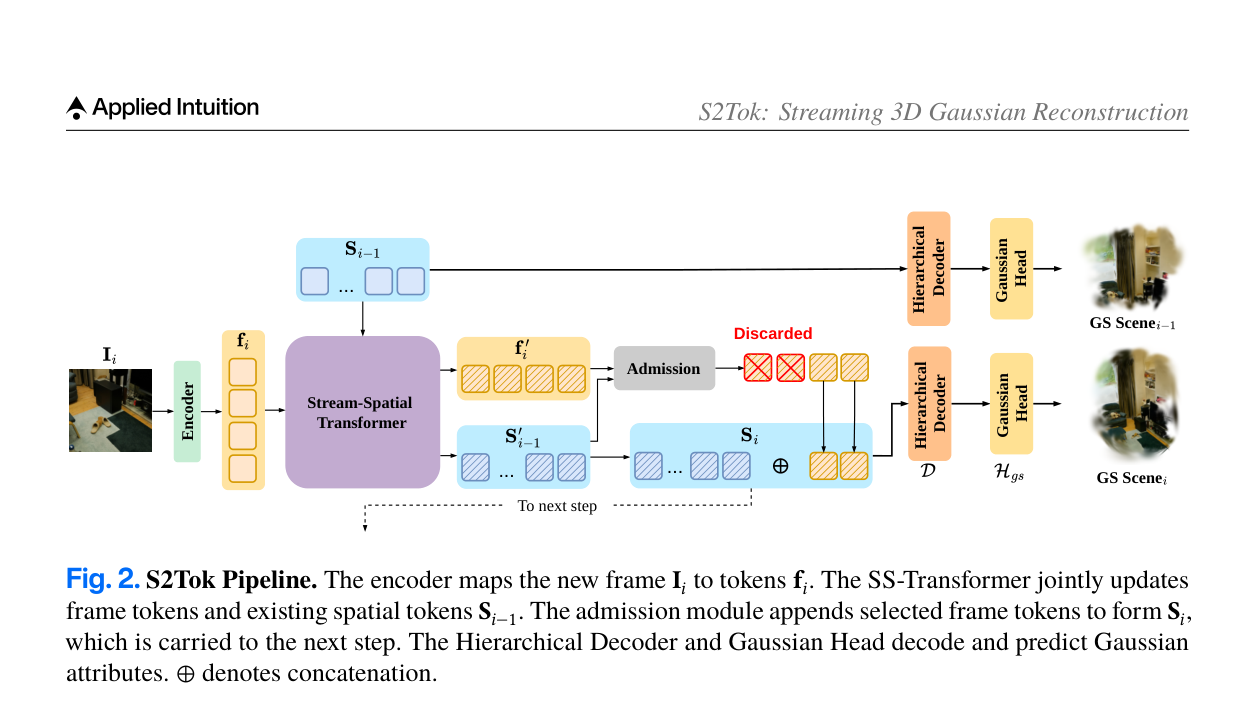
图2是方法总览,宜作特色图。左侧输入帧 Ii 是室内桌面照片,经绿色 Encoder 变成黄色帧 token fi,与浅蓝空间 token S_{i-1} 一起进入紫色 Stream-Spatial Transformer。输出分两路:斜线填充的更新帧 token f'_i 进入灰色 Admission,标红 Discarded 的 token 被丢掉,留下的与更新后的 S'_{i-1} 拼接成 S_i;虚线标 To next step,表示 S_i 被带到下一步。S_{i-1} 与 S_i 各自经过橙色 Hierarchical Decoder 与黄色 Gaussian Head,得到 GS Scene_{i-1} 与 GS Scene_i 两张渲染。图注写明 ⊕ 表示拼接。这张图把“更新已有状态”和“选择性扩容”画在同一条管线上。
解码与渲染
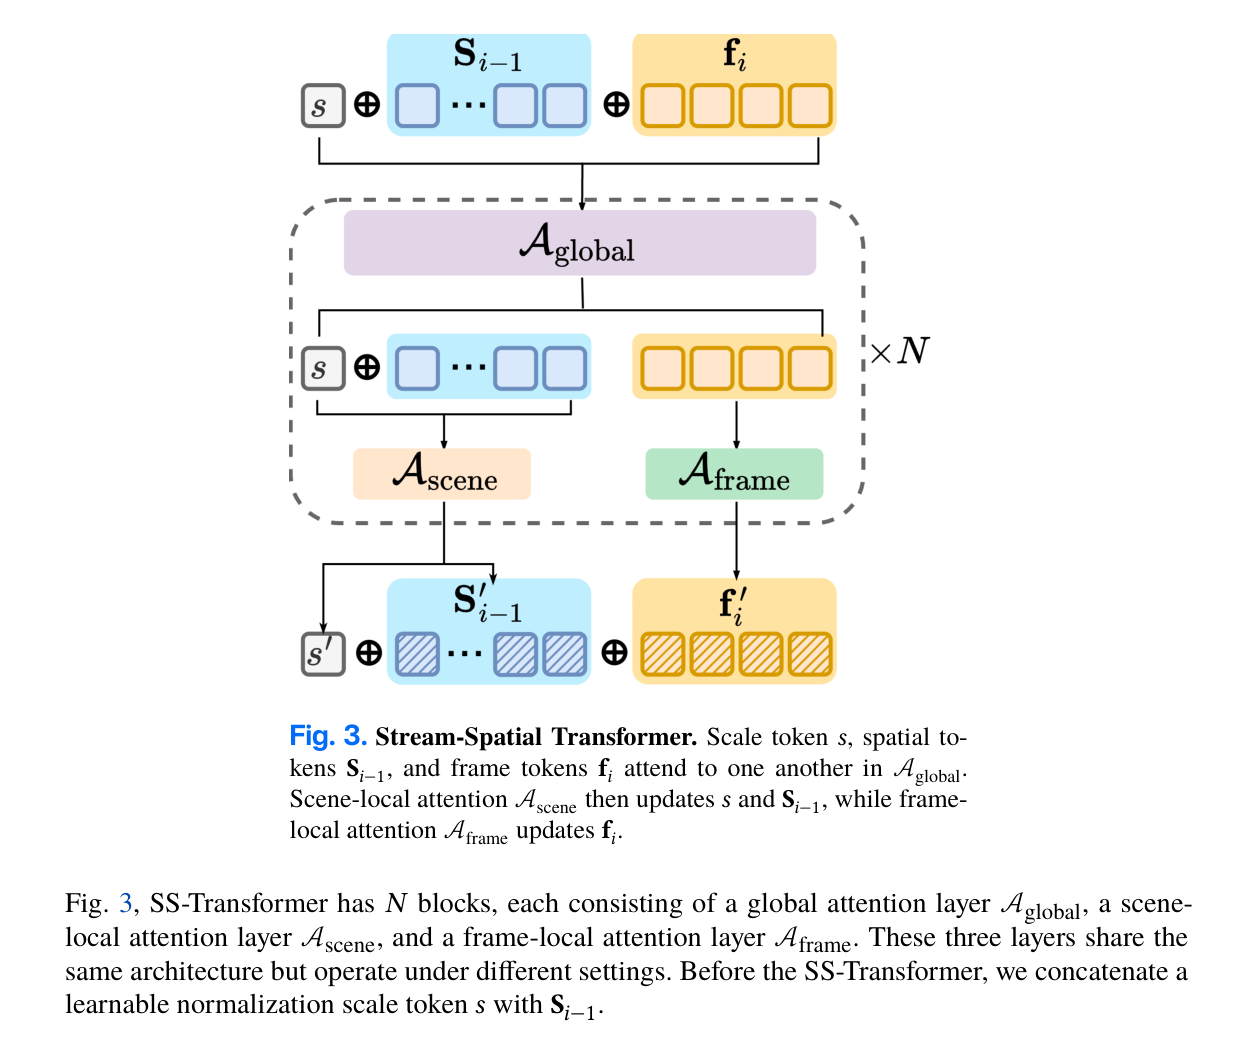
图3是 Stream-Spatial Transformer 的注意力分解,选用比 figure-03-p005-01 更少页眉残字的裁切。顶部把尺度 token s、浅蓝 S_{i-1} 与黄色 fi 拼接后送入紫色 A_global;再分成两支:左支 A_scene 只更新 s 与空间 token,右支 A_frame 只更新帧 token,虚线框标 ×N 表示 N 个 block。底部得到 s'、斜线填充的 S'_{i-1} 与 f'_i。图下方多出来的段落来自正文,不是图注本身,讲图时忽略。它对应方法里“全局对齐、场景内更新、帧内更新”三层分工。
Fig
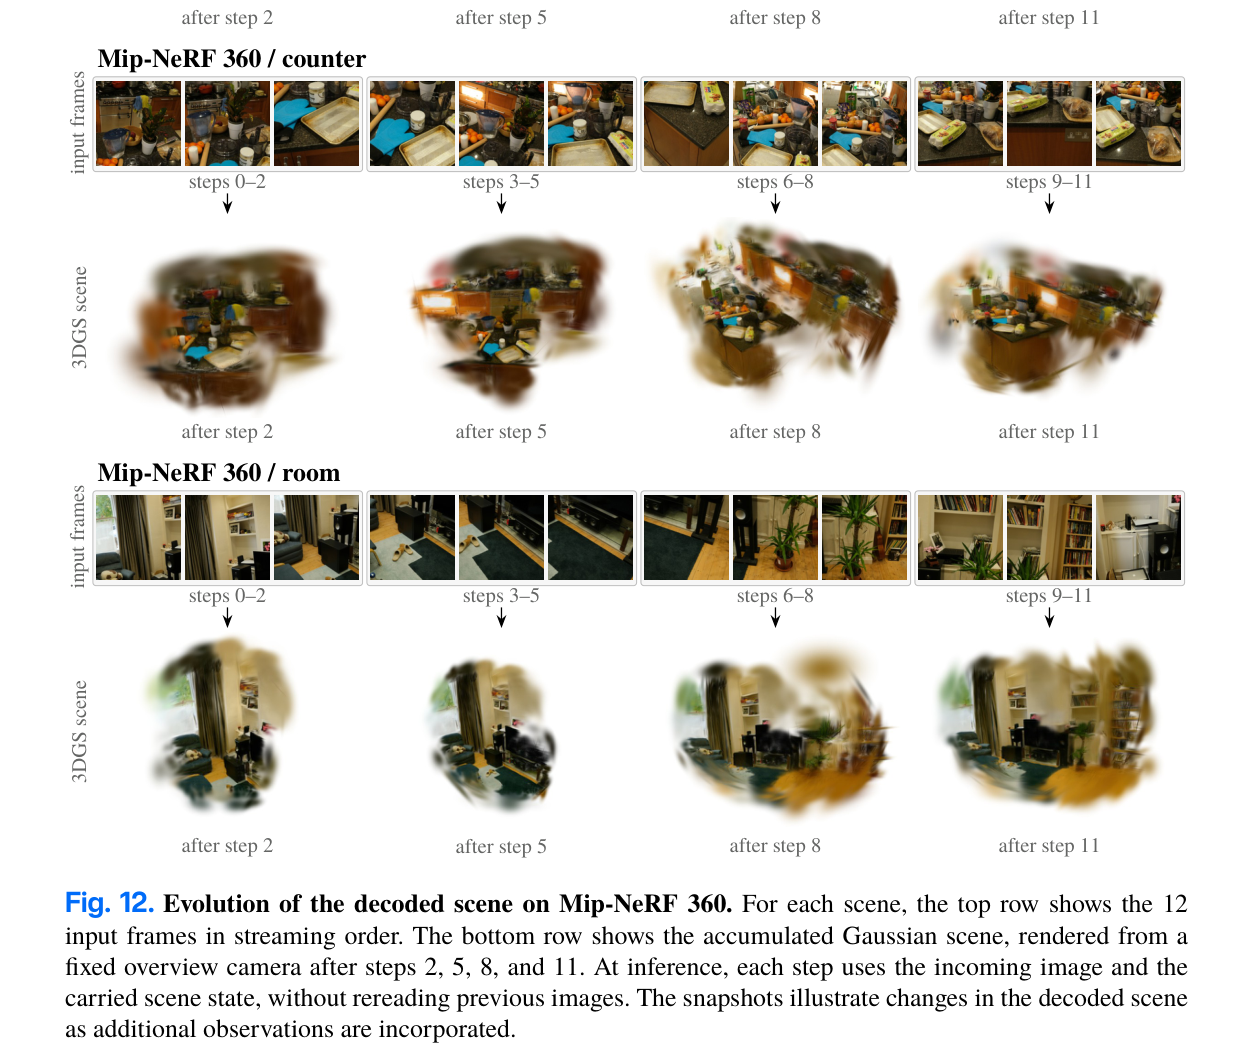
图12展示 Mip-NeRF 360 上解码场景如何随流演化。这张裁切含 counter 与 room 两景(PDF 全图还有 bonsai)。每景上行是 12 张按流顺序排列的输入帧,分成 steps 0–2、3–5、6–8、9–11;下行是固定鸟瞰相机在 after step 2/5/8/11 渲染的累积 3DGS。counter 从模糊台面逐渐出现餐具与水果,room 从暗客厅逐渐出现沙发、绿植与书架。图注强调推理每步只用当前图像和携带的场景状态,不重读旧图。早期渲染很糊,说明状态是逐步变完整的,也与正文里 Final 不保证单调提升的警告一致。
实验如何设计?
- 训练只使用 DL3DV 与 RealEstate10K。评测覆盖这两个训练集,以及训练域外的 Mip-NeRF 360 与 ScanNet++。训练时采样 12 到 24 帧有序上下文,第一帧定义参考坐标系。
- 评测在相邻上下文视点之间扣留一个目标视点,分两种协议。Final:整段上下文处理完后再渲染全部目标视点。Intermediate:每一步只用当时已见的上下文渲染对应目标视点。流式方法增量更新场景;非流式方法在每个评测步重新联合处理当时所有上下文。StreamSplat 只报 Intermediate,因为它的时间条件重建不产生全局相机对齐的最终场景。点图方法用 point-splat 渲染后再比图像指标。
- 对照包括 ZipSplat(默认压缩与匹配 token 预算两种)、TokenGS、GlobalSplat、AnySplat、DepthSplat-B,以及优化式 MonoGS 和 CUT3R、StreamSplat、Spann3R、Point3R、StreamVGGT。流式方法在 50 视点设定下于单张 A100 80GB 上报每视点时间与峰值显存。
关键结果与论文证据
- Table 1 上,DL3DV 含较大相机运动。S2Tok 在所比前馈流式方法中取得最高 PSNR:12 视点 Final 19.52、Intermediate 20.27,36K 高斯;50 视点 Final 18.00、Intermediate 19.11,66K 高斯,81 ms/视点、7.8 GiB。优势并非所有指标均匀,LPIPS 仍弱于若干非流式高斯方法。作者强调与匹配预算的 ZipSplat†(66K)相比,它用流式状态达到可渲染结果,而 ZipSplat 本身不是流式。
- 室内 RealEstate10K 上,12 视点 Final 23.86 / Intermediate 25.03,仅 17K 高斯;50 视点 Final 23.62 / Intermediate 25.04,21K 高斯,仍是所比前馈流式方法中最高 PSNR。Mip-NeRF 360 作为迁移集,50 视点 Final 18.00、Intermediate 19.16,82K 高斯,PSNR 高于所比前馈流式方法,但 LPIPS 不占优。ScanNet++ 上 Final 分数在前馈流式方法中最好且高斯最少(41K/71K),但 50 视点 Intermediate 由 StreamSplat 在三项指标上领先。
- Table 3 显示:去掉 RoPE3D 或尺度 token 都会降渲染质量。去掉准入后高斯从 66K 暴涨到 518K,Intermediate PSNR 升到 20.39,Final 反而降到 17.50,说明无节制扩容会伤害最终一致性。去掉 SCST 略升指标但高斯近乎翻倍到 120K;在匹配 66K 预算时,完整模型在全部 Final 与 Intermediate 指标上更好。作者还指出,50 视点上 Final PSNR 普遍低于 Intermediate(DL3DV 18.00 vs 19.11,RealEstate10K 23.62 vs 25.04,ScanNet++ 20.54 vs 22.63),继续更新并不单调提升已见视图。
阅读时需要注意
- 附录 H 写明:持续更新会降低已评视图保真度;训练与评测窗口有限,更长流上的保持未证实;准入只加不减,没有固定记忆预算;框架针对静态场景。Fig. 11 还显示 token 存储在 50 步窗口内增速变慢,但仍在扩张,不能据此外推更长流的显存上界。该存储曲线也不同于 Table 1 的端到端 GPU 峰值。
- 作者同时提醒:对照方法的监督、表示和渲染内核并不完全一致,不能把 PSNR 差距归因到单一模块。深度图是 DA3 伪真值。预印本未同行评审,版权标注为 Applied Intuition。
关联工作
- 离线前馈重建从 DUSt3R 的成对点图、VGGT 的多视几何,走到 pixelSplat、MVSplat、NoPoSplat 等像素对齐或无位姿高斯。它们联合处理图像,缺少随流演化的持久状态,像素对齐原语也更占存储。
- 流式一侧,优化式单目高斯 SLAM 依赖测试时跟踪与建图迭代;StreamVGGT 缓存历史键值,IncVGGT 压缩历史。循环点图方法把记忆解码成每视点几何。可渲染流式工作如 StreamGS、StreamSplat 预测并融合逐帧高斯。S2Tok 选择把可扩展潜在状态与非像素对齐高斯放在同一表示里,推理不读旧图。