快速导读:YUBI-STAG 用接触轨迹锚定自动标注,把粗粒度双臂演示对齐到细粒度操作语言,再后训练引出预训练 VLA 的精细接触能力。
机器人演示已经能告诉模型任务做完了什么,却很少告诉它是怎么做的:哪只夹爪先动、接触的是红色塑料件还是隔壁零件、盖子是被拧开还是被托住。YUBI-STAG(arXiv:2610.09718,AIRoA / 东京大学 / 东京科学大学)把这个问题写成数据中心对齐:预训练视觉-语言-动作模型(VLA)已经从大规模交互里学到几何与物理,缺的是能把这些能力唤出来的细粒度语言。项目页为 https://yubi-stag.airoa.io/ 。
作者用接触物体分割得到接触轨迹,再分四阶段自动标注物体身份、每夹爪动作、双手协同与物体变化,并把管线蒸馏成可直接处理未切分腕部视频的 YUBI-VLM。用这些标注后训练 π0.5 策略后,零件分拣的完整成功率从粗标签的 0% 升到 60%,颜色、夹爪和空间关系等原演示标签里没有的概念也能被语言控制。预印本尚未同行评审。
英文题目:YUBI-STAG: Contact and Semantic-Rich Alignment for VLAs via Automated Video-Language Grounding
论文出处:arXiv 每日论文精选 · arXiv:2610.09718
原始论文:PDF / 论文页面
这篇论文解决什么问题?
YUBI 这类便携双臂接口把采集效率推到 8434 小时,但语言仍按任务类复制同一句粗指令,例如整段分拣都被写成 pick a part and place it in a box。后训练如果只看见这句话,就无法知道接触何时开始、哪只手负责、物体被交接到何处。
现有指令增强多补执行细节,中间表示则把框、轨迹或接触点画在图像上,但很少同时从运动腕部视角恢复:哪只夹爪、在哪些像素、在哪段时间接触哪个物体,以及双手如何协同。作者因此把 Superficial Alignment Hypothesis 延伸到 VLA:限制主要不在先天能力,而在后训练缺少精确对齐信号。
核心创新
- 接触锚定的 STAG 管线把粗标签双臂演示恢复成时空接地标注,并蒸馏成可直接处理未切分腕部视频的 YUBI-VLM。
- 提出 YUBI-STAG-Bench,在未见任务上评接触区间与掩码、PA 切分与描述、身份属性、协同、空间关系与状态转移。
- 接触与语义丰富的 VLA 后训练提供惯用手、接触相位与接触感知采样,把数据中心对齐从指令文本延伸到物理交互。
方法概览
YUBI-STAG 分两块。接触物体分割模块用冻结 DINOv2-L 编码双腕视频,时序 Transformer 加 MLP 预测接触状态,DPT 风格解码器输出接触物体掩码;伪标签来自夹爪开度稳定后用指尖间点提示 SAM2,再以共运动过滤背景,经自训练与少量人工标注精修。接触轨迹作为时空锚点,交给四阶段 VLM 标注:场景清单与持久物体 ID;绑定接触轨迹后写 PA 子阶段、每夹爪动作与七类协同;比较接触前后记录位置、状态、装配与容纳变化;最后合成带 ID 的接地 PA 描述。因管线依赖已切分 PA 且调用次数多,作者把能力蒸馏进 YUBI-VLM:从 Qwen3.6-27B 用 LoRA 训练十种预测模式,接触掩码以轮廓叠在腕部帧上,50% 样本丢掉顶视。后训练在 π0.5 骨干上保持观测与动作不变,用物体属性与空间关系丰富 PA,并加入惯用手、接触相位(接近、抓取、保持、释放)与接触优先采样。
- 接触不能靠夹爪开度凑合。开度稳定既不稳定,也漏掉用来扶持、抵住的非抓取接触;YUBI 与 UMI 又没有触觉。分割模块用冻结 DINOv2-L 编码左右腕视频,轻量时序 Transformer 联合建模,MLP 预测接触状态,DPT 风格解码器输出接触物体的像素掩码。规模化训练先用开度稳定后的指尖间点提示 SAM2,再以点跟踪共运动滤掉背景,经人工筛选、自训练和少量精确标注精修。
- 接触轨迹成为四阶段 VLM 标注的时空锚点。第一阶段建立带持久 ID 的场景清单,记录颜色、材质、形状、尺寸与角色,避免同一物体在不同交互被当成新实例。第二阶段把轨迹绑到 ID,利用释放后立刻再抓或交接的时间连续性消解外观相似,并在给定 PA 区间内细分成子阶段,写出每只夹爪动作与七类协同。第三阶段对比接触前与释放后,记录相对位置、开关状态、装配与容纳。第四阶段把上述结果合成带 ID 的接地 PA 描述。
- 完整管线需要已切分 PA 且每 episode 约 154 次 VLM 请求。YUBI-VLM 从 Qwen3.6-27B 出发,用 LoRA(489M,1.76%)在十种预测模式上联合训练,覆盖清单、PA 时间跨度、持物分配、子阶段与协同、状态与容纳,以及接地描述。接触掩码以轮廓叠在腕部帧上,无需额外掩码编码器;50% 样本丢掉顶视,使腕部-only 采集也可标注。训练数据为 2,477 场、129 个长程任务、29.4 小时、18,336 个 PA 片段,得到 29,500 条样本,并排除全部 Bench 任务。
- VLA 侧采用 π0.5:两路腕部图像、语言与本体感觉预测双臂动作块,动作为每手 6-DoF 增量与夹爪命令,损失是标准条件流匹配。后训练不改网络,只把 PA 写成带属性与空间关系的指令,并默认加入惯用手(左、右、两种交接)与接触相位(接近、抓取±0.2 秒、保持、释放末 0.2 秒)。接触优先采样把稀疏但关键的相位提到更高抽中频率,例如占演示 5% 的抓取起始可构成 30% 训练块。
逐图理解论文
监督缺口
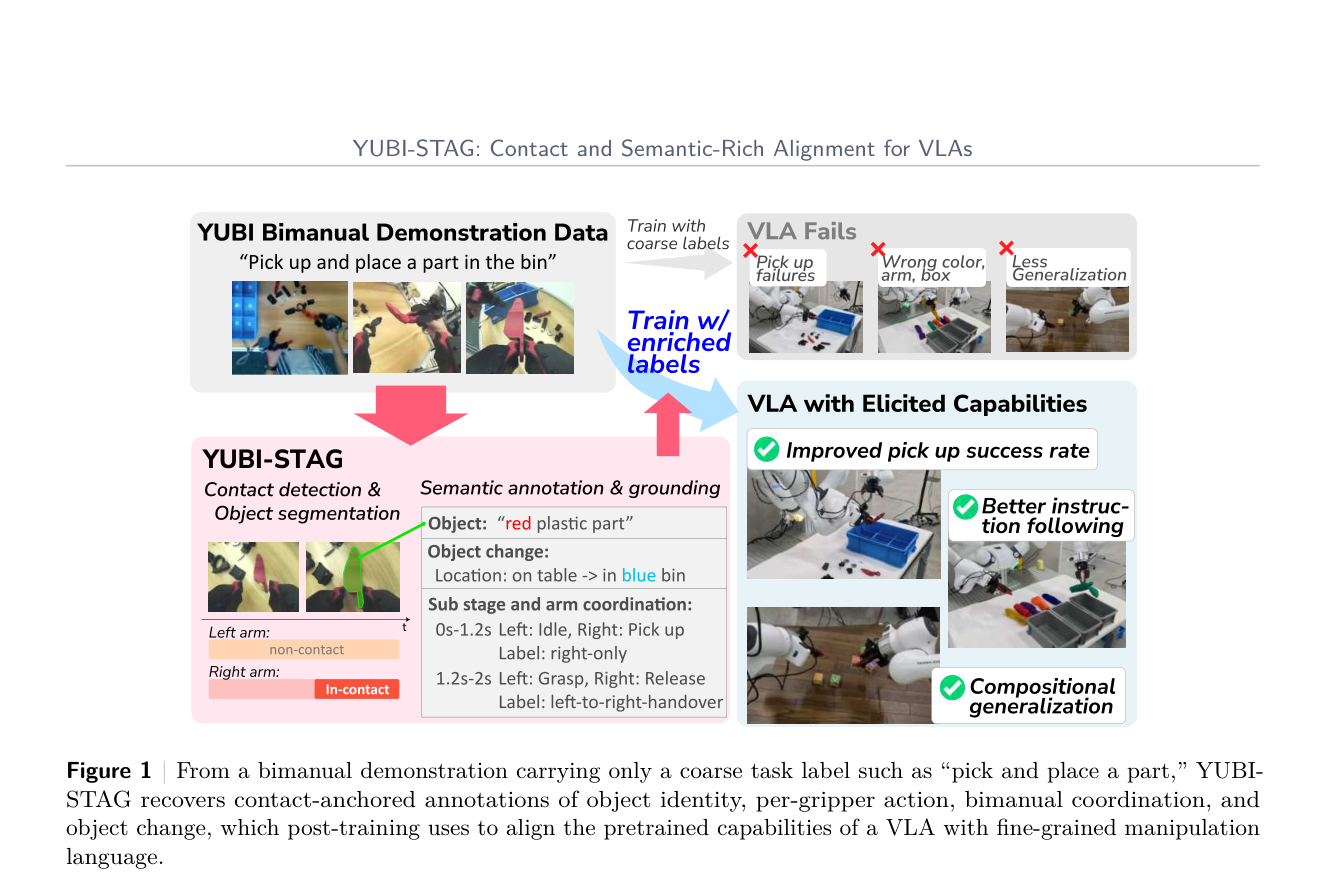
图1是首页总览,宜作特色图。上方演示只有 Pick up and place a part in the bin 这类粗标签;Train with coarse labels 通向三条失败:拾取失败、颜色/手臂/箱子错误、泛化变差。蓝色箭头把丰富标签送入粉框 YUBI-STAG:左为接触检测时间条,左臂 non-contact、右臂 In-contact,并给出接触物体分割;右为语义字段,物体写 red plastic part,位置从桌上到 blue bin,0s-1.2s 右臂拾取(right-only),1.2s-2s 左抓右放(left-to-right-handover)。右下青框给出引出后的三项:拾取成功率、指令跟随、组合泛化。
标注管线
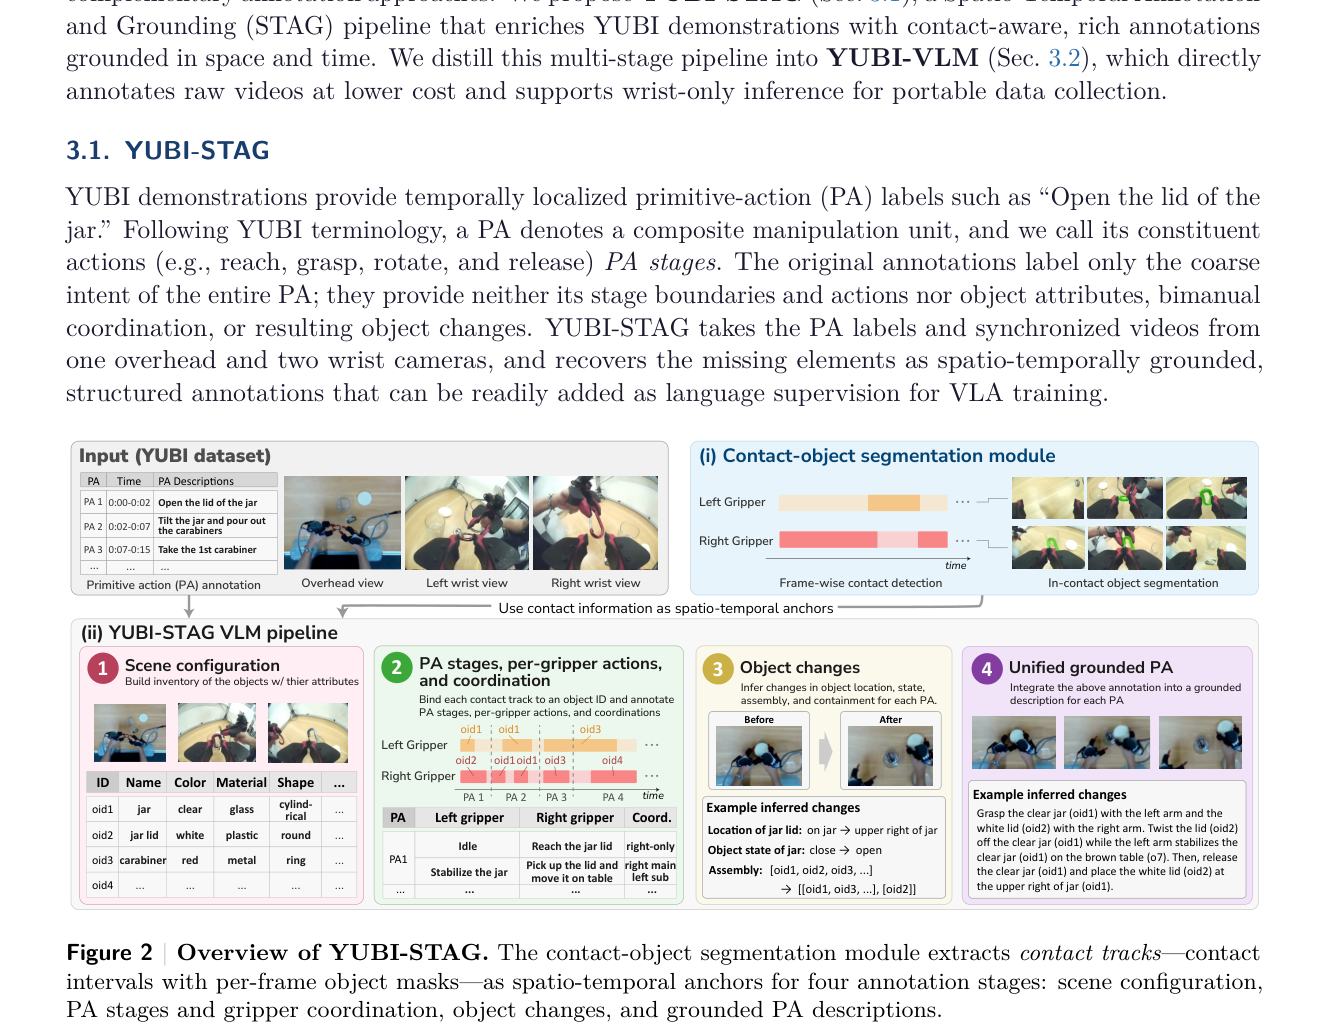
图2是 YUBI-STAG 管线。输入是 PA 表(开罐盖、倾斜倒出快挂扣、取第一只快挂扣)加顶视与双腕视频。右上接触物体分割模块输出逐帧接触与掩码。下方四阶段:① 建立 oid1 jar、oid2 jar lid、oid3 carabiner 等清单;② 把接触轨迹绑到 ID,写 Idle / Reach the jar lid / Stabilize the jar 与 right-only、left sub 等协同;③ 对比开关盖,盖子 on jar→upper right of jar,罐子 close→open,装配从 [oid1, oid2, oid3, …] 拆成 [[oid1, oid3, …], [oid2]];④ 合成 Grasp the clear jar (oid1) with the left arm and the white lid (oid2) with the right arm 这类接地描述。裁切上方有 3.1 节正文,读图时可忽略。
蒸馏与后训练
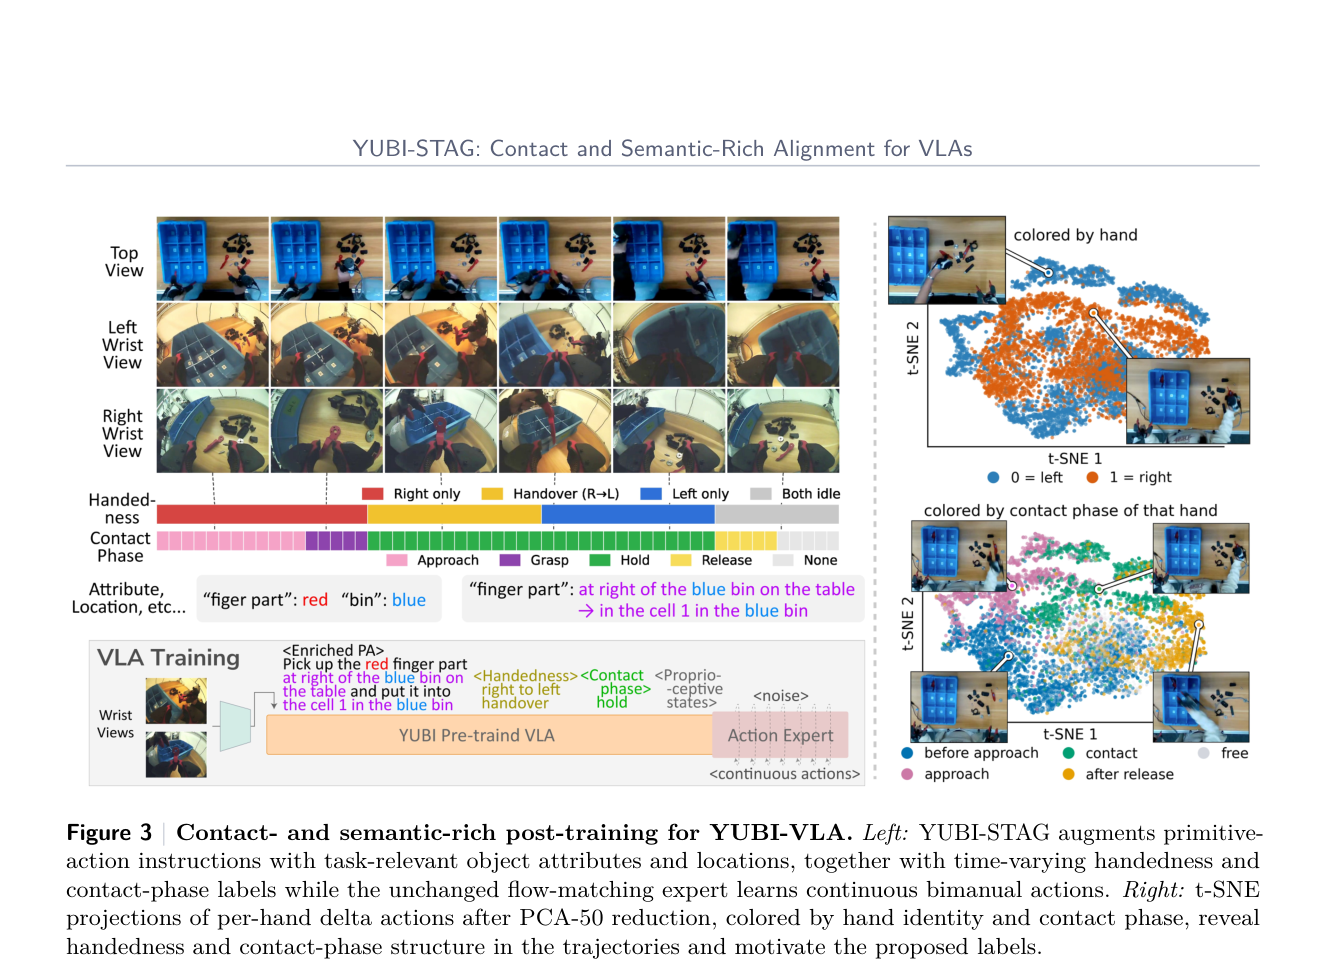
图3讲后训练。左侧零件分拣时间轴上,Handedness 在 Right only、Handover (R→L)、Left only 间切换,Contact Phase 为 Approach、Grasp、Hold、Release。语言把 finger part: red 与 bin: blue 写成 at right of the blue bin on the table → in the cell 1 in the blue bin。训练框图里腕部观测进入 YUBI Pre-train VLA,Handedness、Contact phase 与本体状态一起条件化未改动的流匹配动作专家。右侧 t-SNE 在 PCA-50 后按手着色呈蓝左橙右两簇,按接触相位着色则接近、接触、释放分区,用来说明这些标签对应真实动作模式。原图把 finger 印成 figer。
关键证据
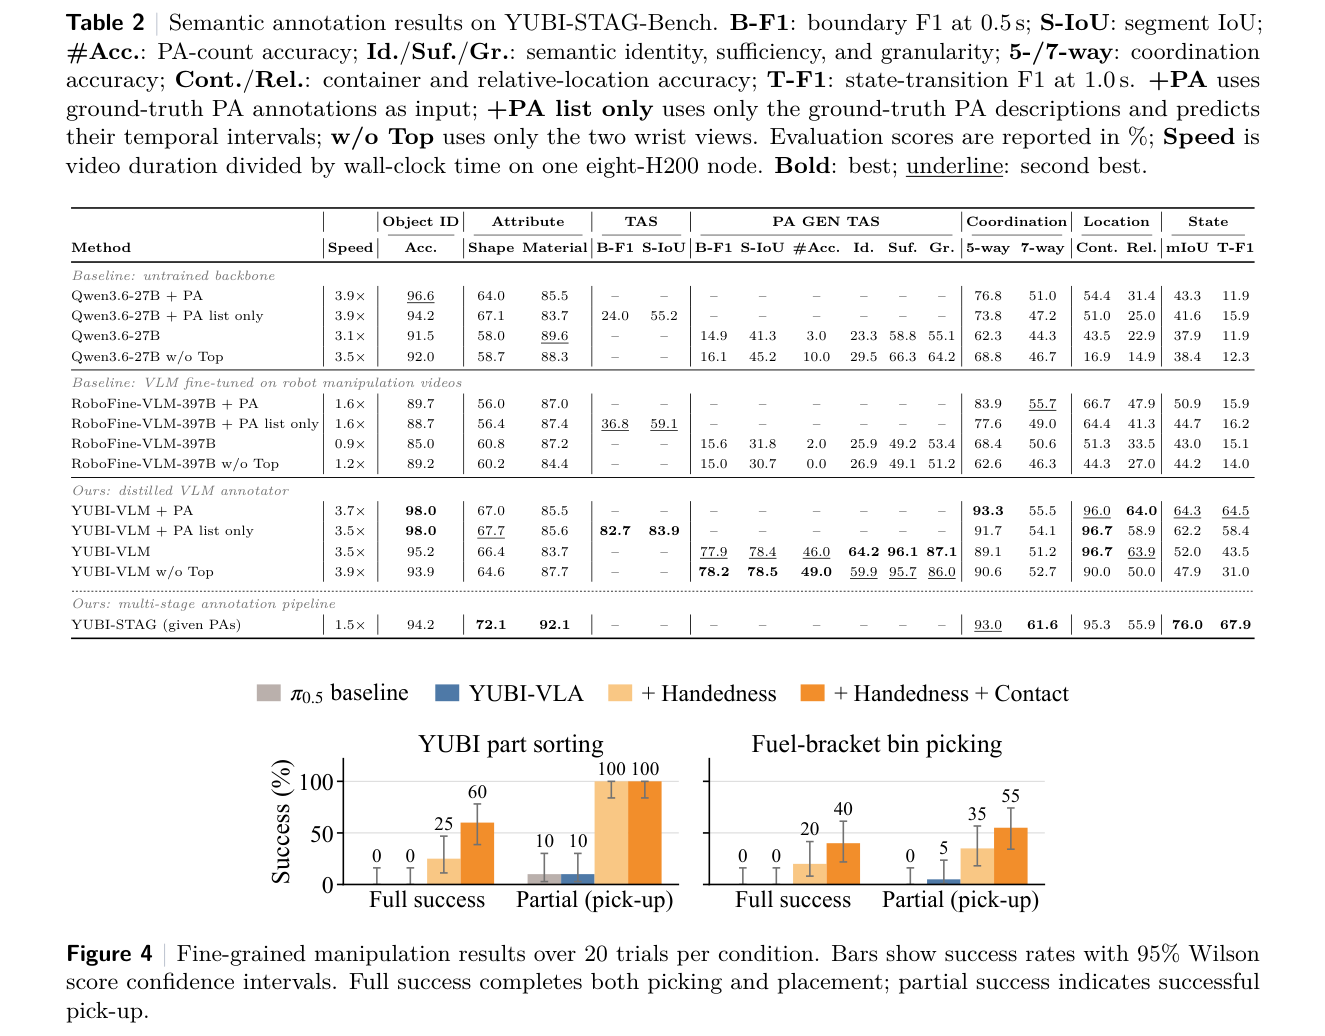
图4是精细操作成功率,每条件 20 次,误差棒为 95% Wilson 区间。左:YUBI part sorting,完整成功 0/0/25/60,部分拾取 0/10/100/100。右:Fuel-bracket bin picking,完整成功 0/0/20/40,部分拾取 0/5/35/55。四档颜色依次为 π0.5 baseline、YUBI-VLA、+Handedness、+Handedness + Contact。PNG 上半误裁入 Table 2 语义标注表,讲图只取下方柱状。
实验如何设计?
- YUBI-STAG-Bench 含 10 个未见任务、每任务 10 条、共 100 条人工标注 episode,计 510 个物体、970 个 PA、2,201 段交互,接触掩码 10 fps。接触评测用时间 mIoU、帧准确率以及 DAVIS J/F(未覆盖帧记零)。语义侧按接触轨迹重叠匹配物体,不看预测名字;TAS 用边界 F1@0.5 秒与片段 IoU;PA GEN TAS 另报 PA 计数,并用 GPT-5.2 评身份、充分性与粒度。
- 对照包括开度+SAM2、未训练 Qwen3.6-27B(可给格式示例)以及 FineVLA 发布的 RoboFine-VLM-397B。+PA 提供真值描述与区间,+PA list only 只给描述,默认从原始未切分视频出发,w/o Top 仅保留腕部。速度定义为视频时长除以单台八卡 H200 的墙钟时间。
- 真机为 Franka 加 YUBI 双臂末端,10 Hz、八步动作块。精细操作含零件分拣与燃油支架箱拣(超时 2.5 分钟),每条件 20 次,完整成功需拾取并放置,部分成功只计拾取。语言可控性在六色袜子与左中右三箱上评颜色、夹爪、目标箱、相对位置与序数选择。组合实验用 BED 六个字母布局的演示,在已放好 B 的条件下拼 ID 的 BED 与 OOD 的 BUS。
关键结果与论文证据
- Table 1 上,学习到的接触模块把 mIoU 从 71.8 提到 89.7,帧准确率 83.8 到 94.5,端到端 J/F 从 40.3/43.6 提到 74.0/75.1,说明接触轨迹可作为后续标注锚点。Table 2 中,给定 PA 的 YUBI-STAG 在形状 72.1、材质 92.1、状态 mIoU 76.0 上仍最强;蒸馏后的 YUBI-VLM 在原始视频上 Object ID 95.2、PA 边界 F1 77.9、5-way 协同 89.1,并保持 3.5× 实时,每 episode 请求降到约 33 次。去掉顶视后相对位置与状态计时下降,说明全局上下文仍有价值。RoboFine-VLM 虽大,但时间定位弱、易过切分。
- Figure 4 显示监督变细、同一策略变稳。两条粗标签基线在两道任务上完整成功均为 0%。零件分拣加上惯用手后完整成功 25%、拾取 100%,再加接触监督到 60%;燃油支架从 20% 加倍到 40%,拾取 35% 到 55%。作者观察到粗标签动作更犹豫,细粒度条件则更干脆,并与 Figure 3 右侧 t-SNE 中手别与接触相位的分簇一致。
- 语言可控性上,YUBI-STAG 颜色正确率 82.9% 对基线 46.4%,且完成试验中夹爪指令全部遵循,而基线遇到左手指令仍常用右手。换成未见箱序后,基线目标箱从 100% 掉到 53.3%,说明它更靠场景顺序而非语言接地。关系放置 50.0% 对 11.1%;序数精确选择 41.7% 对 12.5%,平均绝对误差 0.67 对 2.26(随机期望 1.94)。字母积木上,YUBI-VLM 生成的 PA 在 BED 与未见 BUS 上都改善了选字、拾取与放置漏斗,任务级基线则到不了放置完成。
阅读时需要注意
- 论文没有独立 Limitations 节,但从结果可以读出边界。STAG 管线依赖已切分 PA 与多次请求;细粒度外观、相对位置和状态变化仍然困难,尤其在过远顶视或晃动腕部上看不清细节时。生成标注会把红/橙/黄、蓝/紫弄混,关系放置也有近失、左右反转或放到参照物上。
- 接触由视觉推断,没有触觉;真机只覆盖 Franka+YUBI 与少量桌面任务,每条件 20 次。序数试验中基线常抓最左侧袜子,P&P 完成率不能当成指令跟随。预印本未同行评审,项目由 NEDO JPNP25015 资助。
关联工作
- 可扩展采集一侧是 ALOHA、AnyTeleop、UMI 与 YUBI;数据变野之后,缺的是把未切分视频变成细粒度监督。语言重标工作能写出主动臂和接触区域,却不一定在像素和时间上同时定位夹爪-物体接触。
- SPARC 与 Robo2VLM 从夹爪状态或本体感觉推相位,可能漏掉非抓取接触。YUBI-STAG 更接近手-物体接触检测:从运动腕部直接恢复接触区间、掩码与协同。后训练文献里的偏好优化、演示筛选或细指令配对,通常仍不在接近-抓住-保持-释放这些转折上给显式监督。
- π0.5 提供开放世界泛化的流匹配 VLA 骨干;本文固定其观测、动作与目标,只替换监督,用来隔离接触语义的贡献。